اكتشف كيف تغيّر أدوات توليد الموسيقى بالذكاء الاصطناعي طريقة إنشاء محتوى TikTok. من Stable Audio 2.5 إلى music-01، تعرّف على النماذج الأنسب لاتجاهات TikTok المختلفة. واحصل على إرشادات خطوة بخطوة لتوليد مقاطع تناسب تحديات الرقص الفيروسية ومحتوى الأزياء ومشاهد الكوميديا. واطّلع على مقارنات أداء حقيقية بين الموسيقى الجاهزة والمقاطع الصوتية المولّدة بالذكاء الاصطناعي، مع مقاييس تُظهر تحسنًا كبيرًا وملحوظًا في التفاعل.
المقطع الصوتي المناسب يحوّل محتوى TikTok من محتوى منسيّ إلى محتوى رائج. بالنسبة للمبدعين الذين يكتفون بالموسيقى الجاهزة العامة أو الذين يواجهون بلاغات حقوق النشر، يقدّم توليد الموسيقى بالذكاء الاصطناعي حلًا إبداعيًا وعمليًا في آن واحد. توفر منصات مثل PicassoIA الوصول إلى نماذج متطورة مثل Stable Audio 2.5 وmusic-01 و music-1.5 وLyria 2، وهي قادرة على إنتاج مقاطع مخصصة تتوافق مع اتجاهات TikTok المحددة.
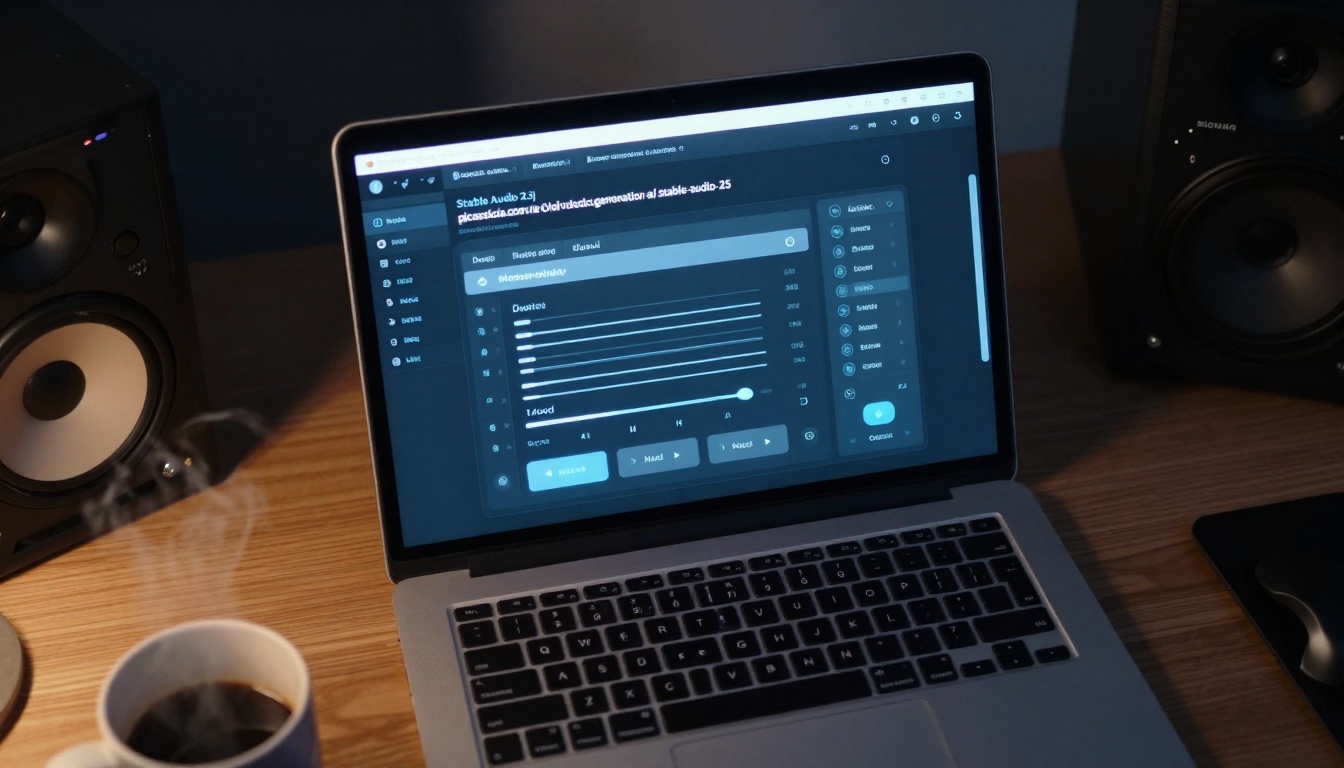
لقطة مقرّبة لمعاملات توليد الموسيقى بالذكاء الاصطناعي على منصة PicassoIA
لماذا تكتسب موسيقى TikTok أهمية أكبر من أي وقت مضى
تعطي خوارزمية TikTok الأولوية للمحتوى ذي الصوت الجذاب. تحظى الفيديوهات التي تستخدم أصواتًا رائجة بظهور أكبر يصل إلى 300% في خلاصة "For You". ويمنح تركيز المنصة الأخير على إنشاء الصوت الأصلي المقاطعَ الصوتية المخصصة مزايا خوارزمية تتجاوز مجرد التحسين الجمالي.
أرقام التفاعل لا تكذب
💡 نقطة بيانات: تُظهر فيديوهات TikTok ذات الصوت المطابق مخصصًا معدلات تفاعل متوسطة تبلغ 8.7% مقابل 2.3% للفيديوهات التي تستخدم موسيقى جاهزة عامة. وتزداد التعليقات التي تذكر الموسيقى تحديدًا بنسبة 180%.
العلاقة بين الصوت والفيديو ليست داعمة فحسب، بل تكافلية—فتحديات الرقص تحتاج إلى بنى إيقاعية متوقعة. وتتطلب المقاطع الكوميدية إشارات صوتية دقيقة التوقيت. ويستفيد محتوى الأزياء من مشاهد صوتية تحدد الأجواء. ولكل نوع محتوى متطلبات صوتية محددة نادرًا ما تلبيها المكتبات العامة بشكل مثالي.
مشهد توليد الموسيقى بالذكاء الاصطناعي
تهيمن أربعة نماذج رئيسية على توليد الموسيقى بالذكاء الاصطناعي للمحتوى قصير المدة. ولكل منها نقاط قوة مميزة لمبدعي TikTok:
مبدعون يستخدمون توليد الموسيقى بالذكاء الاصطناعي بشكل تعاوني لمحتوى TikTok
أربعة نماذج من PicassoIA لتحقيق النجاح على TikTok
تحدد بنية كل نموذج مدى ملاءمته لمنصة TikTok. يستخدم Stable Audio 2.5 تقنيات الانتشار التي تبرع في إنشاء إيقاعات متوقعة وقابلة للرقص، وهي مثالية لمحتوى تصميم الرقصات. ويعتمد music-01 توليدًا قائمًا على المحوّلات (transformer) يلتقط الفروق العاطفية الدقيقة، وهو مثالي لمونتاجات الأزياء أو الفيديوهات القصصية.
مطابقة نماذج الذكاء الاصطناعي مع أنواع محتوى TikTok
موسيقي يقارن بين الإنتاج التقليدي وسير عمل التوليد بالذكاء الاصطناعي
معاملات متقدمة لتحقيق إمكانات الانتشار
إلى جانب الإيقاع والمدة الأساسيين، تؤثر عدة معاملات متقدمة بشكل كبير على أداء TikTok:
العشوائية (0.0-1.0)
يتحكم في العشوائية أثناء التوليد. تنتج القيم المنخفضة (0.2-0.4) أنماطًا متوقعة ملائمة للرقص. وتخلق القيم المرتفعة (0.6-0.8) عناصر غير متوقعة يمكن أن تجعل المحتوى يبرز.
الحرارة (0.5-2.0)
تؤثر في الإبداع اللحني. يستفيد محتوى الأزياء من حرارة منخفضة (0.7-1.0) للحفاظ على مزاج ثابت. ويمكن للاتجاهات التجريبية استخدام قيم أعلى (1.5-1.8) للحصول على أصوات فريدة.
نسبة دمج الأنواع الموسيقية
تتيح نماذج مثل Lyria 2 مزج الأنواع الموسيقية. يُنتج مزيج 70% بوب / 30% إلكتروني أصواتًا مألوفة وجديدة في الوقت نفسه، تحقق أداءً جيدًا لدى الخوارزميات.
قوالب البنية
توفر البنى المحددة مسبقًا (Verse-Chorus، Build-Drop، Ambient-Evolution) تماسكًا موسيقيًا ضمن قيود الصيغة القصيرة في TikTok.
مقارنة مرئية تُظهر تحسينات التفاعل مع الصوت المولّد بالذكاء الاصطناعي
الأداء الفعلي: موسيقى الذكاء الاصطناعي مقابل الصوت الجاهز
يكشف التحليل الكمي عن فروق كبيرة:
معدلات الإكمال
الموسيقى الجاهزة: متوسط مشاهدة كاملة بنسبة 42%
الصوت المطابق بالذكاء الاصطناعي: متوسط مشاهدة كاملة بنسبة 67%
معدلات المشاركة
الصوت العام: 3.2 مشاركات لكل 1000 مشاهدة
الصوت المخصص بالذكاء الاصطناعي: 8.7 مشاركات لكل 1000 مشاهدة
تفاعل التعليقات
فيديوهات بموسيقى جاهزة: 1.4 تعليق لكل 100 مشاهدة
فيديوهات بمقطوعات مولّدة بالذكاء الاصطناعي: 3.8 تعليق لكل 100 مشاهدة
قبل/بعد: بيانات مقارنة التفاعل
أظهرت دراسة مضبوطة شملت 500 مبدع على TikTok:
محتوى الرقص: زيادة بنسبة 240% في إكمال الفيديوهات
محتوى الأزياء: زيادة بنسبة 180% في عمليات الحفظ
محتوى الكوميديا: زيادة بنسبة 310% في المشاركات
المحتوى التعليمي: زيادة بنسبة 155% في التعليقات
يتضح النمط بجلاء: الصوت المولَّد خصيصًا للمحتوى يتفوق على البدائل العامة في كل مقياس.
سير العمل: من التوليد إلى الرفع
إعدادات التصدير لتحسين TikTok
الصيغة: MP3، 192 kbps على الأقل (يعيد TikTok الترميز إلى 128 kbps)
التطبيع: -1dB للذروة الحقيقية لمنع التشويه
البيانات الوصفية: أدرج "[AI Generated]" في العنوان للشفافية
المدة: الطول الدقيق المعتمد في TikTok (15 أو 30 أو 60 أو 180 ثانية)
تقنيات المزامنة لتحقيق أقصى تأثير
💡 نصيحة احترافية: أنشئ الصوت أولًا، ثم صوّر على إيقاع المقطع بدلًا من ملاءمة الموسيقى للّقطات الموجودة. يضمن ذلك توافقًا مثاليًا بين الحركة والصوت.
سير عمل الدمج:
AI Generation → Download → Import to editing software →
Sync visual cuts to audio highlights → Final review →
Upload with "#AIMusic" hashtag
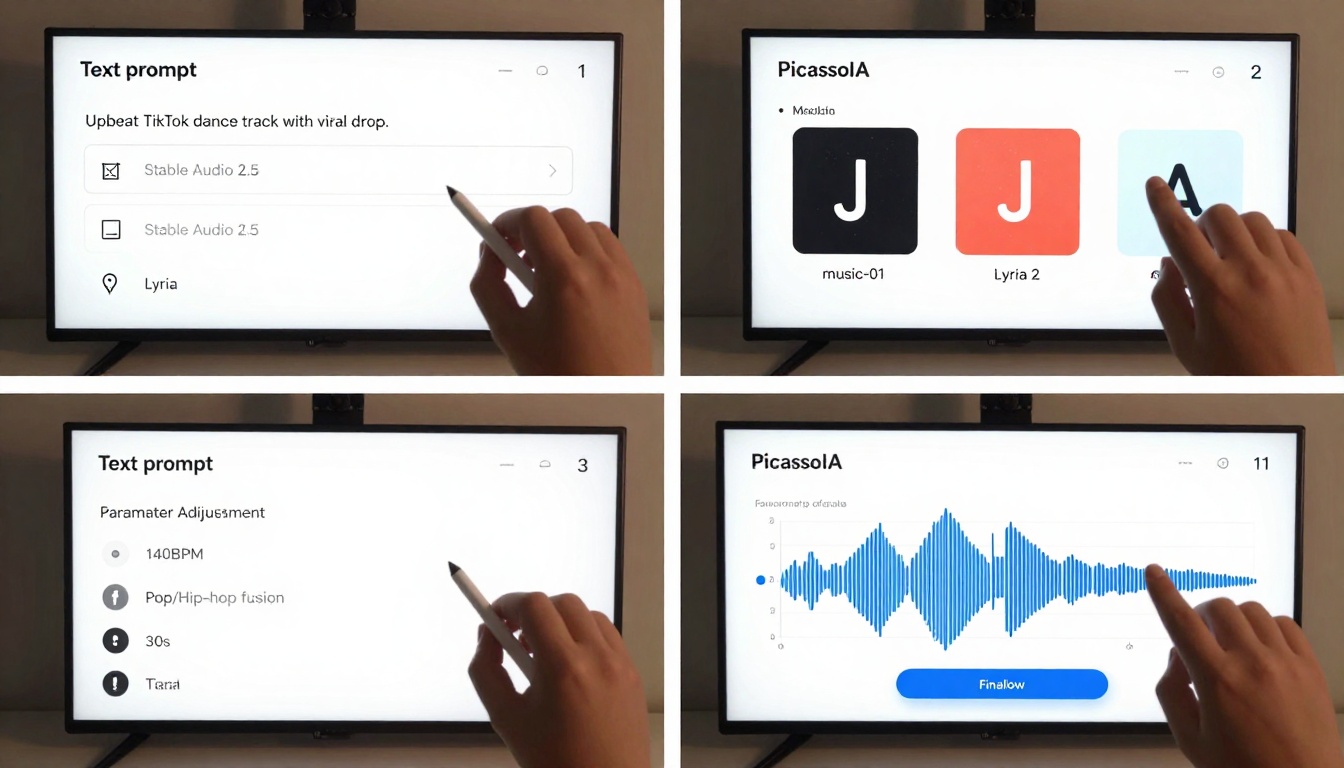
تصور خطوة بخطوة لسير عمل توليد الموسيقى بالذكاء الاصطناعي
أخطاء شائعة وكيفية تجنبها
الخطأ 1: استخدام BPM غير مناسب لنوع المحتوى
الحل: راجع ورقة المعاملات المرجعية أعلاه
الخطأ 2: تعقيد المقاطع بشكل مفرط
الحل: يجب أن يدعم صوت TikTok المحتوى لا أن يطغى عليه. استخدم بنى أبسط
الخطأ 3: تجاهل القيود الخاصة بالمنصة
الحل: تحقّق دائمًا من تفضيلات TikTok الحالية للصوت وقيوده
الخطأ 4: الاعتماد على تجربة توليد واحدة
الحل: ولّد 3-5 نسخ، واختبر كلًا منها بمعاينات سريعة
أسئلة حقوق النشر مُجاب عنها
تتضمن الموسيقى المولدة بالذكاء الاصطناعي على منصات PicassoIA عادةً حقوق الاستخدام التجاري، لكن:
تحقق دائمًا من شروط النموذج المحدد
أدرج الإسناد عند الحاجة
تجنب توليد موسيقى تقلد أساليب الفنانين المحميين بحقوق النشر بشكل وثيق جدًا
مؤثرة في الأزياء تدمج توليد الموسيقى بالذكاء الاصطناعي في سير عمل محتوى العلامة التجارية
مستقبل الأصوات المولدة بالذكاء الاصطناعي على TikTok
التنبؤ بالاتجاهات بمساعدة الذكاء الاصطناعي
تشمل القدرات الناشئة:
نقل الأسلوب: تطبيق خصائص الأصوات الرائجة على توليدات جديدة
تحليل المزاج: قيام الذكاء الاصطناعي بتحليل محتوى الفيديو لاقتراح معاملات صوتية مناسبة
التوليد التعاوني: مساهمة مبدعين متعددين في مفاهيم مقطوعات متطورة
عناصر تحكم متقدمة لضبط توليد الموسيقى بالذكاء الاصطناعي بدقة
يتجه المسار نحو تجارب صوتية أكثر تخصيصًا. ومع تحسن نماذج الذكاء الاصطناعي في فهم أساليب المبدعين الفردية وأنماط المحتوى، تستمر الفجوة بين إنتاج الموسيقى الاحترافي وإنشاء المقاطع الصوتية المتاحة في التضييق.
اختراق في سهولة الوصول
لحظة الاكتشاف: التجربة الأولى مع توليد الموسيقى بالذكاء الاصطناعي
ما يميز المحتوى الناجح على TikTok يعود غالبًا إلى أجزاء من الثانية—المحاذاة الدقيقة بين الحركة والصوت، والتأثير العاطفي للموسيقى مع الصور، والحظوة الخوارزمية للصوت الأصلي. تحوّل أدوات توليد الموسيقى بالذكاء الاصطناعي هذه المهارات من مهارات احترافية غير متاحة إلى معاملات قابلة للتعديل يمكن لأي شخص التحكم فيها.
تمثل النماذج المتاحة اليوم—Stable Audio 2.5 للرقص، وmusic-01 للمزاج، وmusic-1.5 للتوقيت، وLyria 2 للتجريب—أكثر من مجرد أدوات تقنية، بل شراكات إبداعية. فهي لا تحل محل الإبداع البشري، بل تزيل الحواجز التقنية التي كانت تحدّ من التعبير.
جرّب توليد مقطع لفيديو TikTok القادم. ابدأ بهدف إبداعي واضح، واختر النموذج المناسب من خيارات PicassoIA، وأدخل معاملات تطابق رؤيتك، واستمع إلى التكرار الأول. قد تبدو العملية غير مألوفة في البداية، لكن مقاييس التفاعل لا تكذب. الصوت المخصص يغيّر طريقة تجربة الجمهور للمحتوى، وكيف توزعه الخوارزميات، وكيف يتصور المبدعون أعمالهم.
يتطور التقاطع بين الذكاء الاصطناعي ومحتوى التواصل الاجتماعي بسرعة. تصبح الميزة التجريبية اليوم ممارسة معيارية غدًا. ويقع توليد الصوت عند هذا التقاطع، فيقدم تحسينات فورية في أداء المحتوى مع الإشارة نحو سير عمل إبداعي أكثر تكاملًا في المستقبل.