Kolors: شرح نموذج Kuaishou لتوليد الصور بالذكاء الاصطناعي
Kolors هو نموذج انتشار مفتوح المصدر لتحويل النص إلى صورة من Kuaishou Technology، مبني على بنية الانتشار الكامن مع مُرمِّز نصي من ChatGLM يدعم الأوامر النصية بالصينية والإنجليزية. يشرح هذا المقال كيف يعمل النموذج من الداخل، وما الذي يميّزه عن SDXL ونماذج رائدة أخرى، ولماذا ينتج نتائج حادة وواقعية في البورتريهات وصور المنتجات وحالات الاستخدام ثنائية اللغة.
ظهر Kolors في عام 2024 كأحد أكثر الإصدارات إثارةً من الناحية التقنية في المشهد البحثي للذكاء الاصطناعي في الصين. طوّرته Kuaishou Technology، الشركة التي تقف وراء منصة الفيديوهات القصيرة Kuaishou، وأُتيح النموذج كمفتوح المصدر تقريبًا فور إطلاقه، ونال اهتمامًا كبيرًا من الباحثين والمطورين الذين اعتادوا على الإصدارات التي تهيمن عليها الشركات الغربية.
ما لفت الأنظار لم يكن جودة الصور وحدها، وهي مبهرة فعلًا، بل القرارات المعمارية التي تقف خلفها. يستخدم Kolors مُرمِّز نص قائمًا على المحوّلات (transformer) مأخوذًا من ChatGLM، بدلًا من مُرمِّز CLIP الذي تعتمد عليه معظم النماذج الغربية. لهذا الاختيار الواحد تبعات كبيرة على طريقة تفسير الأوامر النصية، وعلى مدى جودة تعامل النموذج مع المدخلات باللغة الصينية عبر مجموعة واسعة من التطبيقات التجارية والإبداعية.
يتناول هذا المقال طريقة عمل Kolors من الناحية التقنية، وما الذي ينتجه، وكيف يقارن بالنماذج الرائدة الأخرى، وأين يقع في المشهد المتغير بسرعة لتوليد الصور مفتوحة المصدر اليوم.
ما هو Kolors فعلًا
Kolors نموذج انتشار واسع النطاق لتحويل النص إلى صورة، طوّره فريق Kolors التابع لشركة Kuaishou، وأُطلق للعموم في منتصف عام 2024. الاسم الكامل للنموذج هو Kolors-diffusers، وأُتيح على Hugging Face بأوزان يمكن لأي شخص تنزيلها وتشغيلها. وهو مبني على إطار الانتشار الكامن، أي أن الصور تُولَّد وتُعالَج في فضاء كامن مضغوط بدلًا من دقة البكسل الكاملة، وهذا أسرع وأوفر للذاكرة.
تعود جذور البنية إلى العائلة نفسها من الأفكار التي أنتجت SDXL. لكن Kolors يختلف اختلافًا جوهريًا في مكوّن أساسي واحد: مُرمِّز النص. هذا الاختلاف ليس تعديلًا صغيرًا، فهو يعيد تشكيل أنواع الأوامر النصية التي يستطيع النموذج التعامل معها، ومن يستطيع الاستفادة منه بفعالية.
مبني على الانتشار الكامن
في نموذج الانتشار الكامن، تحدث عملية إزالة الضوضاء الفعلية في فضاء كامن منخفض الأبعاد. يضغط Variational Autoencoder (VAE) الصور إلى هذا الفضاء أثناء التدريب، وأثناء التشغيل يولّد النموذج في هذا الفضاء المضغوط، قبل أن يعيد مفكك VAE بناء الصورة النهائية بالبكسل.
يعني هذا أن الجزء المكلف حسابيًا، أي إزالة الضوضاء التكرارية، يعمل على مصفوفة أصغر بكثير مما تتطلبه البكسلات الخام. يستخدم Kolors فضاءً كامنًا بأربع قنوات وعامل تصغير قدره 8، لذلك تُعالَج صورة بحجم 1024x1024 كفضاء كامن بحجم 128x128. يُدرَّب UNet داخل Kolors على التنبؤ بالضوضاء في كل خطوة من خطوات الانتشار داخل هذا الفضاء المضغوط، ثم يسلّم النتيجة إلى مفكك VAE للتصيير النهائي.
مُرمِّز النص ChatGLM
هنا يتميز Kolors فعلًا عن المنافسين. فبدلًا من CLIP، الذي يُرمِّز النص إلى تسلسل ثابت الطول من 77 توكنًا بعمق دلالي محدود، يستخدم Kolors النموذج ChatGLM3-6B كمُرمِّز نصي. وChatGLM نموذج لغوي ثنائي اللغة (صينية وإنجليزية) من جامعة Tsinghua وشركة Zhipu AI، ويتعامل مع الأوامر الطويلة والدقيقة بقدرة أفضل بكثير من CLIP.
الفرق العملي حقيقي وقابل للقياس. فقد دُرِّب CLIP على بيانات مُجمّعة من الويب تغلب عليها الإنجليزية، ويواجه صعوبة مع ثلاث فئات من المدخلات:
الأوامر الطويلة التي تتجاوز 77 توكنًا
الحروف الصينية وما تحمله من دلالات دقيقة
التعليمات التركيبية المعقدة التي تتضمن عدة أشخاص وعلاقات بينهم
يعالج ChatGLM الفئات الثلاث جميعها. فهو يدعم حتى 256 توكنًا من المدخلات، ويتمتع بقدرة ثنائية اللغة أصيلة على مستوى التدريب، ويمتلك عمق المحوّلات الناتج عن نموذج لغوي بحجم 6 مليارات معامل، دُرِّب خصيصًا على فهم الصينية والإنجليزية.
💡 الفرق الجوهري: يستطيع Kolors قبول أمر نصي كامل باللغة الصينية وإنتاج نتائج توصف المطلوب بدقة، في حين أن SDXL إما يسيء الترجمة أو يتجاهل المعنى تمامًا.
لماذا يتميز Kolors
هناك عشرات النماذج مفتوحة المصدر لتحويل النص إلى صورة متاحة في عام 2024. فما الذي يمنح Kolors سببًا للوجود يتجاوز كونه مجرد تعديل آخر على SDXL؟
نصوص ثنائية اللغة داخل الصور
تُنتج معظم النماذج الغربية حروفًا صينية مشوهة أو غير متسقة عند الطلب منها تضمين نص في الصور. أما Kolors فيتعامل مع الطباعة الصينية بدقة أعلى بوضوح، لأن مُرمِّز نصه يفهم الوزن الدلالي للتوكنات الصينية على مستوى عميق. وهذا مهم جدًا لحالات الاستخدام التجاري في الأسواق الناطقة بالصينية: لافتات منتجات التجارة الإلكترونية، وتصميم الملصقات، وصور وسائل التواصل الاجتماعي، ولقطات شاشات متاجر التطبيقات.
تمتد القدرة نفسها إلى عرض النصوص الإنجليزية. فنموذج Kolors منافس، وإن لم يكن متفوقًا بثبات، للنماذج المتخصصة في النصوص داخل الصور بالحروف اللاتينية. لكنه، مع ذلك، النموذج الكبير المفتوح المصدر الوحيد الذي يتعامل مع الحرفين بموثوقية داخل بنية واحدة، دون الحاجة إلى أي خطوة ترجمة مسبقة.
جودة الصور الواقعية
ينتج Kolors صورًا تميل بقوة نحو الواقعية. فملمس البشرة وتفاصيل الأقمشة والإضاءة المحيطة وعمق المشهد تظهر جميعها بجودة طبيعية تنافس إصدارات SDXL المضبوطة بدقة وFLUX.1 Dev. دُرِّب النموذج على مجموعة بيانات خاصة ضخمة أعدّتها Kuaishou، تضمنت صورًا فوتوغرافية بدقة عالية وصورًا تجارية مصدرها النظام الإعلامي للمنصة.
في اختبارات مقارنة أجراها مجتمع الذكاء الاصطناعي بعد الإطلاق بوقت قصير، تفوّق Kolors باستمرار على SDXL الأساسي في عدة اختبارات معيارية:
المقياس
SDXL الأساسي
Kolors
درجة تفضيل البشر
75.2%
85.6%
واقعية ملمس البشرة
متوسطة
عالية
دقة الأوامر الصينية
ضعيفة
عالية
اتباع الأوامر الطويلة
متوسط
عالٍ
عرض النص الصيني
فشل
نجاح
الدقة التركيبية
متوسطة
عالية
تأتي هذه الأرقام من قسم التقييم في ورقة Kolors البحثية، وتمثل منهجية الاختبار الداخلية لشركة Kuaishou. وقد أكدت الاختبارات المستقلة التي أجراها المجتمع الاتجاه العام إلى حد كبير، لا سيما في الأشخاص في البورتريهات وصور المنتجات الموضوعة على الأسطح، حيث تكون الواقعية المعيار الأساسي.
مفتوح المصدر ومجاني للتشغيل
أطلقت Kuaishou نموذج Kolors بترخيص مفتوح يسمح بالاستخدام التجاري. الأوزان الكاملة وVAE وإعدادات المجدول متاحة مجانًا على Hugging Face. يستطيع أي شخص لديه وحدة GPU مناسبة تشغيله محليًا دون تكاليف API. كان هذا خيارًا استراتيجيًا مقصودًا، فالإصدار المفتوح يبني نظامًا بيئيًا من المطورين الذين يضبطون النموذج، ومدربي LoRA، والتطبيقات التابعة، وهذا يوسّع نطاق النموذج إلى ما هو أبعد بكثير مما تستطيع Kuaishou إنتاجه داخليًا.
تعمّق في بنية Kolors
فهم سبب نجاح Kolors يتطلب نظرة موجزة على ما يحدث داخل النموذج. إن لم تكن تهتم بالتفاصيل التقنية، يمكنك تخطي هذا القسم دون أن تفقد خيط المقال.
العمود الفقري UNet
يستخدم Kolors نموذج UNet معدّلًا كعمود فقري لإزالة الضوضاء، وهو مشابه في بنيته لنسخة UNet المستخدمة في SDXL، لكنه دُرِّب من الصفر على خط بيانات Kuaishou. القرارات البنيوية التي تحدد سلوكه هي:
دعم الدقة: تدريب أصلي بحجم 1024x1024 مع دعم تكييف نسب العرض إلى الارتفاع المتعددة
طبقات الانتباه: يُكيّف الانتباه المتقاطع (cross-attention) التوليد وفق التضمينات النصية القادمة من ChatGLM عند أعماق متعددة في UNet
الوصلات المتخطية: تحافظ وصلات التخطي القياسية في UNet على البنية المكانية خلال مسار التكبير
تكييف الخطوة الزمنية: تنقل تضمينات الخطوة الزمنية الجيبية مرحلة إزالة الضوضاء إلى الشبكة طوال عملية التشغيل
يستقبل UNet الكامن الضجيجي والتكييف النصي المُسقَط في الوقت نفسه، ويتنبأ بمكوّن الضوضاء المراد إزالته، ويكرر العملية. المجدولات الشائعة، ومنها DDIM وDPM++ 2M Karras وEuler، متوافقة جميعها مع Kolors. وعادةً ما تنتج 20 إلى 50 خطوة نتائج عالية الجودة، وتُعدّ 25 إلى 35 خطوة النقطة العملية المثلى بين السرعة والجودة.
كيف تنتقل التوكنات عبر النموذج
مسار تكييف النص في Kolors أكثر تعقيدًا من إعداد المُرمِّزين الاثنين في SDXL. فيما يلي تسلسل المعالجة من الأمر النصي الخام إلى تكييف الصورة:
يصل الأمر النصي بالصينية أو الإنجليزية، بحد أقصى 256 توكنًا
يُرمِّز مُقطِّع ChatGLM3-6B النص إلى معرّفات توكنات مع تقطيع جزئي للكلمات يراعي اللغة
طبقة الإسقاط تحوّل التضمينات ذات الأبعاد 4096 إلى بُعد التضمين الداخلي لـ UNet
الانتباه المتقاطع في طبقات UNet عند أعماق متعددة يكيّف كل خطوة توليد وفق هذه الإسقاطات
تحمل تضمينات ChatGLM معلومات سياقية أكثر بكثير من تضمينات CLIP، لأن ChatGLM محوّل توليدي تلقائي الانحدار كامل، وليس نموذجًا تقابليًا دُرِّب على أزواج من الصور والنصوص. لهذا يتعامل Kolors مع الأوامر التركيبية بموثوقية أكبر: فجملة "امرأة ترتدي معطفًا أحمر تقف أمام مبنى أخضر في مساء ممطر" تُفهم كمشهد تركيبي، لا كتجمّع إحصائي من ارتباطات بين الصور والنصوص.
VAE والفضاء الكامن
يستخدم Kolors مُشفّر VAE قياسيًا مُنظَّمًا بتباعد KL، بأربع قنوات كامنة. يُحوّل المُشفّر الصور البكسلية إلى فضاء كامن بضغط مكاني قدره 8 مرات أثناء التدريب، ويعيد المفكك بناء الصور الكاملة أثناء التشغيل. استخدم فريق Kolors أوزان VAE المنشورة لنموذج SDXL كنقطة بداية للتهيئة، وهذا أحد أسباب توافق خصائص الفضاء الكامن إلى حد ما مع بعض أدوات SDXL ومجتمعاته.
يشغل Kolors مكانًا محددًا: التوليد الواقعي مع دعم ثنائي اللغة أصيل، وبمستوى إتاحة مفتوح المصدر. لا يجمع أي نموذج آخر في هذه المقارنة بين هذين الأمرين. يقترب FLUX.1 Dev من Kolors في الواقعية، لكنه يفتقر إلى عمق الصينية. ويتعامل GPT Image 2 مع الصينية بشكل أفضل، لكنه مغلق المصدر ومتاح عبر API فقط.
أما مواطن ضعف Kolors النسبية فهي: أن نظام ضبط LoRA الخاص به أصغر من نظام SDXL، وأن سرعة تشغيله أبطأ من FLUX.1 Schnell، وأن عدد إصدارات checkpoint بأساليب بصرية مدرَّبة من المجتمع المتاحة للتنزيل فيه أقل.
متى تختار Kolors
اختر Kolors عندما:
يكون جمهورك ناطقًا بالصينية وستكون الأوامر النصية بالصينية في الغالب
تحتاج إلى بورتريهات واقعية أو صور منتجات تجارية بجودة النشر
تريد أوزانًا مفتوحة المصدر بترخيص ملائم للاستخدام التجاري في النشر الإنتاجي
تبني منتجًا ثنائي اللغة وتريد نموذجًا واحدًا يخدم الجمهورين اللغويين
ابحث عن خيار آخر عندما:
تكون أقصى سرعة للتشغيل هي الأولوية (FLUX Schnell أسرع بشكل ملحوظ)
تحتاج إلى أكبر نظام بيئي للضبط الدقيق وLoRA (ما زال SDXL يتصدر هنا)
يلزم تركيب مشهد معقد مع اتباع دقيق للتعليمات (FLUX.1 Dev يؤدي بشكل أفضل)
حالات استخدام من الواقع
تصوير البورتريه والموضة
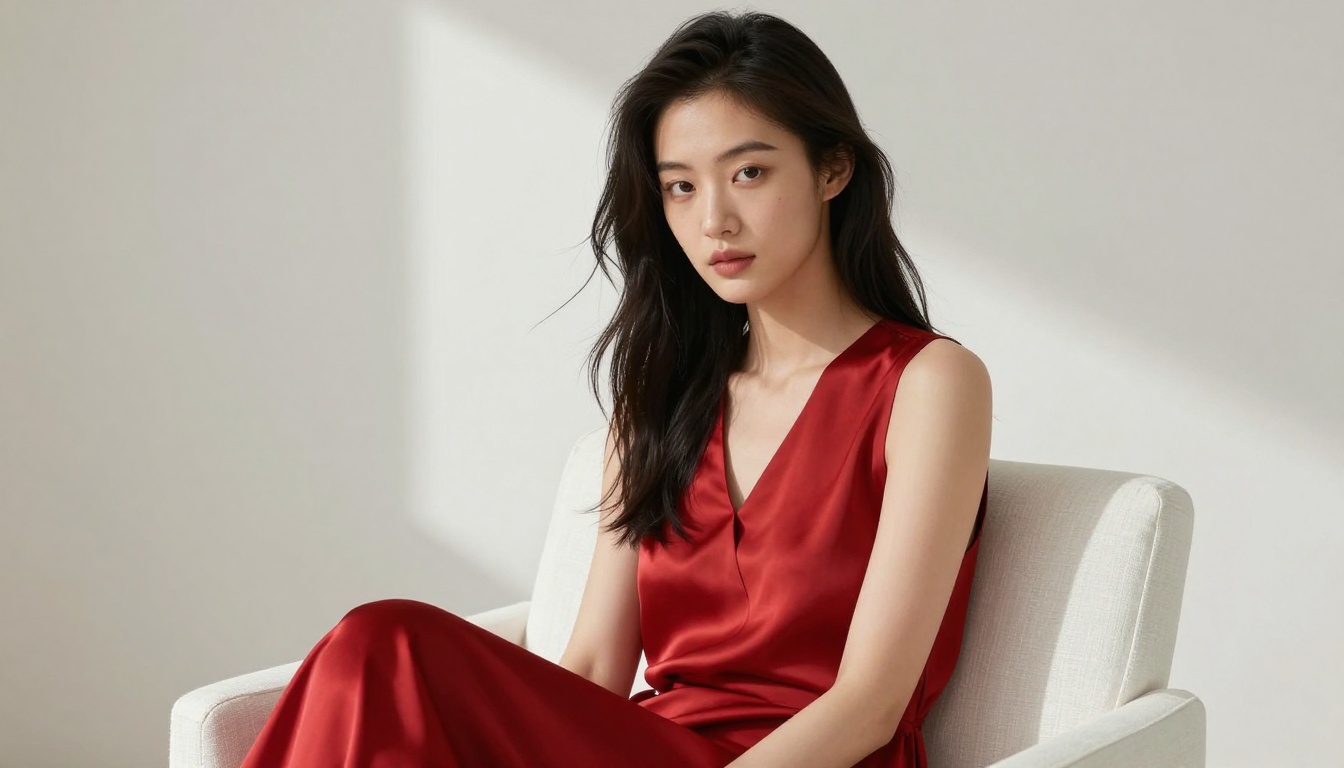
ينتج Kolors مخرجات بجودة البورتريه يمكن أن تحل محل صور المخزون في كثير من السياقات التجارية. يأتي تصيير لون البشرة طبيعيًا عبر نطاق واسع من الأعراق، وتبدو الإضاءة متسقة دون لمعان صناعي المظهر، ويتعامل النموذج مع سلوك أقمشة الملابس بدقة مفاجئة. اعتمد مصورو الموضة وفرق الإنتاج في التجارة الإلكترونية في الصين النموذج بسرعة لتوليد صور المنتجات وإطارات المرجع للعارضين بحجم لا تستطيع التصوير التقليدي مجاراته اقتصاديًا.
تصوير المنتجات
تستخدم العلامات التجارية الصينية Kolors بنشاط لتوليد صور المنتجات في سياقها دون جلسات تصوير استوديو مكلفة. يمكن لعلامة للعناية بالبشرة أن تنتج زجاجة مصل موضوعة على رف رخامي في حمام، مع انعكاسات ضوئية وظلال دقيقة، بجزء صغير من تكلفة التصوير التقليدي. ودعم الأوامر النصية ثنائية اللغة الأصيل يعني أن فريق التسويق يستطيع العمل مباشرة بالصينية دون أي خطوة ترجمة أو تقريب لغوي.
تعامل النموذج مع الأسطح العاكسة وشفافية المواد والتفاعل بين السطح والضوء قوي بشكل خاص في تصوير المنتجات، وهو عمل يعتمد على دقة تصيير المواد.
وسائل التواصل الاجتماعي وإنشاء المحتوى
منصة Kuaishou نفسها منتج للفيديوهات القصيرة يتنافس بشكل مباشر مع TikTok في الصين. يُدمج Kolors مباشرة في أدوات صنّاع المحتوى داخل المنصة. يستطيع صانعو المحتوى توليد صور مصغّرة وفنون لافتات ورسومات ترويجية بالكامل بالصينية، بنتائج تطابق التوقعات البصرية لجماليات وسائل التواصل الاجتماعي الصينية دون أي خطوة وسيطة بالإنجليزية.
تشغيل Kolors عمليًا
عبر API
أبسط طريقة لتشغيل Kolors دون أجهزة محلية هي عبر Replicate API. النموذج مستضاف على kwai-kolors/kolors ويقبل معاملات الانتشار القياسية: الأمر النصي، والأمر النصي السلبي، والخطوات، ومقياس التوجيه، وقيمة البذرة. يكلّف الاستدعاء النموذجي جزءًا من السنت لكل صورة، وينتج مخرجات بحجم 1024x1024 في نحو 10 إلى 20 ثانية من وقت التشغيل.
الإطار البرمجي: Diffusers 0.30.0 أو أحدث من Hugging Face
Checkpoint: Kwai-Kolors/Kolors متاح مباشرة على Hugging Face Hub
يندمج النموذج مع الفئة KolorsPipeline في Diffusers، التي تتولى تقطيع توكنات ChatGLM تلقائيًا. التحميل بدقة float16 يناسب ذاكرة VRAM بين 18 و20 جيجابايت. على RTX 4090، يستغرق التشغيل بعدد 30 خطوة بدقة 1024x1024 نحو 8 إلى 12 ثانية.
💡 نصيحة: طبّق torch.compile() على UNet لتحقيق تحسين في سرعة التشغيل بنسبة 20 إلى 30% على وحدات GPU من جيلي Ada وAmpere. ادمجه مع انتباه SDPA لكفاءة أعلى في الذاكرة دون خسارة في الجودة.
ضبط LoRA الدقيق
يدعم Kolors الضبط الدقيق باستخدام LoRA عبر نصوص التدريب القياسية في Diffusers، مع تعديلات طفيفة لاستيعاب مسار التكييف الخاص بـ ChatGLM. يتطلب تدريب LoRA للأسلوب على Kolors نحو 20 إلى 50 صورة مرجعية و1,000 إلى 2,000 خطوة تدريب على وحدة GPU بذاكرة 24GB للحصول على جودة معقولة. كما يُدعم الضبط الدقيق الكامل بأسلوب dreambooth لمهام ثبات الهوية.
أصدر فريق Kuaishou نماذج مرافقة، منها Kolors-IP-Adapter لتوليد بورتريهات ثابتة الهوية، وKolors-ControlNet للتحكم في الوضعية والعمق وحواف Canny. تجعل هذه الإضافات مجموعة الأدوات العملية حول Kolors أكثر اكتمالًا بكثير مما قد يوحي به تقييم النموذج الأساسي وحده.
الصورة الأوسع
يمثل Kolors شيئًا يستحق الانتباه بما يتجاوز أرقام المعايير الفردية. فهو جزء من موجة أوسع من نماذج الذكاء الاصطناعي عالية الجودة الصادرة عن فرق بحثية صينية، وقد حظيت بقدر قليل نسبيًا من الظهور في النقاشات الغربية حول تطوير النماذج الرائدة.
تملك Kuaishou، مثل ByteDance ومختبر DAMO التابع لشركة Alibaba، العمق الهندسي والموارد الحسابية وبيانات التدريب الخاصة اللازمة لإنتاج نماذج تنافس النظراء الغربيين أو تتفوق عليهم في مجالات بعينها. لا يتفوق Kolors على Midjourney v6 في الأسلوب الجمالي الخام. لكنه يتفوق على SDXL الأساسي في معظم اختبارات الواقعية، وهو في الوقت نفسه مفتوح المصدر، يدعم لغتين بشكل أصيل، مرخّص تجاريًا، ومتاح للاستضافة الذاتية مجانًا.
أعاد الإصدار أيضًا التأكيد على نهج استخدام النماذج اللغوية الكبيرة كمشفّرات نصية لتوليد الصور. فقد استُخدم T5-XXL في Stable Diffusion 3 وFLUX.1 Dev، وأثبت الفكرة من الجانب الغربي. أثبت Kolors أن النهج يعمل بالقدر نفسه على الأقل، وربما بشكل أفضل للغات غير الإنجليزية، وذلك باستخدام ChatGLM. ولا يزال البحث عن بنى أفضل لتكييف النص في نماذج الانتشار مستمرًا، ويمثل Kolors نقطة بيانات مهمة في هذا المسار المتواصل.
بالنسبة إلى الفرق التي تبني منتجات تخدم المستخدمين الناطقين بالصينية، فإن Kolors ليس فضولًا تقنيًا ولا بديلًا تجريبيًا. إنه حاليًا أقوى خيار مفتوح المصدر يجمع بين جودة الصور الواقعية ودعم الأوامر الصينية الأصيل في نموذج واحد مرخّص تجاريًا.
ابدأ بتوليد صورك الخاصة
أسرع طريقة لتجربة ما يمكن أن تنتجه تقنية توليد الصور بالذكاء الاصطناعي الحديثة، دون أجهزة محلية أو تنزيل نماذج أو بيانات اعتماد API، هي استخدام منصة تولّت البنية التحتية بالفعل. تستضيف PicassoIA عشرات النماذج المتقدمة لتحويل النص إلى صورة، ويمكنك تشغيلها مباشرة في متصفحك دون أي إعداد.
إن أردت توليدًا واقعيًا بالأسلوب الذي شاع مع Kolors، فإن FLUX.1 Dev يقدم مخرجات مفصّلة للغاية ودقيقة في تنفيذ الأمر النصي على PicassoIA. وللعمل الإبداعي الكثيف بالتعليمات حيث يهم النص داخل الصورة، يتوفر GPT Image 2 دون أي إعداد مطلوب. يعمل النموذجان على بنية PicassoIA التحتية، لذا تكتب أمرًا نصيًا وترى النتائج خلال ثوانٍ.
سواء كنت تنتج تصوير بورتريه أو صور منتجات أو أصولًا لوسائل التواصل الاجتماعي، أو كنت تختبر ببساطة ما يمكن أن تنتجه هذه النماذج من وصف مفصّل، فإن PicassoIA يجمع توليد الصور بمستوى الجودة الرائد في مكان واحد. اكتب أمرك النصي، واختر نموذجك، وشاهد النتيجة.