Pasar dos horas en una reunión para luego dedicar otra hora a reconstruir lo que dijo todo el mundo es un impuesto sobre el flujo de trabajo que se acumula cada día. Entre reuniones de seguimiento de producto, llamadas con clientes, grabaciones de podcast y entrevistas con inversores, el profesional medio genera más contenido hablado del que podría recoger a mano. Ese es exactamente el problema para el que se creó la transcripción con IA.
El paso de tomar notas a mano al reconocimiento automático del habla se ha acelerado mucho. Hoy las mejores herramientas no se limitan a convertir audio en texto. Identifican a cada hablante, señalan los puntos de acción, generan archivos buscables de cada palabra pronunciada y entregan documentos limpios y con formato en segundos después de terminar la grabación. La pregunta ya no es "¿puede la IA transcribir?". Ahora es "¿qué IA transcribe con la precisión suficiente para el uso real?".
Este artículo separa el ruido de lo importante. A continuación encontrarás qué diferencia una buena transcripción con IA de una excelente, un análisis práctico de los principales modelos disponibles en PicassoIA, casos de uso reales con exigencias de precisión concretas y una guía paso a paso para transcribir tu primer archivo en línea.
Qué separa lo bueno de lo excelente
No todas las herramientas de voz a texto son iguales, y la diferencia se hace evidente en cuanto sales de una grabación limpia en una habitación silenciosa. Tres factores separan una herramienta que merece la pena de otra que te hace perder el tiempo.
Precisión con audio real y desordenado
Un modelo de transcripción entrenado con voz de calidad de estudio se vendrá abajo en una llamada de Zoom grabada con el micrófono de un equipo portátil y el aire acondicionado de fondo. Los mejores sistemas de transcripción con IA se entrenan con conjuntos de datos enormes y variados: llamadas telefónicas, podcasts, habla con acento, conversaciones solapadas y terminología técnica. Usan el contexto para corregir lo que la señal de audio por sí sola podría identificar mal.
La tasa de error de palabras (WER) es la métrica estándar. Los modelos de primer nivel ya logran un WER inferior al 5 % en habla general. En audio difícil, con ruido de fondo, acentos marcados o vocabulario muy especializado, la diferencia entre modelos se amplía considerablemente.
Identificación de hablantes y marcas de tiempo
La transcripción en bruto es una cosa. Un documento estructurado que te diga quién dijo qué y cuándo es algo mucho más útil. La diarización, es decir, la segmentación del audio por hablante, es una capacidad que varía mucho de una herramienta a otra. Para notas de reuniones, revisiones de llamadas comerciales o transcripciones de entrevistas, la diarización es imprescindible.
Las marcas de tiempo también importan. Una transcripción sin referencias temporales es un bloque de texto sin estructura. Una con marcas de tiempo por frase o por párrafo se convierte en un documento buscable al que puedes volver al audio original en segundos.
Velocidad: tiempo real frente a procesamiento por lotes
Algunos flujos de trabajo necesitan resultados al instante, como los subtítulos en directo durante una reunión o un agente de un centro de llamadas que toma notas mientras el cliente sigue en la línea. Otros pueden esperar: un episodio semanal de podcast, una sesión de formación grabada o la declaración de un juicio. La transcripción en tiempo real sacrifica algo de precisión a cambio de latencia. El procesamiento por lotes invierte esa contrapartida y suele ofrecer mejor precisión, porque el modelo puede procesar el contexto completo del audio en lugar de un búfer deslizante.
Saber qué modo necesita tu flujo de trabajo reducirá tus opciones de inmediato.
Los 3 modelos de voz a texto de PicassoIA
PicassoIA te da acceso directo y sin código a tres potentes modelos de transcripción. Cada uno tiene un perfil distinto en cuanto a techo de precisión, velocidad y costo. Así se comparan.
Gemini 3 Pro: la opción de máxima precisión de Google
Gemini 3 Pro es el modelo de voz más capaz de Google disponible en la plataforma. Destaca por su razonamiento contextual durante la transcripción, lo que significa que no se limita a convertir fonemas en palabras, sino que usa el contexto circundante para elegir la palabra más probable en situaciones ambiguas. Esto lo hace especialmente sólido con:
- Vocabulario técnico y específico de cada sector: Terminología médica, jurídica y de ingeniería que suena parecida a palabras comunes.
- Audio con varios hablantes: Su salida de diarización está bien estructurada y es coherente aunque los hablantes se interrumpan.
- Grabaciones largas: Una reunión de una hora se procesa sin pérdida de precisión al final en comparación con el principio.
Si la precisión es tu prioridad y trabajas con grabaciones importantes en las que cada palabra cuenta, Gemini 3 Pro es el modelo al que conviene recurrir primero.
GPT-4o Transcribe: el caballo de batalla versátil de OpenAI
GPT-4o Transcribe lleva el modelo multimodal insignia de OpenAI a la transcripción de audio. El modelo procesa el audio directamente en lugar de convertirlo primero en una representación intermedia, lo que reduce la cascada de errores típica de los enfoques de pipeline más antiguos.
Lo que hace destacar a GPT-4o Transcribe:
- Compatibilidad multilingüe con detección automática del idioma en más de 50 idiomas.
- Contexto que se mantiene: En grabaciones que cambian de tema con frecuencia, el modelo mantiene la coherencia a lo largo de toda la transcripción.
- Robustez frente al ruido: Funciona de forma fiable con audio grabado en teléfonos inteligentes, micrófonos de equipos portátiles y grabadoras de campo.
Para la mayoría de usuarios que manejan una mezcla de grabaciones de reuniones, notas de voz y entrevistas, GPT-4o Transcribe encuentra el equilibrio adecuado entre precisión y flexibilidad.
GPT-4o Mini Transcribe: rápido y económico
GPT-4o Mini Transcribe es la herramienta adecuada cuando necesitas procesar mucho volumen con rapidez sin gastar el presupuesto. Comparte la misma línea de arquitectura que su hermano mayor, pero está optimizado para el rendimiento por encima de la máxima precisión.
Situaciones ideales para GPT-4o Mini Transcribe:
- Procesamiento por lotes de gran volumen: Decenas de grabaciones cortas que hay que transcribir en una sola sesión.
- Notas internas y reuniones rápidas de equipo: Donde una precisión del 98 % es más que suficiente.
- Borradores de primera pasada: Generar una transcripción aproximada que luego revisa y corrige un editor humano.
💡 Consejo: Procesa tu acumulado de grabaciones con GPT-4o Mini Transcribe y reserva Gemini 3 Pro para las grabaciones en las que se juega mucho.
Cómo transcribir audio en PicassoIA
PicassoIA hace el proceso sencillo. No hay credenciales de API que configurar ni software local que instalar.
Paso 1: Ve a la sección de voz a texto y selecciona el modelo que se ajuste a tu caso de uso. Para la mayoría de las grabaciones de reuniones, empieza con GPT-4o Transcribe.
Paso 2: Sube tu archivo de audio. Los formatos admitidos son MP3, MP4, WAV, M4A, FLAC y WEBM. Se admiten archivos de hasta varias horas de duración.
Paso 3: Configura tus preferencias de salida. La mayoría de los modelos te permiten especificar el idioma de salida (o la detección automática), el nivel de detalle de las marcas de tiempo (a nivel de palabra o de segmento) y si quieres etiquetas de hablante.
Paso 4: Envía y espera. El tiempo de procesamiento depende de la duración del audio. Una grabación de 60 minutos suele estar lista en menos de 3 minutos.
Paso 5: Revisa y exporta. La transcripción aparece con formato, etiquetas de hablante y marcas de tiempo. Cópiala directamente, expórtala como texto plano o envíala a tu flujo de trabajo de documentos.
💡 Para obtener los mejores resultados: Graba en un espacio con el mínimo ruido de fondo, mantén el micrófono a unos 18 pulgadas del hablante y evita grabar encima de sistemas de climatización ruidosos. Incluso pequeñas mejoras en las condiciones de grabación pueden reducir notablemente tu tasa de error de palabras.
Casos de uso reales que conviene conocer
Reuniones de equipo y reuniones de seguimiento
El beneficio más inmediato para la mayoría de los equipos es la transcripción de reuniones. En lugar de un tomador de notas designado, cada participante puede centrarse en la conversación. La transcripción se convierte en el registro: buscable y lista para compartir minutos después de que termine la llamada.
En las reuniones recurrentes, este patrón resulta especialmente potente. Las reuniones de seguimiento semanales, las revisiones de sprint y las sesiones de planificación trimestrales generan un archivo histórico que los nuevos miembros del equipo pueden leer para ponerse al día con las decisiones y el contexto. Se acabó preguntar "¿puedes resumir lo que pasó en el T3?"
Qué vigilar: Las reuniones con varios participantes que se interrumpen con frecuencia o hablan a la vez son más difíciles para los modelos de diarización. Gemini 3 Pro maneja el habla solapada mejor que la mayoría de las alternativas.
Grabaciones de podcast y entrevistas
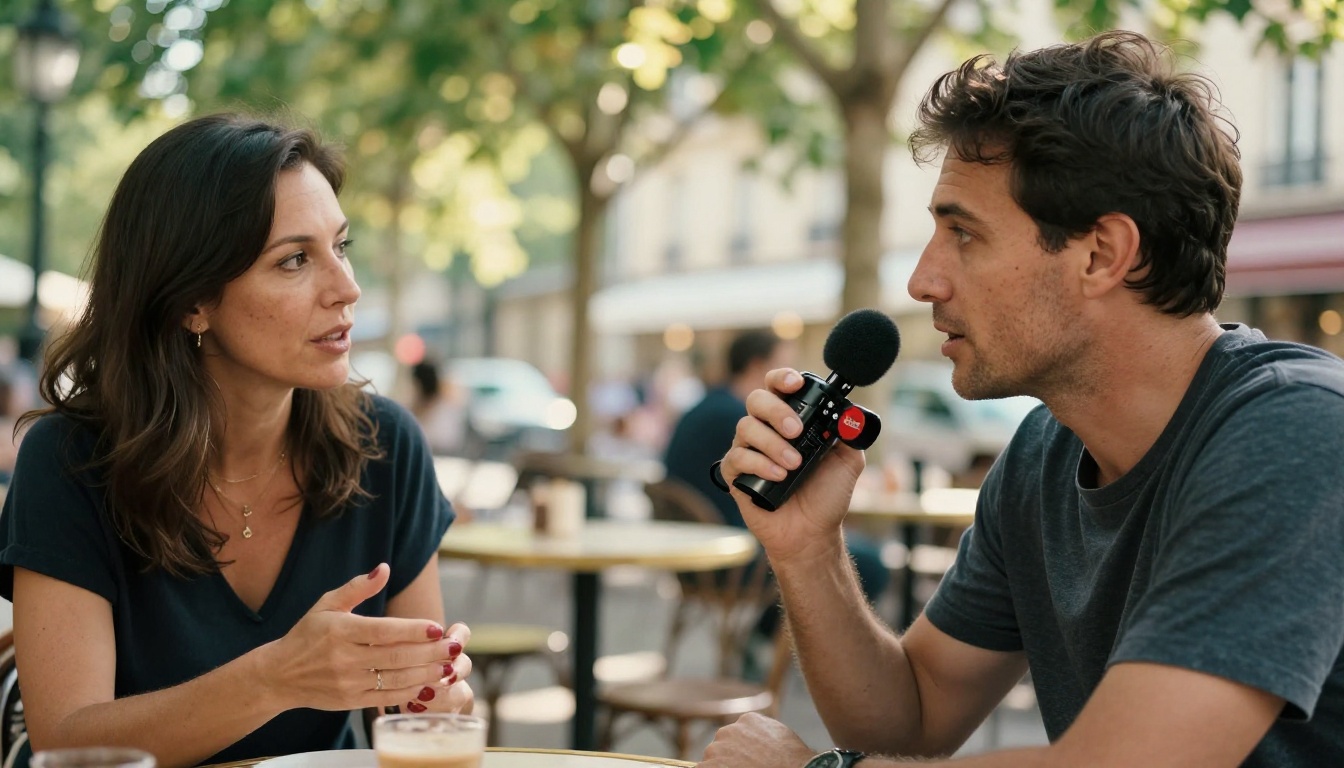
Los creadores de contenido se enfrentan a un reto de transcripción muy concreto: su audio suele tener buena calidad, pero las conversaciones no tienen guion y a menudo tratan temas muy específicos. Un modelo de transcripción estándar tropezará con una entrevista de 45 minutos sobre fabricación de semiconductores o ecología de las profundidades marinas.
La ventaja de Gemini 3 Pro en este caso es su adaptación contextual del vocabulario. No necesita haber sido entrenado con tu tema concreto; infiere la terminología probable a partir de pistas del contexto. El resultado es un primer borrador notablemente más preciso para que un editor humano lo pula.
Los equipos de podcast también usan las transcripciones para reaprovechar el contenido de forma eficiente: extraer citas para redes sociales, crear notas del programa optimizadas para SEO y generar marcadores de capítulo para facilitar la navegación por el episodio.
Llamadas con clientes y revisiones de ventas
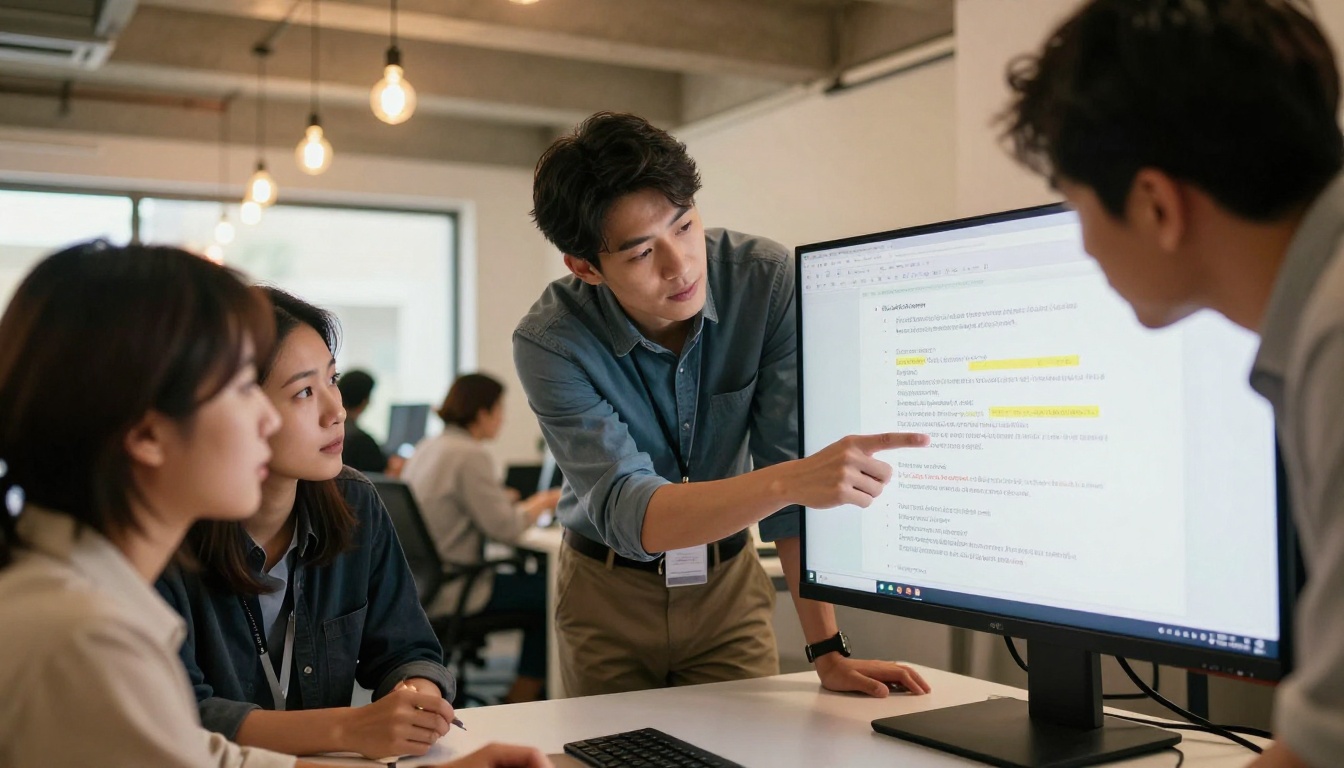
Los equipos de ventas y de éxito del cliente tienen quizá el caso de uso con mayor retorno de la transcripción con IA. Un archivo buscable de cada conversación con un cliente es una mina de oro para los equipos que saben aprovecharlo bien.
| Caso de uso | Qué saca a la luz |
|---|
| Seguimiento de objeciones | Qué inquietudes aparecen con más frecuencia antes de que una venta se cierre o se estanque |
| Menciones a competidores | Con qué frecuencia y en qué contexto se habla de los competidores |
| Oportunidades de coaching | Momentos concretos en los que puede mejorar la comunicación de un comercial |
| Señales de abandono | Patrones de lenguaje que aparecen antes de que un cliente cancele |
| Feedback de producto | Peticiones de funciones sin filtrar, con las palabras del propio cliente |
Procesar una semana de llamadas con GPT-4o Mini Transcribe por su velocidad y eficiencia de costo, y marcar los casos límite para revisarlos con Gemini 3 Pro, es un reparto práctico al que la mayoría de los equipos llegan con rapidez.
Investigación académica y trabajo de campo
Los investigadores que realizan entrevistas cualitativas afrontan una carga de tiempo importante cuando la transcripción es manual. Las entrevistas etnográficas, los grupos de discusión y las grabaciones de historia oral pueden durar horas cada una, y un solo proyecto de investigación puede incluir decenas de ellas. La transcripción con IA reduce esa carga de días a horas. El tiempo ahorrado vuelve a la interpretación de los datos en lugar de a la introducción de datos.
La precisión con hablantes no nativos de inglés o con acentos regionales es donde muchas herramientas flaquean. La base de entrenamiento multilingüe de GPT-4o Transcribe le da una ventaja clara en grabaciones de trabajo de campo con varios idiomas o con acentos muy marcados.
Precisión en distintas condiciones
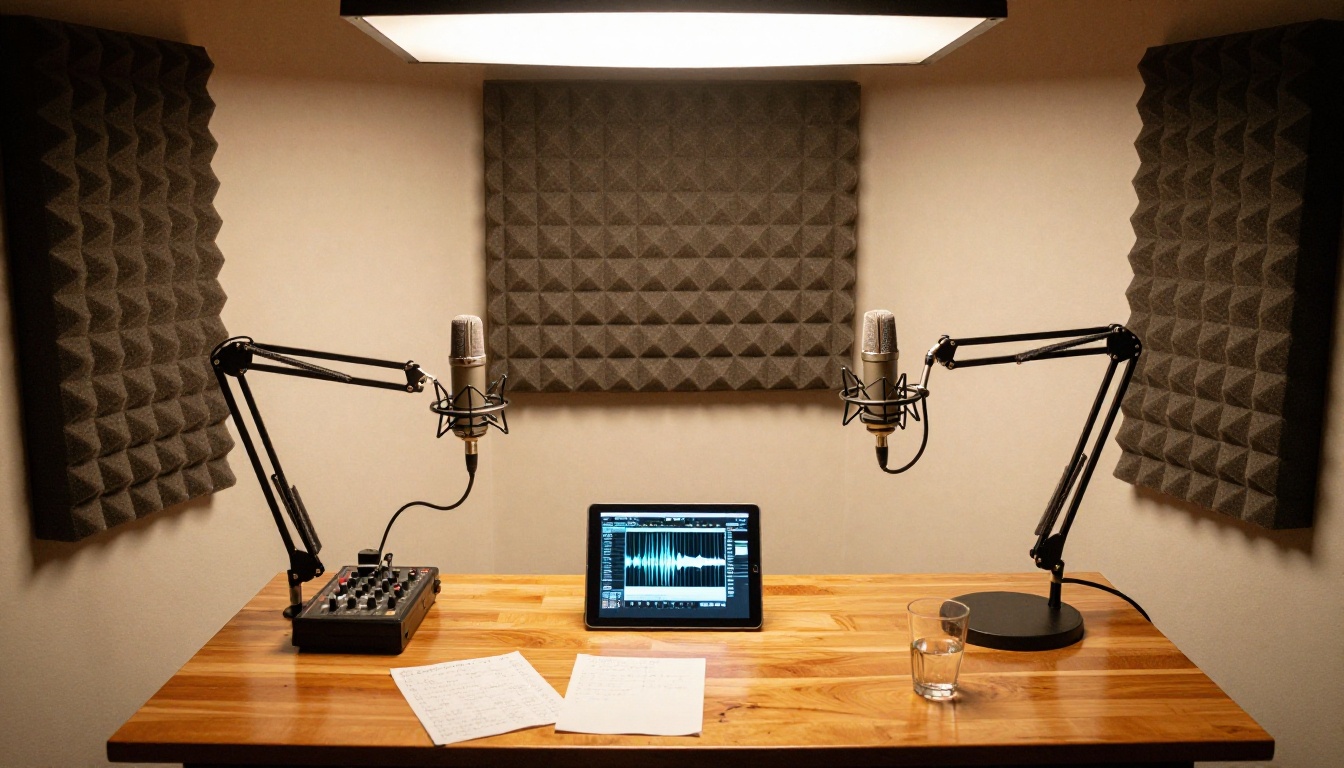
Entender cómo se comportan los modelos en distintas condiciones importa más que las puntuaciones de benchmark con audio limpio.
Ruido de fondo
El ruido de fondo de oficina, incluido el zumbido de la climatización, el tecleo, las conversaciones del pasillo y los artefactos de compresión de las videoconferencias, es la fuente más común de errores en las transcripciones reales. Los tres modelos de PicassoIA manejan bien el ruido de fondo moderado. Con niveles de ruido altos, el rendimiento se degrada en proporción a la calidad de la señal. Ningún sistema de IA transcribe lo que un humano tampoco puede entender.
Una pasada sencilla de reducción de ruido con una herramienta como Audacity antes de subir el archivo puede mejorar la precisión varios puntos porcentuales en grabaciones difíciles.
Acentos y hablantes no nativos
Aquí es donde los grandes conjuntos de datos de entrenamiento importan más. GPT-4o Transcribe y Gemini 3 Pro funcionan de manera sólida con una amplia variedad de acentos: del sur de Asia, de Asia oriental, latinoamericanos, del África occidental y de Europa del Este. Los modelos más débiles en este terreno son los sistemas más antiguos, con conjuntos de entrenamiento más estrechos que nunca vieron suficiente diversidad de acentos a gran escala.
Para contenido muy técnico con jerga específica de un sector, elegir Gemini 3 Pro por su razonamiento contextual te da la mejor oportunidad de obtener un resultado preciso a la primera.
Grabaciones largas
La precisión en los primeros 10 minutos de una grabación y la del minuto 90 pueden diferir de forma notable en los modelos más débiles. La ventana de contexto importa: un modelo que procesa el audio en fragmentos pequeños sin arrastrar el contexto cometerá errores cerca de los límites de cada fragmento, que un modelo con una ventana de contexto efectiva más larga no cometerá.
Para grabaciones de más de 45 minutos, Gemini 3 Pro es la opción recomendada precisamente por su estabilidad en contextos largos. La calidad se mantiene desde la primera frase hasta el cierre final.
Qué hacer con tu transcripción
Una transcripción en bruto es un punto de partida, no un punto final. Los flujos de trabajo más eficaces combinan la transcripción con un procesamiento posterior que extrae más valor del texto.
- Resumen: Pasa la transcripción a un modelo de lenguaje para obtener una lista con viñetas de decisiones y puntos de acción, con formato y lista para compartir.
- Detección de tono: Identifica señales emocionales en distintos segmentos de una llamada con un cliente para marcar los momentos que merecen revisión.
- Traducción: Una transcripción en inglés se traduce a cualquier otro idioma sin esfuerzo, lo que hace la localización mucho más fácil que trabajar desde el audio en bruto.
- Reaprovechamiento de contenido: Las transcripciones de reuniones o entrevistas se convierten en material de partida para artículos de blog, publicaciones en redes sociales, documentación interna y materiales de formación.
La categoría de modelos de lenguaje de PicassoIA te ofrece la capacidad de procesamiento posterior para tomar una transcripción y generar resúmenes, pares de preguntas y respuestas o informes con formato en la misma plataforma donde la transcribiste. Todo el flujo de trabajo, desde el archivo de audio hasta el documento final, se queda en un solo lugar.
Los números del costo no engañan
La transcripción manual, ya sea interna o subcontratada, cuesta entre 1 y 3 dólares por minuto de audio según el servicio. Un día completo de reuniones para un equipo de seis personas puede generar tres o más horas de contenido grabado. Eso son entre 180 y 540 dólares al día en costos de transcripción, solo en mano de obra o en tarifas de proveedores.
La transcripción con IA cuesta una fracción de eso y devuelve resultados en minutos en lugar de días. Para cualquier organización que trate las reuniones, las llamadas o el contenido grabado como un flujo de trabajo central, el cálculo hace evidente el cambio.
La cuestión más matizada son los umbrales de precisión. En procedimientos judiciales, consultas médicas y declaraciones financieras, sigue siendo necesaria una revisión profesional de las transcripciones generadas por IA. En la mayoría de contextos empresariales, el resultado de Gemini 3 Pro o de GPT-4o Transcribe es lo bastante preciso como para actuar sobre él directamente, con solo algunas correcciones ocasionales.
Los equipos que más partido sacan a la transcripción con IA no la usan para sustituir el juicio humano. La usan para eliminar el cuello de botella entre el momento en que se mantiene una conversación y el momento en que esa conversación se convierte en un activo útil y buscable.
Empieza con una sola grabación
Si tienes un archivo de reunión en tu carpeta de descargas, una grabación de Zoom de la semana pasada, un episodio de podcast por procesar o una pila de grabaciones de llamadas con clientes esperando revisión, no hay motivo para aplazarlo. PicassoIA te da acceso inmediato a Gemini 3 Pro, GPT-4o Transcribe y GPT-4o Mini Transcribe sin configuración previa ni ajustes de API.
Sube tu primer archivo, elige el modelo que se ajuste a tu caso de uso y ten una transcripción con formato, etiquetas de hablante y marcas de tiempo en minutos. La plataforma también te da acceso a herramientas de texto a voz, generación de música con IA y el conjunto completo de modelos de voz a texto para cualquier flujo de trabajo de audio que necesites.
Tus reuniones ya se están grabando. Hacerlas buscables, compartibles y accionables es el paso que realmente hace que valgan el tiempo que cuestan.


