Stable Cascade cambió las reglas de la generación de imágenes de código abierto en cuanto se lanzó. Mientras la mayoría de los modelos de la familia Stable Diffusion competían por la memoria de la GPU y la velocidad de inferencia, Stable Cascade llegó con una propuesta fundamentalmente distinta: comprimir la representación de la imagen de forma tan agresiva que el proceso de difusión resulta mucho más barato, sin sacrificar de forma significativa la calidad del resultado.
La respuesta fue un pipeline de dos etapas basado en la arquitectura Würstchen v3. Esa combinación cambió cómo podía ser la generación de imágenes con IA eficiente, y sigue siendo uno de los diseños de modelo técnicamente más interesantes del ecosistema de código abierto.
Qué es Stable Cascade realmente
Stable Cascade es un modelo de texto a imagen publicado por Stability AI a comienzos de 2024. Forma parte del ecosistema de generadores de imágenes con IA de código abierto y está disponible en Hugging Face tanto para inferencia como para ajuste fino. El modelo es una evolución directa de la arquitectura Würstchen, que dio prioridad a un espacio latente ultracomprimido como base de todo el proceso de generación.
La mayoría de la gente oye "Stable Cascade" y asume que es un checkpoint refinado dentro de la línea estándar de Stable Diffusion. No lo es. Mientras que Stable Diffusion y Stable Diffusion 3 operan en un espacio latente comprimido pero relativamente convencional, Stable Cascade comprime la representación de la imagen en un factor de 42x antes de ejecutar cualquier difusión.
No es un error de escritura. 42 veces.
No es solo otro modelo de difusión
El enfoque estándar de difusión latente, que usan la mayoría de los generadores de imágenes, incluidos SDXL y sus derivados, toma una imagen de píxeles y la codifica en una representación latente unas 8 veces más pequeña por dimensión espacial. La difusión se ejecuta entonces en ese espacio latente. Esto ofrece una aceleración notable frente a la difusión en el espacio de píxeles, pero el latente sigue siendo lo bastante grande como para contener la mayor parte de la información estructural de la imagen.
Stable Cascade va más lejos. Codifica las imágenes en un espacio latente unas 24x más pequeño por dimensión, no 8x. La contrapartida es que este latente diminuto no puede contener el detalle a nivel de píxel. Contiene información semántica y estructural: qué formas hay presentes, dónde están colocadas, cómo se relacionan los sujetos entre sí y cuál es el estado de ánimo compositivo general.
El detalle fotográfico fino se añade de nuevo en una segunda etapa. Esta es la innovación arquitectónica central.
La base de Würstchen
El proyecto de investigación Würstchen, anterior a Stable Cascade, giró en torno a una pregunta: ¿hasta qué punto puede reducirse el latente antes de que la calidad de la imagen se degrade de forma irreparable? La respuesta resultó ser mucho menor de lo que suponía la comunidad investigadora.
La versión 3 de la arquitectura, que impulsa Stable Cascade, llevó la compresión hasta sus límites prácticos y demostró que un proceso de decodificación en dos etapas podía recuperar el detalle de alta frecuencia perdido. Stability AI tomó esta investigación y la escaló hasta convertirla en un modelo de texto a imagen de nivel de producción.
La arquitectura en dos etapas
La arquitectura separa la generación en dos etapas distintas, cada una con una responsabilidad específica y sin solapamientos. Saber qué hace cada etapa es la forma más rápida de entender tanto las ganancias de eficiencia como las características de salida de Stable Cascade.
Etapa C: construir el plano
En la Etapa C ocurre el proceso de difusión principal. Dado un prompt de texto, la Etapa C produce una representación latente muy comprimida de la imagen buscada. Con una resolución de salida de 1024x1024, la Etapa C opera en un espacio latente de aproximadamente 24x24 valores.
Compáralo con SDXL, que ejecuta la difusión en un latente de 128x128 para la misma resolución de salida. El latente de la Etapa C es unas 28 veces más pequeño en número total de valores. Cada paso de difusión de la Etapa C es mucho más barato en operaciones de punto flotante.
La Etapa C usa un mecanismo de condicionamiento de texto basado en un codificador CLIP, lo que le permite codificar tanto el contenido semántico ("una mujer de pie en una azotea") como la intención compositiva ("contraluz cálido, ángulo de cámara bajo, enfoque poco profundo") en su representación comprimida.
💡 Vale la pena saberlo: Como la Etapa C opera sobre un latente diminuto, puedes ejecutar muchos más pasos de difusión dentro del mismo presupuesto de cómputo. Más pasos suelen significar mejor adherencia al prompt y composiciones más coherentes en su estructura.
Etapa B: traducir a píxeles
La Etapa B toma el latente comprimido de la Etapa C y lo decodifica en una imagen de resolución completa. No es un simple escalado bilineal ni una decodificación VAE estándar. La Etapa B es en sí misma un modelo de difusión condicionado, que usa el latente de la Etapa C como prior estructural y añade todo el detalle de alta frecuencia que faltaba en la representación comprimida.
La Etapa C es el arquitecto que produce un plano estructural preciso. La Etapa B es el artesano que construye el edificio real a partir de ese plano, añadiendo textura, detalle de materiales e información superficial fotorrealista que ningún latente comprimido podría codificar.
El resultado se beneficia de ambas: la coherencia semántica y la precisión compositiva de la Etapa C, combinadas con la fidelidad visual y el render de texturas de la Etapa B.
Dentro del espacio latente comprimido
La relación de compresión es el aspecto técnicamente más interesante de Stable Cascade. Merece un examen directo porque explica tanto su perfil de velocidad como sus fortalezas características en los resultados.
Qué significa realmente la compresión 42x
Un VAE estándar, como el que usa Stable Diffusion 3.5 Large, comprime una imagen 8 veces por dimensión espacial: una imagen de 1024x1024 se convierte en un latente de 128x128. Eso es una compresión de 64 veces en el número total de valores.
La Etapa C de Stable Cascade opera con una compresión lineal de 42x, reduciendo una imagen de 1024x1024 a un latente de unos 24x24 valores: una compresión total de aproximadamente 1.800 veces respecto al número de píxeles original. La Etapa C no intenta almacenar valores de píxel en absoluto. Almacena una codificación semántica estructurada: posiciones de los sujetos, intención de iluminación, geometría de la composición y estado de ánimo.
Por eso existe la Etapa B. La Etapa B reconstruye la información que falta condicionándose en el latente de la Etapa C y, al mismo tiempo, ejecuta su propio proceso de difusión para generar la textura y el detalle de alta frecuencia adecuados.
El beneficio de eficiencia de cómputo
El cómputo de un modelo de difusión escala aproximadamente con el cuadrado de las dimensiones espaciales del latente. La tabla siguiente muestra cómo se compara la Etapa C con los modelos existentes por paso:
| Modelo | Resolución de salida | Tamaño del latente | Cómputo relativo por paso |
|---|
| Stable Diffusion 1.5 | 512x512 | 64x64 | 100% (base) |
| SDXL | 1024x1024 | 128x128 | ~400% |
| Stable Cascade Etapa C | 1024x1024 | ~24x24 | ~14% |
| Pipeline completo de Stable Cascade | 1024x1024 | 128x128 (Etapa B) | ~414% en total |
La Etapa C por sí sola es unas 7 veces más barata por paso que ejecutar SDXL. El pipeline completo (Etapa C más Etapa B) tiene un cómputo total comparable al de SDXL, pero como la Etapa C hace la mayor parte del trabajo semántico a bajo costo, puedes permitirte más pasos donde más importan.
💡 Implicación práctica: Ejecutar 100 pasos en la Etapa C cuesta aproximadamente lo mismo que 15 pasos en SDXL. Esto cambia lo que resulta práctico para flujos de trabajo creativos iterativos y para el ajuste fino.
Cómo se compara con SDXL
La comparación más directa es con SDXL y sus derivados, ya que apuntan a la misma resolución de salida de 1024x1024 y ocupan posiciones similares en el ecosistema de código abierto.
Velocidad y memoria
Stable Cascade genera imágenes de 1024x1024 de forma notablemente más rápida que SDXL en hardware equivalente cuando se usan muchos pasos, principalmente porque el latente más pequeño de la Etapa C hace que cada paso sea más barato. En una GPU A100, Stable Cascade alcanza una calidad comparable a SDXL en unos 10-20 segundos con 100 pasos, mientras que SDXL con 30-50 pasos tarda entre 20 y 40 segundos.
El uso de VRAM cuenta una historia más matizada. La Etapa C por sí sola consume poca memoria y funciona cómodamente en GPU de consumo de 8 GB. El pipeline completo, incluida la Etapa B, usa más memoria, pero la Etapa C puede descargarse en la CPU entre etapas, lo que hace viable la generación de 1024px en equipos de consumo que tendrían dificultades con SDXL.
Adherencia al prompt y composición
Stable Cascade rinde siempre bien en precisión compositiva en evaluaciones independientes. Como la Etapa C ejecuta la difusión en un espacio latente puramente semántico y no cercano a los píxeles, los prompts complejos con varios sujetos y relaciones espaciales concretas tienden a producir resultados más coherentes en su estructura.
Los prompts que describen escenas como "dos personas a la izquierda de una mesa con un objeto rojo en el centro" producen composiciones notablemente más precisas con Stable Cascade que con ejecuciones de SDXL con parámetros comparables.
La ventaja del ecosistema de SDXL
Donde SDXL conserva una ventaja clara es en las herramientas de la comunidad. Años de ajuste fino comunitario han producido miles de checkpoints, LoRA y pesos de ControlNet de SDXL. Modelos como Dreamshaper XL Turbo reflejan la profundidad de ese ecosistema.
La biblioteca de modelos de la comunidad de Stable Cascade es más pequeña. Si tu flujo de trabajo depende de estilos estéticos concretos o de LoRA de personajes que solo existen para SDXL, el ecosistema de SDXL es más rico para ese caso de uso.
La velocidad de generación en la práctica
La velocidad no se mide solo en cifras de benchmark. Cambia por completo el flujo de trabajo creativo: cuántas variaciones de prompt puedes probar, con qué rapidez puedes refinar un concepto y qué hardware resulta realmente práctico para cada caso de uso.
Accesibilidad de las GPU de consumo
Stable Cascade se diseñó pensando en un acceso más amplio al hardware. En una GPU de 16 GB como una RTX 3080 o 4080, tanto la Etapa C como la Etapa B funcionan cómodamente a 1024x1024. El latente de la Etapa C es lo bastante pequeño como para que incluso las tarjetas de 8 GB puedan manejarlo en resoluciones moderadas, usando inferencia secuencial en lugar de por lotes.
Con SDXL a 1024px, 8 GB de VRAM exigen una gestión cuidadosa de la memoria y a menudo producen errores sin un troceado explícito de la atención o una decodificación secuencial. La Etapa C de Stable Cascade maneja ese rango de resolución con más soltura en hardware de consumo de gama media.
Generación por lotes para iterar
El cómputo barato de la Etapa C hace que la generación por lotes sea mucho más práctica. Generar 4 u 8 imágenes a la vez para comparar prompts y probar variaciones es más rápido y más eficiente en memoria que la generación por lotes con SDXL. Para los profesionales creativos que trabajan de forma iterativa, generando muchas opciones antes de elegir una para desarrollar, esto supone una ventaja real en el flujo de trabajo.
Flexibilidad del presupuesto de pasos
Como los pasos de la Etapa C son baratos, puedes ejecutar entre 80 y 120 pasos sin una penalización de tiempo significativa. Esto importa en prompts complejos, donde pocos pasos producen resultados estructurales irregulares. Con SDXL, superar los 50 pasos suele considerarse un desperdicio. Con la Etapa C de Stable Cascade, los pasos altos son asequibles y a menudo producen resultados de composición notablemente mejores.
Acceso de código abierto y comunidad
Stability AI publicó Stable Cascade con pesos disponibles públicamente en Hugging Face. Esto lo posicionó como herramienta de inferencia para producción y como base de investigación para la comunidad más amplia de IA de código abierto.
Lo que permite el acceso abierto
Para los investigadores, los pesos abiertos significan que la arquitectura es totalmente auditable. Los académicos que estudian la difusión eficiente, la compresión latente o los pipelines de generación en dos etapas pueden reproducir resultados, construir sobre la arquitectura y proponer modificaciones. El diseño de Würstchen v3 es ahora una referencia documentada y disponible para el campo.
Para los creadores, la inferencia local significa sin límites de uso de la API, sin facturación por imagen y control total del pipeline de generación y de sus resultados. Ejecutar Stable Cascade en un equipo personal es viable en un rango de hardware más amplio que el de la mayoría de los modelos comparables capaces de 1024px.
Ajuste fino a menor costo
El entrenamiento de Stable Cascade es donde la ventaja de eficiencia se acumula con más claridad. Ajustar la Etapa C con un conjunto de datos propio requiere bastante menos cómputo que ajustar SDXL en hardware equivalente. Un entrenamiento que exige 24 GB de VRAM en SDXL puede caber sin problemas en 12-16 GB en la Etapa C de Stable Cascade.
El modelo admite toda la gama de técnicas de adaptación:
- Ajuste fino completo del checkpoint con conjuntos de datos de imágenes específicos de un dominio
- Entrenamiento de LoRA para la adaptación de estilos y conceptos
- Ajuste fino al estilo DreamBooth para sujetos concretos, personas u objetos
- Variantes de inpainting construidas sobre la Etapa B para flujos de edición controlada de imágenes
Esto hace que el entrenamiento personal de modelos y la adaptación a estilos concretos sean accesibles en configuraciones de hardware que quedarían fuera del ecosistema de ajuste fino de SDXL.
Cómo es el resultado
La arquitectura y las métricas de eficiencia importan. Pero la calidad del resultado es la medida más directa de si un modelo merece la pena.
Fortalezas de composición
Stable Cascade produce imágenes con una coherencia estructural notable. Las escenas complejas con varios sujetos, relaciones espaciales definidas y detalles del entorno en capas salen bien organizadas. El pipeline en dos etapas contribuye a ello: la Etapa C resuelve la cuestión arquitectónica de qué va dónde, mientras que la Etapa B determina cómo se ve cada elemento con detalle fotográfico.
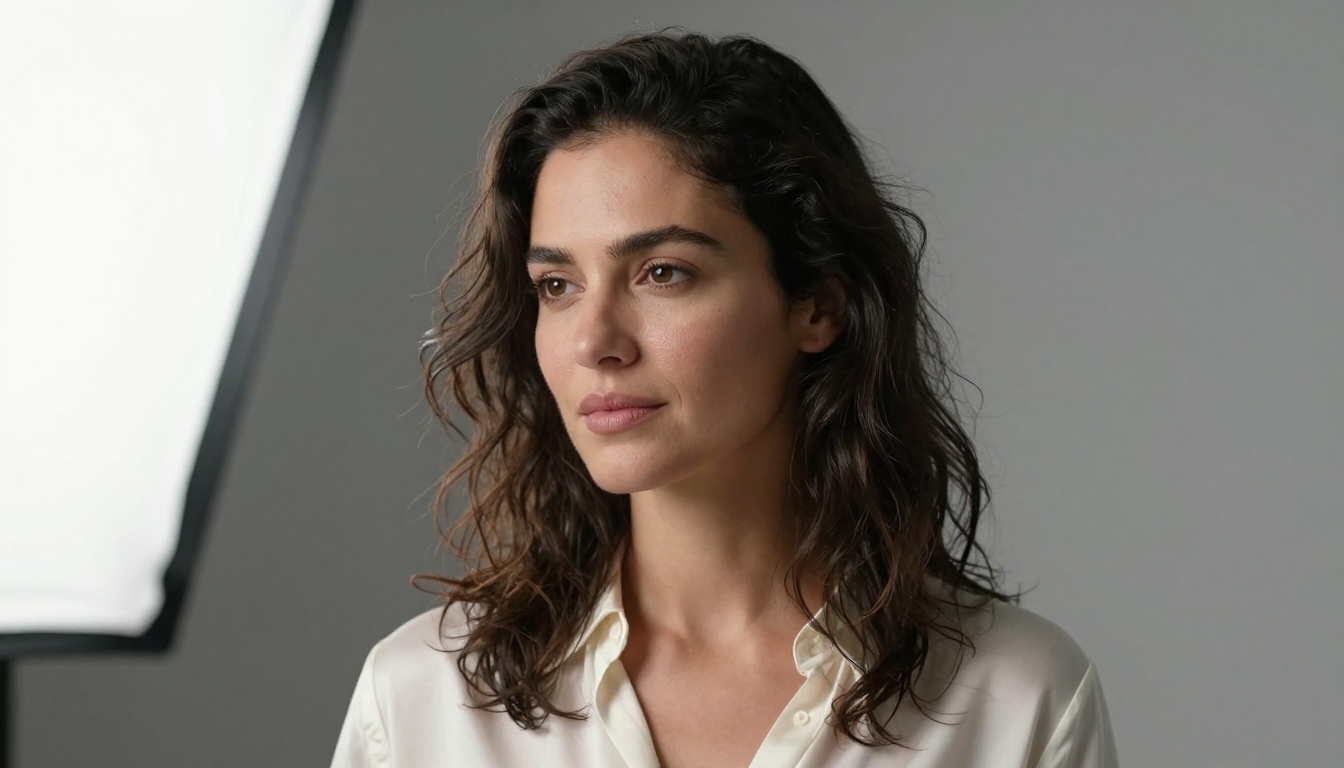
Los prompts de retrato responden especialmente bien. La textura de la piel, el detalle de los mechones de pelo, los brillos naturales en los ojos y el render realista de las telas son siempre sólidos a 1024x1024. El modelo maneja una amplia variedad de perfiles demográficos sin la tendencia a limitarse a ciertos perfiles que se observa en otros generadores.
Detalle de superficies y materiales
Las texturas finas responden bien a la reconstrucción condicionada de la Etapa B. Los materiales de construcción, los tejidos, las superficies naturales y las texturas del entorno se renderizan con alta fidelidad. Esto hace que Stable Cascade sea especialmente adecuado para:
- Fotografía de producto y naturaleza muerta en la que importa la superficie del material
- Fotografía de retrato con render detallado de piel y ropa
- Visualización de paisajes y arquitectura con texturas naturales
- Fotografía de moda con detalle preciso de telas y prendas
Limitaciones reconocidas
Stable Cascade comparte las debilidades conocidas de la mayoría de los modelos de difusión: las manos, el texto denso en las imágenes y la anatomía en primerísimo plano siguen siendo un reto. La compresión de la Etapa C es lo bastante agresiva como para que las relaciones espaciales finas dentro de objetos pequeños puedan codificarse de forma imprecisa antes de que la Etapa B tenga la información necesaria para reconstruirlas con exactitud.
Las poses de manos complejas y las manos superpuestas en el encuadre son los artefactos más comunes. Es una limitación conocida y documentada, compartida con prácticamente todos los sistemas actuales de texto a imagen de código abierto.
Eficiencia de entrenamiento e impacto en la investigación
El impacto estructural de Stable Cascade va más allá de su caso de uso inmediato. Demostró algo arquitectónicamente significativo para la comunidad investigadora en general.
Prueba de concepto de la compresión extrema
Antes de Stable Cascade, la suposición dominante era que una calidad competitiva de 1024px requería espacios latentes de al menos 64x64 valores. El trabajo de Würstchen cuestionó esto directamente, y Stable Cascade lo validó a escala.
El resultado fue una prueba publicada de que la compresión latente extrema es compatible con una síntesis fotorrealista de alta calidad, siempre que haya una etapa decodificadora capaz. Esto influyó en el diseño de las arquitecturas de modelos posteriores, incluso en las que no adoptaron directamente el enfoque de dos etapas de Würstchen.
Ventajas de una arquitectura modular
La separación entre Etapa C y Etapa B crea un sistema modular con rutas de mejora diferenciadas. Un decodificador de Etapa B mejor puede entrenarse e intercambiarse sin reentrenar la Etapa C. Una Etapa C específica de un dominio, entrenada con imágenes médicas, fotografía satelital o catálogos de productos, puede combinarse con el decodificador de Etapa B de uso general sin reentrenar todo el pipeline.
Esta modularidad es poco habitual en los modelos de difusión y abre posibilidades interesantes para aplicaciones especializadas, donde una etapa puede congelarse mientras la otra se adapta.
Reducir la barrera del entrenamiento
El entrenamiento original de SDXL requirió miles de horas de GPU A100. La Etapa C de Stable Cascade, que opera en su espacio latente diminuto, puede ajustarse por completo desde cero con conjuntos de datos propios usando una fracción de ese cómputo. Investigadores independientes, pequeños estudios creativos y laboratorios universitarios sin acceso a grandes clústeres de GPU ya pueden entrenar sistemas de texto a imagen competitivos.
Es un cambio estructural en quién puede construir y poseer capacidades de generación de imágenes con IA.
Casos de uso prácticos
El valor de la arquitectura depende de sus aplicaciones reales. Stable Cascade encaja en un conjunto de casos de uso concretos mejor que cualquier otro modelo de código abierto de su época.
Iteración visual rápida
Los profesionales creativos que necesitan evaluar muchos conceptos visuales con rapidez (directores de arte, diseñadores de marca, concept artists) se benefician directamente del menor costo por generación de Stable Cascade. Generar 20 variaciones de composición para elegir 3 y desarrollarlas es algo práctico que los modelos más caros hacen costoso.
Inferencia local en hardware de consumo
Si trabajas con una GPU de gama media en casa, sin acceso a cómputo en la nube, Stable Cascade ofrece generación a 1024x1024 que antes no estaba disponible en ese nivel de hardware. El latente de la Etapa C es lo bastante pequeño como para que la inferencia sea posible sin recursos de GPU de nivel empresarial.
Desarrollo de modelos específicos de un dominio
Los equipos que quieran modelos de texto a imagen especializados para sectores concretos, sin presupuestos de entrenamiento enormes, deberían considerar Stable Cascade como base. La moda, la visualización arquitectónica, la fotografía de producto y la ilustración médica son ámbitos en los que una Etapa C de Stable Cascade ajustada podría superar a un checkpoint genérico de SDXL con una fracción del costo de entrenamiento.
Su lugar en el ecosistema más amplio
El ámbito de la generación de imágenes con IA avanzó con rapidez tras el lanzamiento de Stable Cascade. Modelos como Flux Dev, Flux Pro y Flux Schnell han llevado después lo más avanzado aún más lejos, tanto en calidad como en velocidad. Pero la aportación arquitectónica de Stable Cascade, en concreto la prueba de que la compresión latente extrema es viable para la síntesis de alta calidad, influyó en el pensamiento que dio lugar a esos modelos.
Su legado es tanto conceptual como práctico.
Empieza a generar hoy
Si quieres experimentar lo que es capaz la generación de imágenes modernas de código abierto sin configurar entornos locales ni gestionar recursos de GPU, PicassoIA te da acceso directo a toda la gama de modelos disponibles.
La plataforma incluye la familia completa de Stable Diffusion, desde el Stable Diffusion original, pasando por Stable Diffusion 3 y Stable Diffusion 3.5 Large, junto con arquitecturas más nuevas como Flux Dev, Flux Pro, Flux Schnell y Dreamshaper XL Turbo.
Los principios que hicieron técnicamente relevante a Stable Cascade (adherencia al prompt, coherencia estructural y síntesis eficiente de alta resolución) se ven en los resultados que producen estos modelos. La mejor forma de formarte una opinión fundamentada sobre todo esto es escribir un prompt y ver qué sale.
Sin teoría necesaria. Solo pruébalo.


