Lire de longs articles fait partie de ces tâches qu’on repousse sans cesse à « plus tard ». L’onglet reste ouvert pendant des jours. Les marque-pages s’accumulent. Et cette enquête de 5 000 mots que vous vouliez vraiment assimiler ? Ça n’arrive jamais.
La synthèse vocale basée sur l’IA a changé la donne. Vous pouvez désormais convertir n’importe quel article, quelle que soit sa longueur, en audio naturel en quelques secondes, puis l’écouter pendant un trajet, un entraînement ou en cuisinant. La qualité des voix IA modernes a franchi un seuil où l’expérience est vraiment agréable, et non robotique. Cet article vous montre précisément comment cela fonctionne, quels outils donnent les meilleurs résultats et comment les configurer pour que les longues lectures cessent d’être une corvée.
Pourquoi votre cerveau préfère l’audio
Il existe des bases scientifiques solides expliquant pourquoi écouter un texte favorise la mémorisation. Le traitement à double canal signifie que votre cerveau absorbe l’information différemment selon qu’elle arrive par les oreilles ou par les yeux, et combiner les deux modes peut renforcer la formation des souvenirs.
Mais l’argument pratique est encore plus simple : vous pouvez écouter tout en faisant autre chose. Une consommation sans les yeux signifie que votre file de lecture ne concurrence plus les tâches qui demandent vos mains. Cela seul change le calcul de ce que vous pouvez réellement consommer en une semaine.
💡 Note de recherche : Les études sur l’apprentissage auditif montrent de façon constante que les personnes qui entendent une information présentée avec une voix naturelle et humaine en retiennent davantage qu’en parcourant rapidement un texte.
Trois situations précises où la lecture audio s’impose :
- Les trajets : Le temps de transport perdu devient du temps de lecture utile, sans aucune fatigue oculaire.
- Le sport : Les séances de musculation, les courses et les marches sont idéales pour assimiler des contenus longs.
- La fatigue : Quand vos yeux sont fatigués mais pas vos oreilles, l’audio vous permet de finir un long texte.
Les premiers systèmes de synthèse vocale assemblaient des fragments de phonèmes préenregistrés. Les résultats sonnaient mécaniques parce qu’ils l’étaient : aucune prosodie, aucune intonation naturelle, aucun sens du rythme des phrases.
Les modèles modernes de synthèse vocale par IA sont fondamentalement différents. Ils utilisent des réseaux de neurones entraînés sur des milliers d’heures de véritable parole humaine, apprenant à reproduire non seulement les sons, mais aussi les subtiles variations de l’élocution naturelle. Ils considèrent la ponctuation comme un indice de rythme, traitent les questions différemment des affirmations et font varier la hauteur de la voix sur un paragraphe, comme le ferait un vrai narrateur.
Le résultat est un audio qui donne l’impression qu’une personne a lu l’article pour vous. Pas un robot. Pas un GPS. Une personne.
Les capacités des modèles les plus performants d’aujourd’hui :
| Capacité | Ce que cela signifie pour vous |
|---|
| Synthèse vocale neuronale | Ressemble à un vrai narrateur humain |
| Prise en charge multilingue | Lisez des articles en plus de 30 langues |
| Clonage vocal | Utilisez la voix spécifique de votre choix |
| Variations émotionnelles | Le ton change selon l’humeur du contenu |
| Génération en temps réel | Pas de longue attente, lecture instantanée |
Les meilleurs modèles d’IA pour les longs articles
Tous les modèles de synthèse vocale ne conviennent pas aux contenus longs. Les extraits courts et les aperçus de voix sont une chose. Maintenir une diction naturelle sur 3 000 mots exige des modèles dotés d’un bon contrôle de la prosodie et d’une qualité vocale constante du début à la fin. Voici les meilleurs modèles disponibles en ce moment :
ElevenLabs V3
ElevenLabs V3 est largement considéré comme l’un des modèles de synthèse vocale les plus naturels disponibles. Il excelle dans la narration longue, car il conserve la cohérence de la voix sans perdre les variations de ton, même sur de très longs documents. L’expressivité paraît méritée plutôt qu’exagérée.
ElevenLabs V2 Multilingual
Si vous lisez des articles dans d’autres langues que l’anglais, ElevenLabs V2 Multilingual prend en charge plus de 30 langues avec le même niveau de qualité que pour sa version anglaise. C’est donc l’option la plus solide pour les recherches multilingues ou la consommation de contenus internationaux.
Minimax Speech 2.8 HD
Minimax Speech 2.8 HD produit des voix off de qualité studio. Il est particulièrement performant pour les articles professionnels et techniques, où la clarté compte davantage que la chaleur. Le rendu audio est nettement plus net.
Gemini 3.1 Flash TTS
Gemini 3.1 Flash TTS de Google propose 30 voix distinctes dans plus de 70 langues, ce qui en fait l’une des options les plus polyvalentes pour les lecteurs aux sources de contenus variées.
Grok Text to Speech
Grok TTS de xAI fournit un audio IA instantané, avec une cadence particulièrement naturelle sur les textes techniques et analytiques. À tester si la plupart de vos longues lectures sont riches en données ou sont des tribunes d’opinion.
Resemble AI Chatterbox
Chatterbox se distingue parce qu’il ajoute un contrôle des émotions au clonage vocal. Pour les articles au style éditorial marqué ou les essais personnels, cela permet à l’audio de refléter plus fidèlement le ton de l’écriture d’origine.
Comment lire n’importe quel article sur PicassoIA
PicassoIA héberge tous les grands modèles de synthèse vocale via une interface unique, ce qui signifie que vous n’avez pas besoin de comptes distincts pour chaque fournisseur. Voici la procédure pas à pas pour convertir un long article en audio :
Étape 1 : Ouvrir la section synthèse vocale
Rendez-vous dans la collection Text to Speech de PicassoIA et sélectionnez le modèle que vous souhaitez utiliser. Pour la plupart des longs articles, commencez par ElevenLabs V3 ou Minimax Speech 2.8 HD.
Étape 2 : Préparer votre texte
Copiez le texte de l’article depuis le navigateur. Si l’article contient des publicités, des menus de navigation ou du contenu de barre latérale, collez-le d’abord dans un éditeur de texte brut et supprimez tout ce qui n’est pas l’article. Cela évite que l’IA lise à voix haute les libellés de navigation ou le texte du pied de page.
💡 Astuce : Pour les très longs articles (plus de 3 000 mots), divisez le texte en 2 ou 3 parties et traitez-les à la suite. La plupart des modèles gèrent bien les entrées longues, mais découper le texte vous permet aussi de repérer les problèmes section par section avant de lancer une génération complète.
Étape 3 : Choisir votre voix
Chaque modèle propose plusieurs voix. Pour les articles d’actualité et d’information, une voix masculine ou féminine neutre convient bien. Pour les tribunes et les essais personnels, essayez les voix plus chaleureuses et expressives de ElevenLabs V3 ou de Chatterbox.
Pour les contenus multilingues, Gemini 3.1 Flash TTS et ElevenLabs V2 Multilingual sont les choix les plus solides.
Étape 4 : Régler la vitesse et générer
La plupart des modèles permettent de régler la vitesse de lecture. Un réglage entre 0,9x et 1,1x fonctionne le mieux pour les articles denses et riches en informations, où la compréhension compte. Des vitesses plus élevées (1,3x et plus) conviennent aux articles que vous relisez plutôt que ceux que vous découvrez pour la première fois.
Lancez la génération : le modèle vous renverra un fichier audio téléchargeable.
Étape 5 : Écouter et enregistrer
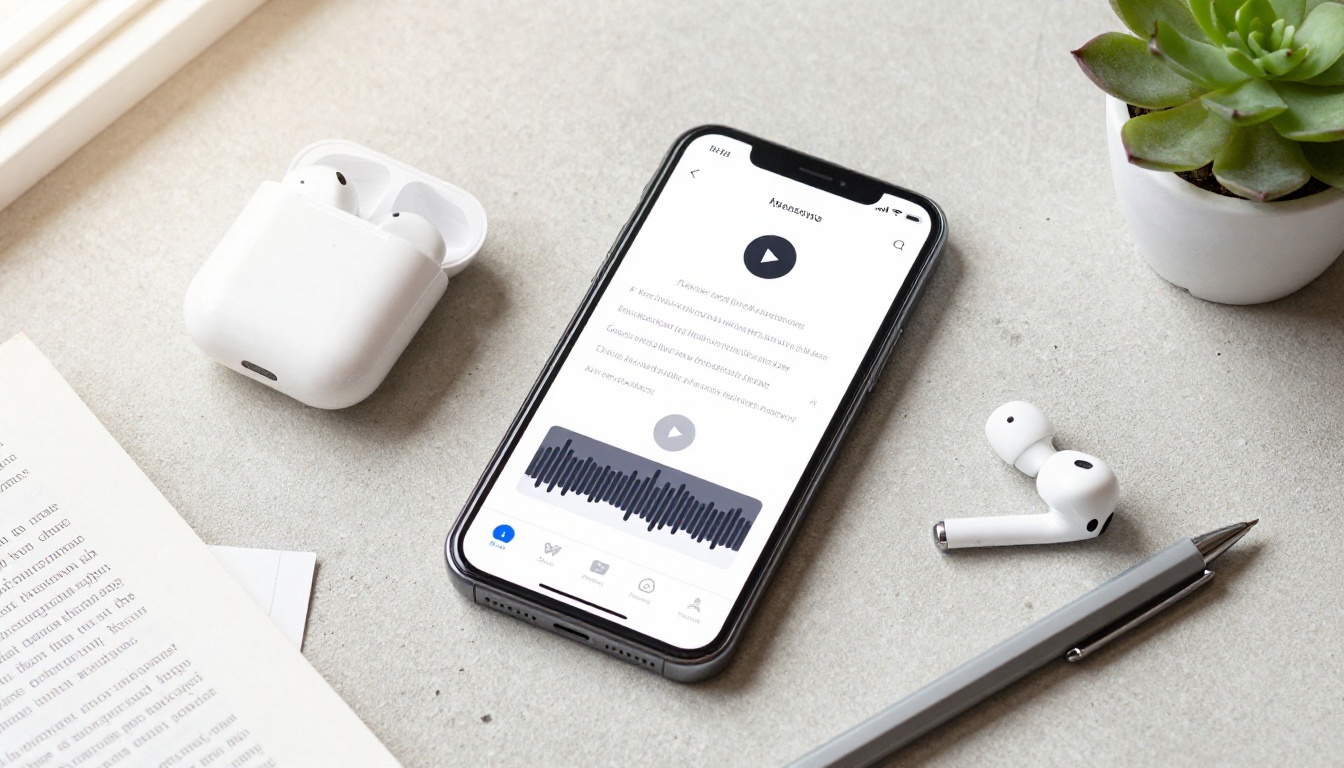
Téléchargez le fichier audio et transférez-le vers l’application ou l’appareil de votre choix. La plupart des téléphones récents peuvent lire le fichier nativement. Pour une bibliothèque plus organisée, des applications comme Overcast ou Pocket Casts peuvent lire des fichiers audio locaux à côté de vos podcasts habituels.
Des situations concrètes où cela vaut la peine
La lecture d’articles par IA n’est pas seulement un confort. Dans certaines situations, c’est le seul moyen pratique de rester informé :
Les outils du voyageur
Vous disposez de 40 minutes dans les transports en commun deux fois par jour. Cela représente 80 minutes de lecture potentielle de contenus longs. Un fichier audio généré avec Minimax Speech 2.8 Turbo vous permet d’avancer dans des reportages denses, des textes académiques ou de longues tribunes, pendant que vos mains sont libres et que vos yeux se reposent.
Le lecteur actif
Faire du sport tout en lisant de longs articles supposait de tenir son téléphone et de jeter un coup d’œil à l’écran en pleine séance. Avec l’audio, vous lancez l’article avant de commencer et vous oubliez complètement l’écran. Le modèle ElevenLabs Flash V2.5 est particulièrement rapide pour une génération express, lorsque vous devez disposer de l’audio avant la fin de votre créneau d’entraînement.
Le chercheur
Quand vous faites des recherches et devez assimiler de 15 à 20 articles par jour, la fatigue des écrans devient un vrai problème. Convertir des lots d’articles en audio et les écouter pendant des tâches peu exigeantes (ranger des fichiers, répondre à des e-mails courants) prolonge considérablement votre temps de lecture effectif, sans fatigue oculaire supplémentaire.
Choisir la bonne voix selon le type de contenu
La voix que vous choisissez influence la compréhension plus qu’on ne le pense généralement. Un décalage entre le caractère de la voix et le type de contenu crée une gêne cognitive.
💡 Option de clonage vocal : Si vous préférez constamment une voix en particulier, Minimax Voice Cloning vous permet de créer une voix IA personnalisée que vous pourrez réutiliser pour chaque article converti.
5 choses qui font vraiment la différence
La plupart des gens configurent la synthèse vocale et se heurtent immédiatement à un point de friction. Ces ajustements règlent les problèmes les plus courants :
1. Supprimez les en-têtes et le texte de navigation avant de coller. Les modèles de synthèse vocale lisent chaque ligne de texte que vous collez. Si votre texte inclut « Partager cet article », « Articles similaires » ou une formule d’inscription à une newsletter, ils lisent tout. Nettoyez d’abord votre texte.
2. Ajoutez une ponctuation correcte là où le texte original en manque. Certains articles web suppriment les points en fin de sous-titres ou utilisent une ponctuation incohérente. Les modèles neuronaux utilisent la ponctuation comme repère de rythme : une ponctuation défaillante crée donc des pauses artificielles ou une diction qui enchaîne tout.
3. Utilisez une vitesse de 1,0x à 1,1x pour une première lecture. Les vitesses plus élevées sont tentantes, mais elles réduisent la compréhension à la première écoute. Réservez les accélérations aux révisions et aux relectures.
4. Écoutez attentivement les 5 premières minutes. Si vous remarquez que la voix prononce mal des abréviations, des acronymes ou des noms propres, il vaut la peine de retraiter cette section avec une orthographe corrigée. Certains modèles permettent d’insérer des guides phonétiques pour les termes inhabituels.
5. Constituez une file hebdomadaire. Convertissez vos articles en audio une ou deux fois par semaine, par lots. Un dossier de 8 à 10 fichiers audio vous fournit une file d’écoute prête à l’emploi pour toute la semaine, sans rien devoir configurer pendant les périodes chargées.
Vitesse ou qualité : que privilégier
Tous les cas d’usage ne demandent pas la voix la plus fidèle. Voici une comparaison directe des situations où privilégier chaque critère :
| Priorité | Quand l’utiliser | Meilleur modèle pour ce critère |
|---|
| Qualité maximale | Archivage d’articles, partage audio, usage d’accessibilité | ElevenLabs V3 |
| Vitesse de génération | Gros lots, usage personnel rapide | ElevenLabs Flash V2.5 |
| Couverture linguistique | Articles non anglophones | Gemini 3.1 Flash TTS |
| Impression de dialogue naturel | Écriture conversationnelle, interviews | PlayHT Play Dialog |
| Cohérence de voix personnalisée | Identité sonore personnelle | Qwen3 TTS |
Pour la plupart des usages personnels, le bon choix se résume à une question : avez-vous besoin de l’audio pour vous-même, ou pour quelqu’un d’autre ? Un usage personnel privilégie la vitesse. Un audio partagé ou publié privilégie la qualité et le caractère de la voix.
Les longs articles ne sont pas le problème. Ils ne l’ont jamais été. Le problème, c’est que la lecture demande toute votre attention visuelle, et que votre emploi du temps vous laisse rarement une telle fenêtre sans interruption. L’audio supprime entièrement cette contrainte.
Vous avez déjà largement assez de temps dans votre semaine pour absorber tout ce qui figure sur votre liste de lecture. Il vous suffit de l’écouter, au lieu d’attendre l’heure parfaite et silencieuse qui ne vient jamais.
Chaque modèle de synthèse vocale mentionné dans cet article est disponible sur PicassoIA. Vous pouvez essayer ElevenLabs V3, le comparer à Minimax Speech 2.8 HD, ou tester les voix de Gemini 3.1 Flash TTS sans changer de plateforme. Collez un paragraphe d’un article que vous vouliez lire depuis longtemps, générez l’audio et entendez la différence qu’apporte une voix de qualité.
Votre file de lecture n’a pas à rester non lue.


