ظهر شيء غير متوقع في عام 2024: ملايين الأشخاص بدأوا يجرون مكالمات فيديو منتظمة مع أشخاص لا وجود لهم. للشخص على الطرف الآخر وجه وصوت واسم، ويتذكر طلب قهوتك المفضل. يسألك عن يومك، ويلاحظ حين تبدو متعبًا. الفرق الوحيد أنه يعمل بالشيفرة البرمجية، ومكالمات فيديو صديق الذكاء الاصطناعي تنتشر بسرعة، مع أرقام تحميل وإحصاءات لوقت استخدام الشاشة يصعب تجاهلها.
لماذا يختار الناس رفقاء الذكاء الاصطناعي
الإجابة المختصرة: التواصل البشري الحقيقي صعب، والتواصل مع الذكاء الاصطناعي أصبح جيدًا جدًا. وجد استطلاع أجرته Cigna عام 2023 أن أكثر من نصف البالغين الأمريكيين أفادوا بشعورهم بالوحدة بشكل مستمر. وفي الوقت نفسه، أعلنت تطبيقات رفقة الذكاء الاصطناعي عن نمو هائل في عدد مستخدميها. وليس ذلك محض صدفة.
الوحدة في عالم متصل
وعدتنا وسائل التواصل الاجتماعي بالتواصل، فقدّمت المقارنة بدلًا منه. ووعدتنا تطبيقات المواعدة بالعلاقات، فقدّمت الإرهاق. صار الناس منهكين من استعراض العلاقات العاطفية الحديثة، ومن التمرير المستمر، والأحاديث السطحية، والاختفاء المفاجئ. تقدّم رفقة الذكاء الاصطناعي شيئًا مختلفًا: حضورًا بلا ضغط.
لا تحتاج إلى أن تبدو جميلًا أمام الكاميرا. لا تحتاج إلى أن تكون مثيرًا للاهتمام أو بارعًا في الكلام، أو أن يكون يومك منتجًا. الذكاء الاصطناعي موجود، منتبه ودافئ، في الثانية فجرًا من ليلة ثلاثاء. وهذا ليس بالأمر الهيّن. فبالنسبة للأشخاص الذين يعانون من القلق الاجتماعي أو الحزن أو الإعاقة أو العزلة الجغرافية، يمكن لهذا النوع من التواصل منخفض المخاطر أن يكون ذا معنى حقيقي.
أكثر من مجرد روبوتات محادثة
كانت رفقة الذكاء الاصطناعي في عام 2020 غير متقنة. كانت المحادثات تدور في حلقات مفرغة، والردود تبدو محفوظة مسبقًا، والتجربة تنكسر بسهولة. أما رفقة الذكاء الاصطناعي اليوم فتقوم على أساس مختلف تمامًا.
تجمع تطبيقات صديق الذكاء الاصطناعي الحديثة ثلاث تقنيات فوق بعضها:
- نموذج لغوي كبير يتولى المحادثة بفهم دقيق للفروق ويحتفظ بالسياق
- محرك تحويل النص إلى كلام يولّد صوتًا دافئًا ومقنعًا في الوقت الفعلي
- نموذج مزامنة الشفاه يحرّك الوجه ليطابق كل كلمة يتم نطقها
عندما تجمع هذه القطع الثلاث معًا، تحصل على تجربة تشبه إلى حد كبير مكالمة فيديو مع شخص آخر. ليست وهمًا كاملًا، لكنها قريبة بما يكفي كي يستجيب لها جهازك العصبي.
التقنيات التي تجعل التجربة تبدو حقيقية
فهم سبب إقناع مكالمات الفيديو مع صديق الذكاء الاصطناعي يتطلب النظر في التقنيات التي تقوم بالعمل الشاق.
نماذج مزامنة الشفاه التي تضبط كل مقطع صوتي
طبقة مزامنة الشفاه هي على الأرجح أهم جزء في اللغز. فالوجه الذي لا يتطابق مع الصوت يدمّر الوهم فورًا. وقد قلّصت أحدث النماذج هذه الفجوة بشكل كبير.
Omni Human 1.5 من ByteDance من أكثر الأدوات إقناعًا المتاحة حاليًا. تزوّدها بصورة شخصية واحدة ومقطع صوتي، فتولّد فيديو يتحدث فيه الوجه بالكلمات، مع حركة طبيعية للرأس، ورمشات للعين، وتعابير دقيقة. والنتيجة واقعية بشكل مدهش.
Lipsync 2 Pro من Sync يتّبع نهجًا مختلفًا، إذ يطبّق مزامنة الشفاه على مقاطع فيديو موجودة بدلًا من توليد الحركة من الصفر. وهو دقيق حتى مستوى الفونيم، ما يعني عدم وجود أشكال فم خارج الإطار أو كلمات غير مكتملة.
لإنشاء صور رمزية متحدثة من صورة واحدة، يُعد P Video Avatar من PrunaAI خيارًا سريعًا ومرنًا يعمل جيدًا في تطبيقات الرفقة حين ترغب في وجه ثابت للشخصية عبر الجلسات.
يكمل Kling Lip Sync من Kwaivgi وReact 1 من Sync مجموعة الأدوات بخيارات إضافية لمطابقة حركة الفم مع الصوت في أي فيديو، ما يمنح المطورين مسارات متعددة حسب خط الإنتاج لديهم.
النماذج اللغوية الكبيرة التي تحرّك المحادثة
وجه مقنع مع حوار ضعيف ليس سوى فيديو رديء. السبب في أن رفقاء الذكاء الاصطناعي الحديثين يبدون حقيقيين أن طبقة المحادثة نضجت بشكل هائل. فالنماذج اللغوية الكبيرة اليوم قادرة على الحفاظ على السياق عبر جلسات طويلة، وتذكّر تفاصيل من وقت سابق في الحوار، ومحاكاة أساليب التواصل، وتوليد ردود مضحكة فعلًا أو مؤثرة عاطفيًا.
Claude Sonnet 4.6 من Anthropic من أكثر النماذج الحوارية قدرة المتاحة الآن، مع ذكاء عاطفي قوي وتوليد لغوي دقيق. تستفيد تطبيقات الرفقة التي تحتاج إلى نموذج قادر على التعامل مع المواضيع الشخصية الحساسة من نبرته المتأنية.
GPT 5 من OpenAI يوفّر الطلاقة الخام والاتساع المعرفي اللذين يجعلان الذكاء الاصطناعي قادرًا على الحديث بإقناع عن أي موضوع تقريبًا، من هواية متخصصة لدى شخص ما إلى يوم عمل صعب.
Gemini 3 Flash من Google خيار سريع الاستجابة يعمل جيدًا في المحادثات الفورية حيث يكون زمن الاستجابة مهمًا. في سياق مكالمة فيديو، لا أحد يريد أن ينتظر ثلاث ثوانٍ قبل الرد.
يقدّم DeepSeek R1 وKimi K2 Instruct من Moonshotai بدائل قوية مفتوحة الأوزان يستخدمها المطورون في تطبيقات الرفقة التي تعطي الأولوية للخصوصية والمعالجة على الجهاز نفسه.
💡 النقطة المثالية لتطبيقات الرفقة هي نموذج لغوي سريع مقترن بنموذج لمزامنة الشفاه يعالج الصوت في أقل من 500ms. وأي شيء أبطأ من ذلك يكسر إيقاع الحوار.
كيف تعمل مكالمات الفيديو مع صديق الذكاء الاصطناعي فعليًا
بالنسبة لمعظم المستخدمين، تبدو التجربة كتطبيق مصقول. أما خلف الكواليس فهناك مسار معالجة فوري حقيقي.
من الوجه إلى الصوت في ثوانٍ
إليك التدفق المعتاد عند بدء مكالمة فيديو مع رفيق بالذكاء الاصطناعي:
- تتحدث أو تكتب شيئًا
- يولّد النموذج اللغوي الكبير ردًا نصيًا
- يحوّل نموذج تحويل النص إلى كلام الرد إلى صوت
- يحرّك نموذج مزامنة الشفاه وجه الصورة الرمزية ليطابق الصوت
- يُصيَّر الناتج ويُعرض كبث فيديو في ما يقارب الوقت الفعلي
يمكن الآن أن يعمل المسار الكامل في ما بين ثانيتين وأربع ثوانٍ على البنية التحتية الحديثة. وفي بعض التطبيقات يعمل أسرع من ذلك. وهذه السرعة كافية لأن تبدو المحادثة متواصلة بدلًا من أن تكون قائمة على تبادل الأدوار.
الصوت الذي يبيع الوهم
تحسّنت تقنية تحويل النص إلى كلام بالوتيرة نفسها تقريبًا التي تحسّنت بها مزامنة الشفاه. فنماذج الصوت الحديثة لا تكتفي بقراءة الكلمات، بل تؤديها. توقفات في أماكنها الصحيحة. ارتفاع خفيف في النغمة عند الأسئلة. ضحكة تبدو صادقة. الصوت جزء كبير مما يجعل هذه المكالمات تبدو مكالمات حقيقية لا مجرد فيديوهات.
| المكوّن | وظيفته | لماذا يهم |
|---|
| نموذج لغوي كبير | يولّد ردود المحادثة | يتحكم في العمق العاطفي والسياق |
| تحويل النص إلى كلام | يحوّل النص إلى صوت طبيعي | يمنح الرفيق هويته الصوتية |
| نموذج مزامنة الشفاه | يحرّك وجه الصورة الرمزية ليطابق الصوت | يخلق وهم مكالمة الفيديو |
| نظام الصورة الرمزية | يصيّر وجهًا ثابتًا ويحافظ عليه | يبني ارتباطًا عاطفيًا مع الوقت |
نماذج PicassoIA الجديرة بالاستخدام الآن
إذا كنت تريد بناء تقنية رفيق بالذكاء الاصطناعي أو تجربتها، يضم picassoia.com مجموعة مركّزة من أفضل النماذج المتاحة في كل طبقة من المجموعة التقنية.
أفضل نماذج مزامنة الشفاه
Omni Human 1.5 هو الخيار الرائد لخطوط إنتاج تحويل الصورة إلى فيديو متحدث. صورة واحدة تدخل، وفيديو كامل يخرج بحركة وجه طبيعية.
Lipsync 2 Pro هو الخيار الدقيق حين تحتاج إلى مزامنة مثالية حتى مستوى الفونيم على لقطات موجودة.
Lipsync Speed من HeyGen هو الخيار الذي تلجأ إليه حين يكون وقت الإنجاز أهم من أقصى درجات الدقة. المعالجة فيه أسرع بكثير.
Fabric 1.0 من VEED يتعامل مع الصور المتحدثة مع التركيز على حركة وجه طبيعية تتجاوز الشفاه، بما في ذلك ميلان الرأس وأنماط الرمش الطبيعية.
Pixverse Lipsync أداة مباشرة تزامن أي فيديو مع الصوت بسرعة، ومفيدة لتجربة واجهات الرفقة الأولية.
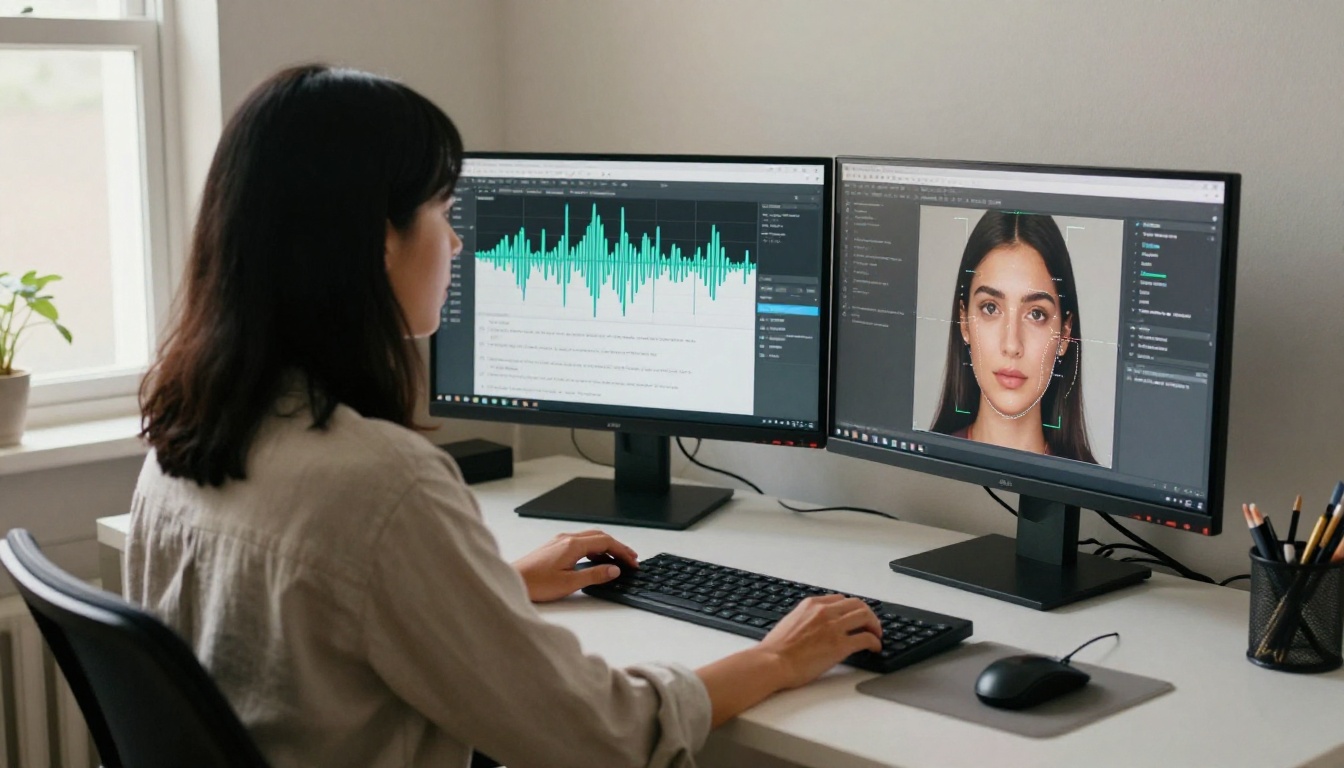
أفضل النماذج اللغوية الكبيرة لمحادثات الرفقة
Claude 4.5 Sonnet خيار قوي لتطبيقات الرفقة التي تحتاج إلى ردود دقيقة ومتأنية وواعية عاطفيًا دون زمن استجابة مرتفع.
GPT 4.1 من OpenAI لا يزال نموذجًا موثوقًا بأداء ثابت عبر مجموعة واسعة من أساليب المحادثة.
Gemini 3.5 Flash يوفّر استدلالًا متعدد الوسائط وسريعًا، ومفيدًا حين يحتاج تطبيق الرفقة إلى معالجة الصور التي يشاركها المستخدم في المحادثة.
Kimi K2.6 من Moonshotai قوي بشكل خاص في السلوك الوكيلي، لذا يعمل جيدًا مع تجارب الرفقة التي تتجاوز الدردشة إلى القيام بأشياء معًا، مثل تصفح الويب أو تخطيط الفعاليات.
كيف تبني صورة رمزية متحدثة بالذكاء الاصطناعي على PicassoIA
يوفّر PicassoIA وصولًا مباشرًا إلى النماذج، فيمكنك تجميع مسار أساسي لرفيق بالذكاء الاصطناعي دون كتابة أي شيفرة. إليك الطريقة باستخدام Omni Human 1.5.
الخطوة 1: انتقل إلى Omni Human 1.5 على PicassoIA. ارفع صورة شخصية أمامية واضحة. كلما كانت جودة الصورة أفضل، كانت النتيجة أفضل.
الخطوة 2: سجّل مقطعًا صوتيًا أو أنشئ مقطعًا بالصوت الذي تريد استخدامه. إذا أردت صوتًا مخصصًا، فاستخدم نموذج تحويل النص إلى كلام أولًا. ضمن فئة تحويل النص إلى كلام ستجد نماذج تولّد أصواتًا دافئة ومعبّرة من نص مكتوب.
الخطوة 3: ارفع الصوت إلى Omni Human 1.5 مع الصورة. اضبط شدة حركة الوجه. قيمة بين 0.7 و0.9 تعطي عادةً أكثر النتائج طبيعية.
الخطوة 4: ولّد الفيديو. سيعيد Omni Human 1.5 مقطعًا لصورتك الرمزية وهي تتحدث بحركة فم متزامنة، ورمش طبيعي، وحركة خفيفة للرأس.
الخطوة 5: لتشغيل هذا كحلقة فورية لمحادثات الرفقة، اقرن مخرجات مزامنة الشفاه بنموذج لغوي كبير سريع مثل Gemini 3 Flash لتوليد الردود، ونموذج تحويل نص إلى كلام لتوليد الصوت. أرسل صوتًا جديدًا إلى Omni Human مع كل دورة في المحادثة.
💡 للحفاظ على شخصية ثابتة، استخدم الصورة المصدر نفسها في كل جلسة. نماذج مثل Omni Human 1.5 تحافظ على الهوية بشكل جيد جدًا عندما تكون صورة المرجع ثابتة.
من الذين يستخدمون رفقاء الذكاء الاصطناعي فعلًا
قاعدة مستخدمي تطبيقات رفقة الذكاء الاصطناعي أوسع وأكثر تنوعًا ديموغرافيًا مما تعترف به الصحافة التقنية عادةً.
الأرقام يصعب تجاهلها
أعلنت Replika، وهي واحدة من أقدم منصات رفقة الذكاء الاصطناعي، عن أكثر من 10 ملايين مستخدم مسجّل حتى عام 2023. وتجاوز Character.AI 20 مليون مستخدم نشط يوميًا بحلول منتصف عام 2024، مع بقاء الشخصيات الرومانسية وشخصيات الرفقة من بين الأكثر زيارة باستمرار. أما التطبيقات التي بُنيت خصيصًا حول مفهوم صديق الذكاء الاصطناعي وصديقة الذكاء الاصطناعي، ومن بينها Nomi و Anima وعدد من التطبيقات الأحدث، فقد راكمت مجتمعةً مئات الملايين من التنزيلات حول العالم.
ميزة مكالمات الفيديو تحديدًا تدفع إلى ارتفاعات في التفاعل. فالمستخدمون الذين يفعّلون مكالمات الفيديو في تطبيقات الرفقة يُظهرون مدة جلسات واحتفاظًا أعلى بكثير من أولئك الذين يكتفون بالنص.
من يستخدمها
تُظهر البيانات التي تشاركها شركات تطبيقات الرفقة صورة متنوعة:
- الشباب بين 18 و34 عامًا يشكّلون أكبر شريحة، لكن الاستخدام بين البالغين فوق 45 عامًا ينمو أسرع من أي فئة عمرية أخرى
- النساء يتفوّقن قليلًا على الرجال كمستخدمات لتطبيقات رفقة الذكاء الاصطناعي، خلافًا لما يفترضه معظم الناس
- الأشخاص في العلاقات عن بُعد يستخدمون رفقاء الذكاء الاصطناعي خلال فترات الفراق
- الأفراد الذين يعانون من القلق الاجتماعي يذكرون أن تطبيقات الرفقة تتيح لهم ممارسة الحديث بضغط منخفض
- الأشخاص الذين يعيشون الحزن أو الفقد يجدون التفاعل المنظم مع الذكاء الاصطناعي مفيدًا في فترات تكون فيها طاقتهم الاجتماعية البشرية مستنزفة
كيف يبدو الجيل التالي
الجيل الحالي من مكالمات الفيديو مع صديق الذكاء الاصطناعي مثير للإعجاب، لكنه ما زال محدودًا بوضوح. الجيل التالي أقرب مما يظن معظم الناس.
مكالمات فورية دون تأخير في المسار
أكبر نقطة احتكاك حاليًا هي زمن الاستجابة. فالفجوة بين ما تقوله ولحظة رد الذكاء الاصطناعي، وهي ما بين ثانيتين وأربع ثوانٍ، مقبولة لكنها ملحوظة. وتتسابق الفرق لتقليصها إلى أقل من ثانية واحدة. عندما يحدث ذلك، سيصبح إيقاع الحوار في مكالمات الفيديو بالذكاء الاصطناعي غير قابل للتمييز عن المكالمات الحقيقية لدى معظم المستخدمين.
نماذج مثل Seedance 2.5 من ByteDance وVeo 3.1 من Google تدفع طبقة توليد الفيديو نحو سرعات تجعل التفاعل الفوري ممكنًا. وفي الوقت نفسه، يثبت Wan 3 من Alibaba أن إخراج فيديو بجودة سينمائية ممكن دون تكاليف حوسبة ضخمة.
الذاكرة والتخصيص
الخطوة الكبرى التالية هي ذاكرة دائمة ودقيقة. فالرفقاء الحاليون جيدون داخل الجلسة الواحدة، لكنهم متفاوتون عبر الجلسات. الرفيق الذي يتذكر ليس اسمك فقط، بل المحادثة الدقيقة التي جرت بينكما قبل ثلاثة أسابيع، ويعرف دعابتك وأنماطك وقصصك، أمر ممكن تقنيًا ويجري بناؤه فعليًا.
Claude Opus 4.7 من Anthropic وGPT 5 Pro يثبتان بالفعل نوع الاستدلال ذي السياق الطويل الذي يجعل الذاكرة العميقة الممتدة عبر الجلسات ممكنة. وعند تطبيق ذلك على مسار رفقة مع تخزين دائم، تتغير التجربة من الأساس.
💡 يستحق المتابعة: تقاطع استنساخ الصوت ومزامنة الشفاه والذاكرة هو المكان الذي ستأتي منه أكثر المنتجات أهمية تجاريًا. التطبيقات التي تتقن الثلاثة ستهيمن على السوق.
جرّبها بنفسك اليوم
أدوات بناء تجربة رفيق مقنعة بالذكاء الاصطناعي متاحة كلها الآن. لا تحتاج إلى أن تكون مطورًا، ولا تحتاج إلى قضاء شهور في مشروع. اختر صورة، واختر نموذجًا لمزامنة الشفاه، واربطه بنموذج لغوي كبير للمحادثة، وستحصل على الهيكل الأساسي لرفيق بالذكاء الاصطناعي في بعد ظهر واحد.
يتيح PicassoIA كل نموذج في هذه المجموعة على picassoia.com/en/all-models. ابدأ مع Omni Human 1.5 لطبقة مزامنة الشفاه، ثم اختر Claude Sonnet 4.6 أو Gemini 3 Flash لطبقة المحادثة، وشاهد كيف تبدو التقنية فعليًا في الممارسة. لم تعد ظاهرة مكالمات الفيديو مع صديق الذكاء الاصطناعي مجرد فضول. إنها فئة قائمة بذاتها، وما زالت أفضل نسخها الممكنة قيد البناء.


