تفتح محرر الفيديو، والفيديو جاهز، والشيء الوحيد الناقص هو السرد. تسجيله يستغرق ساعة، وتخطئ في الجملة الثالثة، وبعد أسبوع يتغير النص فتضطر إلى إعادة كل شيء. يلغي التعليق الصوتي بالذكاء الاصطناعي بصوتك هذه الدائرة. تسجّل مقطعًا قصيرًا مرة واحدة، فيبني نموذج الاستنساخ نسخة قابلة لإعادة الاستخدام من صوتك، ومن تلك اللحظة تكتب النص فتحصل على صوت يشبهك.
يستعرض هذا المقال طريقة العمل، وأي الأدوات الأونلاين تستحق التجربة، وكيف تسجّل عينة نظيفة، وأي الإعدادات تجعل الناتج يبدو بشريًا بدل أن يبدو آليًا. ويتضمن أيضًا شرحًا عمليًا لاستنساخ صوتك على PicassoIA.
لماذا تستخدم صوتك الخاص
أصوات الذكاء الاصطناعي الجاهزة مناسبة لمسودة سريعة، لكنها تبدو كأنها في كل فيديو آخر. صوتك الخاص مميز يتعرف عليه الناس، وهذا أهم مما يتوقعه معظم صانعي المحتوى.
صوتك جزء من هويتك
يتعرف المستمعون على الصوت في نحو ثانية واحدة. إذا كنت تدير قناة أو بودكاست أو دورة أو سلسلة شروحات لشركة، فإن صوتًا ثابتًا يبني الثقة بالطريقة نفسها التي يبنيها الشعار. يتيح لك الصوت المستنسخ الحفاظ على هذا الصوت عبر مئات المقاطع دون حجز استوديو.
يوفّر ساعات في كل مراجعة
تتغير النصوص. تُصحَّح أسماء المنتجات. يطلب راعٍ سطرًا مختلفًا. مع الصوت المستنسخ، تصبح المراجعة تعديلًا في النص وبضع ثوانٍ من التوليد، لا جلسة تسجيل جديدة بنفس صدى الغرفة ونفس المسافة من الميكروفون.
يعمل حين لا تستطيع التسجيل
مريض، أو مسافر، أو تجلس في شقة مزعجة؟ ولّد الصوت لاحقًا من النص. كثيرون يستخدمون الصوت المستنسخ أيضًا لإنتاج السرد بلغات لا يتحدثونها، مع الحفاظ على نبرة صوتهم.
💡 نظرة واقعية سريعة: الصوت المستنسخ ممتاز للسرد والشروحات والمسودات. لن يحل محل أداء حي تحتاج فيه إلى انفعال عفوي حقيقي، لكنه يقترب بدرجة مدهشة مع الإعدادات الصحيحة.
كيف يعمل استنساخ الصوت فعليًا
لا تحتاج إلى معرفة الحسابات، لكن نموذجًا ذهنيًا بسيطًا يساعدك على إصلاح المشكلات حين يبدو الناتج غريبًا.
المقطع المرجعي
يستمع نموذج الاستنساخ إلى تسجيل قصير لك ويستخرج السمات التي تجعل صوتك صوتك: نطاق درجة الصوت، والنبرة، واللهجة، وإيقاع الكلام، وطريقة تشكيلك للحروف المتحركة. يُسمّى هذا الملف المضغوط أحيانًا تضمين الصوت (voice embedding). كلما كان الإدخال أنظف كان الملف أنظف، ولهذا تكتسب خطوة التسجيل هذا القدر من الأهمية.
محرك تحويل النص إلى كلام
يقرأ نموذج كلام منفصل نصك ويصيّره باستخدام ذلك الملف. المحركات الأفضل تضيف توقفات طبيعية وتنفسًا وتنغيمًا. بعض الأدوات تجمع الخطوتين في شاشة واحدة. وأدوات أخرى، مثل نموذج Voice Cloning على PicassoIA، تنشئ الصوت أولًا ثم تتيح لك إقرانه بمستوى من نماذج الكلام، من التوربو السريع إلى الدقة العالية.
أسلوبان للاستنساخ
| الأسلوب | العينة المطلوبة | النتيجة المعتادة | الاستخدام الأمثل |
|---|
| فوري (zero shot) | من 5 إلى 30 ثانية | قريب جدًا، مع بعض الهنات الصغيرة | الاختبارات السريعة والمقاطع القصيرة |
| صوت مدرَّب | من 10 ثوانٍ إلى عدة دقائق | أكثر ثباتًا عبر النصوص الطويلة | السلاسل والدورات والكتب الصوتية |
يتوفر الأسلوبان أونلاين دون تثبيت أي شيء، ويمكن تجربة عدة منهما مجانًا.
مقارنة الأدوات الأونلاين المجانية
السوق مزدحم، لذا إليك مقارنة عملية للخيارات التي يمكنك فتحها في المتصفح الآن. كل ما يلي متاح على PicassoIA، فيمكنك اختبارها جنبًا إلى جنب بحساب واحد.
| النموذج | أسلوب الاستنساخ | نقطة القوة | الاستخدام المناسب |
|---|
| Voice Cloning | ارفع مقطعًا واحصل على صوت قابل لإعادة الاستخدام | إزالة الضوضاء وتطبيع مستوى الصوت مدمجان | إنشاء نسخة دائمة من صوتك |
| Chatterbox | صوت مرجعي مع النص في خطوة واحدة | شريط للانفعال والتحكم في الإيقاع | السرد المعبّر |
| Chatterbox Pro | صوت مرجعي، ناتج مصقول | أداء مصقول وطبيعي | التعليقات الصوتية النهائية |
| Chatterbox Turbo | توليد سريع | السرعة في التكرارات السريعة | المسودات والاختبارات |
| Qwen3 TTS | استنساخ أي صوت أو تصميم صوت جديد | مرن ومتعدد اللغات | التجارب وأصوات الشخصيات |
أيّها تختار؟
إذا كان هدفك صوتًا تعيد استخدامه لأسابيع، فابدأ بنموذج Voice Cloning، ثم أقرن الناتج بنموذج كلام. إذا أردت كتابة نص وسماعه فورًا بصوتك، فإن Chatterbox هو الطريق الأسرع لأنه يأخذ المقطع المرجعي والنص في نموذج واحد. وحين تريد لمسة احترافية بأسلوب الاستوديو على نص نهائي، قارن مع Speech 2.8 HD وElevenLabs V3 للأصوات الجاهزة لترى كيف يقارن استنساخك بها.
ماذا تعني كلمة "مجاني" فعليًا
عادةً تعني "مجاني" عددًا محدودًا من التوليدات، أو حدًا أقصى للطول، أو علامة مائية. يضيف Chatterbox مثلًا علامة مائية غير مسموعة إلى ناتجه، بحيث يمكن تتبع الملف دون أن يتغير صوته. جرّب استنساخك على فقرات قصيرة أولًا حتى لا تستنفد رصيدك على محاولة فاشلة.
سجّل عينة صوتية نظيفة
هنا تُكسب أو تُخسر معظم النتائج. نموذج متوسط مع عينة جيدة يتفوق على نموذج ممتاز مع عينة رديئة.
عالج الغرفة قبل الميكروفون
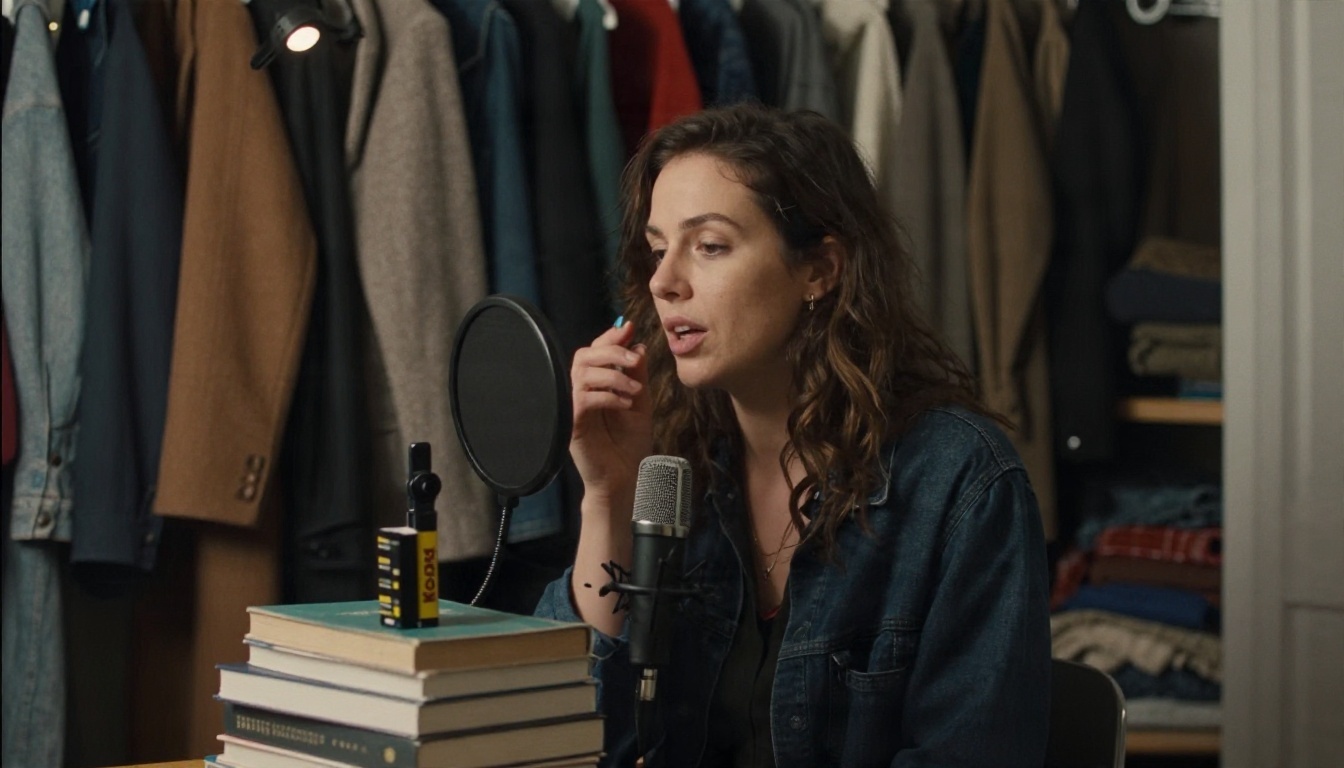
الصدى هو أكبر عدو. الجدران الصلبة ترد صوتك إلى الميكروفون، ويتعلم الاستنساخ الصدى كجزء من صوتك. لا تحتاج إلى استوديو. خزانة ملابس مليئة بالمعاطف، أو مكتب تحيط به الوسائد والبطانيات، يمتص معظمه.
اختر ميكروفونًا تملكه بالفعل
هاتف يُمسك على بعد قبضة يد تقريبًا من فمك يكفي. ميكروفون USB مكثف أفضل. مهما كان ما تستخدمه، حافظ على المسافة ثابتة، وتكلم بميل طفيف إلى الجانب لتجنب الانفجارات الصوتية (plosives)، وهي النفخات الحادة في أصوات "p" و"b".
ماذا تقرأ
اقرأ نصًا يشبه المشروع النهائي. إذا كنت تخطط لشروحات دافئة وودودة، فلا تقرأ نص أخبار جادًا. الاستنساخ يرث طاقتك. تشمل العينة الجيدة ما يلي:
- مزيجًا من جمل قصيرة وأخرى طويلة
- بعض الأسئلة، حتى يسمع النموذج النغمة الصاعدة
- توقفات طبيعية، لا أداءً مستعجلًا
- أرقامًا وأسماءً وكلمتين صعبتين تستخدمهما كثيرًا
قائمة مراجعة للعينة
| العنصر | الهدف |
|---|
| الطول | من 30 ثانية إلى دقيقتين هو المدى المثالي |
| الصيغة | WAV أو MP3 أو M4A |
| ضوضاء الخلفية | أقرب ما يمكن إلى الصمت |
| مستوى الصوت | واضح، دون تشويه أو تقطيع |
| المتحدثون | أنت فقط، دون أصوات أخرى |
| الأداء | النبرة التي تريدها في التعليق النهائي |
💡 نصيحة: سجّل ثلاث محاولات قصيرة واستخدم الأفضل. لا تدمج محاولات سُجّلت في أيام مختلفة، لأن الصوت يتغير قليلًا مع النوم والترطيب والمزاج.
كيف تستخدم Voice Cloning على PicassoIA
يحوّل نموذج Voice Cloning مقطعًا صوتيًا قصيرًا إلى صوت ذكاء اصطناعي قابل لإعادة الاستخدام. يمكن تجربته أونلاين مجانًا دون أي برمجة. يقبل ملفات MP3 وM4A وWAV بحجم يصل إلى 20 ميغابايت، ومدة تتراوح بين 10 ثوانٍ و5 دقائق.
خطوة بخطوة
- افتح صفحة النموذج. انتقل إلى صفحة Voice Cloning على PicassoIA.
- ارفع ملف صوتك. اختر التسجيل النظيف الذي أنجزته في القسم السابق.
- فعّل إزالة الضوضاء عند الحاجة. إذا سجلت خارج غرفة هادئة وسمعت حفيفًا أو همهمة، ففعّل Need Noise Reduction.
- فعّل تطبيع مستوى الصوت. إذا تضمن مقطعك لحظات عالية وأخرى هادئة، ففعّل Need Volume Normalization ليبقى الاستنساخ عند مستوى ثابت.
- اختر نموذج الكلام. الافتراضي هو
speech-2.6-hd. يمكنك أيضًا اختيار speech-2.6-turbo أو speech-02-hd أو speech-02-turbo.
- اترك الدقة عند 0.7 في البداية. هذه عتبة التحقق من النص، وهي رقم من 0 إلى 1. القيمة الافتراضية نقطة بداية معقولة.
- شغّله واستمع. تأكد من أن الاستنساخ يلتقط لهجتك وإيقاعك، ثم استخدم الصوت الناتج مع نموذج الكلام المناسب.
نصائح للمعاملات
| الإعداد | الافتراضي | متى تغيّره |
|---|
| النموذج | speech-2.6-hd | استخدم HD للناتج النهائي وturbo للمسودات السريعة |
| إزالة الضوضاء | مغلق | شغّلها للتسجيلات من الهاتف أو الغرف التي فيها ضجيج مروحة |
| تطبيع مستوى الصوت | مغلق | شغّلها إذا كان مستوى الصوت في مقطعك متفاوتًا |
| الدقة | 0.7 | ارفعها إذا نُطقت الكلمات بشكل خاطئ، واخفضها إذا رفض التحقق عينة جيدة |
طريق أسرع: Chatterbox
إذا كنت تفضل خطوة واحدة، فافتح Chatterbox. ألصق نصك في خانة الأمر النصي، وأرفق مقطعك كأمر صوتي، ثم ولّد. ولأنه يعيد إنتاج المتحدث من بضع ثوانٍ فقط من الصوت المرجعي، فهو مثالي لاختبار ما إذا كانت عينتك جيدة بما يكفي قبل الالتزام بسير عمل استنساخ أطول.
الإعدادات التي تغيّر النتيجة
بعد استنساخ صوتك، يأتي الفرق بين "يبدو ذكاءً اصطناعيًا بوضوح" و"هذا يشبهني" من عدد قليل من أدوات التحكم. يعرض Chatterbox أوضحها، ومنطق الأمر ينطبق على معظم الأدوات.
الانفعال والمبالغة
يتحكم شريط المبالغة في مدى تعبيرية الأداء. القيمة المحايدة هي 0.5. حرّكه نحو 0.6 أو 0.7 للسرد الحيوي والنشيط، مثل إعلان منتج. اخفضه للشروحات الهادئة ونصوص التأمل. القيم المتطرفة قد تصبح غير مستقرة، لذا غيّرها بخطوات صغيرة.
الإيقاع ووزن CFG
يعمل وزن CFG كأداة للتحكم في الإيقاع. القيمة الافتراضية هي 0.5. القيم الأدنى تميل إلى إبطاء الأداء ومنحه إيقاعًا أكثر استرخاءً، بينما ترفعه القيم الأعلى. إذا كان استنساخك يتحدث أسرع منك، فاخفض هذا الوزن قليلًا وقارن.
درجة الحرارة
تتحكم درجة الحرارة في التنوع. عند القيمة الافتراضية 0.8، ستختلف التشغيلات المتكررة للجملة نفسها قليلًا، وهذا يبدو طبيعيًا. اخفضها لقراءات متوقعة ومتسقة للمحتوى التقني. ارفعها قليلًا إذا بدا الناتج مسطحًا.
قيمة البذرة (Seed)
قيمة البذرة 0 تعني عشوائية. حين تحصل على محاولة تحبها، سجّل قيمة البذرة وأعد استخدامها. بهذه الطريقة لن يغيّر تعديل صغير في النص الشخصية الكاملة للأداء.
اكتب للأذن
حتى أفضل استنساخ يعاني مع نص مكتوب للعين. أصلح النص أولًا:
- استخدم جملًا قصيرة. اجعلها أقل من 20 كلمة.
- اكتب الكلمات الصعبة كاملة. اكتب "عشرون عشرون وستة" إذا تعثّر النموذج في سنة.
- استخدم علامات الترقيم كتوجيه. الفاصلة تصنع توقفًا صغيرًا، والنقطة توقفًا أطول، وعلامة الاستفهام ترفع الدرجة.
- أضف كتابات صوتية لأسماء العلامات التجارية التي تُنطق بشكل خاطئ.
- ولّد على دفعات. الفقرة تلو الأخرى أسهل في التصحيح من كتلة من عشر دقائق.
💡 حركة احترافية: ولّد الفقرة نفسها ثلاث مرات بقيم مبالغة مختلفة قليلًا، ثم احتفظ بالمحاولة التي تبدو أقرب إلى صوتك.
تحقق من الناتج مقابل النص المكتوب
لالتقاط الكلمات المتخطاة أو المتبادلة، شغّل الصوت الناتج عبر نموذج تفريغ مثل GPT 4o Transcribe وقارن النص بنصك. يستغرق ذلك ثوانٍ ويوفر كثيرًا من الاستماع.
أين تعمل التعليقات الصوتية المستنسخة بأفضل شكل
يمكن أن يظهر صوتك الآن في أماكن أكثر مما كان يمكنك تسجيله فيها.
الفيديو والمحتوى الاجتماعي
المقاطع القصيرة والشروحات أسهل مكسب. اكتب النص، ووّلد الصوت، ثم أضفه إلى الخط الزمني. إذا كان فيديوك يعرض متحدثًا على الشاشة، فاقرن الصوت مع Lipsync 2 ليتطابق تحريك الفم مع المسار الجديد.
الكتب الصوتية والسرد الطويل
القراءات الطويلة تكافئ الأصوات المدرَّبة والإعدادات المتسقة. قسّم المخطوطة إلى فصول، واحتفظ بالبذرة والنموذج والإعدادات نفسها لكل فصل، وانتبه إلى الانحراف بين الفصول.
تدريب والفيديوهات الداخلية
تحدّث الشركات محتوى التدريب باستمرار. امتلاك صوت داخلي موثوق يعيد توليد وحدة متغيرة خلال دقائق يوفر وقتًا كبيرًا مقارنة بإعادة حجز معلق صوتي.
الدبلجة إلى لغات أخرى
حين تريد الفيديو نفسه بالإسبانية أو الفرنسية أو الألمانية، يمكن لأداة دبلجة مثل Dubbing ترجمة الفيديو إلى أكثر من 90 لغة. أما النصوص متعددة اللغات التي تتحكم في كتابتها، فيستحق Qwen3 TTS وVoice Cloning التجربة بعينتك الخاصة.
استخدم فقط الأصوات التي لديك إذن باستنساخها
استنسخ صوتك أنت، أو صوت شخص وافق على ذلك بوضوح. لا تستنسخ أبدًا صوت زميل أو مشهور أو قريب دون موافقته. أشر إلى أن المقطع الصوتي مُنشأ بالذكاء الاصطناعي عندما يكون السياق مهمًا، كما في الإعلانات أو المحتوى على غرار الأخبار، واحتفظ بالتسجيلات الأصلية تحسبًا لأن يطلب منك أحد إثبات مصدر أي مقطع.
إصلاح المشكلات الشائعة
| المشكلة | السبب المرجح | الحل |
|---|
| أداء آلي أو مسطح | عينة رتيبة | أعد التسجيل مع تنوع أكبر في درجة الصوت |
| نتيجة بها صدى | انعكاسات الغرفة | سجّل داخل خزانة أو أضف أثاثًا ناعمًا |
| حفيف في الناتج | مدخل فيه ضوضاء | فعّل إزالة الضوضاء وأعد التشغيل |
| قفزات في مستوى الصوت | تسجيل غير متساوٍ | فعّل تطبيع مستوى الصوت |
| نطق خاطئ | كلمات غير معتادة | اكتبها صوتيًا في النص |
| انحراف الصوت بين الملفات | بذرة وإعدادات عشوائية | ثبّت البذرة والنموذج والمبالغة |
| يبدو كشخص آخر | العينة قصيرة جدًا أو فيها ضوضاء | استخدم من 30 إلى 60 ثانية من كلام نظيف |
جرّب صوتك بنفسك اليوم
لا تحتاج إلى معدات جديدة أو استوديو لتسمع صوتك يقدم سرد نص كتبته قبل خمس دقائق. سجّل دقيقة نظيفة، وارفعها إلى Voice Cloning، ثم اختبرها مقابل Chatterbox وChatterbox Pro لترى أيّها يشبهك أكثر. عدّل المبالغة والإيقاع ودرجة الحرارة بخطوات صغيرة، واحتفظ ببذرة محاولتك المفضلة، وابنِ مكتبة نصوص يمكنك إعادة توليدها في أي وقت.
افتح PicassoIA، واختر نموذجًا، وأنجز أول تعليق صوتي لك بصوتك. ولمزيد من نماذج الصوت والصورة والفيديو التي يمكن دمجها معه، تصفح كل نماذج PicassoIA.


