الثورة الحسية التي تحدث على TikTok لا تتعلق بالانتقالات اللافتة أو الموسيقى الصاخبة، بل بالأصوات الهادئة والحميمة التي تجعل فروة رأس المشاهدين تتنمّل. وقد تطور محتوى الاستجابة الحسية الذاتية للدماغ (ASMR) من مجتمعات متخصصة على YouTube إلى محرك التفاعل الأكثر موثوقية على TikTok، مع تجاوز الفيديوهات الموسومة #ASMR مليارات المشاهدات شهريًا. لكن ما يكتشفه صنّاع المحتوى هو أن إنتاج محتوى ASMR عالي الجودة وثابت أمر مُرهق جسديًا ومُستنزف إبداعيًا. وهنا تُحدث أدوات الذكاء الاصطناعي تحولًا في خط الإنتاج بأكمله.
كل سطح يحكي قصة صوتية مختلفة عند استكشافه عبر تحليل الملمس بمساعدة الذكاء الاصطناعي
لماذا يهيمن ASMR على خوارزمية TikTok
لا تكتفي خوارزمية TikTok بتتبع المشاهدات، بل تقيس نسب إكمال المشاهدة، وسلوك إعادة المشاهدة، ومدة الجلسة. ويتفوق محتوى ASMR في المقاييس الثلاثة. فعندما يعثر شخص على فيديو همس مُرضٍ أو تسلسل نقر مُريح، لا يشاهده مرة واحدة فقط، بل يحفظه ويشاركه ويعود إليه مرارًا. وهذا يُنتج إشارات قوية تُخبر TikTok بأن "هذا المحتوى يُبقي الناس على المنصة لفترة أطول".
💡 يحقق فيديو ASMR المتوسط على TikTok نسب إكمال أعلى بنسبة 47% من المحتوى العادي. والفيديوهات التي تُحفّز استجابات جسدية (قشعريرة، استرخاء) تُولّد مشاركات أكثر بمقدار 3.2 مرة.
يعزّز التصميم الحساس للصوت على المنصة فعالية ASMR. فيقوم TikTok تلقائيًا بضبط تطبيع مستوى الصوت، ويطبّق معالجة الصوت المكاني، ويحسّن التجربة للاستماع بسماعات الرأس، وكلها ميزات تعزز تجارب ASMR. وهذه البنية التقنية تمنح صنّاع ASMR ميزة مدمجة، لكنها ترفع أيضًا توقعات الجمهور بشأن جودة الإنتاج.
تركيب الصوت بالذكاء الاصطناعي لفيديوهات الهمس
يطرح محتوى الهمس تحديات فريدة: إجهاد الحبال الصوتية يحدّ من جلسات التسجيل، والثبات يتراجع مع التعب، وأصوات الفم الدقيقة تختلف من يوم لآخر. تحل أدوات تركيب الصوت بالذكاء الاصطناعي هذه المشكلات عبر توليد همسات مثالية من نص مُدخل.
تفاصيل صوتية حميمة تُلتقط عبر تحسين التسجيل بمساعدة الذكاء الاصطناعي
أبرز إمكانات أدوات الصوت المُحسَّنة للهمس:
| الميزة | التسجيل التقليدي | المُولَّد بالذكاء الاصطناعي |
|---|
| الثبات | يتفاوت مع إجهاد الصوت | ثابت تمامًا عبر الجلسات |
| المدة | محدودة بالإجهاد الجسدي | توليد بطول غير محدود |
| أصوات الفم | طبيعية لكنها غير ثابتة | مُحسّنة برمجيًا لتناسب ASMR |
| دعم اللغات | محصور في لغات صانع المحتوى | أكثر من 50 لغة بلهجات أصيلة |
| ما بعد الإنتاج | ساعات من المونتاج المطلوب | معالجة فورية مع مؤثرات |
تستخدم المنصات الأكثر فعالية استنساخ الصوت العصبي الذي يلتقط الخصائص الصوتية المميزة لصانع المحتوى، ثم يطبّق معالجة خاصة بالهمس: تقليل الانفجارات الصوتية (plosives)، وتعزيز أصوات التنفس، وتحسين نطاقات الترددات للاستماع بسماعات الرأس. وينتج عن ذلك محتوى يبدو شخصيًا مع القضاء على عوائق الإنتاج.
أدوات توليد ASMR البصري
رغم أن ASMR سمعي في جوهره، فإن الجانب البصري على TikTok لا يمكن تجاهله. يتوقع المشاهدون عناصر بصرية مُرضية تُرافق التجارب الصوتية. وتُنشئ أدوات توليد الصور بالذكاء الاصطناعي هذه العناصر البصرية بدقة لا تستطيع التصوير الفوتوغرافي التقليدي مجاراتها.
أبرز فئات ASMR البصري وحلول الذكاء الاصطناعي لكل منها:
- لقطات قريبة للملمس - يولّد Flux 2 Klein 4B لقطات ماكرو متطرفة للمواد بإضاءة مثالية تُوحي بالصوت
- أنماط مُرضية - يُنشئ Qwen Image 2512 أنماطًا مثالية رياضيًا تتزامن مع إيقاعات الصوت
- فيديوهات العمليات - يحوّل WAN 2.6 I2V الصور الثابتة إلى رسوم متحركة لعمليات مُرضية
- تحولات قبل/بعد - يعزّز P Image Edit اللقطات الموجودة بمؤثرات بصرية مُحسّنة لمحتوى ASMR
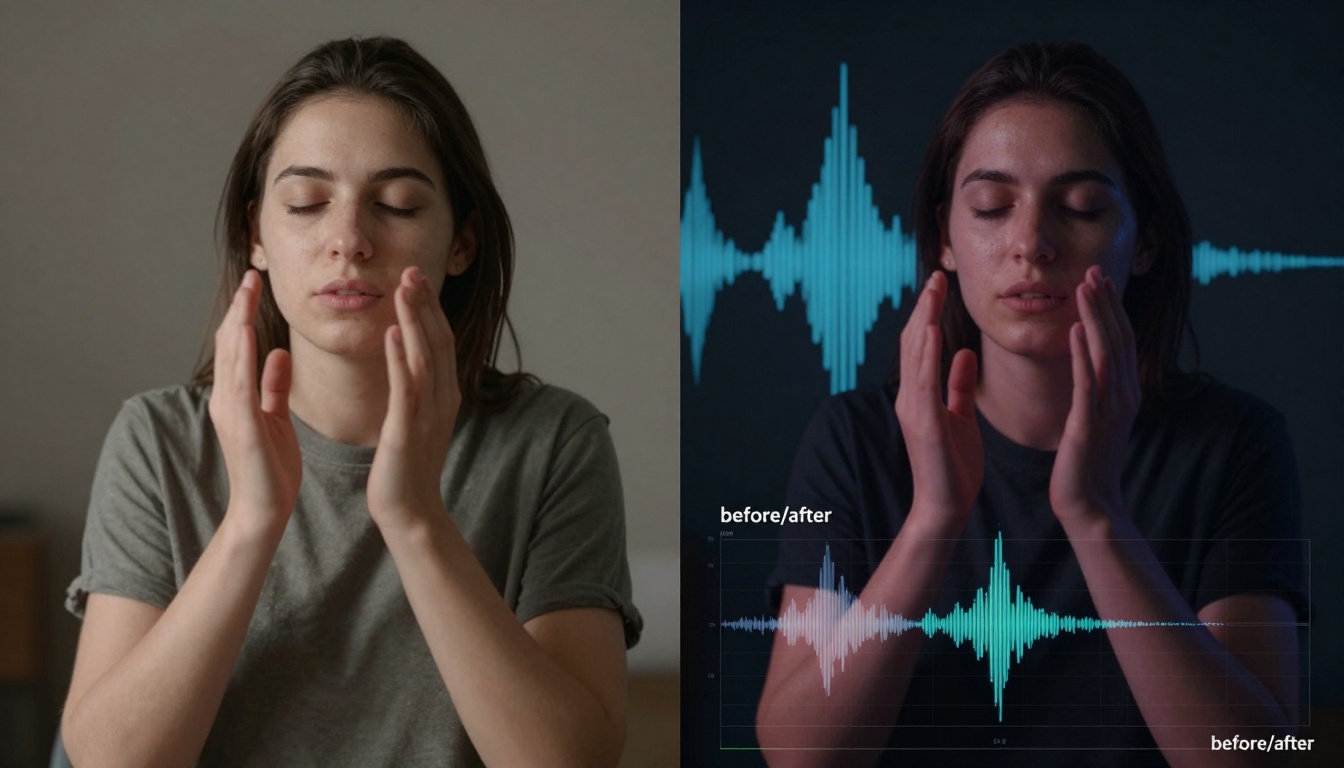
التحويل بالذكاء الاصطناعي يرفع اللقطات العادية إلى جودة ASMR احترافية
تتطلب هندسة الأوامر البصرية لـ ASMR مفردات محددة:
- "لقطة ماكرو متطرفة تُظهر ألياف المخمل الفردية وهي تُضغط"
- "قطرة ماء بطيئة الحركة تصطدم بالسطح مع انتشار تموجات مرئي"
- "نمط متماثل تمامًا يتكشف مع كشف متسلسل مُرضٍ"
- "ملمس مرئي عبر إضاءة اتجاهية تُبرز تضاريس السطح"
معالجة الصوت ومنصات تصميم الأصوات
تحتوي تسجيلات ASMR الخام على ضوضاء غير مرغوبة، ومستويات غير متسقة، وعيوب تُقلل من فعاليتها. تقوم أدوات معالجة الصوت بالذكاء الاصطناعي بتنظيف هذه التسجيلات وتحسينها وضبطها تلقائيًا.
التحليل الصوتي الاحترافي يُوجّه قرارات المعالجة بالذكاء الاصطناعي
مراحل معالجة الصوت الحاسمة لمحتوى ASMR:
المرحلة 1: تقليل الضوضاء
- يزيل هدير التكييف والتداخل الكهربائي ورنين الغرفة
- يحافظ على أصوات الفم الدقيقة وملمس المواد
- يستخدم خوارزميات الطرح الطيفي التي تحدد أنماط الضوضاء الثابتة وتزيلها
المرحلة 2: تحسين نطاق الديناميكية
- يضغط الذروات الصاخبة (الانفجارات الصوتية، النقرات المفاجئة) دون قصّ
- يعزّز التفاصيل الخافتة (أصوات التنفس، الخشخشات الخفيفة)
- يطبّق الضغط متعدد النطاقات المصمم لنطاقات ترددات ASMR
المرحلة 3: التعزيز المكاني
- يُنشئ تأثيرات ثنائية الأذن من تسجيلات أحادية القناة
- يحاكي حركة الرأس والصوت الموضعي
- يستخدم نمذجة HRTF (دالة النقل المرتبطة بالرأس) لصوت ثلاثي الأبعاد أصيل
المرحلة 4: تحسين TikTok
- يطبّق تطبيعًا لمستوى الصوت خاصًا بالمنصة
- يضيف تعزيزًا خفيفًا للترددات العالية لمكبرات صوت الهواتف الذكية
- يُنشئ نسخًا محسّنة لسماعات الرأس مقابل السماعات
تحويل الفيديو إلى ASMR
تحوّل أقوى تطبيقات الذكاء الاصطناعي محتوى ليس من فئة ASMR إلى تجارب حسية مُرضية. وهذا يفتح مكتبات محتوى ضخمة لإعادة الاستخدام.
استراتيجية متعددة المنصات تستفيد من الذكاء الاصطناعي لإنتاج محتوى متسق
سير عمل التحويل باستخدام نماذج توليد الفيديو بالذكاء الاصطناعي:
من فيديوهات الطبخ إلى محتوى طعام ASMR:
- استخرج الصوت من أصوات الطبخ (التقطيع، القلي، الصب)
- استخدم Seedance 1.5 Pro لتوليد عناصر بصرية مُرضية مرافقة
- طبّق حركة مُبطأة لإبراز تفاصيل الملمس
- أضف لقطات ماكرو تُظهر ملمس الطعام عن قرب
من لقطات الطبيعة إلى ASMR بيئي:
- اعزل الأصوات الطبيعية (المطر، أوراق الشجر، الماء)
- ولّد حلقات بصرية متطابقة باستخدام Kling V2.6
- طبّق تمديد الزمن لإنشاء أنماط إيقاعية
- أضف طبقات ملمس بصري تعكس ترددات الصوت
من الدروس التعليمية اليدوية إلى فيديوهات العمليات المُرضية:
- استخرج أصوات البناء والصنع
- استخدم WAN 2.5 T2V Fast للتصور السريع
- طبّق تأثيرات الإنجاز المُرضية (الكشف النهائي، المحاذاة المثالية)
- أضف تصورًا للتقدم يتزامن مع الصوت
إنشاء تجارب حسية كاملة
لا تكتفي أنجح فيديوهات ASMR على TikTok بعرض الأصوات، بل تصوغ بيئات حسية كاملة. وتمكّن أدوات الذكاء الاصطناعي من ذلك عبر التوليد متعدد الوسائط الذي يُزامن الصوت والصورة وحتى الإيحاءات اللمسية.
أنماط صوتية معقدة مُصوَّرة عبر التحليل الطيفي بالذكاء الاصطناعي
سير عمل إنشاء التجربة الكاملة:
الخطوة 1: توليد الفكرة
- المدخل: "تنظيم مُرضٍ لأدوات الفن"
- يولّد الذكاء الاصطناعي: لوحة أصوات (نقر الفرشاة، نقر الحاويات، خشخشة الأوراق)
- يولّد الذكاء الاصطناعي: تسلسلًا بصريًا (محاذاة الفرشاة، إغلاق الأغطية، تكديس الأوراق)
- يولّد الذكاء الاصطناعي: نمطًا إيقاعيًا (تسارع تدريجي نحو خاتمة مُرضية)
الخطوة 2: إنتاج العناصر
- الصوت: يولّد GPT Image 1.5 صورًا مرجعية لمطابقة الأصوات
- الصورة: يُنشئ Flux 2 Max رسومًا متحركة مُرضية لعمليات
- المزامنة: يُحاذي الذكاء الاصطناعي ذروات الصوت مع الأفعال البصرية إطارًا بإطار
الخطوة 3: تحسين المنصة
- نسخة TikTok: تباين أعلى، قطع أسرع، تركيز على لحظات الإنجاز
- نسخة YouTube: مدة أطول، بناء تدريجي، لقطات ملمس مفصّلة
- نسخة Instagram: تنسيق مربع، مقاطع أبرز، مكافآت الرضا
الخطوة 4: تحسين إمكانية الوصول
- أوصاف بصرية للمشاهدين ضعاف السمع
- أوصاف صوتية للمشاهدين ضعاف البصر
- ترجمة متبادلة بين الحواس حيث توحي الأصوات بالصور والعكس
تحسين خوارزمية TikTok بالذكاء الاصطناعي
فهم خوارزمية TikTok شيء، والعمل الفعلي على تحسين المحتوى وفقها يتطلب قدرات تحليل بيانات تفوق القدرة البشرية. تحلل أدوات الذكاء الاصطناعي آلاف فيديوهات ASMR الناجحة لتحديد أنماط الفوز.
التحليلات الفورية تُوجّه قرارات المحتوى بمساعدة الذكاء الاصطناعي
عوامل تحسين الخوارزمية التي يتتبعها الذكاء الاصطناعي:
أنماط وقت المشاهدة:
- الطول المثالي لفيديو ASMR حسب الفئة (الهمس: 47 ثانية، النقر: 72 ثانية)
- نقاط الانسحاب التي تشير إلى مقاطع غير مُرضية
- لحظات إعادة المشاهدة التي تدل على ذروة الرضا
تحليل الصوت:
- نطاقات الترددات التي تُحفّز أقوى الاستجابات
- أنماط الإيقاع التي تحافظ على التفاعل
- ديناميكيات الصوت التي تخلق الترقب والمكافأة
التكوين البصري:
- زوايا الكاميرا التي تعزز وضوح الملمس
- ظروف الإضاءة التي تُوحي بالخصائص اللمسية
- لوحات الألوان المرتبطة باستجابات الاسترخاء
أداء الهاشتاغات:
- فعالية الهاشتاغات المتخصصة مقابل العامة
- ارتباط الاتجاهات الموسمية (ASMR الأعياد، الأصوات الموسمية)
- تركيبات الهاشتاغات بين الفئات التي تصل إلى جماهير جديدة
تحليل مشاعر التعليقات:
- الاستجابات العاطفية مصنفة حسب نوع الصوت
- أنماط الطلبات التي تُظهر رغبات الجمهور
- أنماط النقد التي تُبرز مشكلات الإنتاج
💡 يكشف تحليل الذكاء الاصطناعي أن فيديوهات ASMR التي تتضمن زيادات تدريجية في مستوى الصوت تحقق نسب إكمال أعلى بنسبة 28% من تلك ذات مستوى الصوت الثابت. وتفسّر الخوارزمية البناء التدريجي على أنه "سرد قصصي" لا "محتوى ثابت".
دمج سير العمل وتوفير الوقت
الفائدة الأهم التي يجلبها الذكاء الاصطناعي لإنتاج ASMR ليست تحسين الجودة فحسب، بل استعادة الوقت. يتطلب إنتاج ASMR التقليدي ساعات من التسجيل والمونتاج والتحسين لكل دقيقة من المحتوى. أما الذكاء الاصطناعي فيختصر هذا الجدول الزمني.
سير عمل متكامل من التسجيل حتى النشر مُحسَّن بمساعدة الذكاء الاصطناعي
مقارنة الوقت: الإنتاج التقليدي مقابل الإنتاج بمساعدة الذكاء الاصطناعي
| المهمة | الوقت التقليدي | الوقت بمساعدة الذكاء الاصطناعي | الوقت الموفَّر |
|---|
| تسجيل Whisper | 2 ساعة لكل 10 دقائق | 15 دقيقة لكميات غير محدودة | 1 ساعة و45 دقيقة |
| تنظيف الصوت | 45 دقيقة لكل دقيقة | معالجة فورية | 45 دقيقة |
| إنشاء المرئيات | 3 ساعات لكل فيديو | 20 دقيقة مع التوليد | 2 ساعة و40 دقيقة |
| تحسين المنصات | 30 دقيقة لكل منصة | أتمتة عبر المنصات | 30 دقيقة |
| مراجعة التحليلات | 1 ساعة يوميًا | لوحة معلومات فورية | 1 ساعة |
| تخطيط المحتوى | 2 ساعة أسبوعيًا | اقتراحات تحليل الاتجاهات بالذكاء الاصطناعي | 1 ساعة و30 دقيقة |
إجمالي الوقت الأسبوعي: توفير 14 ساعة و15 دقيقة لكل صانع محتوى
سير عمل متكامل بالذكاء الاصطناعي لإنتاج ASMR اليومي:
- الصباح (15 دقيقة): مراجعة تقرير الاتجاهات المُولَّد بالذكاء الاصطناعي، واختيار المواضيع اليومية
- جلسة التسجيل (30 دقيقة): التقاط الأصوات الأساسية مع المعالجة الفورية بالذكاء الاصطناعي
- مرحلة التوليد (20 دقيقة): ينشئ الذكاء الاصطناعي العناصر البصرية المرافقة والتحسينات
- التجميع (15 دقيقة): يُزامن الذكاء الاصطناعي الصوت والصورة، ويطبّق تحسينات المنصات
- النشر (5 دقائق): نشر آلي عبر TikTok و Instagram و YouTube
- التحليل (فوري): يتتبع الذكاء الاصطناعي الأداء ويقترح محتوى الغد
يُنتج هذا السير 3 إلى 5 فيديوهات ASMR عالية الجودة يوميًا مقابل 1 إلى 2 فيديو بالطرق التقليدية باستثمار زمني مماثل.
ثورة المحتوى الحسي
يمثل ASMR بداية فقط لمحتوى يركز على الحواس. ومع تطور أدوات الذكاء الاصطناعي، نتجه نحو توليد المحتوى متعدد الحواس الذي يأخذ في الاعتبار ليس الصوت والصورة فحسب، بل أيضًا التجارب اللمسية المُوحاة، والارتباطات الحرارية، وحتى ذكريات الروائح.
رضا إنشاء محتوى يؤثر في المشاهدين عاطفيًا بصدق
إمكانات الذكاء الاصطناعي الناشئة لجيل ASMR القادم:
الترجمة المتبادلة بين الحواس: أصوات تولّد ملامس بصرية مقابلة
خوارزميات التخصيص: محتوى يتكيف مع التفضيلات الحسية للفرد
التكيف الفوري: فيديوهات تتعدل بناءً على إشارات تفاعل المشاهد
التوليد التعاوني: عصف ذهني بمساعدة الذكاء الاصطناعي بين صنّاع المحتوى حول العالم
لم يعد هناك حاجز أمام إنتاج محتوى ASMR احترافي. فما كان يتطلب استوديوهات مخصصة ومعدات باهظة وخبرة تقنية، بات يندرج ضمن سير عمل متاح لأي شخص يملك هاتفًا ذكيًا وإمكانية الوصول إلى أداة ذكاء اصطناعي. وهذا التعميم يعني وصول تجارب حسية أكثر تنوعًا إلى جمهور يحتاجها، سواء للاسترخاء أو التركيز أو المساعدة على النوم أو المتعة البسيطة.
ملاحظة ختامية: يحافظ أنجح صنّاع ASMR الذين يستخدمون أدوات الذكاء الاصطناعي على لمستهم الشخصية الفريدة، مع الاستفادة من المساعدة التقنية. يتولى الذكاء الاصطناعي ثبات الإنتاج، بينما يركز صانع المحتوى على الأصالة العاطفية، وهذا المزيج هو ما يصنع المحتوى الرائج حقًا.
الآن بعد أن رأيت كيف يحوّل الذكاء الاصطناعي إنشاء ASMR من عملية يدوية مُرهقة إلى تدفق إبداعي منسّق، فكّر في تجربة هذه الأدوات في فيديو TikTok القادم. ابدأ بتحسين صوت بسيط باستخدام P Image للعناصر البصرية المرافقة، أو جرّب Veo 3.1 Fast لتحويل الصور الثابتة إلى فيديوهات عمليات مُرضية. فالجمع بين رؤيتك الإبداعية وقدرات الإنتاج لدى الذكاء الاصطناعي قد يصنع الظاهرة الرائجة التالية في ASMR، تلك التي تترك المشاهدين بقشعريرة الفروة المُرضية التي يعودون باستمرار للبحث عنها.


