تطور مجال فيديو الذكاء الاصطناعي بسرعة في عام 2024، ثم انفجر في عام 2025. يمكنك الآن كتابة سطر نصي واحد والضغط على التوليد، ثم ترى مقطع فيديو كاملَ التصيير وواقعيًا للغاية يظهر على شاشتك في أقل من 30 ثانية. بالنسبة إلى صنّاع المحتوى للبالغين، هذا يغيّر كل شيء.
السؤال ليس هل يمكنك إنشاء فيديوهات AI للبالغين. أنت تستطيع ذلك. السؤال الحقيقي هو أي النماذج تنتج أحدّ النتائج وأكثرها سينمائية، وأين يمكنك تشغيلها دون الاصطدام بجدران الدفع، أو فلاتر المحتوى، أو العلامات المائية التي تظهر كل عشر ثوانٍ.
يشرح هذا المقال كل ذلك.
ماذا يفعل تحويل النص إلى فيديو بالذكاء الاصطناعي فعليًا
من الأمر النصي إلى مقطع قابل للتشغيل
يعمل تحويل النص إلى فيديو بالذكاء الاصطناعي عبر أخذ وصف مكتوب، ومعالجته بنموذج مدرّب قائم على الانتشار (diffusion) أو على المحوّلات (transformer)، ثم إخراج مقطع فيديو قصير، عادةً من 5 إلى 10 ثوانٍ، يطابق الوصف المكتوب بدقة لافتة.
لا تنتج أحدث أجيال النماذج مجرد تقريبات ضبابية. بل تنتج حركة واقعية كالصور الفوتوغرافية: شعر يتحرك مع الريح، وماء يكسر الضوء بشكل صحيح، وقماش ينسدل ويتدفق بطبيعية. يُنتج أمر نصي مثل "امرأة ترتدي فستانًا من الحرير تمشي في شقة تضيئها الشموع" هذه النتيجة تمامًا، حتى طريقة اهتزاز لهب الشمعة وطريقة التقاط الفستان للضوء.
ما يجعل هذه التقنية مفيدة فعلًا للمحتوى للبالغين هو الجمع بين حركة الجسم الطبيعية، وتصيير البشرة الواقعي، ودقة الإضاءة. عانت النماذج القديمة من الثلاثة. وقد حلّت النماذج المتاحة في 2027 هذه المشكلات إلى حد كبير.
لماذا يحتاج المحتوى للبالغين إلى متطلبات خاصة
يضع إنتاج المحتوى للبالغين متطلبات محددة على نماذج الذكاء الاصطناعي لا تعالجها المولّدات العامة جيدًا. أنت تحتاج إلى:
- ثبات مظهر الشخصية عبر الإطارات، دون وميض في الوجه
- حركة طبيعية لا تبدو آلية أو متقطعة
- ملمس واقعي للبشرة والقماش والماء والأسطح
- تفسير مرن للأوامر النصية لا يرفض المدخلات الإيحائية
- عدم وجود فلاتر رقابة تحجب أي شيء يتجاوز المحتوى المنقّى
تفشل معظم منصات فيديو الذكاء الاصطناعي السائدة في النقطتين الأخيرتين. فهي مصممة لفيديوهات الشرح المؤسسية وعروض المنتجات. وتضع فلاتر مدمجة في بنيتها ترفض أي شيء إيحائي ولو من بعيد، حتى المحتوى الفني أو المحتوى الموجّه نحو الجلامور (glamour).
لا تفرض المنصات والنماذج المذكورة أدناه هذه القيود.
أفضل النماذج لفيديوهات AI للبالغين
Kling V3 Video
يُعد Kling V3 Video من Kwai المعيار الحالي لفيديو الذكاء الاصطناعي الواقعي للبالغين. ينتج مقاطع من 5 إلى 10 ثوانٍ بتفاصيل استثنائية للبشرة، وفيزياء حركة طبيعية، وتصيير ألوان يطابق لقطات الكاميرات الراقية. وجودة الحركة في حركة الجسم، وتحديدًا طريقة انسدال القماش، وحركة الشعر، واستجابة الأجساد للوزن الضمني، لا يضاهيها معظم المنافسين.
أبرز نقاط قوة Kling V3:
- ثبات استثنائي للوجه عبر الإطارات
- محاكاة قماش طبيعية
- دعم عميق للأوامر النصية الإيحائية
- تصيير عمق مجال سينمائي
يوسّع Kling V3 Omni النموذج الأساسي بإدخال نصي وصوري معًا، بحيث يمكنك البدء من صورة وتحريكها مباشرة.
Seedance 2.0
يُعد Seedance 2.0 من ByteDance أول نموذج في هذه القائمة يتضمن توليد صوت أصلي إلى جانب الفيديو. اكتب أمرًا نصيًا، واحصل على مقطع مع صوت محيطي متزامن. بالنسبة إلى صنّاع المحتوى للبالغين الذين يبنون مشاهد بموسيقى أو تعليق صوتي، فهذه فجوة قدرة كبيرة مقارنة بالمنافسين.
تطابق الجودة البصرية لنموذج Kling V3 في معظم المقاييس، مع علم ألوان أدفأ قليلًا يعمل جيدًا في المشاهد الداخلية والحميمية. وتُصيَّر درجات البشرة بشكل جيد بصفة خاصة في ظروف الإضاءة الخافتة.
توجد أيضًا نسخة سريعة، Seedance 2.0 Fast، تضحّي بقدر بسيط من التفاصيل مقابل تقليل كبير في وقت التوليد، وهي مفيدة للتكرار السريع.
PixVerse V5.6
يتفوق PixVerse V5.6 في محتوى البالغين الخيالي والجوي. فبينما يُعد Kling V3 قوة في الواقعية، يقدّم PixVerse جودة أكثر أسلوبًا وسينمائية قليلًا، مثل أفلام دافئة الألوان، وحوافّ ناعمة معتمة (vignettes)، وبيئات خلفية غنية.
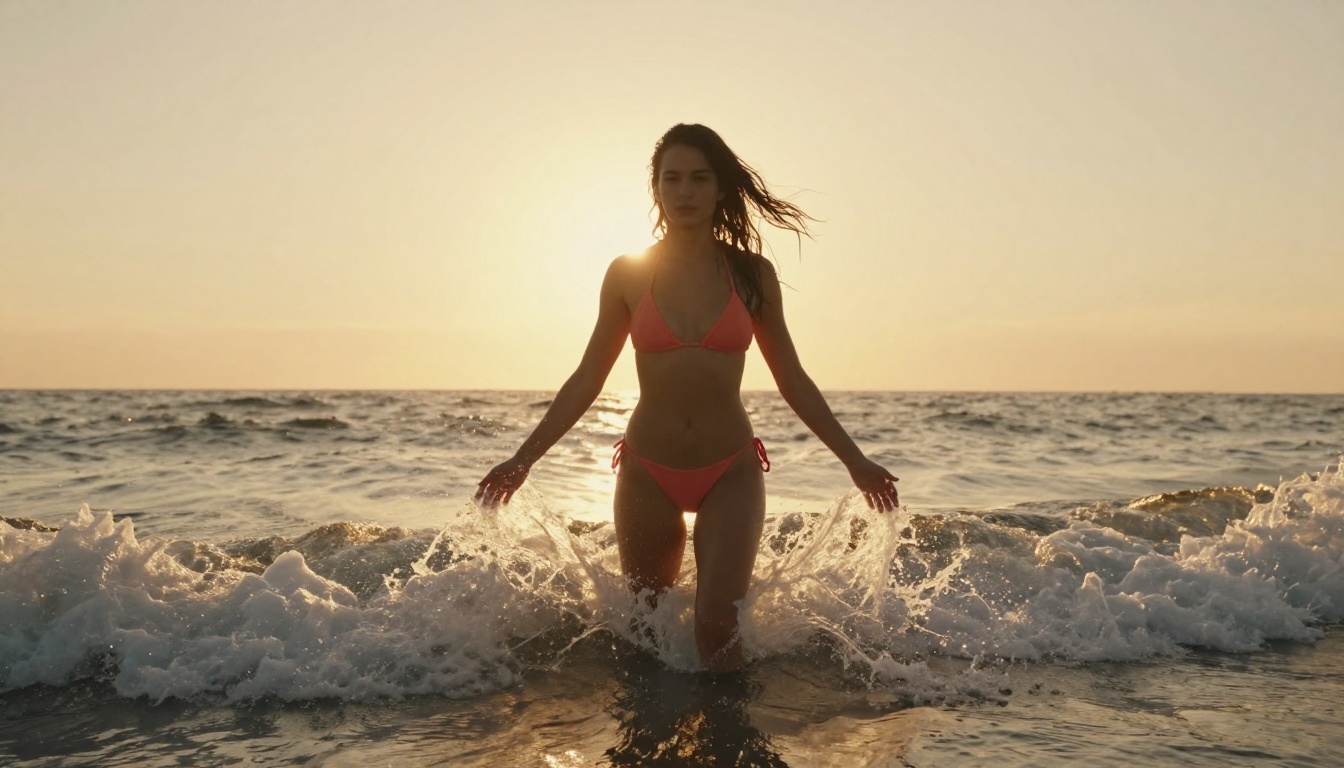
يتعامل بشكل ممتاز مع المشاهد الخارجية: الشواطئ، والبيئات الاستوائية، والسيناريوهات قرب المسابح. ومحاكاة الماء فيه من بين الأفضل بين نماذج تحويل النص إلى فيديو المتاحة حاليًا.
Veo 3 من Google
يُعد Veo 3 نموذج توليد الفيديو الرائد لدى Google. وفيزياء الحركة فيه هي الأدق من الناحية الفيزيائية بين جميع النماذج في هذه القائمة. فالشعر والماء والقماش والدخان تتصرف بدقة تقترب منها النماذج الأخرى ولا تبلغها.
بالنسبة إلى المحتوى للبالغين الذي يتضمن عناصر بيئية معقدة، مثل امرأة عند حافة شلال أو مشهد بقماش تحركه الريح، ينتج Veo 3 نتائج يصعب على المنافسين مطابقتها. وتوجد أيضًا نسخة Veo 3 Fast للمسودات الأسرع.
Hailuo 2.3
يُعد Hailuo 2.3 من Minimax الخيار الاقتصادي مع جودة إخراج متميزة. وهو أسرع من معظم النماذج بهذا المستوى من الجودة، ويتعامل بقوة خاصة مع اللقطات المقربة والمشاهد الحميمية. تحمل تعابير الوجه تفاصيل دقيقة، وحركة العين طبيعية، ويفسر النموذج الأوامر النصية الدقيقة الخاصة بوضعية الجسم بشكل صحيح.
تستحق نسخة Hailuo 2.3 Fast الاستخدام عندما تكون السرعة أهم من التفاصيل المطلقة.
LTX-2.3 Pro
يقدم LTX-2.3-Pro من Lightricks إمكانات تحويل الصوت إلى فيديو، أي أنك تستطيع تحريك صورة على إيقاع مقطع صوتي. وبالنسبة إلى صنّاع المحتوى الذي يبنون مرئيات مدفوعة بالموسيقى أو مشاهد تتفاعل مع الصوت، فهذه القدرة فريدة بين النماذج المذكورة هنا.
كيفية استخدام Kling V3 على PicassoIA
توفر PicassoIA Kling V3 Video ضمن مجموعتها مباشرة، دون اشتراط التسجيل للتوليد الأولي. إليك الخطوات بالتفصيل.
الخطوة 1: افتح صفحة النموذج
انتقل إلى صفحة Kling V3 Video على PicassoIA. سترى حقل إدخال الأمر النصي في الأعلى، ومجموعة من معاملات التوليد أسفله.
الخطوة 2: اكتب أمرك النصي
أكبر عامل منفرد في جودة الإخراج هو جودة الأمر النصي. يستجيب Kling V3 بصورة أفضل للأوامر التي تتضمن:
- وصف الشخص: من أو ما الموجود في المشهد
- المكان والبيئة: أين يقع المشهد
- ظروف الإضاءة: وقت اليوم، ونوع مصدر الضوء
- تفاصيل الكاميرا: الزاوية، والمسافة، ونوع العدسة
- وصف الحركة: الحركة التي تحدث
أمر نصي يعمل بضعف: "امرأة ترتدي بيكيني على الشاطئ"
أمر نصي يعمل جيدًا: "امرأة جميلة ترتدي بيكيني أبيض واقفة على خط الشاطئ لشاطئ استوائي عند الساعة الذهبية، أمواج لطيفة تغسل قدميها، ضوء خلفي دافئ يخلق إضاءة حافة على بشرة مبللة، مصوّرة من ارتفاع الركبة بمسافة متوسطة، حركة بطيئة ولطيفة"
يمنح الأمر النصي الثاني النموذج سياقًا للإضاءة والفيزياء ووضع الكاميرا، وكل ذلك يحسّن جودة الإخراج بشكل كبير.
الخطوة 3: حدد المدة ونسبة العرض إلى الارتفاع
يدعم Kling V3 Video مقاطع من 5 ثوانٍ و10 ثوانٍ. بالنسبة إلى المحتوى للبالغين:
- 5 ثوانٍ أفضل للقطات المقربة والمركّزة
- 10 ثوانٍ مناسبة للمشاهد ذات حركة أكبر أو سرد بيئي
بالنسبة إلى نسبة العرض إلى الارتفاع، تُعد 16:9 المعيار لمعظم المنصات. وتعمل 9:16 إذا كنت تنشئ محتوى لخلاصات عمودية.
الخطوة 4: وَلِّد، وراجع، وكرّر
نادرًا ما تكون أول نتيجة هي النسخة النهائية. ولّد 2 إلى 3 تنويعات للأمر النصي نفسه مع تعديلات صغيرة. وهذه أكثر خطوات التكرار شيوعًا:
| إذا احتوى الإخراج على | جرّب إضافة هذا إلى أمرك النصي |
|---|
| حركة متيبسة | "fluid natural movement, slow motion" |
| إضاءة غير متسقة | حدد اتجاه الضوء: "ضوء دافئ من اليسار" |
| وضعية جسم محرجة | صِف الوضعية بتفصيل أكبر |
| ملمس بشرة مسطح | أضف "بشرة واقعية، 8K، حبيبات فيلم" |
| خلفية عامة | أضف تفاصيل بيئية محددة |
لا علامات مائية، لا فلاتر، لا جدران تسجيل
هنا تفشل معظم المنصات بصمت. تعرض عليك عروضًا مثيرة للإعجاب، وتدفعك إلى التسجيل، ثم تواجهك بما يلي:
- علامات مائية على كل نتيجة حتى تدفع
- فلاتر محتوى ترفض أي شيء يتجاوز أكثر المدخلات تنقيحًا
- حدود للاستخدام تمنع التوليد بعد عدد قليل من المقاطع
- حسابات إلزامية لمجرد رؤية ما يستطيع النموذج فعله
تتبع PicassoIA نهجًا مختلفًا. فنماذج تحويل النص إلى فيديو البالغ عددها أكثر من 89 في المجموعة متاحة دون نقاط الاحتكاك تلك. لا توجد علامات مائية إلزامية تُلصق على المشاهد الحميمية. ولا يوجد نظام فلاتر يرفض "امرأة ترتدي لانجيري" بينما يسمح بالمحتوى نفسه مع تأطير مختلف.
النماذج نفسها هي النسخ الإنتاجية الكاملة، وليست بوابات جودة من فئة العروض التوضيحية.
تجدر الملاحظة: تُشغّل المنصة استدعاءات API الفعلية إلى Kling، وSeedance، وPixVerse، وVeo، ونماذج أخرى. تحصل على جودة النموذج نفسها التي تحصل عليها عند الذهاب مباشرة إلى كل مزوّد، لكن دون إعداد الحساب، ودون إدارة مفاتيح API، ودون تعقيدات الفوترة التي تأتي مع استخدام كل منها على حدة.
ما نوع الفيديوهات التي يمكنك إنشاؤها فعلًا
المدى الذي يدعمه هذا المحتوى من النماذج أوسع مما يتوقعه معظم الناس.
مشاهد الجلامور (glamour) والأزياء
محتوى أزياء على طراز Runway، وجماليات جلسات التصوير لمجلات الأزياء، وعروض اللانجيري وملابس السباحة. وهنا تتألق النماذج الواقعية مثل Kling V3 وSeedance 2.0. فمحاكاة القماش وجودة الإضاءة تنتجان نتائج تبدو فعلًا كفيديو أزياء عالي الميزانية.
تطبيقات عملية:
- محتوى فيديو لدفاتر الأزياء (lookbook)
- مقاطع أزياء لوسائل التواصل الاجتماعي
- فيديوهات عرض منتجات مع عارضة بشرية
السرد الحميمي
سيناريوهات البودوار، ومشاهد غرف النوم، واللحظات الحميمة بين الزوجين. تتعامل النماذج مع المسافات القريبة والإضاءة الخافتة بدقة لافتة. ويتميز Hailuo 2.3 بقوة خاصة هنا بفضل دقة تعابير الوجه وعلم الألوان الدافئ.
السيناريوهات الخيالية والبيئية
مشاهد الشواطئ، وسيناريوهات المسابح، والإعدادات الخارجية ذات الإضاءة الدرامية. يؤدي PixVerse V5.6 وVeo 3 أفضل أداء في هذه السياقات. وتبدو فيزياء الماء والحركة التي تدفعها الريح طبيعية بدلًا من أن تبدو مصطنعة.
تحريك الشخصيات من الصور
إذا كان لديك شخصية أو وجه محدد تريد تحريكه، فنماذج مثل DreamActor-M2.0 وKling Avatar V2 تتيح لك رفع صورة مصدر وتوجيه الشخصية بأوامر نصية. والنتيجة المتحركة تحافظ على هوية الصورة الأصلية.
النماذج في لمحة
نصائح للأوامر النصية التي تهم فعلًا
الأوامر النصية الضعيفة تهدر النقاط وتنتج نتائج متوسطة. هذه هي الأشياء التي تحدث فرقًا حقيقيًا:
1. حدد اتجاه الإضاءة دائمًا
"ضوء دافئ من اليسار" أو "إضاءة خلفية من شمس الغروب" تمنح النموذج مرجعًا فيزيائيًا يستخدمه لحساب الظلال، وإبرازات البشرة، والانعكاسات عبر كل إطار.
2. سمِّ عدسة الكاميرا
"عمق مجال 85mm f/1.4" يخبر النموذج بضغط البعد البؤري وقدر تمويه الخلفية الذي يجب تصييره. هذه الإضافة وحدها ترفع الإخراج من مسطح إلى سينمائي.
3. صِف الحركة في المشهد، لا في الشخص فقط
"شعرها يتحرك في نسيم خفيف" أو "القماش يتحرك بينما تدور" تمنح النموذج متجهات حركة يعمل بها. وغالبًا ما ينتج الأشخاص الذين يبدون ثابتين من أوامر تصف الوضعية دون حركة.
4. استخدم لغة الملمس
"بشرة برونزية ناعمة" أو "شعر مبلل بقطرات الماء" تمنح النموذج خصائص سطحية ليصيّرها بشكل صحيح. وهذا هو الفرق بين النتيجة العامة والنتيجة الواقعية كالصور الفوتوغرافية.
5. حدد المزاج
"حميمي، ناعم، دافئ" مقابل "درامي، عالي التباين، سينمائي" ينتج تدرجات ألوان واختيارات إضاءة مختلفة تمامًا، حتى مع وصف الشخص نفسه.
الاتساق عبر عدة مقاطع
من التحديات العملية لفيديو الذكاء الاصطناعي للمحتوى للبالغين هو ثبات الشخصية. إذا كنت تبني سلسلة من المقاطع يجب أن تظهر فيها الشخصية نفسها، فأنت تحتاج إلى طرق للحفاظ على الهوية البصرية عبر التوليدات.
الطريقة الأكثر موثوقية: استخدم مسار تحويل الصورة إلى فيديو بدلًا من تحويل النص إلى فيديو الخالص.
- ولّد صورة مرجعية ثابتة لشخصيتك باستخدام نموذج تحويل النص إلى صورة
- استخدم تلك الصورة كإطار بداية لنماذج مثل Kling V3 Omni أو Wan 2.6 I2V
- يبدأ كل مقطع مُولَّد من المرجع نفسه، ما يحافظ على مظهر الشخصية
لا يضمن هذا الأسلوب اتساقًا مثاليًا، لكنه ينتج نتائج أكثر تماسكًا بكثير من التوليد من النص وحده عبر عدة مقاطع.
نصيحة: احفظ رقم قيمة البذرة (seed) الدقيق من توليد صورتك المرجعية الأفضل. تنتج قيم البذرة المختلفة شخصيات مختلفة حتى مع أوامر نصية متطابقة. وإذا وجدت شخصية تعجبك، فرقم البذرة هذا هو ما يعيد إنتاجها بثبات.
الدقة وجودة الإخراج
تُخرج جميع النماذج على PicassoIA بدقة جاهزة للإنتاج. ومعظمها يولّد بدقة 720p أو 1080p حسب النموذج والإعدادات.
بالنسبة إلى صنّاع المحتوى الذين يحتاجون إلى إخراج نهائي بدقة أعلى، توفر المنصة أيضًا نماذج الدقة الفائقة التي ترفع دقة إطارات الفيديو 2 أو 4 مرات دون تدهور واضح. وتشغيل فيديو ذكاء اصطناعي بدقة 720p عبر أداة رفع دقة 2x قبل النشر ينتج نتائج تصمد على الشاشات الكبيرة.
أنشئ مقطعك الأول الآن
التقنية متاحة، والنماذج تعمل، والنتائج تتحدث عن نفسها. لا تحتاج إلى كاميرا، ولا عارضة، ولا موقع تصوير، ولا ميزانية إنتاج.
اختر نموذجًا، واكتب أمرًا نصيًا مفصلًا، واضغط على التوليد.
يُعد Kling V3 Video نقطة البداية إذا أردت أفضل واقعية. وSeedance 2.0 إذا أردت إدراج الصوت. وPixVerse V5.6 إذا أردت مشاهد خارجية سينمائية بسرعة.
جميع نماذج تحويل النص إلى فيديو البالغ عددها أكثر من 89 متاحة عبر PicassoIA دون فلاتر محتوى، ودون علامات مائية على مخرجاتك، ودون إنشاء حساب إلزامي يقف بينك وبين مقطعك الأول. الشيء الوحيد الذي يفصلك عن فيديو AI للبالغين مكتمل هو الأمر النصي الذي لم تكتبه بعد.
اكتبه.


