تخيّل أنك سجّلت فيديو تتحرك فيه الشفاه بشكل لا يتطابق مع الصوت. هذا الانفصال المحرج يُفقد المشاهدين اهتمامهم أسرع من أي عامل آخر. كان تصحيح مزامنة الشفاه التقليدي يتطلب تحريرًا دقيقًا لكل إطار على حدة، وبرامج متخصصة تكلّف آلاف الدولارات، وأسابيع من العمل لبضع دقائق من الفيديو. أما اليوم، فقد أزال الذكاء الاصطناعي هذه الحواجز تمامًا.
تحلّل مولدات مزامنة الشفاه المجانية بالذكاء الاصطناعي الصوت، وتستخلص الفونيمات (وحدات الصوت المميزة في اللغة)، ثم تربطها بأشكال الشفاه المقابلة لها في الوقت الفعلي. وقد بلغت هذه التقنية مستوى تكاد فيه النتائج لا تُميَّز عن الكلام الطبيعي. وسواء كنت تدبلج مقاطع موجودة، أو تنشئ شخصيات ناطقة من الصور، أو تولّد محتوى تعليميًا، فإن هذه الأدوات تقدّم جودة احترافية دون السعر الاحترافي.
لماذا تهم مزامنة الشفاه بالذكاء الاصطناعي الآن
ازداد الطلب على محتوى الفيديو بشكل كبير. تُعطي منصات التواصل الاجتماعي الأولوية للفيديو، وانتقل التدريب المؤسسي إلى الصيغ الرقمية، وصار المحتوى التعليمي يعتمد أكثر على الشروح المتحركة. وعندما تتطابق حركات الشفاه تمامًا مع الصوت، يرتفع معدل بقاء المشاهدين بنسبة 40% وفقًا لدراسات حديثة. فالدماغ يعالج المعلومات السمعية البصرية المتزامنة بكفاءة أعلى، فيخلق تجربة مشاهدة سلسة تبدو طبيعية بدل أن تكون مشتتة.
💡 نصيحة احترافية: مزامنة الشفاه المثالية لا تتعلق بالدقة وحدها، بل بالتوقيت أيضًا. تأخذ أفضل أدوات الذكاء الاصطناعي في الحسبان فترات الصمت الطبيعية في الكلام، وأصوات التنفس، والاختلافات الدقيقة في طريقة نطق الناس للكلمات.
كيف تعمل تقنية مزامنة الشفاه بالذكاء الاصطناعي
تتبع العملية تسلسلًا منطقيًا يحاكي الطريقة التي يزامن بها الإنسان الكلام مع حركات وجهه بشكل طبيعي:
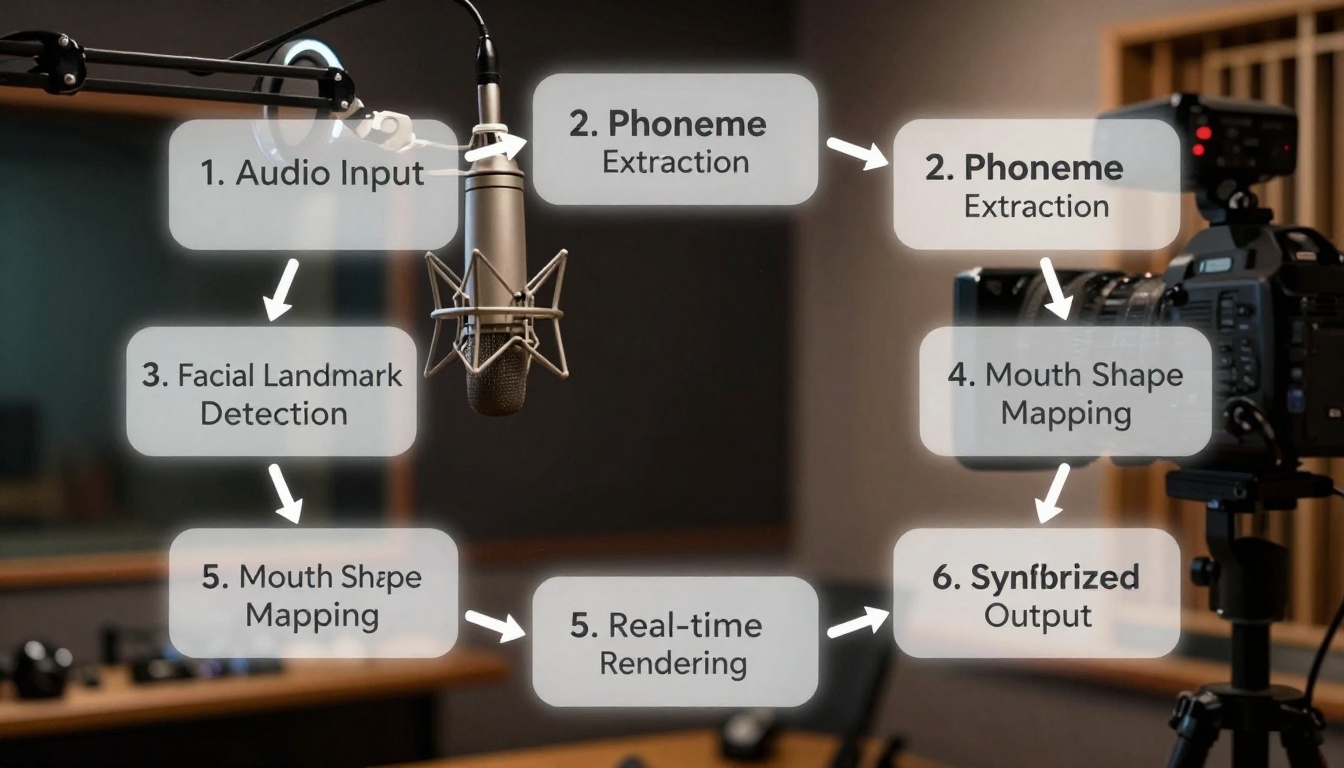
- معالجة الصوت: يحلّل النظام ملف الصوت الخاص بك، ويحدد الفونيمات (وحدات الصوت الأساسية مثل "p" و"t" و"k") وتوقيتها
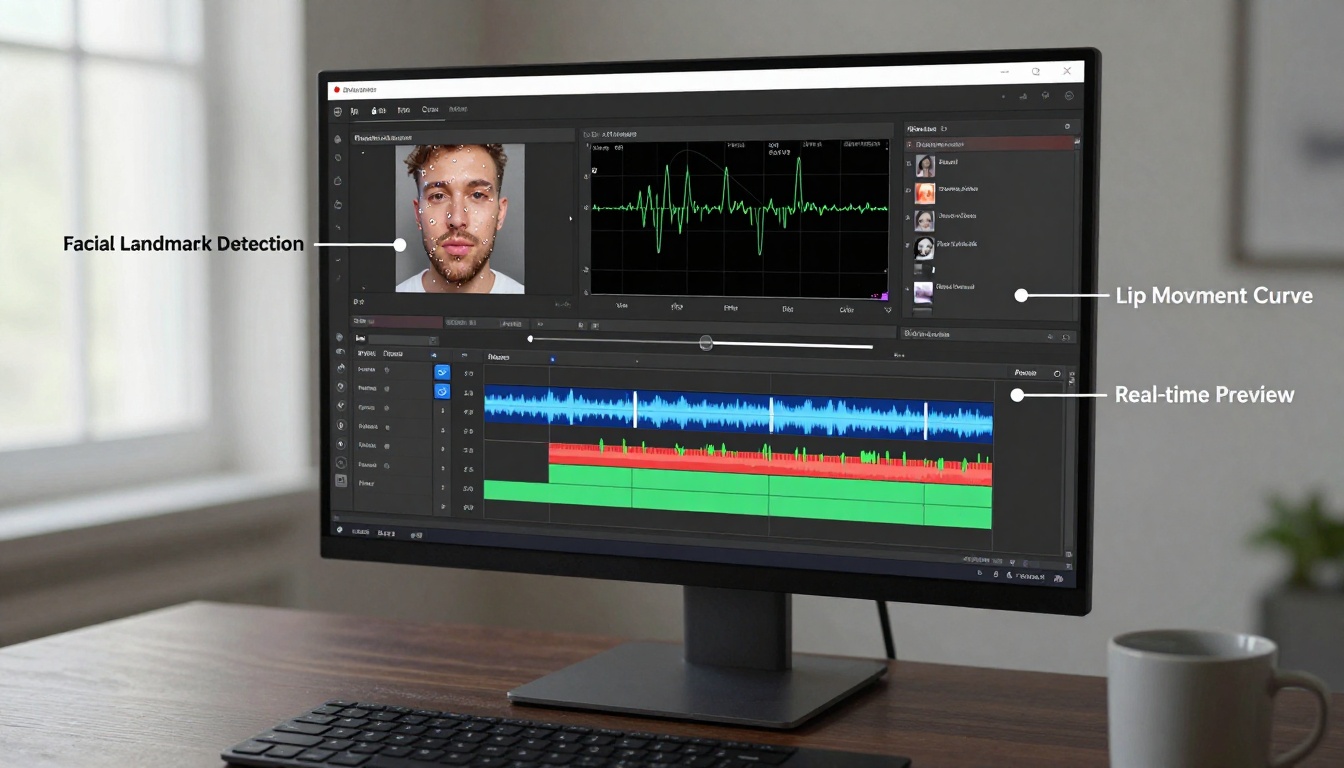
- اكتشاف الوجه: بالنسبة إلى الفيديو الموجود، يحدد الذكاء الاصطناعي المعالم الوجهية، أي 68 نقطة رئيسية حول الفم والعينين والفك
- خوارزمية الربط: يُقابَل كل فونيم بأشكال محددة للشفاه وحركات عضلية معينة
- محرك التصيير: يولّد الذكاء الاصطناعي حركات الشفاه أو يعدّلها إطارًا بإطار
- تركيب المخرجات: يجمع الفيديو النهائي بين اللقطات الأصلية وحركات شفاه موقوتة بدقة
الاختراق التقني يأتي من نماذج تعلم الآلة المدرَّبة على ملايين الساعات من لقطات الكلام المتزامن. لا تتعلم هذه النماذج أشكال الشفاه الأساسية فحسب، بل تتعلم أيضًا اللهجات الإقليمية، وأنماط الكلام، والاختلافات المرتبطة بالعمر، والتعابير العاطفية المصاحبة لأنواع الكلام المختلفة.
أفضل أدوات مزامنة الشفاه المجانية بالذكاء الاصطناعي المتاحة اليوم
توجد عدة خيارات مجانية ممتازة تقدّم نتائج احترافية. إليك ما يميّز كل واحد منها:
| الأداة | أفضل استخدام | الميزة الرئيسية | القيود |
|---|
| react-1 | التعبير العاطفي | تصوير عاطفي واقعي | الخطة المجانية تحتوي على علامات مائية |
| omni-human | التحريك لكامل الجسم | ينشئ فيديوهات متحركة من الصور | أنماط شخصيات محدودة |
| kling-lip-sync | المعالجة عالية السرعة | تصيير سريع في أقل من 60 ثانية | مخرجات بدقة أقل |
| lipsync-2 | نتائج بجودة الاستوديو | دقة احترافية | يتطلب مادة مصدر جيدة |
| fabric-1.0 | تحريك الصور البسيطة | يحوّل الصور إلى فيديوهات ناطقة | حركات شفاه أساسية فقط |
| lipsync | أسلوب الرسوم المتحركة والكرتون | تحريك شخصيات بأسلوب مُنمَّق | ليس واقعيًا كالصور الفوتوغرافية |
| lipsync-2-pro | المشاريع التجارية | أعلى جودة متاحة | مع علامة مائية في النسخة المجانية |
اختيار الأداة المناسبة يعتمد على احتياجاتك المحددة. في المحتوى التعليمي حيث يهم الوضوح أكثر من أي شيء، تقدّم lipsync-2 مطابقة للفونيمات هي الأدق. أما في الترفيه أو وسائل التواصل الاجتماعي حيث تدفع العاطفة التفاعل، فإن react-1 يلتقط تعابير الوجه الدقيقة التي تصاحب الكلام.
تطبيقات عملية يمكنك البدء بها اليوم
تفتح مرونة أدوات مزامنة الشفاه المجانية بالذكاء الاصطناعي أبوابًا في صناعات متعددة:
إنشاء المحتوى ووسائل التواصل الاجتماعي
- الدبلجة على YouTube: أضف تعليقًا صوتيًا احترافيًا إلى المقاطع الموجودة
- TikTok/Reels: أنشئ محتوى جذابًا بشخص يتحدث أمام الكاميرا دون تسجيل فيديو جديد
- تحسين البودكاست: حوّل البودكاست الصوتي إلى تجارب بصرية
- القنوات اللغوية: أنشئ محتوى بلغات متعددة باستخدام القاعدة البصرية نفسها
التعليم والتدريب
- الدورات الإلكترونية: حرّك شخصيات تاريخية أو خبراء
- تعلم اللغات: أظهر أشكال الشفاه لتدريب النطق
- التدريب المؤسسي: أنشئ رسائل متسقة للفرق العالمية
- التعليم الخاص: أدوات الكلام المرئي لذوي الإعاقة السمعية
الترفيه والإعلام
- الأفلام المستقلة: أصلح مشكلات تزامن الحوار في مرحلة ما بعد الإنتاج
- الرسوم المتحركة: مزامنة شفاه سريعة لتحريك الشخصيات
- الألعاب: أنشئ حوارات لشخصيات الألعاب
- إعادة إحياء التاريخ: أعد الحياة إلى اللقطات الأرشيفية بدبلجة دقيقة
خطوة بخطوة: إنشاء أول فيديو لك بمزامنة الشفاه بالذكاء الاصطناعي
يتطلب البدء معرفة تقنية بسيطة. اتبع هذه العملية المباشرة:
-
جهّز مادة المصدر الخاصة بك
- للفيديو الموجود: تأكد من إضاءة جيدة ووضوح الوجه
- لتحريك الصور: استخدم صورًا شخصية أمامية عالية الدقة
- جودة الصوت: سجّل في بيئة هادئة بكلام واضح
-
اختر منصتك
- الأدوات المعتمدة على الويب لا تتطلب تثبيتًا
- تتيح التطبيقات المكتبية تحكمًا أكبر
- توفر تطبيقات الجوال سهولة للمشاريع السريعة
-
ارفع المادة وعالجها
- تعالج معظم الأدوات الملفات التي يقل حجمها عن 100 ميغابايت مجانًا
- يتراوح زمن المعالجة بين 30 ثانية و5 دقائق
- عاين النتيجة قبل الإنهاء للتحقق من الدقة
-
اضبط الإعدادات
- حساسية المزامنة: اضبط مدى دقة تتبع الفم للصوت
- مستوى التعبير: تحكّم في شدة تعابير الوجه
- الحفاظ على الأسلوب: حافظ على الجماليات الأصلية للفيديو
- صدّر وشارك
- تحتوي النسخ المجانية عادةً على علامات مائية
- خيارات الدقة من 480p حتى 1080p
- المشاركة المباشرة إلى منصات التواصل الاجتماعي متاحة
التحديات الشائعة والحلول
حتى مع الذكاء الاصطناعي المتقدم، قد تواجه مشكلات. إليك كيفية حلّها:
المشكلة: تبدو حركات الشفاه آلية أو غير طبيعية
الحل: اضبط شريط "الطبيعية" في الأداة التي اخترتها. تتضمن معظم برامج مزامنة الشفاه بالذكاء الاصطناعي هذا التحكم، الذي يضيف تغيرات دقيقة إلى حركات الشفاه تحاكي عدم الكمال البشري.
المشكلة: ينحرف الصوت والفيديو عن التزامن مع مرور الوقت
الحل: يشير هذا عادةً إلى معدل إطارات متغير في الفيديو المصدر. حوّل الفيديو إلى معدل إطارات ثابت (CFR) قبل المعالجة. تتعامل أدوات مجانية مثل HandBrake مع هذا التحويل بسهولة.
المشكلة: يفشل اكتشاف الوجه مع زوايا أو إضاءة معينة
الحل:
- تعمل اللقطات الأمامية بأفضل شكل (ضمن 30 درجة من الاستقامة المباشرة)
- تأكد من إضاءة متساوية دون ظلال حادة
- تجنب الإكسسوارات التي تحجب ملامح الوجه (النظارات، والقبعات، والأقنعة)
المشكلة: الكلام بلكنة أجنبية لا يتزامن بشكل صحيح
الحل: تتعامل بعض الأدوات مع اللهجات بشكل أفضل من غيرها. تمتلك react-1 و lipsync-2-pro مكتبات فونيمات أوسع تستوعب الاختلافات الإقليمية في أنماط الكلام.
اعتبارات تقنية لأفضل النتائج
يتطلب تحقيق جودة احترافية الانتباه إلى هذه التفاصيل التقنية:
قائمة التحقق من إعداد الصوت:
- معدل العينة: 44.1 كيلوهرتز أو 48 كيلوهرتز
- عمق البت: 16 بت أو أعلى
- صيغة الملف: WAV أو MP3 عالي الجودة
- إزالة الضوضاء: أزل الهمهمات والنقرات الخلفية
- التطبيع: مستويات صوت متسقة طوال الملف
متطلبات مصدر الفيديو:
- الدقة: 720p كحد أدنى، ويفضّل 1080p أو أعلى
- معدل الإطارات: 24 أو 25 أو 30 fps (ثابت)
- الترميز: H.264 أو أحدث للتوافق
- الإضاءة: إضاءة متساوية دون تباين شديد
- الثبات: حركة كاميرا ضئيلة أثناء الكلام
إعدادات المعالجة المهمة:
- دقة الفونيمات: الإعدادات الأعلى = أشكال شفاه أدق
- الحفاظ على التعبير: توازن بين دقة المزامنة والحركة الطبيعية للوجه
- جودة التصيير: الإعدادات الأعلى تستغرق وقتًا أطول لكنها تنتج نتائج أكثر سلاسة
- صيغة المخرجات: صيغة MP4 مع ترميز H.264 تعمل على كل الأجهزة
مقارنة التكلفة: المجاني مقابل المدفوع
رغم أن هذا المقال يركز على الأدوات المجانية، فإن فهم المشهد المدفوع يساعد في اتخاذ قرارات مدروسة:
ما تقدمه النسخ المجانية:
- وظيفة مزامنة الشفاه الأساسية
- مخرجات تحتوي على علامات مائية
- قيود على حجم الملف (عادةً 100 ميغابايت)
- انتظار في قائمة المعالجة خلال أوقات الذروة
- خيارات دقة محدودة (عادةً 720p كحد أقصى)
ما تضيفه الترقيات المدفوعة عادةً:
- إزالة العلامة المائية
- تصدير بدقة أعلى (4K متاحة)
- معالجة ذات أولوية
- إمكانات المعالجة الدفعية
- عناصر تحكم متقدمة للتخصيص
- حقوق الاستخدام التجاري
متى تفكر في الخيارات المدفوعة:
- المشاريع التجارية التي تهم فيها العلامة التجارية
- احتياجات الإنتاج عالي الحجم
- المخرجات الحساسة للوقت
- الحاجة إلى أعلى جودة ممكنة
- عناصر محفظة الأعمال المهنية
التطورات المستقبلية في تقنية مزامنة الشفاه بالذكاء الاصطناعي
يواصل هذا المجال تقدمه بسرعة. إليك ما يمكن توقعه في الأشهر المقبلة:
المعالجة في الوقت الفعلي: تعالج الأدوات الحالية خلال ثوانٍ أو دقائق، لكن مزامنة الشفاه في الوقت الفعلي أثناء مكالمات الفيديو المباشرة أو البث ستصبح معيارًا.
الذكاء العاطفي: بما يتجاوز حركات الشفاه الأساسية، سيلتقط الذكاء الاصطناعي ويعيد إنتاج المدى الكامل للتعبير العاطفي البشري أثناء الكلام.
المزامنة عبر اللغات: أدوات قادرة على أخذ صوت بلغة واحدة وإنتاج حركات شفاه دقيقة لصوتيات لغة أخرى.
ميزات إمكانية الوصول: التكامل مع سماعات الأذن الطبية والتعرف البصري على الكلام لتحسين إمكانية الوصول إلى التواصل.
ابدأ فورًا
لم يكن الدخول إلى هذا المجال أسهل من أي وقت مضى. اختر أداة واحدة من القائمة أعلاه، واجمع مادة المصدر الخاصة بك، وعالج أول فيديو لك اليوم. تتطلب معظم المنصات تسجيل البريد الإلكتروني فقط، دون الحاجة إلى بطاقة ائتمان للوصول إلى الخطة المجانية.
توصيات البدء السريع:
- المستخدمون الجدد: جرّب lipsync-2 لما يوفره من توازن بين البساطة والجودة
- صنّاع المحتوى: تقدم react-1 العمق العاطفي الذي يجذب الجمهور
- المعلمون: ينشئ omni-human عروضًا تقديمية متحركة كاملة من الصور الثابتة
مشروعك الأول: خذ مقطعًا مدته 30 ثانية من هاتفك، وسجّل تعليقًا صوتيًا واضحًا، ثم شغّله عبر الأداة التي اخترتها. منحنى التعلم بسيط للغاية، والرضا عند رؤية مزامنة شفاه مثالية يأتي فورًا.
بلغت التقنية مرحلة تقدّم فيها الأدوات المجانية نتائج كانت تتطلب قبل بضع سنوات فقط برامج بآلاف الدولارات ومهارات متخصصة. سواء كنت تصلح محتوى موجودًا أو تنشئ فيديوهات ناطقة جديدة من الصفر، فإن مولدات مزامنة الشفاه بالذكاء الاصطناعي تزيل الحواجز التقنية وتضع مزامنة الفيديو بجودة احترافية في متناول الجميع.
والآن بعد أن رأيت ما هو ممكن مع أدوات مزامنة الشفاه المجانية بالذكاء الاصطناعي، لماذا لا تجرب إنشاء فيديوهاتك الناطقة الخاصة؟ تقدّم المنصات المذكورة في هذا المقال وصولًا فوريًا إلى تقنية تحوّل الصور الثابتة إلى محتوى متحرك جذاب. لكل أداة نقاطها القوية، فبعضها يتفوق في التعبير العاطفي بينما يركز بعضها الآخر على الدقة التقنية. جرّب أساليب مختلفة مع مادة المصدر نفسها لتكتشف أي سير عمل يناسب أسلوبك الإبداعي واحتياجات محتواك.


