يشهد مجال مزامنة الشفاه بالذكاء الاصطناعي تطورًا سريعًا، ويتصدّر Kling v3 معظم القوائم حاليًا. ويثير وضع الأفاتار 18+ بالتحديد الكثير من الأسئلة: هل يعمل فعليًا بشكل مختلف عن الوضع القياسي؟ وما مستوى الواقعية الذي يمكن توقعه؟ وما القيود الحقيقية في الاستخدام الفعلي؟ يشرح هذا المقال كل ذلك دون مبالغة.
ما هي مزامنة شفاه الأفاتار في Kling v3 فعليًا
Kling v3 نموذج لتوليد الفيديو طوّرته KwaiVGI، وهي الذراع البحثية للذكاء الاصطناعي في Kuaishou. ورغم أن النموذج معروف أساسًا بمخرجات تحويل النص إلى فيديو ذات الطابع السينمائي، فإن قدراته في مزامنة الشفاه وتحريك الأفاتار أصبحت حالة استخدام رئيسية، خاصةً لصانعي الفيديوهات التي تعتمد على الرأس المتحدث.
تطبّق أداة Kling Lip Sync تقنية النموذج لتتبع الفم وتركيب الفونيمات على مقاطع الفيديو أو صور الأفاتار الموجودة، فتحرّك الشفاه بشكل واقعي اعتمادًا على إدخال صوتي. ويشير التصنيف 18+ إلى سياسات المحتوى: فعلى عكس الوضع القياسي، يقبل المستوى 18+ مدخلات أفاتار للبالغين، ويرفع بعض القيود الجمالية المتعلقة بكشف الجلد والأماكن الحميمة والتعبيرات الإيحائية.
كيف تعمل التقنية
يعتمد نظام مزامنة الشفاه في Kling v3 في جوهره على مزيج من:
- كشف الفونيمات: يُحلَّل الإدخال الصوتي إلى مقاطع فونيمية، وهي الوحدات الصوتية المنفردة للكلام.
- تتبع المعالم الوجهية: تُرسم النقاط الرئيسية على الوجه، خاصةً حول الشفاه والذقن والفك، وتُحرَّك وفق كل فونيم.
- الاتساق الزمني: تضمن وحدة تعتمد على الانتشار أن تنتقل الإطارات بسلاسة، بدلًا من حركة الفم المتقطعة الشائعة في الأنظمة القديمة.
- الحفاظ على الهوية: يبقى وجه الأفاتار ولون بشرته وملامحه المحيطة متسقة عبر جميع الإطارات، حتى أثناء تسلسلات الفونيمات السريعة أو المعقدة.
حقق Kling v3 تحسنًا كبيرًا في هذه الركائز الأربع مقارنةً بالإصدارات السابقة. وقد أُعيد بناء وحدة الاتساق الزمني تحديدًا، لمعالجة أكبر شكوى بصرية تكررت بشأن مخرجات مزامنة الشفاه في v1.5 و v2.x.
لماذا يغيّر وضع 18+ المخرجات
الفرق بين الوضع القياسي ووضع 18+ ليس متعلقًا بالمحتوى وحده. هناك عدة عوامل تقنية تتغير:
- تفاصيل عرض الجلد: يطبّق الوضع القياسي تنعيمًا محافظًا لتجنب مخرجات صريحة عرضية في الحالات الاستثنائية. ويزيل المستوى 18+ فلتر المعالجة اللاحقة هذا، فينتج عنه ملمس بشرة أكثر واقعية، وتجاعيد التعابير الدقيقة، وتفاصيل عظمة الترقوة.
- نطاق التعابير: تربط الخريطة من الفونيمات إلى التعابير نطاقًا أوسع في وضع 18+. ويقيّد الوضع القياسي بعض أوضاع فتح الفم وظهور اللسان. أما المستوى 18+ فيُلغي تلك القيود.
- قبول صورة الإدخال: تُرفض بعض صور الأفاتار من المصنّف في الوضع القياسي بسبب الملابس أو الوضعية أو العري الجزئي. ويُضبط مصنّف وضع 18+ لقبول نطاق أوسع بكثير من مدخلات الأفاتار.
ما الذي تحصل عليه فعليًا
لنستعرض ميزة بميزة ما تقدّمه مزامنة شفاه الأفاتار 18+ في Kling v3 عمليًا.
دقة مزامنة الفم
جيدة جدًا للإنجليزية والماندرين. مقبولة للغات الأوروبية الرئيسية. ضعيفة للغات النغمية الشديدة ذات تبديل الفونيمات السريع.
عمليًا، يتعامل Kling v3 مع الكلام الإنجليزي بمستوى مقنع كأنه بشري بسرعات المشاهدة العادية. وعند التشغيل البطيء (0.5x) يمكنك ملاحظة إطار متفرّق لا يتطابق فيه شكل الشفاه تمامًا مع الفونيم، لكن بالسرعة العادية يصمد الوهم بشكل جيد.
دعم الماندرين قوي، وهذا منطقي بالنظر إلى أصول KwaiVGI. والإسبانية والفرنسية تؤديان بشكل معقول. أما العربية ولغات جنوب شرق آسيا النغمية الشديدة فتُظهر قدرًا أكبر من عدم الاتساق.
بالنسبة للمحتوى الغنائي، تنخفض الدقة بشكل ملحوظ. لم يُدرَّب النموذج على مجموعات بيانات مُحسّنة للغناء، وهذا واضح: تمدد حروف العلة أثناء النغمات الممدودة ينتج أوضاعًا للشفاه تنحرف عن الواقعية، وتسلسلات المقاطع السريعة في الأغاني ذات الإيقاع المتسارع تُحدث تشويهات تقطّع مرئية.
💡 نصيحة: في مزامنة الشفاه للغناء، جرّب أولًا صوتًا بإيقاع أبطأ. وإذا ظلت النتيجة غير موثوقة، فإن Sync Lipsync 2 Pro أو React 1 by Sync Labs يتعاملان مع المحتوى الموسيقي بشكل أفضل.
متطلبات صورة الأفاتار
هنا يواجه كثير من المستخدمين المشكلات. تتطلب مزامنة الشفاه في Kling v3 ما يلي:
| المتطلب | المواصفات |
|---|
| اتجاه الوجه | قريب من الأمامي (أقصى دوران نحو 30°) |
| دقة الوجه | عرض 512 بكسل كحد أدنى، ويُوصى بـ 1024 بكسل فأكثر |
| حجب الوجه | الحد الأدنى: بدون نظارات شمسية أو أقنعة أو شعر كثيف يغطي الوجه |
| الإضاءة | متساوية أو جانبية. تجنّب التباين الضوئي الحاد |
| التعبير | محايد أو ابتسامة خفيفة. تجنّب الابتسامات التي تكشف الأسنان |
| صيغة الصورة | JPG أو PNG، بحجم أقل من 10 ميغابايت |
بالنسبة لمحتوى 18+ تحديدًا، يمكن أن تُظهر صورة الأفاتار ما يلي:
- ملابس داخلية أو ملابس سباحة أو عريًا جزئيًا (غير صريح)
- وضعيات وتعبيرات إيحائية
- أماكن حميمة مثل غرف النوم أو المسابح أو بيئات الاستوديو
ما لا يزال يرفضه حتى في وضع 18+: العري الصريح أو الأفعال الجنسية، ووجود عدة وجوه في صورة الأفاتار الأساسية، والصور المموّهة بشدة أو المعدّلة بفلاتر فنية، والوجوه التي تحمل فلاتر تجميل قوية تُربك نظام تتبع المعالم.
مرونة إدخال الصوت
يقبل Kling v3:
- ملفات MP3 وWAV وM4A وAAC بمدة تصل إلى 60 ثانية
- متحدث واحد فقط (الصوت متعدد المتحدثين ينتج مخرجات متدهورة)
- معدل العينات الموصى به: 44.1 كيلوهرتز أو 48 كيلوهرتز
- الحد الأقصى لحجم الملف: 20 ميغابايت
💡 نصيحة: أزل الموسيقى الخلفية قبل الرفع. تشوّش الموسيقى المتسربة على كاشف الفونيمات وتنتج أشكالًا عشوائية للفم. استخدم أداة لعزل الصوت أولًا.
يتعامل النموذج جيدًا مع التعليق الصوتي والحوار المكتوب وصوت المحادثة الطبيعية. ويعطي الكلام المولّد بالذكاء الاصطناعي أنظف النتائج، لأن توقيته ثابت ولا يحتوي على ضوضاء خلفية.
Kling v3 مقابل الإصدارات الأقدم
ما الذي أصلحه v3
القفزة من v2.1/v2.6 إلى v3 مهمة بالنسبة لمزامنة الشفاه تحديدًا:
الاتساق الزمني هو التحسن الأبرز. كان مستخدمو v2.x كثيرًا ما يلاحظون وميضًا حول الفك والخد السفلي بين الإطارات، حتى عندما يكون شكل الفم نفسه صحيحًا. وقد عالج v3 ذلك بإدخال خسارة للاتساق في التدفق أثناء التدريب تفرض انتقالات أكثر سلاسة.
انجراف الهوية انخفض بشكل كبير. ففي المقاطع الطويلة (30 إلى 60 ثانية)، كانت أفاتارات v2.x تنجرف تدريجيًا في تناسب الملامح أو لون البشرة أو توزيع الشعر. أما v3 فيبقى مستقرًا طوال مدة المقطع المدعومة كاملةً.
التفاصيل الدقيقة للتعبيرات تحسّنت بشكل عام. فمنطقة العينين والحاجبين وجسر الأنف تستجيب الآن بشكل خفيف لانتقالات الفونيمات، بطريقة تبدو كتعبير بشري طبيعي وليس وجهًا ثابتًا مع شفاه متحركة. وهذا ما يجعل محتوى 18+ يبدو أكثر واقعية بشكل ملحوظ.
ميزات لا تزال غائبة
رغم التحسينات، لا تفعل مزامنة شفاه Kling v3 ما يلي:
- حركة الرأس: يبقى رأس الأفاتار في مكانه. لن تحصل على إيماءات طبيعية أو ميلان أو تمايل أثناء الكلام.
- التحكم في الرمش: تحدث الرمشات على فترات ثابتة بغض النظر عن طاقة الصوت، وقد تبدو آلية أثناء المقاطع الكلامية المكثفة.
- تحريك الجسم: يُحرَّك الوجه فقط، وتبقى بقية صورة الأفاتار ثابتة.
- المعالجة الفورية: التوليدات غير متزامنة. توقّع من 30 إلى 120 ثانية حسب طول المقطع وحمل الخادم.
| الميزة | Kling v3 | Omni Human 1.5 |
|---|
| حركة الرأس | لا | نعم |
| إيماءات الجسم | لا | نعم (محدودة) |
| محتوى 18+ | نعم | لا |
| الاتساق الزمني | ممتاز | جيد جدًا |
| نطاق لغات الصوت | واسع | واسع |
لتحريك الجسم كاملًا مع مزامنة الصوت، فإن Omni Human 1.5 by ByteDance هو الخيار الأقوى، رغم أنه يخضع لسياسات محتوى أكثر صرامة.
كيفية استخدام مزامنة شفاه Kling على PicassoIA
Kling Lip Sync متاح على PicassoIA دون إعداد محلي أو مفاتيح API. إليك سير العمل بالتفصيل:
خطوات التنفيذ
1. جهّز صورة الأفاتار
ابدأ بصورة أمامية أو قريبة من الأمامية، بعرض 1024 بكسل كحد أدنى. وبالنسبة لمحتوى 18+، تأكد من أن الصورة غير صريحة لكنها قد تكون إيحائية. تعطي الإضاءة الجيدة والتعبير المحايد أو الابتسامة الخفيفة أنظف نتيجة لمزامنة الشفاه.
2. جهّز الصوت
يعمل الصوت النظيف لمتحدث واحد بأفضل شكل. إذا كنت تولّد الصوت باستخدام نموذج ذكاء اصطناعي، فصدّره بمعدل 44.1 كيلوهرتز بصيغة WAV. أزل أي موسيقى خلفية أو ضوضاء محيطة أولًا.
3. افتح الأداة
انتقل إلى نموذج Kling Lip Sync على PicassoIA. سترى خانات إدخال لصورة الأفاتار وملف الصوت.
4. ارفع الملفات واضبط الإعدادات
ارفع صورة الأفاتار والصوت. فعّل مفتاح وضع 18+ إن كان متاحًا وكان المحتوى مؤهلًا لذلك. واترك الإعدادات الأخرى على وضعها الافتراضي ما لم يكن لديك سبب محدد لتغييرها.
5. ولّد وراجع
أرسل التوليد. وحسب حمل الخادم، توقّع النتائج خلال 30 إلى 120 ثانية. عاين المخرجات، وتحقق من مزامنة الشفاه بالسرعة العادية وبسرعة تشغيل مخفّضة.
6. أعد المحاولة عند الحاجة
إذا ظهرت عيوب بصرية حول الفك أو انزياح في الفيديو الناتج من المحاولة الأولى، فجرّب قص الصورة المصدر بحيث يتمركز الوجه في المنتصف بشكل أوضح، أو اضبط الصوت لإزالة أي فجوات صامتة تزيد مدتها على 2 ثانية.
نصائح للحصول على نتائج أفضل
- التعبير المحايد الأساسي هو الأفضل: الوجه الذي تظهر أسنانه في صورة المصدر يترك للنموذج مساحة أقل للعمل. وتعطي الابتسامة الخفيفة المريحة أكثر الانتقالات طبيعية.
- الصوت عالي التباين يساعد: الكلام الذي يتفاوت في مستوى الصوت (وليس رتيبًا) يمنح كاشف الفونيمات إشارة أنظف.
- أبقِ المقاطع دون 30 ثانية: المقاطع الأطول تضخّم أي انجراف في الهوية لا يزال موجودًا في v3. قسّم النصوص الطويلة إلى مقاطع من 20 إلى 30 ثانية ثم ادمج المخرجات.
- استخدم الصوت المولّد بالذكاء الاصطناعي للحصول على أفضل مزامنة: تنتج أدوات الصوت بالذكاء الاصطناعي صوتًا نظيفًا ومحدد التوقيت يتزامن بدقة شبه مثالية.
أدوات أخرى لمزامنة الشفاه تستحق المقارنة
HeyGen: الدقة مقابل السرعة
تقدم HeyGen نموذجين لمزامنة الشفاه على PicassoIA: Lipsync Precision وLipsync Speed. وكما توحي الأسماء، يعطي Precision الأولوية للجودة، ويعطي Speed الأولوية لسرعة الإنتاج.
نماذج HeyGen ممتازة للمحتوى المؤسسي والتجاري، مع حد أدنى مرتفع للجودة. لكنها تخضع لسياسات محتوى أكثر صرامة، ولا تناسب محتوى أفاتار 18+.
نماذج Sync Labs
يُعد Lipsync 2 وLipsync 2 Pro من Sync Labs أقوى المنافسين في الدقة الفونيمية الخالصة، خاصةً للصوت المعقد الذي يضم عدة متحدثين أو موسيقى. ويتعامل المستوى Pro مع الغناء بشكل أفضل بكثير من Kling v3.
المفاضلة: منتجات Sync Labs لا تدعم محتوى 18+، ولديها متطلبات أكثر صرامة لصور الأفاتار، وهي مصممة أساسًا لصور وجوه واضحة الإضاءة بجودة الاستوديو.
يضيف React 1 من Sync Labs تعابير وجه تفاعلية تتجاوز حركة الشفاه، ما يجعله مثاليًا لمحتوى المونولوج العاطفي. ومرة أخرى، لا يوجد دعم لمحتوى 18+.
Omni Human من ByteDance
يُعد Omni Human 1.5 الأداة الأكثر قدرة لتحريك الجسم بالكامل متزامنًا مع الكلام. وإذا كان استخدامك يتضمن شخصية في حركة، أو تومئ أثناء الكلام، أو تتفاعل جسديًا مع طاقة الصوت، فإن Omni Human هو الخيار الصحيح.
بالنسبة لصنّاع المحتوى البالغين الذين يحتاجون إلى مرونة 18+ مع تحريك الجسم، فإن سير العمل الحالي هو: توليد صورة الأفاتار، وتطبيق Kling Lip Sync لتحريك الوجه، وقبول محدودية الجسم الثابت. لا يوجد حتى الآن نموذج واحد يجمع جودة تحريك الجسم في Omni Human مع دعم 18+.
ما الذي يُقرن به
يعتمد الحصول على مخرجات مزامنة شفاه قوية على البدء بصورة أفاتار جيدة. وهذا هو الجزء الذي يستثمر فيه معظم صنّاع المحتوى وقتًا قليلًا.
توليد صورة الأفاتار المناسبة
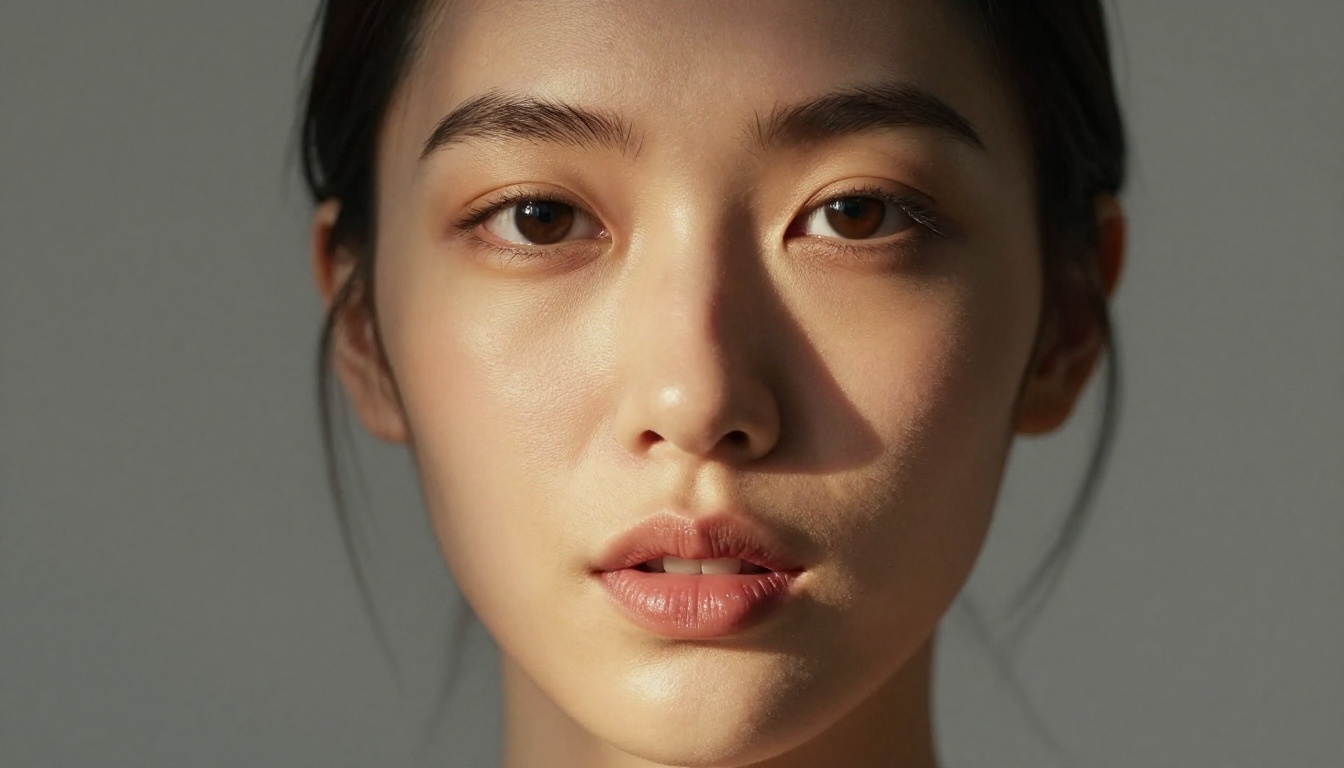
يقدم PicassoIA مجموعة واسعة من أدوات تحويل النص إلى صورة التي تقبل توليد محتوى للبالغين. وبالنسبة لصور الأفاتار المخصصة لمزامنة الشفاه، فإن الأولوية هي توليد بورتريه يتميز بما يلي:
- وجه أمامي أو بزاوية ثلاثية الأرباع خفيفة
- ملمس بشرة واضح ومحدد (غير ناعم بشكل مفرط أو مصقول بالفرشاة الهوائية)
- تعبير محايد إلى خفيف (بدون ابتسامة عريضة تظهر الأسنان)
- إضاءة متساوية أو جانبية الاتجاه
- بدون فلاتر مكياج ثقيلة أو تأثيرات تجميل رقمية
تستحق أداة P Video Avatar الاستكشاف أيضًا لإنشاء فيديوهات مصدر للرأس المتحدث مباشرة، والتي يمكن بعد ذلك توسيعها أو استخدامها كمرجع.
يتناسب نموذج Kling Avatar v2 بشكل طبيعي مع سير عمل مزامنة الشفاه، إذ يولّد مخرجات أفاتار متحركة يمكن أن تكون مقاطع أساسية لمزيد من مزامنة الصوت.
للاطلاع على قائمة كاملة بنماذج تحويل النص إلى صورة وتوليد الأفاتار المتاحة على المنصة، تفضّل بزيارة picassoia.com/en/all-models.
إضافة الصوت باستخدام تحويل النص إلى كلام
أنظف مدخل صوتي لمزامنة شفاه Kling v3 هو الصوت المولّد بالذكاء الاصطناعي. فمخرجات تحويل النص إلى كلام بالذكاء الاصطناعي لها توقيت ثابت، ولا تحتوي على ضوضاء خلفية، ولها إيقاع مضبوط، وكل ذلك يقرؤه كاشف الفونيمات بوضوح.
تتيح خيارات تحويل النص إلى كلام في PicassoIA اختيار ملفات الأصوات، وضبط الإيقاع، والتصدير بجودة جاهزة لمزامنة الشفاه. ويدخل الصوت الناتج مباشرة في سير عمل Kling Lip Sync دون أي معالجة مسبقة.
بالنسبة لمحتوى الأفاتار متعدد اللغات، فإن الجمع بين صوت تحويل النص إلى كلام مع ملفات أصوات لمتحدثين أصليين، إلى جانب مزامنة شفاه Kling v3، ينتج مخرجات يمكن أن تبدو أصيلة لجمهور واسع.
Fabric 1.0 وPixVerse: بدائل أصغر
خياران إضافيان لمزامنة الشفاه يستحق معرفتهما:
يجعل Fabric 1.0 by Veed الصور الثابتة تتحدث، وهو مشابه في الفكرة لوضع الأفاتار في Kling. وجودة مخرجاته أدنى إلى حد ما، لكن سرعة التوليد أعلى، ويتعامل مع صور البورتريه بمتطلبات أقل صرامة.
يقدم PixVerse Lipsync مزامنة سريعة وعالية الجودة للمحتوى القياسي. وتكمن قوته في تكامله مع منظومة فيديو PixVerse، ما يجعله سهلًا إن كنت تستخدم PixVerse بالفعل في أعمال فيديو أخرى.
لا يدعم أي منهما محتوى 18+، لكن كلاهما يستحق الحفظ إن احتجت يومًا إلى مزامنة شفاه أفاتار سريعة وآمنة للعمل (SFW) على نطاق واسع.
وأخيرًا، يمدّ Kling v3 Video وKling v3 Omni Video نفس محرك التوليد إلى فيديو سينمائي أطول، مفيد عندما تريد إنتاج مشهد كامل بدلًا من رأس متحدث واحد.
جرّبه الآن على PicassoIA
تُعد مزامنة شفاه الأفاتار Kling v3 18+ من الأدوات الأكثر قدرة المتاحة لسير عمل صنّاع المحتوى البالغين. فدقة الفونيمات في الإنجليزية والماندرين مثيرة للإعجاب فعلًا، وثبات الهوية عبر المقاطع الطويلة هو الأفضل بين إصدارات Kling حتى الآن، ويزيل المستوى 18+ قيودًا كافية لجعله عمليًا لأنواع المحتوى التي ترفضها منصات أخرى ببساطة.
أسهل مكان لتشغيله هو PicassoIA، الذي يغلّف نموذج Kling Lip Sync في واجهة نظيفة إلى جانب أدوات تحويل النص إلى صورة لتوليد الأفاتار، وتحويل النص إلى كلام لتجهيز الصوت، ومجموعة كاملة من نماذج توليد الفيديو لتوسيع محتواك إلى ما هو أبعد من مقاطع الرأس المتحدث الواحد.
إذا أردت الاطلاع على الكتالوج الكامل لمزامنة الشفاه في المنصة، فتصفّح picassoia.com/en/all-models. بين HeyGen وSync Labs وOmni Human من ByteDance وخياري Veed وPixVerse، يمنحك PicassoIA أوسع مجموعة من أساليب مزامنة الشفاه في مكان واحد، دون تنقّل بين المنصات ودون اشتراكات متفرقة.
ابدأ بصورة أفاتار قوية، واقرنها بصوت نظيف، ومرّرها عبر Kling Lip Sync، وشاهد ما تحصل عليه فعليًا.


