وصل تحويل النص إلى فيديو بالذكاء الاصطناعي إلى مستوى كان سيبدو مستحيلًا قبل ثلاث سنوات. تكتب جملة، فيظهر خلال ثوانٍ فيديو سلس وواقعي يطابق ما وصفته تمامًا، بما في ذلك محتوى كان ممنوعًا على كل منصة كبرى قبل أشهر قليلة. لم تكن الفجوة بين الخيال والنتيجة أصغر من ذلك قط، ولمن يريد إنشاء فيديوهات NSFW بالذكاء الاصطناعي من الأوامر النصية، فإن مجموعة الأدوات الحالية مذهلة فعلًا.
لماذا تغيّر توليد الفيديو بالذكاء الاصطناعي هذا العام
أنتجت الموجة الأولى من نماذج تحويل النص إلى فيديو مقاطع ضبابية ومتقطعة أشبه بعرض شرائح منه بفيديو. كانت الوجوه تتشوه، والأجساد تتحول، والحركة مرتعشة. لم يُبهر أحد.
القفزة النوعية في 2027
تغيّر ذلك بسرعة. نماذج مثل Kling v3 وWAN 2.6 T2V وHailuo 2.3 تولّد الآن مقاطع من 5 إلى 10 ثوانٍ بوجوه واقعية، ومظهر ثابت للشخصيات، وحركة سلسة تصمد إطارًا بعد إطار. أصبحت فيزياء الشعر والماء والقماش تبدو صحيحة أخيرًا.
ما جعل ذلك ممكنًا هو مزيج من:
- مجموعات تدريب أكبر تضم حركة وأوضاعًا متنوعة للجسم
- محولات الانتشار (Diffusion transformers) التي حلّت محل بنى U-Net القديمة
- تقنيات مطابقة التدفق (Flow matching) التي تنتج إطارات أكثر اتساقًا زمنيًا
- رفع الدقة الزمني عالي الدقة لحركة أنعم بين الإطارات
أصبح المحتوى للبالغين متاحًا
في الوقت نفسه، ظهرت فئة جديدة من المنصات تستضيف نماذج دون مرشحات محتوى صارمة. فتح ذلك طريقًا واقعيًا للمبدعين لتوليد فيديو NSFW من وصف نصي فقط، بجودة تنافس الإنتاج الاحترافي وبتكلفة جزء بسيط منه.
ماذا تعني NSFW فعليًا في فيديو الذكاء الاصطناعي
قبل كتابة أي أمر نصي، من المفيد ضبط التوقعات حول ما يستطيع فيديو الذكاء الاصطناعي فعله وما لا يستطيعه في مجال المحتوى للبالغين.
المحتوى الموحي يعطي أفضل النتائج
تتفوق مولدات فيديو الذكاء الاصطناعي في المحتوى الموحي الذي يركز على الجلامور: الملابس الداخلية، وملابس السباحة، والوضعيات المثيرة، والعري الضمني بتأطير راقٍ، والأجواء الحميمة. هذه المشاهد حاضرة بكثرة في بيانات التدريب، لذا تتعامل معها النماذج بثقة واتساق بصري.
الصريح له حدود حقيقية
يظل المحتوى الصريح بالكامل صعبًا تقنيًا على معظم النماذج. ما زال اتساق التشريح عبر الإطارات نقطة ضعف، وغالبًا ما تُضعف التفاعلات المعقدة بين أكثر من شخص الجودة بشكل ملحوظ. قد يبدو الناتج مقنعًا لثانيتين أو ثلاث، ثم ينهار.
💡 نصيحة احترافية: اعمل مع نقاط قوة النموذج. المحتوى الموحي مع سرد بصري قوي يعطي نتائج أفضل بكثير من محاولة الحصول على محتوى صريح ينهار في منتصف المقطع.
سياسات المنصات تختلف
ليست كل منصة تستضيف هذه النماذج تسمح بمخرجات NSFW. كثير منها يطبّق مرشحات محتوى خفية تحجب النتائج للبالغين بصمت. المنصات التي تدعم صراحةً توليد المحتوى للبالغين وتتيح الوصول إلى نماذج غير مقيّدة هي التي تستحق الاستخدام لهذا النوع من العمل.
أفضل النماذج لفيديوهات NSFW بالذكاء الاصطناعي
ليس كل نموذج لتحويل النص إلى فيديو يُنتج محتوى للبالغين بالقوة نفسها. بعضها يملك قدرات NSFW قوية، وبعضها الآخر مُرشّح افتراضيًا. إليك النماذج التي تقدم نتائج تستحق الاستخدام باستمرار.
Kling v3
يُعد Kling v3 حاليًا من أقوى الخيارات للفيديو السينمائي المركّز على الشخصيات. يتعامل بتميز مع ثبات الوجه أثناء الحركة، وهذا أمر بالغ الأهمية في المحتوى NSFW حيث يجب أن تظل سلامة الشخصية قائمة عبر كل إطار. الحركة سلسة، والنموذج يستجيب جيدًا للأوامر التفصيلية حول الملابس والإضاءة وزوايا الكاميرا.
يضيف Kling v3 Omni الإصدار المرافق دعمًا للمدخلات النصية والصورية معًا، ما يتيح لك البدء بصورة ثابتة مولّدة وتحريكها بوصف نصي. يمنحك سير العمل هذا من الصورة إلى الفيديو تحكمًا أكبر بكثير في الشخصية مقارنة بالتوليد النصي الخالص.
WAN 2.6 T2V
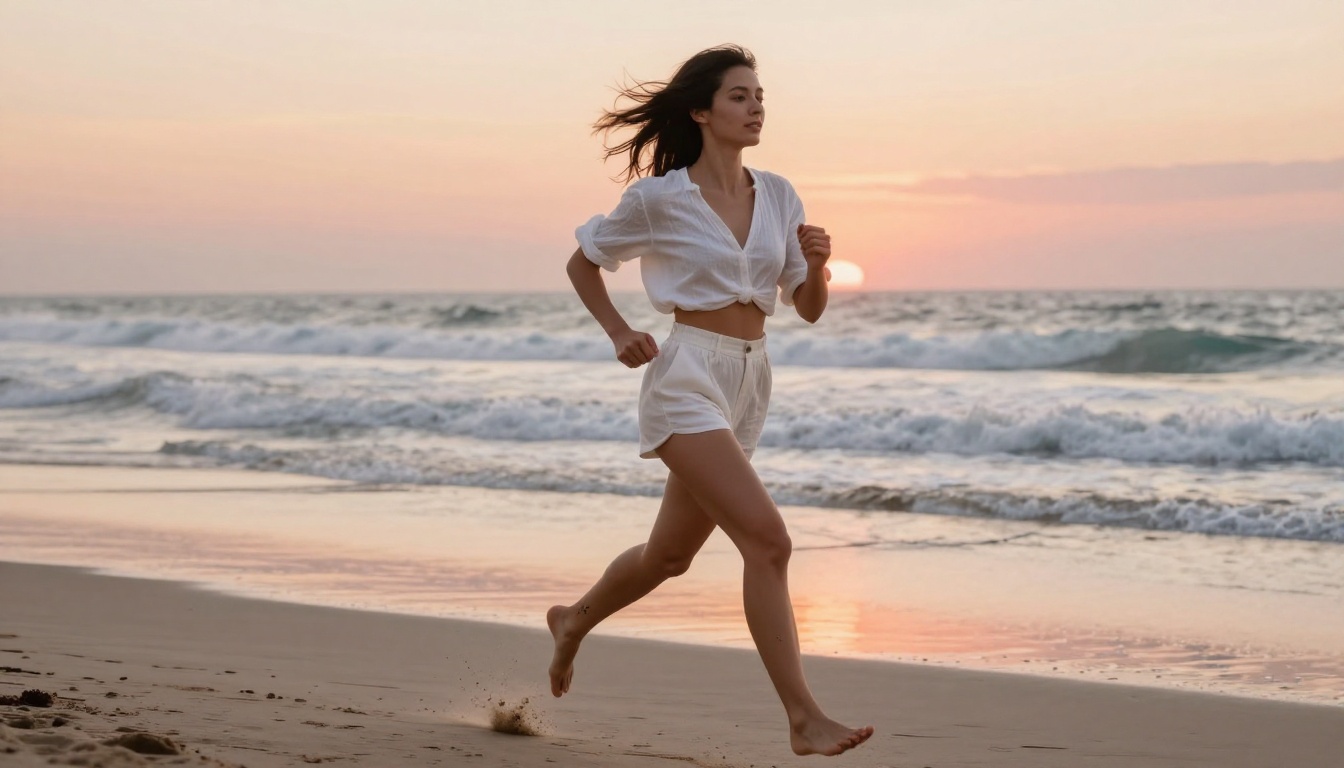
يقدم WAN 2.6 T2V اتساقًا زمنيًا عاليًا وواقعية قوية. يتميز بالحركة القائمة على الفيزياء، بما فيها حركة القماش وديناميكية الشعر والماء. في مشاهد تصوير البودوار أو مشاهد المسبح والشاطئ، يتصدر هذا النموذج فئته.
إذا كنت تحتاج إلى السرعة دون التضحية كثيرًا بالجودة، فإن WAN 2.5 T2V Fast بديل جيد يعالج المقاطع في نحو نصف الوقت بجودة بصرية مقاربة.
Hailuo 2.3
يُعرف Hailuo 2.3 من Minimax بإنتاج بعض أكثر المخرجات ذات الطابع السينمائي توفرًا. يضيف تدرجًا لونيًا سينمائيًا وضبابية حركة طبيعية تلقائيًا، ما يمنح النتائج مظهرًا احترافيًا دون جهد إضافي منك. جودة تصيير الوجوه من بين الأفضل المتاحة في أي نموذج لتحويل النص إلى فيديو.
PixVerse v5.6
يتميز PixVerse v5.6 بحركة الشخصيات المعبّرة. بينما تُنتج بعض النماذج فيديوهات جامدة تبدو مصطنعة، يولّد PixVerse حركة جسدية طبيعية بوزن وزخم معقولين. في المحتوى الذي يتضمن المشي والاستدارة أو الوضعيات الجسدية النشطة، يتفوق غالبًا على المنافسة.
LTX-2.3-Pro
يُعد LTX-2.3-Pro من Lightricks الخيار المناسب عندما تحتاج إلى السرعة والتنوع معًا. يدعم المدخلات النصية والصورية والصوتية، أي أنك تستطيع تحريك صورة ثابتة مع صوت محيطي مصاحب. للمبدعين الذين يبنون مشاهد كاملة بأجواء خاصة، يضيف هذا طبقة لا تقدمها نماذج تحويل النص إلى فيديو الخالصة إطلاقًا.
P-Video
يكمل P-Video القائمة بوصفه الخيار السريع والسهل. زمن التوليد المنخفض يجعله عمليًا للتكرار السريع: شغّل عدة تنويعات للأمر النصي بسرعة، واختر أقوى نتيجة، ثم حسّنها على نموذج متميز باستخدام أمرك الفائز.
مقارنة النماذج في لمحة
| النموذج | نقطة القوة | السرعة | الأفضل لـ |
|---|
| Kling v3 | ثبات الشخصيات | متوسطة | البورتريهات، المشاهد الحميمة |
| WAN 2.6 T2V | الفيزياء، القماش، الماء | متوسطة | الشاطئ، المسبح، الحركة |
| Hailuo 2.3 | الجودة السينمائية | متوسطة | المظهر الفيلمي والاحترافي |
| PixVerse v5.6 | الحركة المعبّرة | سريعة | الوضعيات الديناميكية، المشاهد النشطة |
| LTX-2.3-Pro | مرونة المدخلات المتعددة | سريعة | مشهد كامل مع صوت |
| P-Video | سرعة التكرار | سريعة جدًا | المسودات السريعة، اختبار الأوامر |
كتابة أوامر نصية تعمل
النموذج هو نصف المعادلة فقط. أمر نصي متوسط على نموذج ممتاز سينتج نتائج متوسطة. تتطلب كتابة الأوامر لفيديو الذكاء الاصطناعي تفكيرًا مختلفًا عن توليد الصور، لأنك تصف الحركة والزمن، لا إطارًا ثابتًا فقط.
صغ أمرك النصي بالشكل الصحيح
يتبع أكثر هيكل موثوقية لأمر فيديو NSFW بالذكاء الاصطناعي هذا النمط:
[الشخص + المظهر] + [الحركة أو الوضعية] + [البيئة أو الموقع] + [الإضاءة] + [زاوية الكاميرا والعدسة] + [الأسلوب أو الجو العام]
مثال: "امرأة واثقة في أواخر العشرينات بشعر أسود طويل، ترتدي ملابس داخلية سوداء شفافة، تدير وجهها ببطء نحو الكاميرا، في غرفة نوم فاخرة بإضاءة ناعمة وجدران كريمية، إضاءة كهرمانية دافئة من اليسار، لقطة متوسطة قريبة، عدسة 85 ملم، عمق ميداني سينمائي، بأسلوب Kodak Portra"
هذه الجملة الواحدة تمنح النموذج كل ما يحتاجه لاتخاذ قرارات قوية بشأن الشخصية والحركة والبيئة والإضاءة والكاميرا والأسلوب.
كلمات ترفع الجودة البصرية
هناك مصطلحات تحسّن النتائج باستمرار عبر كل نماذج تحويل النص إلى فيديو:
- Cinematic (سينمائي) يشير إلى إنتاج عالي القيمة في التأطير والتكوين
- عمق الميدان الضحل يفصل الشخص عن الخلفية بشكل جميل
- إضاءة الساعة الذهبية أو إضاءة الحافة الكهرمانية الدافئة تخلق درجات لونية جذابة للبشرة ومُجمِّلة لها
- مراجع عدسة 85 ملم أو 50 ملم تنتج منظورًا أقرب إلى رؤية العين البشرية
- الحركة البطيئة أو الحركة الرشيقة تنتج حركة أنعم وأقل ارتعاشًا
- حبيبات الفيلم تضيف جودة ملموسة شبيهة بالتصوير التقليدي وتزيل مظهر الذكاء الاصطناعي البلاستيكي
- Photorealistic (واقعي كالصور الفوتوغرافية) يوجّه النموذج لإعطاء الأولوية للواقعية على الأسلوبة
3 أشياء تُفسد النتائج
تتكرر هذه الأخطاء باستمرار في مخرجات فيديو الذكاء الاصطناعي منخفضة الجودة:
- أفعال كثيرة في وقت واحد: "تمشي وتستدير وتنظر إلى الخلف وتبتسم" تُرهق النموذج. اختر حركة أساسية واحدة.
- مراجع أسلوب متعارضة: خلط "الطابع الفيلمي القديم" مع "4K رقمي حاد" يُربك التوجيه الأسلوبي للنموذج.
- أوصاف مظهر غامضة: "فتاة جميلة" لا تخبر النموذج بشيء. حدّد لون الشعر والملابس ولون البشرة ووضعية الجسم.
كيفية استخدام Kling v3 على PicassoIA
يُعد Kling v3 النموذج المبدئي الموصى به لمعظم إنشاء فيديوهات NSFW. إليك عملية خطوة بخطوة للحصول على نتائج قوية من جلستك الأولى.
الخطوة 1: افتح النموذج
انتقل إلى صفحة Kling v3 على PicassoIA. تعرض الواجهة حقل الأمر النصي، ومحدد نسبة العرض إلى الارتفاع، وخيارات المدة.
الخطوة 2: اضبط معاملاتك
- نسبة العرض إلى الارتفاع: استخدم 16:9 للمشهد الأفقي السينمائي، و9:16 للتنسيق العمودي للجوال
- المدة: ابدأ بمدة 5 ثوانٍ. المقاطع الأطول تمنح النموذج مساحة للحركة لكنها تزيد زمن التوليد
- الوضع: الوضع القياسي موثوق للتجارب الأولى، بينما يضيف وضع Pro مراحل جودة إضافية للنتائج النهائية
الخطوة 3: اكتب أمرًا نصيًا محددًا
استخدم الهيكل الموضح أعلاه. اجعله في جملتين أو ثلاث كحد أقصى. يعالج Kling v3 الأوامر الطويلة بكفاءة، لكن الجملة الأولى تحمل أكبر وزن في تشكيل الناتج.
الخطوة 4: وَلِّد وقيّم
شغّل أول توليد لك. اسأل: هل مظهر الشخصية صحيح؟ هل الحركة طبيعية؟ هل الإضاءة سليمة؟ حدّد المشكلة الأكبر قبل إعادة كتابة أي شيء.
الخطوة 5: حسّن متغيرًا واحدًا في كل مرة
لا تحاول إصلاح كل شيء في إعادة كتابة واحدة للأمر. غيّر متغيرًا واحدًا في كل مرة. إذا كانت الإضاءة خاطئة، فأضف وصفًا محددًا للإضاءة. إذا كانت الحركة جامدة، فأضف "حركة بطيئة رشيقة" أو "حركة طبيعية سلسة". التحسين التدريجي يتفوق على إعادة الكتابة الشاملة في كل مرة.
💡 نصيحة: احفظ الأوامر التي تعمل. أمر قوي لشخصية واحدة يتكيف بسهولة مع مشهد جديد بتبديل عنصري المكان والحركة فقط، مع الإبقاء على مُعدِّلات الجودة كما هي.
الحصول على نتائج سينمائية
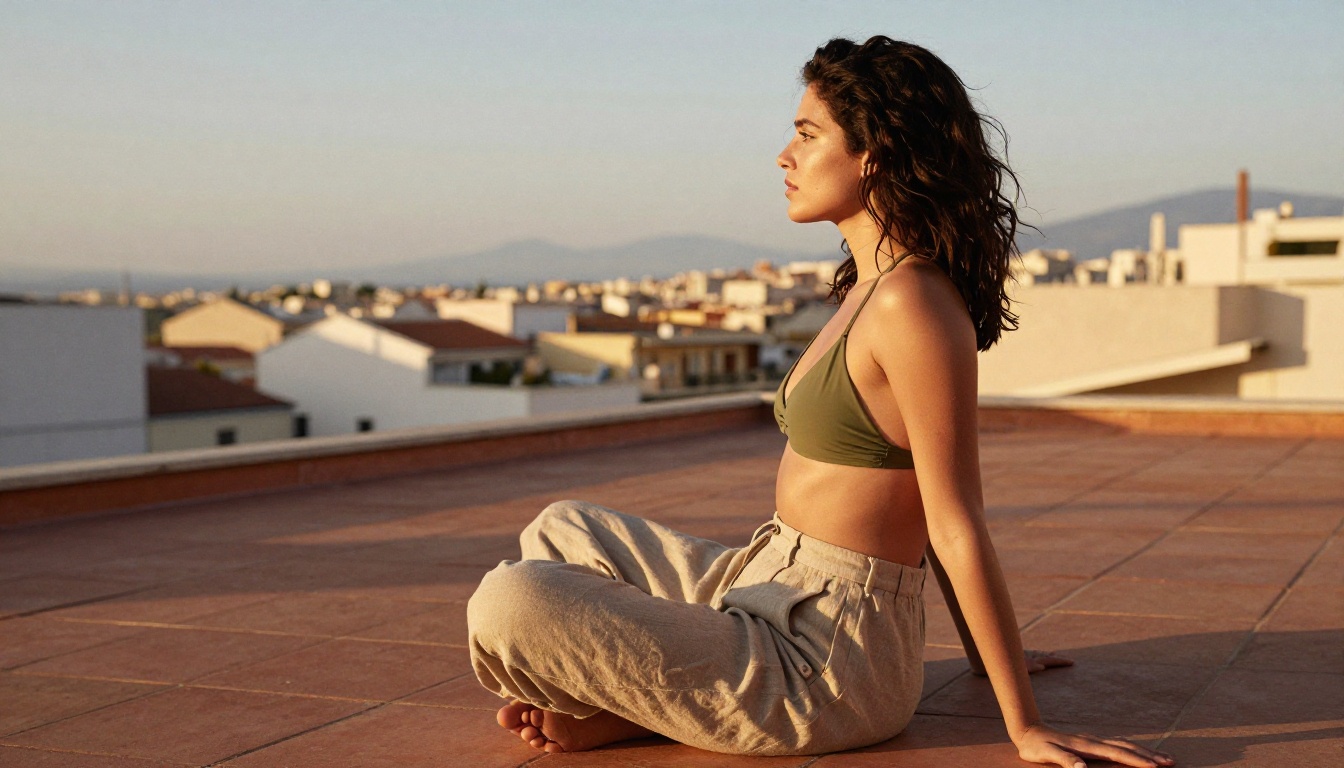
الفرق بين فيديو الذكاء الاصطناعي الذي يبدو هاويًا والمخرجات المبهرة حقًا يعود في الغالب إلى ثلاثة خيارات محددة.
زوايا الكاميرا تشكّل كل شيء
حدّد زاوية الكاميرا بوضوح في كل أمر. "لقطة من زاوية منخفضة تنظر إلى الأعلى" تخلق منظورًا قويًا ودراميًا. "منظر علوي من الأعلى" ينتج طابعًا فنيًا تجريديًا. "لقطة متوسطة بمستوى العين" تبدو محايدة وحميمة. كل زاوية تغيّر النبرة العاطفية للمقطع بأكمله قبل أن تُقرأ كلمة واحدة من وصف الشخص.
الإضاءة تحدد المزاج
الإضاءة المسطحة والمتساوية تنتج فيديو مسطحًا لا يثير الاهتمام. الإضاءة الموجهة من مصدر محدد، مثل نافذة من اليسار أو مصباح خلفي أو غروب من اليمين، تخلق ظلالًا تحدد الشكل وتضيف بعدًا حقيقيًا. المشاهد المضاءة من الخلف تنتج تأثيرات الظل الصوري التي تلفت النظر، وتلمّح بالتفاصيل الصريحة دون أن تعرضها.
الحركة تحتاج إلى قصد
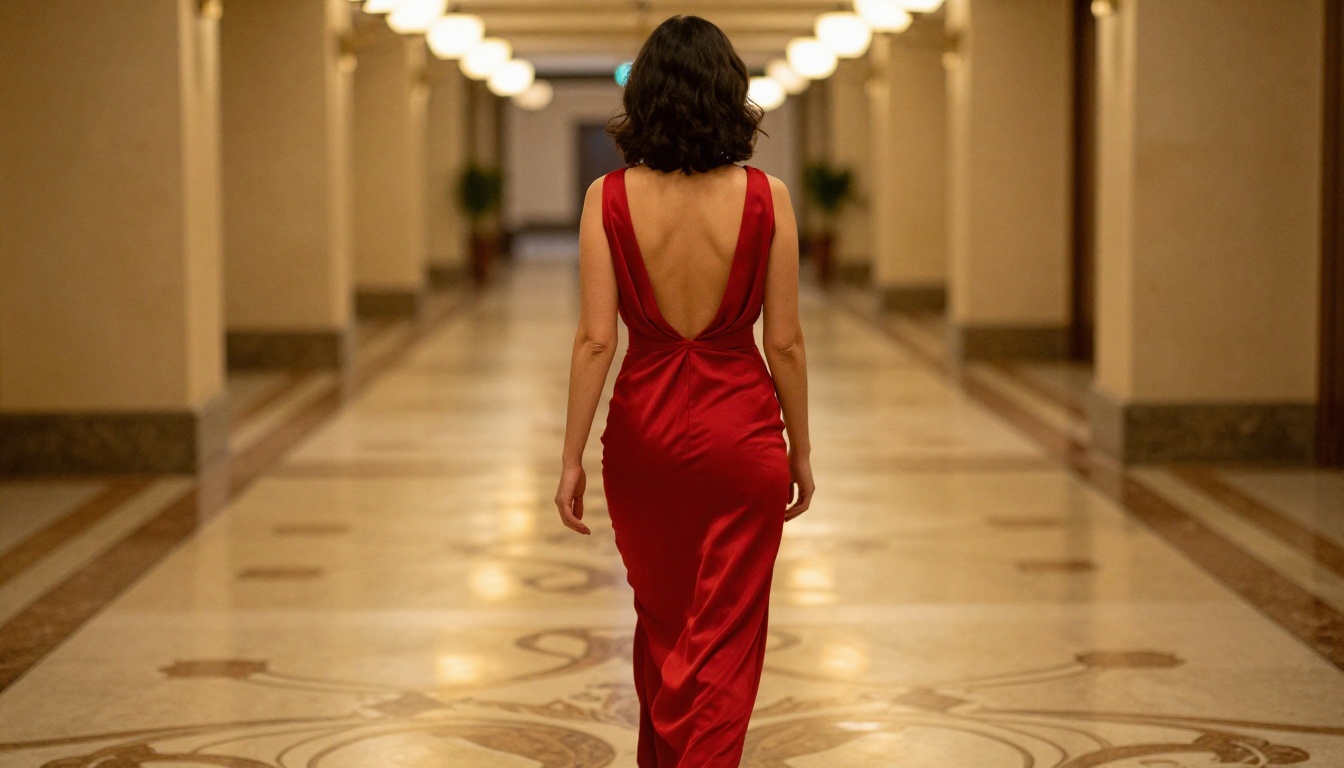
الحركة العشوائية تبدو غير طبيعية وتكشف النموذج. أعطِ حركة الشخص هدفًا واضحًا: "تستدير ببطء نحو الكاميرا"، "تميل إلى الوراء على الوسادة"، "تمشي مبتعدة في ممر طويل". الحركة المقصودة تبدو حقيقية. أما الحركة بلا هدف فتجعل أصل الذكاء الاصطناعي واضحًا.
3 أخطاء تستحق الإصلاح الآن
أوامر قصيرة جدًا
الأمر المكوّن من 10 كلمات ينتج تقريبًا دائمًا مخرجات عامة. يملأ النموذج كل ما لم تحدده بقيمه الافتراضية، وهي نادرًا ما تطابق رؤيتك. الأوامر الأطول والأكثر تحديدًا تنتج نتائج تعكس فعلًا ما كنت تقصده.
نموذج خاطئ للمشهد
WAN 2.6 T2V ممتاز لمشاهد الماء والقماش في الخارج. وKling v3 أفضل لأعمال البورتريه الداخلية. استخدام نموذج يركز على الفيزياء للقطة بورتريه قريبة يهدر نقاط القوة الأساسية لذلك النموذج. طابق النموذج مع نوع المشهد الذي تنشئه.
تجاهل نسبة العرض إلى الارتفاع
يبدو أغلب فيديو NSFW بالذكاء الاصطناعي أفضل بنسبة 16:9 للمحتوى الأفقي السينمائي و9:16 لمحتوى البورتريه العمودي. توليد بورتريه كامل الجسم بنسبة 1:1 يقطع معلومات بصرية مهمة وينتج تكوينات تبدو غير متوازنة بغض النظر عن جودة الأمر.
ما بعد النص: أدوات تحسّن سير عملك
تحويل النص إلى فيديو هو المهارة الأساسية، لكن بعض الأدوات المجاورة تحسّن بشكل كبير الجودة الكلية وثبات مخرجاتك.
تتيح Face Swap AI تبديل الوجوه، أي نقل وجه شخصية مولّدة في مقطع إلى تسلسل جديد مولّد، مع الحفاظ على الهوية البصرية عبر عدة فيديوهات. هذا مفيد بشكل خاص لبناء سلاسل محتوى بشخصيات متكررة.
يحسّن رفع دقة الفيديو بالذكاء الاصطناعي المقاطع المولّدة ويثبتها. معظم نماذج تحويل النص إلى فيديو تُخرج بدقة 480p أو 720p. تمرير المخرجات عبر نموذج للدقة الفائقة يرفعها إلى 1080p مع تفاصيل ووضوح محسّنين. الفرق في الجودة المُدركة كبير.
غالبًا ما يكون تحويل الصورة إلى فيديو أكثر موثوقية من تحويل النص إلى فيديو الخالص في سيناريوهات NSFW المعقدة. ولّد أولًا صورة ثابتة محددة بدقة باستخدام نموذج تحويل النص إلى صورة، ثم استخدم Kling v3 Omni أو WAN 2.6 I2V لتحريكها. تحصل على تحكم دقيق في مظهر الشخصية في الصورة الثابتة، ثم تضيف الحركة في خطوة الفيديو. يتفوق سير العمل من خطوتين هذا باستمرار على التوليد النصي بخطوة واحدة لإنشاء محتوى دقيق للبالغين.
تضيف Lipsync AI كلامًا أو غناءً واقعيًا إلى الشخصيات المولّدة. بالنسبة للمحتوى الذي يتضمن حديثًا مع شخصية مولّدة، تزامن أدوات مزامنة الشفاه حركة الفم مع مسار صوتي تلقائيًا، مضيفةً بعدًا آخر من الواقعية إلى الفيديو النهائي.
أمرك النصي الأول بانتظارك
كل نموذج مذكور في هذه المقالة متاح مباشرة على PicassoIA. يمكنك تشغيل Kling v3 لفيديوهات البورتريه السينمائية، أو WAN 2.6 T2V لمشاهد الخارج كثيفة الفيزياء، أو Hailuo 2.3 لجودة بصرية فيلمية، أو PixVerse v5.6 للحركة المعبّرة للشخصيات، كلها من المنصة نفسها دون تبديل الأدوات.
ابدأ بأمر نصي واحد. شغّله على نموذجين مختلفين. قارن المخرجات جنبًا إلى جنب. ستكوّن بسرعة إحساسًا بالنموذج المناسب لكل نوع من المحتوى، وستصبح أوامرك أدق مع كل تكرار.
النماذج جاهزة، والمنصة جاهزة. الشيء الوحيد الناقص هو أمرك النصي الأول.


