كان جعل صورتك الرمزية تتحدث يتطلب في السابق استوديو تسجيل، ومحرّكًا محترفًا للرسوم المتحركة، وأسبوعًا على الأقل من أعمال ما بعد الإنتاج. لم يعد هذا هو الحال. بفضل تقنية مزامنة الشفاه بالذكاء الاصطناعي، يستطيع أي شخص أن يأخذ صورة واحدة ويحوّلها إلى صورة رمزية متحركة ومتحدثة بالكامل في أقل من دقيقتين، متزامنة مع أي صوت وبأي لغة. يغطي هذا المقال كل ما تحتاج إلى معرفته: كيف تعمل التقنية، وأي النماذج تنتج أكثر النتائج واقعية، وكيف تفعل ذلك خطوة بخطوة على PicassoIA اليوم.
ما الذي تستطيع الصور الرمزية المتحدثة فعله الآن
تلاشت الفجوة بين الصورة الفوتوغرافية ومقطع الفيديو الناطق. تحلل نماذج الذكاء الاصطناعي الحديثة هندسة الوجه، وتتنبأ بحركة الفك الطبيعية، وتُركّب مواضع اللسان والأسنان بواقعية، وتمزج كل ذلك بسلاسة مع إضاءة الصورة الأصلية وملمسها. والنتيجة فيديو يبدو فيه شخصك الرمزي كأنه قال تلك الكلمات فعلًا، لا دمية بفم يتحرك.
من صورة ثابتة إلى متحدث متحرك
العملية الأساسية بسيطة في ظاهرها: توفّر صورة واحدة لوجه وملفًا صوتيًا واحدًا، ويتولى الذكاء الاصطناعي الباقي. يقرأ النموذج الفونيمات في الصوت، ويربطها بأشكال الفم المقابلة، ويستكمل الانتقالات الطبيعية بين كل شكل وآخر، ثم يصيّر الفيديو النهائي إطارًا تلو الآخر. كما تأخذ النماذج عالية الجودة مثل Omni Human 1.5 من ByteDance في الحسبان الحركات الدقيقة للرأس ورفّة العين، فينتج عنها مخرجات تبدو حيّة فعلًا.
من يستخدم هذه التقنية فعليًا
- صنّاع المحتوى الذين ينتجون قنوات YouTube بلا وجوه أو مقاطع قصيرة بتعليق صوتي دون الظهور أمام الكاميرا
- الشركات التي تبني صورًا رمزية تعمل بالذكاء الاصطناعي لخدمة العملاء أو فيديوهات التعريف بالموظفين الجدد
- المعلّمون الذين يحوّلون الدروس المكتوبة إلى شروحات منطوقة بشخصية بصرية ثابتة
- المطوّرون الذين يُجرّبون رفقاء أو شخصيات غير لاعبة بالذكاء الاصطناعي تتحدث بكلام واقعي
- فرق التسويق التي تنتج نسخًا إعلانية متعددة اللغات عبر تركيب صوت فيديو واحد بلغات متعددة مع مزامنة الشفاه
تكفي ميزة السرعة وحدها لتبرير التحول. يتطلب فيديو الشخص المتحدث التقليدي جدولة وإضاءة وإعادة تصوير ومونتاجًا. أما الصورة الرمزية المتحدثة بالذكاء الاصطناعي فتحتاج إلى صورة جيدة ونص.
النماذج التي تقف وراء هذه التقنية
ليست كل نماذج مزامنة الشفاه متساوية. لكل منها نقاط قوة مختلفة بحسب حالة استخدامك، ومادتك الأصلية، ومستوى الواقعية الذي تحتاجه. فيما يلي استعراض لأبرز النماذج المتاحة على PicassoIA.
Omni Human 1.5 من ByteDance
يُعد Omni Human 1.5 من أكثر نماذج تحويل الصورة إلى فيديو متحدث تطورًا المتاحة. يقبل صورة شخصية واحدة ومقطعًا صوتيًا، ثم يولّد فيديو يبدو فيه الشخص يتحدث بشكل طبيعي. ما يميّز هذا النموذج هو تعامله مع تغيّر وضعية الرأس وحركة الجسم. فمعظم أدوات مزامنة الشفاه تنتج وجهًا جامدًا يكاد لا يتحرك. أما Omni Human 1.5 فيضيف تمايلًا طبيعيًا خفيفًا، وإيقاعًا للتنفس، وتعابير دقيقة تجعل النتيجة تبدو كأنها لقطات لشخص حقيقي.
💡 الأفضل في: الصور الرمزية المتحدثة الواقعية لشخص واحد انطلاقًا من صور شخصية، خاصة عندما تريد أن تبدو النتيجة كأنها لقطات فيديو حقيقية.
P Video Avatar من PrunaAI
صُمّم P Video Avatar لإنتاج فيديوهات صور رمزية متحدثة مصقولة بكفاءة عالية. وهو مُحسَّن لإخراج نظيف من الصور الأمامية، ويعمل جيدًا عندما تكون الصورة الأصلية ذات إضاءة جيدة وتعبير محايد. وللمبدعين الذين يحتاجون إلى إنجاز سريع دون التضحية بالجودة، يُعد هذا خيارًا أول موثوقًا.
💡 الأفضل لـ: فيديوهات الصور الرمزية السريعة والمصقولة لوسائل التواصل الاجتماعي والعروض التقديمية وإنتاج المحتوى السريع.
Fabric 1.0 من Veed
يتبنى Fabric 1.0 نهجًا مختلفًا، إذ يركّز على جعل أي صورة تتحدث بأقل قدر من العوائق. صُممت واجهته لتكون سهلة الاستخدام، ويتعامل النموذج مع مجموعة واسعة من أنواع الصور، بما في ذلك الزوايا غير الأمامية وظروف الإضاءة المتنوعة. وإذا لم تكن صورتك بجودة استوديو، فإن Fabric 1.0 يميل إلى التسامح أكثر من النماذج التي تشترط مدخلات مثالية.
💡 الأفضل لـ: صنّاع المحتوى الذين يعملون بصور أصلية غير مثالية أو بزوايا بورتريه غير اعتيادية.
Lipsync 2 Pro من Sync
صُمم Lipsync 2 Pro خصيصًا لمزامنة الشفاه مع الصوت بدقة عالية على مدخلات الفيديو. فبينما تبدأ نماذج أخرى من صورة، يأخذ Lipsync 2 Pro فيديو موجودًا ويستبدل حركات الشفاه أو يصححها لتتطابق مع مسار صوتي جديد. وهذا يجعله مثاليًا لتركيب الأصوات واستبدال الحوار الصوتي والتصحيحات في مرحلة ما بعد الإنتاج. ويقدّم الإصدار القياسي Lipsync 2 إمكانات مماثلة بدقة أقل قليلًا، وهو مفيد عندما تكون السرعة أهم من الكمال.
💡 الأفضل لـ: تركيب الأصوات على فيديوهات موجودة، أو استبدال الحوار الصوتي، أو تصحيح مزامنة الشفاه في مرحلة ما بعد الإنتاج.
Kling Lip Sync من Kwaivgi
يركّز Kling Lip Sync على مطابقة حركات الفم مع الصوت عبر أنواع متعددة من الفيديوهات. وهو قوي مع اللقطات التي تتضمن حركة طبيعية للرأس، وفعّال بشكل خاص عندما يحتوي الفيديو الأصلي على محتوى ديناميكي بدلًا من شخص متحدث ثابت. وإذا كنت تعمل على لقطات حركة أو محتوى لا يكون فيه الشخص ساكنًا تمامًا، فإن Kling يتعامل مع هذا التعقيد بشكل أفضل من النماذج المدرّبة حصريًا على صور ثابتة.
💡 الأفضل لـ: محتوى الفيديو الديناميكي ذي الحركة الطبيعية حيث تعاني أدوات مزامنة الشفاه الثابتة.
كيف تعمل مزامنة الشفاه بالذكاء الاصطناعي فعليًا
فهم الآليات الكامنة وراء الصور الرمزية المتحدثة بالذكاء الاصطناعي يساعدك على اتخاذ قرارات أفضل بشأن النموذج الذي تستخدمه وكيفية تجهيز مادتك الأصلية.
ربط الفونيمات بالصوت
تتكون كل كلمة منطوقة من فونيمات، وهي أصغر وحدات الصوت. عندما تقول "hello"، يمرّ فمك بأشكال مميزة للحرف "h" وللصوت "eh" وللحرف "l" وللصوت "oh". تُدرَّب نماذج مزامنة الشفاه بالذكاء الاصطناعي على مجموعات بيانات ضخمة من لقطات صوت وفيديو متزامنين، فتتعلم بدقة أي تكوين للوجه يقابل كل فونيم. وعند تشغيل النموذج، يحلل ملف الصوت، ويستخلص تسلسل الفونيمات، ويولّد أشكال الفم المقابلة إطارًا تلو الآخر.
ما يفصل النتيجة المقنعة عن النتيجة الآلية هو دقة هذا الربط. تنتج النماذج الأدنى جودة حركات فم متقطعة ومبالغًا فيها تبدو آلية. أما النماذج عالية الجودة مثل Omni Human 1.5 فتنتج انتقالات سلسة وطبيعية بين الأشكال، تطابق الطريقة التي يتدفق بها الكلام البشري الحقيقي.
مزامنة التعابير والمشاعر
تتجاوز أفضل نماذج مزامنة الشفاه بالذكاء الاصطناعي الفم. فالكلام الطبيعي يشمل الوجه بأكمله: حركة الحاجبين، وشدّ عضلات الخد، وتوتر الفك الخفيف، والرمشة العرضية المتزامنة مع الوقفات. صُممت نماذج مثل React 1 من Sync خصيصًا لإضافة حركات تفاعلية للوجه إلى جانب مزامنة الشفاه، فينتج عنها مخرجات يستجيب فيها الوجه كله ديناميكيًا للصوت، بدلًا من تحريك الشفاه فقط أمام تعبير مجمّد.
اللغات والقدرة متعددة اللغات
من أقوى تطبيقات مزامنة الشفاه بالذكاء الاصطناعي التركيب الصوتي متعدد اللغات. فنماذج مثل Lipsync Precision و Lipsync Speed من HeyGen مُحسَّنة خصيصًا لسير عمل التركيب الصوتي، حيث يحتاج فيديو أصلي بلغة ما إلى إعادة مزامنة شفاهه مع مسار صوتي مترجم. ويذهب Video Translate إلى أبعد من ذلك، إذ يدعم أكثر من 150 لغة مع ترجمة تلقائية ومزامنة للشفاه تُطبَّق في الوقت نفسه.
يتيح هذا توزيع المحتوى عالميًا دون الحاجة إلى مسارات تركيب صوتي بشرية مكلفة.
كيف تجعل صورتك الرمزية تتحدث على PicassoIA
يضم PicassoIA فئة مخصصة كاملة لمزامنة الشفاه تضم 12 نموذجًا، كل منها مضبوط لسيناريوهات مختلفة. فيما يلي خطوات إنشاء أول صورة رمزية متحدثة لك باستخدام Omni Human 1.5.
الخطوة 1: جهّز صورتك
تؤثر الصورة الأصلية تأثيرًا كبيرًا في جودة المخرجات. اتبع هذه الإرشادات:
| المتطلب | التفاصيل |
|---|
| الدقة | 512x512 بكسل على الأقل، ويفضّل 1024x1024 أو أعلى |
| الكادرة | يجب أن يشغل الوجه بين 40% و70% من الإطار |
| الزاوية | أمامية أو قريبة من الأمامية، ويفضّل أن تكون ضمن 30 درجة من الاستقامة المباشرة |
| الإضاءة | متجانسة، دون ظلال كثيفة على الوجه |
| التعبير | محايد أو ابتسامة خفيفة، والفم مغلق أو مفتوح قليلًا |
| الخلفية | نظيفة أو بسيطة، وغير مزدحمة |
الصورة المجهّزة جيدًا تنتج نتائج أفضل بكثير من صورة ذات إضاءة سيئة أو دقة منخفضة أو قصّ مفرط.
الخطوة 2: جهّز الصوت
لديك خياران لإدخال الصوت:
- سجّل صوتك بنفسك: استخدم أي تطبيق تسجيل على هاتفك أو حاسوبك. تكفي غرفة هادئة، ولا حاجة إلى ميكروفون احترافي.
- استخدم تحويل النص إلى كلام: يضم PicassoIA فئة Text to Speech تضم نماذج متعددة لتوليد الأصوات. اكتب نصك، وولّد الصوت، واستخدمه كمدخل لمزامنة الشفاه.
للحصول على أنظف النتائج، يجب أن يكون الصوت خاليًا قدر الإمكان من ضوضاء الخلفية، وبإيقاع واضح (ليس سريعًا جدًا)، مع وقفات طبيعية بين الجمل.
الخطوة 3: افتح Omni Human 1.5
انتقل إلى Omni Human 1.5 على PicassoIA. تطلب الواجهة مدخلين:
- الصورة: ارفع صورتك الشخصية المجهّزة
- الصوت: ارفع ملفك الصوتي (MP3 أو WAV)
تتيح بعض الإصدارات أيضًا ضبط مدة المخرجات ودقة الفيديو. اضبطها بحسب المنصة المستهدفة: 1080p لمنصة YouTube أو للاستخدام الاحترافي، و720p للإنجاز السريع على وسائل التواصل الاجتماعي.
الخطوة 4: ولّد وراجع
اضغط على توليد. تستغرق المعالجة عادةً من 30 إلى 90 ثانية بحسب طول الصوت وحمل الخادم. عند ظهور المخرجات، راجعها بعناية:
- دقة مزامنة الشفاه: هل تتطابق الشفاه مع الصوت بدقة؟ انتبه إلى الحروف الساكنة وأصوات العلل.
- الحركة الطبيعية: هل يتحرك الرأس قليلًا؟ هل هناك رمشات؟ التعبير الجامد والمجمّد يدل على أن النموذج واجه صعوبة مع مدخلاتك.
- عيوب الحواف: تحقّق من حدود الفم بحثًا عن تمويه أو تلطيخ أو عدم تجانس في الألوان.
إذا كانت النتيجة تحتوي على مشكلات، فجرّب هذه التعديلات:
الخطوة 5: صدّر واستخدم
نزّل فيديو المخرجات مباشرة من PicassoIA. الملف جاهز للاستخدام في أي محرر فيديو، أو للرفع المباشر على منصات التواصل الاجتماعي، أو لتضمينه في موقع إلكتروني. لا توجد علامات مائية، ولا حاجة إلى تحويل الصيغة.
اختيار النموذج المناسب لحالتك
مع وجود 12 نموذجًا في فئة مزامنة الشفاه وحدها، قد يبدو الاختيار مربكًا. يربط هذا الجدول حالات الاستخدام الشائعة بالنموذج الأنسب لها.
نصائح لتحسين المخرجات
هذه هي العوامل الفعلية التي تفصل بين صورة رمزية متحدثة مقنعة وتزييف واضح.
جودة الصورة هي العامل الأكبر
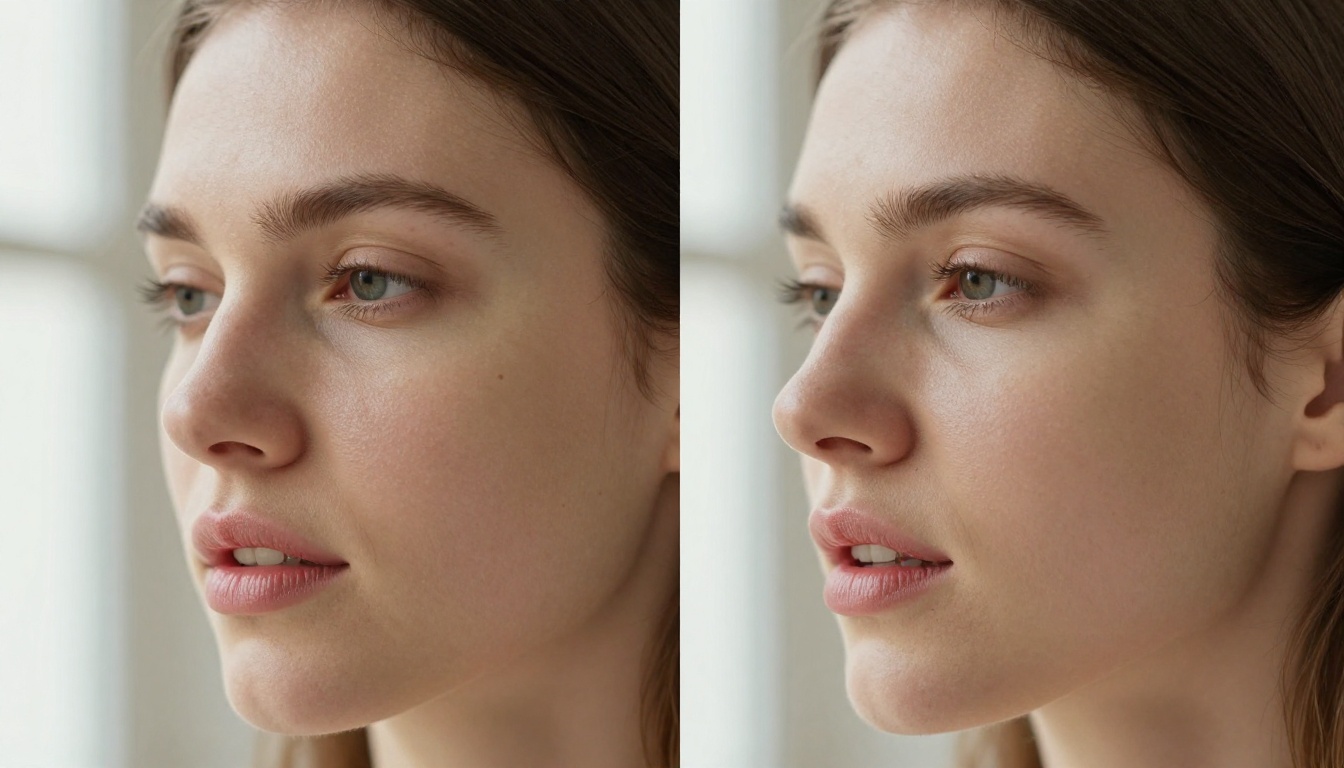
نماذج مزامنة الشفاه بالذكاء الاصطناعي لا تكون أفضل مما تتلقاه من بيانات. فالصورة الضبابية أو منخفضة الدقة ستنتج حركة شفاه ضبابية وغير متسقة. أما البورتريه الحاد الجيد الإضاءة فيمنح النموذج معالم وجه واضحة يعمل عليها، فتكون النتيجة مزامنة دقيقة ومحكمة للشفاه مع حواف نظيفة.
إذا لم تكن لديك صورة جيدة للوجه الذي تريد تحريكه، ففكّر في استخدام أدوات توليد الصور في PicassoIA لإنشاء بورتريه عالي الجودة أولًا، ثم حرّكه.
إيقاع الصوت ووضوحه
يصعب على نماذج مزامنة الشفاه التعامل بدقة مع الكلام السريع المتتابع ذي الوقفات القليلة. سجّل الصوت أو ولّده بإيقاع طبيعي وواضح. لا حاجة إلى نطق مبالغ فيه، لكن الحروف الساكنة الواضحة تساعد النموذج على تحديد حدود الفونيمات بشكل صحيح.
تجنّب الصوت المصحوب بصدى أو ارتداد قوي. فالتسجيل الجاف القريب من الميكروفون سينتج دائمًا مزامنة أفضل من تسجيل في غرفة ذات صدى.
طابِق الصورة مع الصوت
يبدو هذا واضحًا، لكنه يهم كثيرًا. فصورة لامرأة شابة مقرونة بصوت رجالي عميق يخلق تنافرًا معرفيًا بغض النظر عن دقة مزامنة الشفاه. وعند بناء شخصية رمزية متسقة، تأكد من أن الهوية البصرية تتطابق مع هوية الصوت. تقدم نماذج تحويل النص إلى كلام في PicassoIA مجموعة واسعة من الأصوات للاختيار منها، مما يسهّل العثور على صوت يناسب الصورة الرمزية التي اخترتها.
كرّر بسرعة
لا تقضِ ساعات في تحسين مدخلاتك قبل تشغيل أول توليد. شغّل اختبارًا سريعًا بالصورة والصوت المبدئيين، وراقب ما ينتجه النموذج، ثم عدّل بناءً على ما لاحظته، وولّد من جديد. عادةً ما تصل مرتين أو ثلاث مرات إلى نتيجة بجودة الإنتاج، وهذا أسرع من محاولة تجهيز مدخلات مثالية منذ البداية.
ماذا يمكنك أن تبني بهذه التقنية
تمتد تطبيقات الصور الرمزية المتحدثة بالذكاء الاصطناعي إلى ما هو أبعد بكثير من بناء العلامة الشخصية.
قنوات المحتوى بلا وجوه
بعض قنوات YouTube الأسرع نموًا لا تُظهر وجه صانعها الحقيقي أبدًا. تتيح الصور الرمزية المتحدثة بالذكاء الاصطناعي الحفاظ على شخصية ثابتة على الشاشة بمظهر واقعي كالصور الفوتوغرافية وصوت متطابق، دون الظهور أمام الكاميرا بنفسك. تكتب النص، وتولّد فيديو الصورة الرمزية، وتحرر المقاطع معًا، ثم تنشر.
التسويق المحلي على نطاق واسع
يمكن تركيب فيديو تسويقي واحد بعشر لغات باستخدام Video Translate مع ضبط مزامنة الشفاه لكل لغة. ما كان سيتطلب 10 تصويرات منفصلة أو ممثلين صوتيين بشريين مكلفين يصبح سير عمل يستغرق ساعات لا أسابيع.
رفقاء الذكاء الاصطناعي التفاعليون
يستطيع المطوّرون الذين يبنون تطبيقات تعمل بالذكاء الاصطناعي استخدام نماذج مزامنة الشفاه لمنح شخصياتهم الذكية حضورًا بصريًا واقعيًا. فبدلًا من صورة رمزية ثابتة، يرى المستخدمون شخصية تتحدث فعلًا بردودها. وعند دمجها مع نموذج لغوي كبير لتوليد الردود ونموذج تحويل النص إلى كلام للصوت، يقدّم المسار الكامل ذكاءً اصطناعيًا حواريًا مقنعًا بوجه بشري.
التعليم الإلكتروني والتدريب المؤسسي
يستطيع المدرّبون وفرق التطوير والتدريب إنشاء دروس مرئية عبر تحريك صورة رمزية ثابتة للمدرّب. يمكن للشخصية نفسها أن تقدّم كل درس في الدورة، فتحافظ على الاستمرارية البصرية دون أن يضطر المدرّب إلى تسجيل فيديو لكل وحدة. صورة شخصية واحدة مُعدّة جيدًا يمكن أن تكون أساس منهج دراسي كامل.
جرّبها بنفسك
الطريقة الوحيدة لتقدير ما تنتجه مزامنة الشفاه بالذكاء الاصطناعي حق قدره هي رؤية نتيجة بصورتك وصوتك الخاصين. فئة مزامنة الشفاه على PicassoIA جاهزة الآن، وتضم نماذج تتراوح من معاينات سريعة للمسودات إلى مخرجات بجودة سينمائية.
ابدأ باستخدام Omni Human 1.5 لمحاولتك الأولى. استخدم صورة بورتريه واضحة، ومقطعًا صوتيًا قصيرًا (30 ثانية تكفي للاختبار)، وشاهد ما يعيده النموذج خلال أقل من دقيقتين. ومن هناك، يمكنك تجربة مجموعة النماذج كاملة، من Fabric 1.0 للصور الأصلية الصعبة إلى Video Translate للحملات متعددة اللغات.
لم يكن إنشاء صورة رمزية متحدثة بالذكاء الاصطناعي أسهل من ذلك قط. صورة واحدة وبضع ثوانٍ من الصوت تكفيان. اختر صورتك الرمزية، وسجّل صوتك، ودع الذكاء الاصطناعي يتولى الباقي.


