إذا قضيت أي وقت في أوساط إنشاء محتوى البالغين مؤخرًا، فمن المرجح أنك سمعت عن Seedance 2.0. نموذج ByteDance الأحدث لتحويل النص والصورة إلى فيديو يعد بشيء مهم جدًا في هذا المجال: حركة بشرية واقعية، وتصيير مفصّل للبشرة، ودعم للصوت الأصلي ضمن مسار توليد واحد. لكن هل يصمد فعلًا عندما تدفعه نحو نوع المحتوى الذي يحتاجه مبدعو البالغين؟ هذا بالضبط ما تتناوله هذه المقالة، بلا مبالغة وبلا حشو. إليك الوضع الصادق كما هو.
ما هو Seedance 2.0 فعلًا
Seedance 2.0 نموذج لتحويل النص إلى فيديو وتحويل الصورة إلى فيديو، أطلقته ByteDance، الشركة التي تقف وراء TikTok. يتنافس في مجال مزدحم مع نماذج مثل Kling v3 وWan 2.6 I2V، لكنه يأتي بخيارات تصميمية تميّزه للمبدعين الذين يعملون على محتوى حسّي أو جلامور أو محتوى قريب من البالغين.
بنية ByteDance
يعمل النموذج على بنية الانتشار الخاصة بشركة ByteDance، ودُرّب على أحجام ضخمة من بيانات الفيديو. عمليًا، هذا يعني أنه رأى الكثير من الحركة البشرية على مسافات مختلفة، وفي ظروف إضاءة متنوعة، وبأنواع أجسام متعددة. توزيع التدريب أوسع من كثير من البدائل مفتوحة المصدر، وهذا يترجم إلى مخرجات أقرب إلى الطبيعة عندما يتضمن الأمر أشخاصًا.
يدعم النموذج توليد تحويل النص إلى فيديو وتحويل الصورة إلى فيديو. وضع تحويل الصورة إلى فيديو هو المكان الذي سيقضي فيه معظم مبدعي البالغين وقتهم، لأنه يتيح لك البدء من مرجع شخصية محددة، وهذا ضروري عندما تحتاج إلى الاتساق عبر سلسلة من المحتوى.
الصوت الأصلي، ميزة فارقة حقيقية
من الأشياء التي يملكها Seedance 2.0 وتفتقر إليها معظم المنافسات توليد الصوت الأصلي المدمج مباشرة في المسار. هذه ليست ميزة مضافة لاحقًا. يولّد النموذج أصواتًا محيطة وضوضاء خلفية ونسيجًا صوتيًا خفيفًا متزامنًا مع المخرجات المرئية. بالنسبة إلى المبدعين الذين ينتجون مقاطع قصيرة لمنصات تدعم الصوت، هذا يلغي خطوة ما بعد الإنتاج بالكامل.
أين يصبح مبهرًا
ليس كل شيء في Seedance 2.0 تنازلات. هناك مجالات يتفوق فيها هذا النموذج فعلًا على المنافسة في حالات الاستخدام التي يهتم بها مبدعو البالغين أكثر من غيرها.
تصيير البشرة جيد فعلًا
هذه أكبر نقطة قوة فيه. لا تبدو البشرة في مخرجات Seedance 2.0 بلاستيكية أو خالية من المسام كما تبدو في كثير من أدوات الفيديو بالذكاء الاصطناعي. تحصل على ملمس مسامي مرئي، وتأثيرات تشتت ضوئي تحت السطح طبيعية، واستجابة واقعية لتغيّرات الإضاءة. عندما تتحرك الكاميرا الافتراضية، لا تنتقل البشرة فجأة إلى منطقة وادي الغرابة كما يحدث في نماذج التوليد الأقدم.
💡 ملاحظة: تكون جودة البشرة في أفضل حالاتها في اللقطات المتوسطة والمقرّبة. في اللقطات المقرّبة جدًا التي يملأ فيها الوجه الإطار بالكامل، قد تظهر أنماط ملمس ناتجة عن الهلوسة تبدو غير واقعية عند الفحص الدقيق.
يمتد التفصيل إلى القماش أيضًا. سطح الساتان يعكس الضوء بطريقة مختلفة عن القطن، و Seedance 2.0 يحترم هذا الفرق. بالنسبة إلى المبدعين الذين ينتجون محتوى جلامور أو محتوى قريبًا من الملابس الداخلية، هذا مهم لأنه يمنع المخرجات النهائية من أن تبدو كمشهد قصصي من لعبة فيديو.
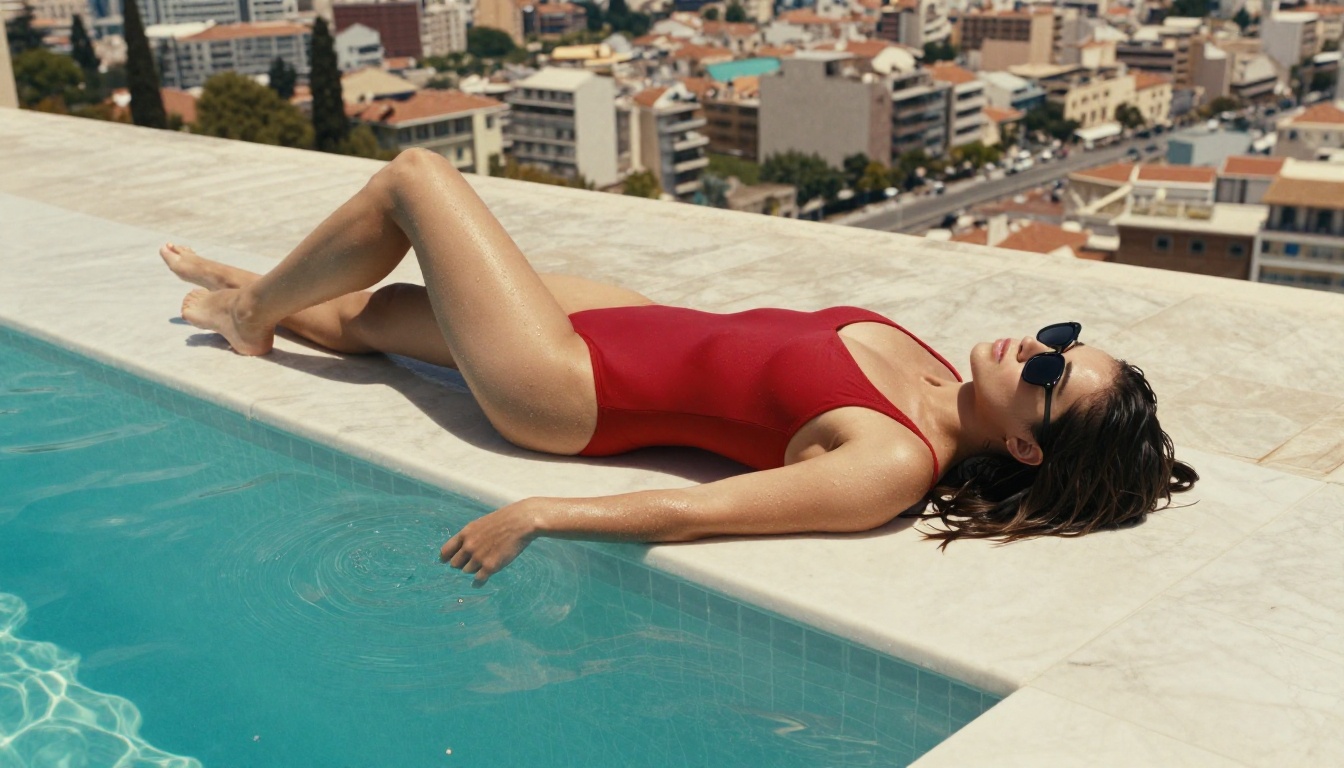
الحركة تتدفق كأنها لقطات حقيقية
الحركة البشرية من أصعب الأشياء على نماذج الفيديو بالذكاء الاصطناعي. المشي، وخصلات الشعر في الريح، وانسدال القماش أثناء الحركة، والطريقة التي ينقل بها الجسم وزنه من ورك إلى آخر. يتعامل Seedance 2.0 مع الحركة البطيئة والمتوسطة السرعة بإتقان. الشخص الذي يمشي نحو الكاميرا أو يدور أو يغيّر وضعه يبدو عادةً سلسًا فعلًا بدلًا من أن يبدو متقطعًا.
هذا تحسن كبير مقارنة مع Seedance 1.5 Pro، الذي كانت تظهر فيه آثار واضحة لاستيفاء الإطارات أثناء حركة الجذع. يتمتع الإصدار 2.0 بتحسن ملحوظ في توقع الحركة بين الإطارات.
| نوع الحركة | Seedance 2.0 | Seedance 1.5 Pro |
|---|
| المشي البطيء | ممتاز | جيد |
| حركة الشعر | جيد جدًا | متوسط |
| دوران الجسم | جيد | مقبول |
| الإيماءات السريعة | متوسط | ضعيف |
| التفاعل باليدين | مقبول | ضعيف |
الاستجابة للأوامر النصية
عندما تصف سيناريو محددًا، يتبعه Seedance 2.0 بدقة أعلى من معظم نماذج الفيديو في هذه الفئة. إذا كتبت "سحب بطيء للكاميرا إلى الخلف يكشف امرأة ترتدي بيكيني أبيض على حافة مسبح، ضوء شمس بعد الظهر"، فغالبًا ستحصل على شيء يطابق هذا المشهد فعلًا بدلًا من شخص عام في محيط عام.
يعود ذلك جزئيًا إلى أن النموذج يملك استدلالًا مكانيًا أفضل مدمجًا فيه. إنه يفسّر مصطلحات حركة الكاميرا والمفاهيم التكوينية كتعليمات فعلية وليس كأوصاف زخرفية.
القيود الصريحة
لا ينبغي لأي مراجعة لنموذج أن تتجاوز الأجزاء التي لا تعمل. لدى Seedance 2.0 قيود حقيقية تؤثر في فائدته في الإنتاج.
ثبات الشخصيات يتراجع
هذه أكبر مشكلة لمبدعي البالغين الذين يعملون مع شخصية متكررة أو مع شبه شخص بعينه. Seedance 2.0 ليس قويًا بشكل خاص في الحفاظ على ملامح وجه ثابتة عبر عدة مقاطع. إذا ولّدت سلسلة من الفيديوهات، فقد يتغير وجه الشخصية بشكل خفيف بين التوليدات، وهذا يجعل إنتاج محتوى متماسك في سلسلة أصعب.
الحل البديل الذي يستخدمه معظم المبدعين هو الجمع بين توليد الفيديو وسير عمل قوي لتوليد الصور. تولّد إطارات مرجعية متسقة أولًا، ثم تغذّي بها وضع تحويل الصورة إلى فيديو. هذا يقلل الانجراف، لكنه لا يلغيه تمامًا.
💡 نصيحة: استخدم دائمًا وضع تحويل الصورة إلى فيديو بدلًا من تحويل النص إلى فيديو عندما يكون ثبات الشخصية مهمًا. البدء من إطار مرجعي ثابت يقلل بشكل كبير من انجراف الوجه بين التوليدات.
اليدان والوجوه تحت الضغط
تظهر مشكلة الذكاء الاصطناعي الكلاسيكية في Seedance 2.0 أيضًا. قد تسبب الأيدي أثناء الحركة، خاصة عندما تتفاعل مع أشياء أو مع أجزاء أخرى من الجسم، أخطاء تشريحية. تندمج الأصابع، أو تنثني عند مفاصل خاطئة، أو تختفي للحظة. يكون هذا أوضح في المقاطع التي تكون فيها الأيدي في المقدمة، أو عندما يتضمن الأمر أفعالًا محددة لليدين.
الوجوه أفضل من الأيدي، لكنها ليست محصّنة. التعابير عالية الانفعال، وزوايا المنظر الجانبي الحادة، واللقطات المقرّبة جدًا للوجه أثناء الحركة، كلها تنتج تشوهات متقطعة. التخطيط للأوامر النصية بطريقة تتجنب هذه السيناريوهات استراتيجية أفضل من الأمل في أن يتعامل النموذج معها بسلاسة.
واقع فلتر المحتوى
لدى Seedance 2.0 قيود محتوى مدمجة. سيتم تصفية المحتوى الجنسي الصريح أو سيؤدي إلى رفض التوليد. هذا قرار سياسي من ByteDance وليس قيدًا تقنيًا. بالنسبة إلى مبدعي البالغين الذين يعملون في منطقة غير صريحة لكنها موحية، تشمل الجلامور والبيكيني والعري الضمني والسيناريوهات الحسّية مع ارتداء الملابس، يعمل النموذج بشكل جيد. أما المخرجات الإباحية الصريحة فلا، ولا يغيّر ذلك أي قدر من هندسة الأوامر.
💡 نظرة واقعية: معظم مبدعي البالغين الناجحين تجاريًا على المنصات السائدة يعملون في المساحة غير الصريحة على أي حال. Seedance 2.0 مفيد فعلًا للمبدعين الذين ينتجون محتوى على منصة Instagram أو لمستويات OnlyFans الخالية من المحتوى الصريح، أو لأي منصة لديها إرشادات مجتمع بشأن المواد الصريحة.
كيفية استخدام Seedance 2.0 على PicassoIA
يمكن الوصول إلى Seedance 2.0 مباشرة عبر منصة PicassoIA، التي تغلّف النموذج بواجهة نظيفة دون الحاجة إلى إعداد API أو ضبط تقني.
أول مقطع لك، خطوة بخطوة
الخطوة 1: افتح صفحة نموذج Seedance 2.0 على PicassoIA.
الخطوة 2: اختر وضع الإدخال. لمحتوى يعتمد على شخصية، اختر Image to Video وارفع صورة مرجعية. لمحتوى يعتمد على المشهد دون شخصية ثابتة، يعمل Text to Video بشكل جيد.
الخطوة 3: اكتب الأمر النصي. كن محددًا بشأن حركة الكاميرا والإضاءة والإيقاع وملابس الشخص أو وضعيته. الأوامر الغامضة تنتج نتائج عامة.
الخطوة 4: حدّد مدة المقطع. يدعم Seedance 2.0 مقاطع تصل إلى عدة ثوانٍ. بالنسبة إلى المحتوى الاجتماعي، تميل المقاطع التي تتراوح مدتها بين 3 و5 ثوانٍ إلى الأداء الأفضل كحلقات متكررة.
الخطوة 5: راجع المخرجات وكرّر التجربة. النتيجة الأولى نادرًا ما تكون النهائية. عدّل الأمر النصي بناءً على ما نجح، ثم شغّل مرة أخرى.
استراتيجيات الأوامر النصية التي تنجح فعلًا
طريقة كتابة الأمر النصي مهمة بشكل كبير مع هذا النموذج. هناك بعض الأساليب التي تحسّن جودة المخرجات باستمرار:
- ابدأ بالشخص والفعل: "امرأة ترتدي بيكيني أسود تدير وجهها ببطء نحو الكاميرا" تتفوق على "لقطة سينمائية لامرأة جميلة" في كل مرة.
- حدّد اتجاه الضوء: "ضوء الشمس من اليسار، ظلال طويلة على الرمال البيضاء" يمنح النموذج معلومات ارتكاز تنتقل مباشرة إلى المخرجات.
- سمِّ حركة الكاميرا: "دفع بطيء للكاميرا نحو الشخص" أو "لقطة ثابتة، دون حركة للكاميرا" يعملان كلاهما وينتجان نتائج مختلفة جدًا.
- تجنّب تكديس مفاهيم كثيرة: إذا طلبت سلسلة معقدة من الأحداث في أمر نصي واحد، فغالبًا سيختار النموذج جزءًا واحدًا ويتجاهل البقية. حركة واحدة، ومكان واحد، وظرف إضاءة واحد في كل توليد أكثر موثوقية بكثير.
- صف القماش والسطح: كتابة "بدلة جسم من الحرير" بدلًا من "زي" تمنح النموذج مادة كافية لإنتاج سلوك واقعي للقماش أثناء الحركة.
Seedance 2.0 مقابل Seedance 2.0 Fast
بالنسبة إلى المبدعين الذين يهتمون بحجم الإنتاج، يُعد Seedance 2.0 Fast خيارًا جديًا. يعمل على نسخة مقطّرة من النموذج الكامل، مقابل التضحية ببعض الجودة من أجل أوقات توليد أسرع بشكل كبير.
| الميزة | Seedance 2.0 | Seedance 2.0 Fast |
|---|
| جودة المخرجات | دقة أعلى | أقل قليلًا |
| سرعة التوليد | أبطأ | أسرع بشكل ملحوظ |
| واقعية البشرة | الأفضل في فئته | جيد جدًا |
| سلاسة الحركة | ممتازة | جيدة |
| أفضل حالة استخدام | مقاطع النشر النهائية | المسودات الجماعية والتكرار |
| توليد الصوت | نعم | نعم |
سير العمل العملي الذي يستقر عليه معظم المبدعين هو استخدام Seedance 2.0 Fast للتكرار واختبار الأفكار، ثم التحول إلى Seedance 2.0 الكامل للمقاطع بجودة النشر. هذا يبقي التكاليف منخفضة مع الإبقاء على الجودة حيث يجب أن تكون للمخرج النهائي.
مقارنة جنبًا إلى جنب مع نماذج الفيديو الأخرى
Seedance 2.0 لا يوجد في عزلة. معرفة موقعه بالنسبة إلى النماذج الأخرى المتاحة تساعدك على توزيع النقاط والوقت بكفاءة أكبر.
مقابل Kling v3
Kling v3 هو الاسم الكبير الآخر في توليد الفيديو البشري الواقعي حاليًا. يتمتع بثبات شخصيات أقوى قليلًا من Seedance 2.0، وهذا يجعله جذابًا لمحتوى السلاسل. مع ذلك، يميل Seedance 2.0 إلى إنتاج ملمس بشرة أكثر طبيعية ودمج أفضل للبيئة المحيطة.
إذا كانت أولويتك وجهًا متسقًا عبر عشرة مقاطع، فإن Kling v3 يتفوق. وإذا كانت أولويتك أكثر مقطع واحد واقعية كالصور الفوتوغرافية في مشهد شاطئ أو مسبح، فإن Seedance 2.0 يفوز في تلك المقارنة.
للتحكم الأدق في الحركة، يتيح Kling v3 Motion Control تحديد الطريقة الدقيقة لتحرك الشخصية، وهذا مفيد لسيناريوهات الوضعيات المحددة. يجمع Kling v3 Omni Video بين مدخلات النص والصورة في نهج بوضعين مشابه لـ Seedance.
مقابل Wan 2.6
Wan 2.6 I2V قوي في فيزياء حركة الجسم، خاصة للقماش والشعر المنساب. أما المكان الذي يتخلف فيه عن Seedance 2.0 فهو تصيير البشرة. يميل Wan 2.6 إلى مظهر ناعم قليلًا يبدو أقل فوتوغرافية بشكل عام.
بالنسبة إلى المبدعين الذين يتضمن محتواهم حركة قماش كثيرة، مثل فستان أو رداء تحركه الريح، يستحق Wan 2.6 الاختبار مقابل Seedance 2.0. أما للمحتوى الذي يركّز على البشرة بملابس قليلة، فإن Seedance 2.0 يملك الميزة الأوضح.
بناء سير عمل إنتاجي حقيقي
المبدعون الذين يحصلون على أفضل النتائج من Seedance 2.0 لا يكتفون بتشغيل الأوامر النصية بمعزل عن غيرها. لقد بنوا سير عمل يجمع أدوات متعددة معًا.
الجمع مع أدوات الصور
تكون ميزة تحويل الصورة إلى فيديو في Seedance 2.0 أقوى ما تكون عندما تغذّيه بإطارات إدخال عالية الجودة ومتسقة. هذا يعني استخدام نموذج لتحويل النص إلى صورة أولًا لترسيخ الشخصية والإضاءة والمكان، ثم تحريكها باستخدام Seedance 2.0.
تمنحك منصة PicassoIA الوصول إلى أكثر من 90 نموذجًا لتحويل النص إلى صورة. يمكنك توليد مرجع شخصية متسق عبر عدة صور باستخدام نماذج تدعم تثبيت الشخصية أو الاتساق القائم على البذرة، ثم استخدام كل إطار من هذه الإطارات كنقطة بداية منفصلة لنموذج Seedance.
إذا احتجت إلى تعديل صورة مولّدة قبل تحريكها، تتيح لك أدوات التعديل الموضعي تغيير عناصر محددة دون إعادة التوليد من الصفر. هذا مفيد لضبط الملابس أو عناصر الخلفية أو تعابير الوجه الخفيفة قبل خطوة التحريك.
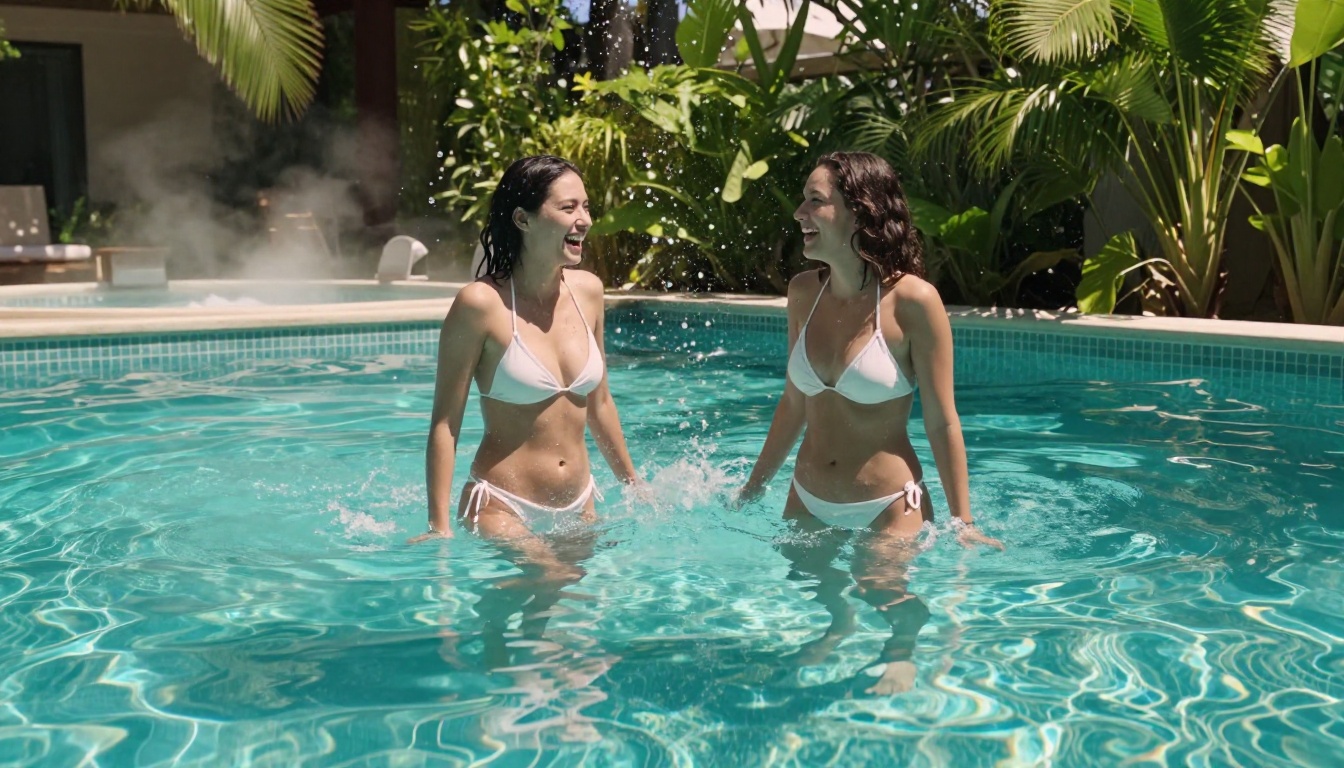
استراتيجية الإخراج الجماعي
يحتاج مبدعو المحتوى للبالغين الذين يعملون على نطاق واسع إلى الحجم. يتضمن النهج الأكثر كفاءة مع Seedance 2.0 ما يلي:
- أنشئ من 5 إلى 10 إطارات مرجعية للصور في جلسة واحدة مع قيمة بذرة ووصف شخصية متسقين
- شغّل تحويل الصورة إلى فيديو على جميع الإطارات المرجعية باستخدام الأمر النصي الأساسي نفسه مع تعديلات طفيفة
- استخدم Seedance 2.0 Fast للمخرجات الأولية على دفعات وفرز الجودة
- أعد تشغيل أفضل 2 إلى 3 مقاطع مختارة عبر Seedance 2.0 الكامل للحصول على جودة مناسبة للنشر
- طبّق رفع الدقة بالذكاء الاصطناعي إذا كنت تحتاج إلى مخرجات بمستوى 4K للمنصات التي تكافئ الدقة العالية
يبقي هذا المسار المجمّع تكاليف التكرار منخفضة، مع ضمان أن محتواك المنشور يبلغ مستوى الجودة الذي يتوقعه جمهورك.
يستحق الاستخدام، مع حدود واضحة
يُعد Seedance 2.0 من أكثر أدوات الفيديو بالذكاء الاصطناعي قدرةً المتاحة حاليًا لمبدعي البالغين الذين يعملون على محتوى جلامور وحسّي غير صريح. تصيير بشرته واقعي كالصور الفوتوغرافية فعلًا، وحركته سلسة للمقاطع البطيئة والمتوسطة السرعة، والصوت الأصلي يلغي خطوة إنتاج كانت تتطلب أدوات منفصلة.
الحدود حقيقية. ثبات الشخصيات عبر المقاطع لم يُحل بعد، والأيدي ما زالت مشكلة، والمحتوى الصريح يُصفّى. التعامل مع هذه القيود يتطلب سير عمل ذكيًا بدلًا من توقع أن ينجز النموذج كل شيء دفعة واحدة.
بالنسبة إلى المبدعين المستعدين للاستثمار في سير العمل، تبرّر جودة المخرجات ذلك. تمنحك PicassoIA كل ما تحتاجه لبناء هذا المسار في مكان واحد، من توليد الصورة المرجعية إلى تحريكها كفيديو، دون التنقل بين خدمات خارجية متعددة.
ابدأ بصورة مرجعية واحدة ومقطع قصير واحد مباشرة على صفحة Seedance 2.0. شاهد ما يفعله النموذج بأسلوبك الخاص. ومن هناك، يتضح مسار الإنتاج بسرعة، وتستحق النتائج الاستثمار في التكرار.


