كان إنشاء التسميات التوضيحية والترجمات يعني في السابق الجلوس لساعات طويلة أمام الصوت، وكتابة كل كلمة بعناية، ومزامنة النص يدويًا مع الجدول الزمني للفيديو. وكانت هذه العملية تستغرق أيامًا في المشاريع الطويلة، وتُدخل أخطاءً بشرية لا مفر منها. أما اليوم، فقد غيّرت تقنية تحويل الكلام إلى نص كل شيء في طريقة التعامل مع تفريغ الصوت لمحتوى الفيديو.
حدث هذا التحول بهدوء لكنه كان شاملًا. تتعامل أدوات التفريغ المدعومة بالذكاء الاصطناعي الآن مع لغات متعددة، ولهجات مختلفة، ومفردات تقنية، وحتى المتحدثين المتداخلين، بدقة كانت تبدو مستحيلة قبل خمس سنوات. بالنسبة إلى صنّاع المحتوى، يعني ذلك سير عمل أسرع. وبالنسبة إلى المشاهدين، يعني ذلك إمكانية وصول أفضل. وبالنسبة إلى المنصات، يعني ذلك معدلات تفاعل أعلى في كل المجالات.
لماذا تهم التسميات الدقيقة أكثر من أي وقت مضى
دفعت متطلبات إمكانية الوصول التسميات التوضيحية إلى صدارة الاهتمام العام، لكن فوائدها تتجاوز الامتثال بكثير. تُظهر الدراسات أن الفيديوهات المزودة بتسميات توضيحية تحصل على مشاهدات أكثر بنسبة 40% وتُبقي المشاهدين متفاعلين لفترة أطول. تُشغّل منصات التواصل الاجتماعي الفيديوهات تلقائيًا دون صوت، ما يجعل التسميات التوضيحية ضرورية لإيصال رسالتك. ويعتمد الجمهور الدولي على الترجمات عندما لا يكون المحتوى بلغته الأم.
للجانب التقني أهميته أيضًا. لا تستطيع محركات البحث فهرسة الصوت، لكنها تستطيع فهرسة النص. تحتل الفيديوهات المزودة بتسميات توضيحية مناسبة مراتب أعلى في نتائج البحث لأن المنصات تستطيع فهم محتواها. وتبحث خوارزمية YouTube تحديدًا عن التسميات الدقيقة عند تحديد مدى صلة الفيديو وجودته.
💡 رؤية عملية: حتى إن كنت تعتقد أن جمهورك لا يحتاج إلى تسميات توضيحية، فإن المنصات والخوارزميات تحتاجها. التسميات ليست مجرد إمكانية وصول، بل هي أيضًا قابلية للاكتشاف.
كيف يعمل التعرف على الكلام الحديث فعليًا
تستخدم أنظمة تحويل الكلام إلى نص المعاصرة شبكات عصبية تُدرَّب على آلاف الساعات من الصوت المتنوع. فهي لا تكتفي بمطابقة الأصوات مع الكلمات، بل تفهم السياق، وتتنبأ بالعبارات المحتملة، وتتكيف مع خصائص المتحدث. وتجري العملية على طبقات:
- المعالجة المسبقة للصوت تُزيل ضوضاء الخلفية وتُوحّد مستوى الصوت
- استخراج الخصائص يحدد العناصر الصوتية وأنماط الكلام
- النمذجة الصوتية تطابق الأصوات مع الفونيمات (وحدات الصوت الأساسية)
- النمذجة اللغوية تتنبأ بتسلسلات الكلمات المحتملة استنادًا إلى السياق
- فك الترميز يحوّل الاحتمالات إلى أرجح نص ناتج
تضيف الأنظمة المتقدمة تمييز المتحدثين (تحديد من يتحدث)، والتنبؤ بعلامات الترقيم، وقواعد التنسيق لأنواع المحتوى المختلفة. وتتعامل أفضل الأدوات مع المصطلحات التقنية وأسماء الأعلام والمفردات الخاصة بالصناعة دون الحاجة إلى تدريب مخصص.
جودة الصوت: العامل المنسي
تعتمد دقة التعرف على الكلام بشكل كبير على جودة المدخلات. يحقق الصوت النظيف بأقل ضوضاء خلفية معدلات دقة تتجاوز 95%، بينما قد تكافح التسجيلات الرديئة للوصول إلى 70%. ويسهم اختيار الميكروفون وبيئة التسجيل ومعالجة الصوت جميعًا في نجاح التفريغ.
| عامل جودة الصوت | الأثر على الدقة | الحل المقترح |
|---|
| ضوضاء الخلفية | تأثير كبير | برامج تقليل الضوضاء، المعالجة الصوتية للغرفة |
| جودة الميكروفون | تأثير متوسط | ميكروفونات مكثفة للاستوديو، وميكروفونات ياقية للهاتف |
| وضوح المتحدث | تأثير كبير | إعداد النص مسبقًا، وتدريب على الإلقاء |
| صيغة التسجيل | تأثير منخفض | WAV أو MP3 بمعدل بت مرتفع، وتجنب الضغط |
| تعدد المتحدثين | تأثير متوسط | ميكروفونات منفصلة، وتحديد هوية المتحدثين |
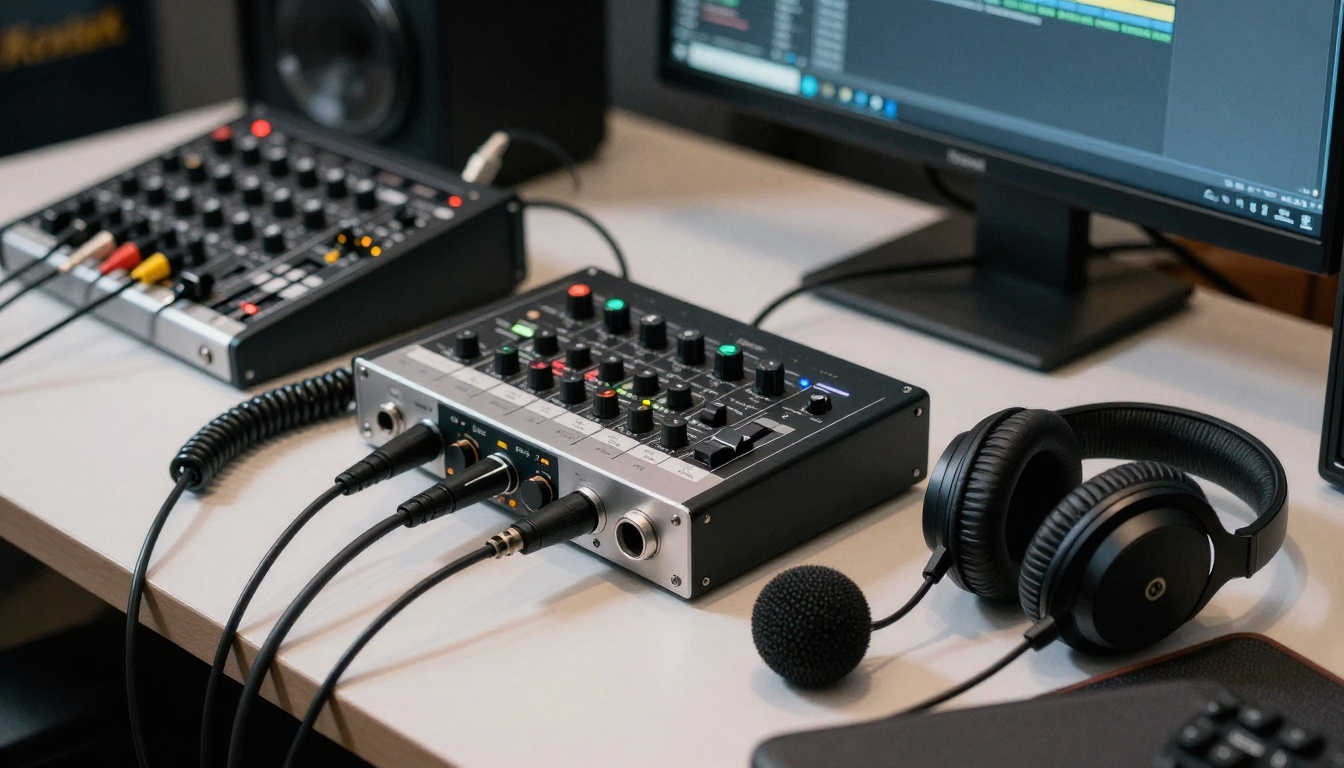
تستخدم الإعدادات الاحترافية واجهات صوتية بوصلات XLR، وفلاتر الانفجار لتقليل صوت الحروف الانفجارية، والمعالجة الصوتية لتقليل انعكاسات الغرفة. أما في التسجيل عبر الهاتف، فتُحدث الميكروفونات الاتجاهية وواقيات الرياح فرقًا كبيرًا.
تطبيقات سطح المكتب مقابل خدمات الويب
يعتمد الاختيار بين البرامج المثبتة وخدمات السحابة على احتياجات سير العمل، ومخاوف الخصوصية، والاعتبارات المتعلقة بالميزانية. ولكل نهج مزايا مختلفة لحالات استخدام مختلفة.
تعمل تطبيقات سطح المكتب مثل Descript وخاصية التفريغ المدمجة في Adobe Premiere Pro دون اتصال بالإنترنت، وتتعامل مع الملفات الكبيرة بكفاءة، وتتكامل مباشرة مع سير عمل المونتاج. وهي مثالية لـ:
- المحتوى الطويل (البودكاست، الأفلام الوثائقية، المحاضرات)
- المواد السرية التي لا يمكن أن تغادر الأنظمة المحلية
- المعالجة الدفعية لعدة ملفات تلقائيًا
- التكامل الوثيق مع الجداول الزمنية لمونتاج الفيديو
تقدّم خدمات الويب مثل Otter.ai وTrint وRev ميزات تعاونية، وتحديثات تلقائية، ومرونة في المنصات. وتتفوّق في:
- التعاون بين الفريق مع التحرير والتعليق المشترك
- الوصول من الجوال من أي جهاز متصل بالإنترنت
- الكشف التلقائي عن اللغة والترجمة
- تكامل API مع أدوات الأعمال الأخرى
أدوات متخصصة لأنواع المحتوى المختلفة
ليست كل احتياجات التفريغ متماثلة. تختلف الأداة المثلى اختلافًا كبيرًا بحسب ما إذا كنت تضيف تسميات إلى فيديوهات YouTube، أو تفرّغ شهادات قانونية، أو تضيف ترجمات إلى الأفلام الروائية.
ينبغي لـصنّاع محتوى YouTube ووسائل التواصل الاجتماعي إعطاء الأولوية للأدوات التي تتكامل مباشرة مع المنصة. تعمل التسميات التلقائية المدمجة في YouTube Studio بشكل جيد نسبيًا وتتزامن تلقائيًا مع عمليات الرفع. وتقدّم خدمات خارجية مثل Subly وCapCut قوالب متخصصة لصيغ التواصل الاجتماعي، مع نصوص متحركة وتوقيت مُحسَّن لفترات الانتباه القصيرة.
يحتاج منتجو البودكاست إلى تحديد دقيق للمتحدثين وعلامات الفصول. ولا يزال Descript المعيار السائد في الصناعة بفضل ميزة Overdub التي تتيح تصحيح أخطاء الصوت عبر تحرير النص. ويقدم Adobe Podcast (المعروف سابقًا باسم Podcast.ai) تفريغًا مجانيًا جيدًا بشكل مفاجئ، مع دقة مقبولة للمحتوى الحواري.
يستفيد المستخدمون في الشركات والمؤسسات التعليمية الذين يتعاملون مع الاجتماعات والمحاضرات والعروض التقديمية من التفريغ الفوري. ينشئ Otter.ai ملاحظات اجتماعات قابلة للبحث تلقائيًا، بينما تتضمن Microsoft Teams وZoom تسميات مدمجة تتحسن مع كل استخدام من خلال التعلم الآلي.
يحتاج المحترفون في السينما والتلفزيون إلى توقيت دقيق على مستوى الإطار والالتزام بالصيغ. يوفر Subtitle Edit وAegisub تحكمًا بمستوى احترافي في التوقيت والموضع والتنسيق البصري، مع دعم لمعايير البث مثل EBU-TT-D وIMSC.
اختبارات الدقة المعيارية: ماذا تعني الأرقام فعلًا
تعلن خدمات التفريغ عن معدلات دقة تتراوح بين 85% و99%، لكن هذه الأرقام تحتاج إلى سياق. فدقة 99% تبدو مبهرة حتى تدرك أنها تعني خطأً واحدًا لكل 100 كلمة، وهو أمر غير مقبول للاستخدام الاحترافي. ومن المقاييس الأكثر دلالة:
- معدل خطأ الكلمات (WER): نسبة الكلمات التي تم تفريغها بشكل خاطئ
- معدل خطأ تمييز المتحدثين: الأخطاء في تحديد من يتحدث
- دقة علامات الترقيم: الوضع الصحيح للفواصل والنقاط وعلامات الاستفهام
- اتساق التنسيق: المعالجة المتسقة للأرقام والتواريخ والمصطلحات الخاصة
تُظهر الاختبارات المستقلة أن معظم الخدمات تحقق دقة تتراوح بين 92% و96% على التسجيلات النظيفة في الاستوديو مع متحدث واحد. وتنخفض الدقة إلى 85% إلى 90% في المحتوى الحواري مع عدة متحدثين وضوضاء خلفية. ويمكن أن تنزل الدقة إلى ما دون 80% مع الكلام ذي اللهجة الثقيلة أو المصطلحات التقنية، دون تدريب مخصص.
واقع التحرير: لماذا لا تكفي دقة 95%
حتى أفضل التفريغ التلقائي يحتاج إلى تحرير بشري. فالبودكاست الذي مدته ساعة بدقة 95% (نحو 9,000 كلمة) يحتوي على 450 خطأ. ويستغرق تحرير هذه الأخطاء 60 إلى 90 دقيقة لمحرر ذي خبرة. وتتضمن عملية التحرير:
- الاستماع أثناء القراءة لالتقاط الكلمات الناقصة والمتجانسات الخاطئة
- تصحيح أسماء الأعلام والمصطلحات التقنية التي أساء الذكاء الاصطناعي سماعها
- إضافة علامات الترقيم حيث أغفل الذكاء الاصطناعي حدود الجمل
- التنسيق لتحسين القراءة بفواصل الفقرات وتسميات المتحدثين
- ضبط التوقيت لمزامنة النص مع الإشارات البصرية في الفيديو
تتمثل أكثر الأخطاء استهلاكًا للوقت في المتجانسات (الكلمات المتشابهة في النطق)، وأسماء العلم، والمصطلحات الخاصة بالمجال. وتظهر أخطاء مثل "Their/there/they're" باستمرار. وتتعرض أسماء الشركات ومصطلحات المنتجات للتشويه ما لم يُدرَّب النظام عليها تحديدًا. أما المفردات الطبية والقانونية والتقنية فتحتاج إلى قواميس متخصصة.
التكامل مع سير عمل مونتاج الفيديو
تأتي مكاسب الكفاءة الحقيقية عندما يتكامل التفريغ بسلاسة مع مونتاج الفيديو. يتيح سير العمل الحديث أن يقود تحرير النص تعديلات الصوت والفيديو، لا العكس.
يتيح التحرير المعتمد على النص في Descript حذف الكلمات الحشو بتحديد النص، مع إزالة الصوت المقابل تلقائيًا. ويربط Adobe Premiere Pro نص التفريغ بعلامات الجدول الزمني، ما يتيح التنقل السريع إلى حوار محدد. كما توفر مساحة عمل التسميات في Final Cut Pro تحكمًا مباشرًا في توقيت الترجمات وتنسيقها داخل بيئة المونتاج.
تستخدم الأنظمة الأكثر تقدمًا اقتراحات تحرير مدعومة بالذكاء الاصطناعي. يمكنها تحديد العبارات المتكررة وحذفها، واقتراح صياغات أفضل، بل وتوليد نسخ بديلة استنادًا إلى أنماط التفريغ. وهذا ينقل التسميات من تنظيف ما بعد الإنتاج إلى تشكيل المحتوى بشكل فعّال.
قدرات تعدد اللغات والترجمة
يحتاج المحتوى العالمي إلى تفريغ وترجمة متعددة اللغات. تتعامل أفضل الأدوات مع ذلك تلقائيًا، لكن بمستويات جودة متفاوتة.
تُنشئ الترجمة التلقائية في YouTube ترجمات بأكثر من 100 لغة، وتعتمد الدقة على شعبية زوج اللغات. ويعتمد معظم الخدمات على محرك الترجمة الخاص بشركة Google، فيما تقدّم DeepL جودة أعلى للغات الأوروبية. وتقدّم Rev وSonix تسميات مترجمة بشريًا للمشاريع الحساسة التي لا تكفي فيها الترجمة الآلية.
يتضمن سير العمل عادةً:
- التفريغ باللغة الأصلية
- الترجمة إلى اللغات المستهدفة
- ضبط التوقيت لاختلاف أنماط الكلام
- التكييف الثقافي للتعابير الاصطلاحية والإشارات
- التحقق من التنسيق وفق معايير الترجمات المختلفة
اعتبارات التكلفة: الخدمات المجانية مقابل المدفوعة
تتراوح نماذج التسعير بين المجانية تمامًا والاشتراكات الاحترافية. ويعتمد الخيار المناسب على الحجم، واحتياجات الدقة، ومتطلبات التكامل.
| نوع الخدمة | التكلفة المعتادة | الأفضل لـ |
|---|
| أدوات المنصات المدمجة | مجانية | صنّاع المحتوى العرضيون، والقنوات الصغيرة |
| خدمات الويب بنموذج Freemium | 0-20 دولارًا شهريًا | المحتوى المنتظم، واحتياجات دقة متوسطة |
| الاشتراكات الاحترافية | 50-200 دولار شهريًا | الحجم الكبير، والاستخدام التجاري، وميزات الفرق |
| الحلول المؤسسية | أكثر من 500 دولار شهريًا | المؤسسات الكبيرة، والتكاملات المخصصة |
| التفريغ البشري | 1-3 دولارات للدقيقة | القانوني والطبي، وأعلى درجات الدقة المطلوبة |
تعمل الخدمات المجانية مثل YouTube Studio وخطة Otter.ai الأساسية للاستخدام المتقطع، لكنها تحد من الميزات ومدة المعالجة. وتقدّم الخدمات المتوسطة مثل Descript وTrint أفضل توازن لصنّاع المحتوى المنتظمين. أما الحلول المؤسسية من Verbit و3Play Media فتوفر الامتثال الأمني، والقواميس المخصصة، والدعم المتخصص.
نماذج تحويل الكلام إلى نص على PicassoIA
للمطورين والمستخدمين التقنيين الذين يرغبون في بناء حلول تفريغ مخصصة، يقدّم PicassoIA عدة نماذج قوية للذكاء الاصطناعي مصممة خصيصًا لمهام التعرف على الكلام. توفر هذه النماذج وصولًا عبر API إلى تقنية تفريغ متطورة يمكنك دمجها في تطبيقاتك الخاصة.
يقدّم gemini-3-pro من Google تفريغًا متقدمًا للكلام إلى نص بدقة استثنائية للغات ولهجات متعددة. يتعامل النموذج مع الكلام الحواري والمصطلحات التقنية وجودة الصوت المتفاوتة مع تصحيح قوي للأخطاء.
يوفّر gpt-4o-transcribe من OpenAI تحويلًا دقيقًا للكلام إلى نص باستخدام التقنية نفسها التي تقف خلف ChatGPT. ويتفوق في فهم السياق، والتعامل مع المتحدثين المتداخلين، والتنبؤ بموضع علامات الترقيم الصحيحة.
يقدّم gpt-4o-mini-transcribe من OpenAI خيارًا أسرع وأكثر كفاءة للتفريغ، محسّنًا للتطبيقات الفورية والمعالجة بكميات كبيرة. ورغم أنه أقل دقة قليلًا من النموذج الكامل، فإنه يقدم أداءً ممتازًا بتكلفة حسابية أقل.
يوفّر AutoCaption من fictions-ai إضافة ترجمات للفيديو بسهولة مباشرة داخل سير عمل مونتاج الفيديو. يتخصص هذا النموذج في مزامنة النص مع الإشارات البصرية والتعامل مع متطلبات التوقيت الفريدة لمحتوى الفيديو.
كيفية استخدام نماذج تحويل الكلام إلى نص على PicassoIA
يتبع دمج التفريغ بالذكاء الاصطناعي في سير عملك عبر PicassoIA خطوات واضحة ومباشرة. توفر المنصة وصولًا مباشرًا إلى نماذج متطورة دون الحاجة إلى خبرة تقنية عميقة.
الخطوة 1: اختيار النموذج
اختر النموذج المناسب بحسب احتياجاتك. للحصول على أعلى دقة مع عدة متحدثين، استخدم gemini-3-pro. وللتطبيقات الفورية مع أداء جيد، يعمل gpt-4o-mini-transcribe بشكل جيد. وللتسميات المتخصصة في الفيديو مع مزامنة التوقيت، يوفّر autocaption إمكانات مخصصة.
الخطوة 2: تحضير الصوت
ارفع ملفات الصوت بالصيغ المدعومة (MP3 وWAV وM4A). يعطي الصوت النظيف نتائج أفضل، فكّر في تقليل الضوضاء الأساسي إذا كانت جودة التسجيل رديئة. وبالنسبة إلى ملفات الفيديو، استخرج مسار الصوت منفصلًا، أو استخدم أدوات تتولى تحويل الفيديو إلى صوت تلقائيًا.
الخطوة 3: إعدادات التهيئة
اضبط معلمات النموذج بحسب المحتوى:
- تحديد اللغة يحسّن الدقة للمحتوى غير الإنجليزي
- عدد المتحدثين يساعد في تمييز المتحدثين (تحديد المتحدثين المختلفين)
- قوائم المفردات التقنية تحسّن التعرف على مصطلحات الصناعة
- تفضيلات علامات الترقيم تتحكم في أسلوب التنسيق
الخطوة 4: المعالجة والمخرجات
أرسل الصوت للتفريغ. يختلف زمن المعالجة بحسب الطول وتعقيد النموذج. نزّل النتائج بالصيغة التي تفضلها:
- نص عادي للتفريغ الأساسي
- ملفات SRT/VTT للترجمات الخاصة بالفيديو مع التوقيت
- JSON/XML للتكامل مع تطبيقات أخرى
- مستندات Word بطوابع زمنية منسقة
الخطوة 5: المراجعة والتصحيح
يحتاج كل تفريغ بالذكاء الاصطناعي إلى مراجعة بشرية. استخدم واجهة التحرير المتاحة لـ:
- تصحيح أخطاء المتجانسات (their/there/they're)
- إصلاح أسماء الأعلام والمصطلحات التقنية
- ضبط علامات الترقيم لتحسين القراءة
- التحقق من تزامن التوقيت في الفيديو
نصائح عملية للتطبيق
- ابدأ بصوت نظيف، فحتى الذكاء الاصطناعي المتقدم يعاني مع التسجيلات الرديئة
- وفّر السياق كلما أمكن (الموضوع، وخلفيات المتحدثين، والمصطلحات التقنية)
- استخدم تسميات المتحدثين إذا كان محتواك يضم عدة مشاركين
- عالج المحتوى المتشابه دفعةً واحدة للحفاظ على الاتساق
- أنشئ قواميس مخصصة لأسماء الأعلام المتكررة
التطورات المستقبلية في التعرف على الكلام
تواصل التقنية تقدمها بسرعة. تركز الأبحاث الحالية على التعلم بلا أمثلة سابقة (فهم الكلام دون تدريب محدد)، والتعرف على المشاعر (اكتشاف النبرة والنية)، والفهم متعدد الوسائط (ربط الكلام بالسياق البصري).
ستصبح الترجمة الفورية أثناء البث المباشر معيارًا خلال عامين. وستقلل نماذج الكلام الشخصية التي تتكيف مع الأصوات الفردية وأنماط الكلام من الأخطاء لدى المتحدثين المنتظمين. وسيفهم التفريغ المدرك للسياق الإشارات إلى العناصر المرئية على الشاشة ويضبط الصياغة وفقًا لذلك.
يتمثل أهم تحسن قريب المدى في التعامل مع الكلام المتداخل. تتعثر الأنظمة الحالية عندما يتحدث عدة أشخاص في الوقت نفسه، وهو أمر شائع في المقابلات والنقاشات الجماعية. وتستخدم نماذج الجيل القادم تقنيات فصل المصادر لعزل الأصوات الفردية من الصوت المختلط.
يتقدم دمج الأجهزة أيضًا. ستتمكن الميكروفونات الذكية المزودة بمعالجة ذكاء اصطناعي مدمجة من التفريغ محليًا دون الاعتماد على السحابة، ما يعالج مخاوف الخصوصية للمحادثات الحساسة. وستقدم الأجهزة القابلة للارتداء تفريغًا مستمرًا لتدوين الملاحظات أثناء الاجتماعات والفعاليات.
المزالق الشائعة وكيفية تجنبها
حتى مع أفضل الأدوات، تواجه مشاريع التفريغ مشكلات متوقعة. إدراك هذه المشكلات مبكرًا يوفر وقت تصحيح كبيرًا لاحقًا.
تظل مشكلات جودة الصوت أكبر عائق. فضوضاء الخلفية وسوء وضع الميكروفون وصدى الغرفة تقلل الدقة بشكل كبير. الحل: استثمر في ميكروفونات جيدة ومعالجة صوتية أساسية للغرفة. سجّل في بيئات هادئة كلما أمكن ذلك.
المصطلحات التقنية تتشوه ما لم يتم تدريب الأداة عليها تحديدًا. فالمفردات الطبية والقانونية والخاصة بالصناعة تحتوي على كلمات غير شائعة لا تتعرف عليها النماذج القياسية. الحل: زوّد خدمات التفريغ بقوائم الكلمات. واستخدم قواميس مخصصة للمصطلحات المتكررة.
تحديد المتحدثين يفشل مع الأصوات المتشابهة أو عندما يقاطع المتحدثون بعضهم بعضًا. الحل: سجّل كل متحدث على مسار منفصل كلما أمكن ذلك. واستخدم ميكروفونات مختلفة لكل مشارك.
عدم اتساق التنسيق ينتج ترجمات تبدو احترافية لكنها معيبة تقنيًا. فالمنصات المختلفة لها متطلبات محددة لطول السطر والمدة والموضع. الحل: استخدم أدوات خاصة بالمنصة، أو تحقق من التنسيق بمقارنته بالإرشادات المنشورة.
بناء تطبيق تحويل الكلام إلى نص الخاص بك
بالنسبة إلى المؤسسات ذات الاحتياجات المحددة، يوفر بناء حلول تفريغ مخصصة باستخدام نماذج PicassoIA مرونة وتحكمًا. تتضمن العملية عدة قرارات رئيسية تتعلق بالبنية وقابلية التوسع والتكامل.
تعتمد خيارات البنية على الحجم ومتطلبات زمن الاستجابة:
- المعالجة المستندة إلى السحابة تعمل مع معظم التطبيقات المتصلة بالإنترنت
- الحوسبة الطرفية تقلل زمن الاستجابة للتطبيقات الفورية
- الأساليب الهجينة تجمع دقة السحابة مع المعالجة المسبقة المحلية
تعالج اعتبارات قابلية التوسع احتياجات التفريغ المتزايدة:
- المعالجة الدفعية تتعامل مع الكميات الكبيرة من المحتوى المسجل مسبقًا
- التفريغ المتدفق يدعم الفعاليات المباشرة والتسجيل المستمر
- المعالجة الموزعة توزع الحمل على عدة نسخ
تحدد أنماط التكامل كيفية دمج التفريغ في سير العمل القائم:
- التكامل عبر API يربط بالبرامج الحالية للمونتاج
- إشعارات Webhook تنبّه الأنظمة عند اكتمال التفريغ
- تخزين قواعد البيانات يحفظ سجل التفريغ مع إمكانية البحث
يتطلب ضمان الجودة مناهج منهجية:
- التحقق الآلي يفحص أنماط الأخطاء الشائعة
- سير عمل المراجعة البشرية يضمن دقة المحتوى المهم
- التحسين المستمر يعيد التصحيحات إلى بيانات التدريب
البدء باستثمار أدنى
لم يكن حاجز الدخول إلى تفريغ عالي الجودة أدنى مما هو عليه اليوم. لا تحتاج إلى برامج باهظة الثمن أو تدريب متخصص لتبدأ في إنشاء تسميات دقيقة لمحتواك.
يتيح استكشاف الطبقة المجانية اختبار خدمات متعددة دون التزام مالي. تقدم معظم المنصات دقائق مجانية محدودة أو ميزات أساسية دون مقابل. استخدمها لفهم الأساليب المختلفة وتحديد ما يناسب سير عملك.
يؤتي الاستثمار التدريجي في معدات أفضل ثماره مع الوقت. فميكروفون بسعر 100 إلى 200 دولار يحسّن جودة الصوت بشكل ملحوظ. وتكلف المعالجة الصوتية الأساسية للغرفة (ألواح الفوم، وحواجز العزل) أقل من 100 دولار، لكنها تغيّر بيئة التسجيل تمامًا.
يركّز تطوير المهارات على التحرير الفعّال بدلًا من التفريغ المثالي. تعلّم اختصارات لوحة المفاتيح في برنامج المونتاج الذي تختاره. وطوّر أساليب منهجية للتعامل مع أنماط الأخطاء الشائعة. وأنشئ قوالب لأنواع المحتوى المتكررة.
توفر موارد المجتمع الدعم وأفضل الممارسات. تتبادل المنتديات الإلكترونية وقنوات الدروس والشبكات المهنية الحلول للمشكلات الشائعة. وتعرض المؤتمرات الصناعية (عند توفرها) الأدوات والتقنيات الناشئة.
الخلاصة حول التفريغ الحديث
تطورت تقنية تحويل الكلام إلى نص من كونها مجرد ابتكار إلى ضرورة. ما كان يتطلب خبرة متخصصة وبرامج باهظة الثمن يعمل الآن بدقة مدهشة عبر أدوات في متناول الجميع. ويؤثر هذا التحول في كل من ينشئ محتوى صوتيًا أو مرئيًا، من صنّاع المحتوى الأفراد إلى المؤسسات الكبيرة.
تستمر الدقة في التحسن مع تدريب النماذج على بيانات أكثر تنوعًا. وتنخفض التكلفة مع اشتداد المنافسة وتحسن الكفاءة. ويتعمق التكامل مع إدراك المنصات للدور المحوري للتفريغ في سير عمل المحتوى.
والنتيجة العملية: لم يعد إنشاء التسميات والترجمات يمثل استثمارًا كبيرًا في الوقت. ما كان يستغرق ساعات أصبح يكتمل خلال دقائق بدقة معقولة. تتطلب اللمسات النهائية اهتمامًا بشريًا، لكن العمل الشاق يتم تلقائيًا.
الخطوات التالية لمشاريعك
قيّم سير عمل التسميات الحالي لديك مقارنةً بالخيارات المتاحة. اختبر خدمات مختلفة بمحتواك الفعلي، لا بالمواد التجريبية فقط. وضع في اعتبارك الاحتياجات الفورية وقابلية التوسع المستقبلية مع نمو حجم محتواك.
بالنسبة إلى المستخدمين التقنيين، استكشف نماذج تحويل الكلام إلى نص على PicassoIA لفهم التقنية الكامنة وراءها. توفر المنصة وصولًا مباشرًا إلى الذكاء الاصطناعي المتطور دون الحاجة إلى خبرة عميقة في تعلم الآلة.
جرّب بناء تطبيقات التفريغ الخاصة بك باستخدام النماذج المتاحة. ابدأ بتكاملات بسيطة ووسّع الوظائف مع تحديد احتياجاتك الفعلية. يجعل الجمع بين نماذج الذكاء الاصطناعي المتاحة وأدوات سير العمل العملية قدرات التفريغ المتطورة في متناول كل من ينشئ محتوى اليوم.


