حدث تحوّل ما على TikTok هذا الأسبوع. الفيديوهات تبدو مختلفة. أنعم، وأكثر سينمائية. وفي كثير من الحالات، لم يصوّرها أحد.
وصل محتوى الفيديو المولّد بالذكاء الاصطناعي إلى نقطة تحوّل على TikTok، والنتائج منتشرة في كل مكان في خلاصتك الآن. أفاتارات تتحدث دون أن ترمش بشكل خاطئ أبدًا. تحوّلات للوجوه تجعلك تتوقف أثناء التمرير. مناظر طبيعية لا يمكن تصويرها بأي كاميرا. صنّاع محتوى ينشرون يوميًا دون أن يغادروا شققهم. هذا ليس توقعًا. هذا ما يحدث بالفعل، ويتسارع أسرع مما يدرك معظم الناس.
شهد هذا الأسبوع موجة من اتجاهات فيديو الذكاء الاصطناعي اجتاحت المنصة بقوة غير معتادة. فيما يلي تفصيل لما ينتشر بالضبط، والأدوات التي تقف خلف كل اتجاه، وكيف يمكنك أن تبدأ في إنتاج المحتوى نفسه اليوم.
لماذا تبدو صفحة For You الخاصة بك مختلفة
سقف الجودة ارتفع من تلقاء نفسه
قبل ستة أشهر، كان فيديو الذكاء الاصطناعي سهل الكشف. أيدٍ تومض، وخلفيات تذوب، وفيزياء لا معنى لها. ذلك العصر انتهى. الجيل الأحدث من نماذج تحويل النص إلى فيديو ينتج لقطات يصعب فعلاً تمييزها عن المحتوى المصوّر باحترافية بسرعة المشاهدة العادية.
والنتيجة: خوارزمية TikTok لا تهتم بما إذا كان الشيء قد صُوّر بكاميرا أو وُلّد بنموذج. إنها تهتم بما إذا كان الناس يشاهدون ويشاركون ويعيدون المشاهدة. المحتوى المولّد بالذكاء الاصطناعي الذي يبدو جيدًا ينجح في هذا الاختبار هذا الأسبوع بأرقام يصعب تجاهلها.
السرعة هي الاضطراب الحقيقي
اتجاه كان يستغرق من فريق تصوير يومًا كاملًا لتنفيذه، صار يستغرق من صانع محتوى يملك الأداة المناسبة نحو اثنتي عشرة دقيقة. هذا الضغط في الجهد يغيّر كل شيء. عندما يكلّف إنتاج مقطع سينمائي قصير تقريبًا الجهد نفسه الذي يتطلبه كتابة تعليق، ينتج الناس منها المزيد. تصبح الخلاصات أكثف، وتنتشر الاتجاهات أسرع. تقلّص إيقاع ما يُعدّ "اتجاه هذا الأسبوع" بشكل ملحوظ.
💡 يستحق المعرفة: أكثر صنّاع محتوى الذكاء الاصطناعي على TikTok مشاهدةً لا ينشرون مرة واحدة في الأسبوع. إنهم ينشرون يوميًا، وأحيانًا عدة مرات في اليوم، لأن وقت الإنتاج منخفض بما يكفي لجعل ذلك ممكنًا.
انفجار الأفاتارات المتحدثة
كيف يبدو فعلاً
اتجاه الأفاتارات المتحدثة ليس جديدًا، لكن الجودة التي تجاوزت عتبة معينة هذا الأسبوع أعادت إحياءه. الصيغة بسيطة: شخص واقعي مولّد بالذكاء الاصطناعي يتحدث مباشرة إلى الكاميرا، يقدّم معلومات، أو يحكي قصة، أو يحرّك شفتيه مع صوت. لم يُصوَّر أي إنسان. الأفاتار وُلّد وحُرّك بالكامل عبر الذكاء الاصطناعي.
ما يختلف الآن هو أن الأفاتارات ترمش على فترات غير منتظمة، ولديها حركات رأس دقيقة وواقعية، وتُظهر تعابير خفيفة تبدو أصيلة. وادي الغرابة يضيق بسرعة، ولأول مرة، لا يلاحظ مشاهدو TikTok العاديون أن هذه الفيديوهات مزيفة عند المشاهدة الأولى.
النماذج التي تتولى العمل الشاق
أداتان مسؤولتان عن غالبية محتوى الأفاتارات المتحدثة الرائج هذا الأسبوع:
Kling Avatar v2 من Kwaivgi مصمَّم خصيصًا لتحريك الوجوه داخل الفيديو. تزوّده بصورة بورتريه، فيحوّلها النموذج إلى شخصية تتحدث وتتحرك. يصل الإخراج إلى دقة 1080p، ويتعامل مع حركة الشفاه والتواصل البصري والدوران الطبيعي للرأس بواقعية لم تكن النماذج الأقدم تقدر عليها أبدًا.
Wan 2.7 I2V نموذج تحويل الصورة إلى فيديو الذي يقترن به صنّاع المحتوى البورتريهات بالذكاء الاصطناعي لإنتاج محتوى بأسلوب الأفاتار دون الحاجة إلى أداة أفاتار متخصصة. تولّد بورتريه بنموذج تحويل النص إلى صورة، ثم تحرّكه. سير العمل المكوّن من خطوتين صار سريعًا بما يكفي ليكون عمليًا للنشر اليومي.
💡 نصيحة: أفضل الأفاتارات المتحدثة على TikTok هذا الأسبوع تستخدم بورتريهات بتواصل بصري مباشر وتعابير محايدة كصورة مصدر. التعابير المبالغ فيها تميل إلى التشوه أثناء التحريك.
تحوّلات الوجوه بالذكاء الاصطناعي واتجاه الانتقالات
الصيغة التي تجعل المشاهد يتوقف عن التمرير فورًا
انتقال تحوّل الوجه هو على الأرجح أكثر صيغة فيديو مولّد بالذكاء الاصطناعي مشاركةً على TikTok الآن. البنية متوقعة بما يكفي لتكون مألوفة، ومفاجئة بما يكفي لتشد الانتباه في كل مرة: وجه يذوب بسلاسة في وجه آخر عبر العمر أو العرق أو الأسلوب البصري. يبدو مستحيلًا لأنه كذلك. لا توجد لقطات حقيقية تُدمج معًا.
الجاذبية النفسية قوية. مشاهدة وجه يتحوّل بسرعة تبدو أنعم من أن تكون مونتاجًا تُحفّز فضولًا حقيقيًا. والتعليقات على هذه الفيديوهات تكون دائمًا تقريبًا من أناس يسألون "كيف؟" بدلاً من نقد المحتوى نفسه.
ما الذي يستخدمه صنّاع المحتوى
Wan 2.7 R2V (Reference to Video) هو النموذج الأكثر ارتباطًا بهذا الاتجاه. يأخذ شخصًا من صورة ويحركه أو يحوّله بثبات عالٍ. جودة الحفاظ على الشخص هي ما يجعل التحولات متماسكة بدلاً من أن تكون فوضوية.
Pixverse v4.5 يتعامل مع المحتوى بأسلوب الانتقالات بشكل جيد بشكل خاص بفضل ثبات حركته. يستخدمه صنّاع المحتوى لمزج صورتين مصدريتين عبر خط زمني سلس للفيديو، لإنتاج تأثير التحوّل الذي يغمر المنصة حاليًا.
مقاطع تحويل النص إلى فيديو التي تنتشر
من جملة إلى مقطع في ثوانٍ
تحويل النص إلى فيديو الصرف، حيث تكتب وصفًا وتتلقى مقطعًا قصيرًا، يعيش أكبر أسبوع له على TikTok حتى الآن. المقاطع التي تنتشر ليست تجارب عشوائية. إنها مشاهد مقصودة ومحكمة الأوامر، تبدو كأنها اقتُطعت من فيلم روائي.
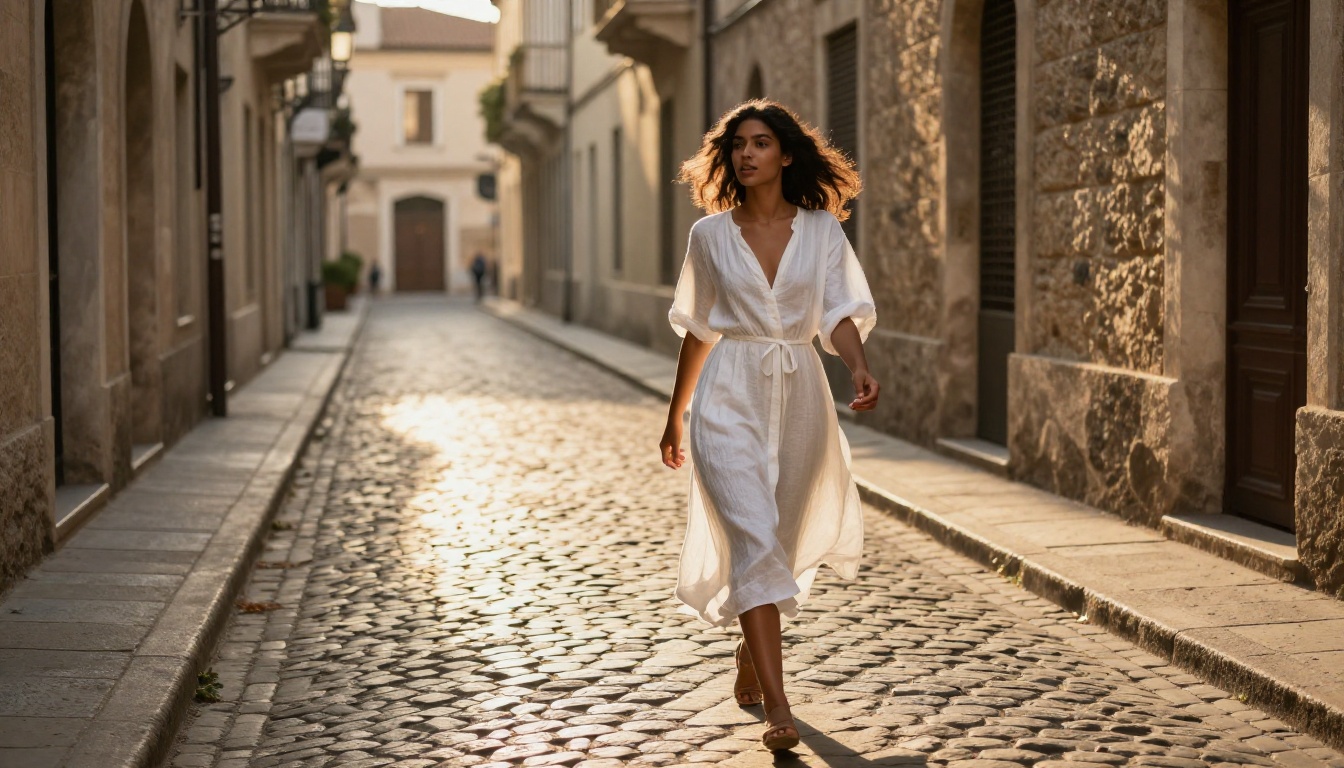
لقطات عريضة سينمائية لجبال عند الساعة الذهبية. امرأة تمشي في شارع مبلل بالمطر ليلًا. عاصفة محيطية تجريدية تُرى من الأعلى مباشرة. لم يُصوَّر أي منها. كلها وُلّدت من أوامر نصية في أقل من دقيقتين، ثم نُشرت مباشرة على TikTok.
نماذج تستحق التجربة الآن
Veo 3 من Google هو المعيار الحالي لتحويل النص إلى فيديو السينمائي. ينتج صوتًا أصليًا إلى جانب الفيديو، أي أن الصوت المحيطي والرياح وضجيج الحشود أو أي شيء توحي به المشهد يُولَّد تلقائيًا. بالنسبة إلى محتوى TikTok، هذا مهم لأن الصوت نصف أسباب نجاح الفيديوهات على المنصة.
Kling v2.6 يواصل الأداء في الصدارة ضمن فئة تحويل النص إلى فيديو لصنّاع المحتوى الذين يريدون إخراجًا سينمائيًا دون أوقات توليد طويلة. فيزياء الحركة قوية بشكل ملحوظ، خاصة في المشاهد التي تتضمن الماء أو الأقمشة أو حركة الإنسان.
Seedance 1.5 Pro من Bytedance (الشركة نفسها التي تقف وراء TikTok) ينتج فيديوهات مع توليد صوت مدمج. أسلوب الحركة يميل إلى السلاسة والتروّي، وهذا يعمل بشكل ممتاز مع المحتوى المركّز على الجماليات، وهو الأفضل أداءً على المنصة.
Hailuo 02 من Minimax يولّد بدقة 1080p مع ثبات قوي جدًا للموضوع عبر الإطارات. بالنسبة إلى الأوامر الأطول التي تصف مشاهد معقدة، يحافظ على التماسك بشكل أفضل من النماذج المضبوطة للمقاطع القصيرة.
💡 نصيحة: الفيديوهات على TikTok التي تحتوي على مقاطع ذكاء اصطناعي من 3 إلى 7 ثوانٍ تحقق أداءً أفضل عندما تتكرر بسلاسة. عند كتابة الأوامر، أضف "حلقة حركة سلسة" أو "حركة دورية بطيئة" لزيادة فرصة الحصول على لقطات تعمل كحلقة متكررة.
موجة تزامن الشفاه
لماذا هذه الصيغة شديدة الإدمان
فيديوهات مزامنة الشفاه حققت دائمًا أداءً جيدًا على TikTok. نسخة الذكاء الاصطناعي من الاتجاه تضيف طبقة لا يستطيعها تزامن الشفاه التقليدي: لا يجب أن يكون المتحدث موجودًا أصلًا. يولّد صنّاع المحتوى أشخاصًا واقعيين يحرّكون شفاههم مع صوت رائج أو تعليق صوتي أو كلام مترجم، مع حركة فم دقيقة كانت النماذج السابقة تخطئ فيها بشكل كارثي.
الموجة الحالية يقودها المحتوى متعدد اللغات. يسجّل صانع المحتوى صوتًا بلغة واحدة، ثم يستخدم تزامن الشفاه بالذكاء الاصطناعي لإنتاج نسخة يبدو فيها متحدث مختلف يقول الكلمات نفسها بلغة أخرى، ثم ينشر النسختين. تنسيق المقارنة "شاهدهما معًا" يحقق أداءً جيدًا باستمرار ويدفع التفاعل في التعليقات من مشاهدين في مناطق متعددة.
ما الذي يقف خلف حركة الفم الواقعية
Wan 2.2 S2V (Speech to Video) مصمَّم خصيصًا لتوليد فيديو متزامن مع الصوت. أعطه صوتًا وبورتريهًا، فينتج فيديو تتطابق فيه حركة الوجه مع الكلمات المنطوقة بتزامن شفاه دقيق على مستوى الإطار. يتعامل مع الفونيمات المعقدة والنبرة العاطفية بشكل أفضل من معظم البدائل في هذه الفئة.
بالنسبة إلى صنّاع المحتوى الذين يريدون توليد المشهد كاملًا بدلًا من البدء من بورتريه، Veo 3 Fast ينتج فيديو بصوت أصلي وبسرعة، وحركة الفم في الشخصيات المولّدة تتماشى بشكل معقول مع الصوت المحيطي في المشهد.
جماليات البورتريه بالذكاء الاصطناعي تغمر صفحات For You
الجمالية التي استحوذت على الخلاصات
الصور الثابتة تنتشر أيضًا على TikTok هذا الأسبوع، منشورة كعروض شرائح صور مصحوبة بالموسيقى. الأسلوب ثابت بدرجة عالية: درجات بشرة دافئة، وإضاءة طبيعية، وتباين مرتفع قليلًا مع لمسة حبيبات الفيلم. الأشخاص جميلون دائمًا تقريبًا، وغالبًا في الهواء الطلق، وفي ضوء مثالي دائمًا.
هذه بورتريهات بالذكاء الاصطناعي وُلّدت بنماذج تحويل النص إلى صورة، وصيغت بهندسة أوامر مقصودة. الجودة بدقة عالية، عند مشاهدتها بمستوى ضغط TikTok، تبدو للمعظم كتصوير فوتوغرافي احترافي دون أي دليل على كيفية إنتاجها.
💡 نصيحة: لعروض شرائح البورتريه على TikTok، ولّد ما بين 5 و9 صور بالموضوع نفسه واتجاه الإضاءة نفسه وتدرج الألوان نفسه. الاتساق عبر المجموعة يجعل عرض الشرائح يبدو مقصودًا وتحريريًا بدلًا من أن يكون مجموعة عشوائية.
ما الذي يولّده صنّاع المحتوى
فئة تحويل النص إلى صورة على PicassoIA تضم أكثر من 90 نموذجًا، ما يمنح صنّاع المحتوى مدى واسعًا حسب الجمالية التي يريدونها. بالنسبة إلى اتجاه البورتريه الواقعي تحديدًا، النماذج التي تعطي الأولوية لملمس البشرة والإضاءة الطبيعية وحبيبات الفيلم تتفوق على البدائل المنمّطة بفارق كبير.
النمط الأوسع لهذا الأسبوع: يستخدم صنّاع المحتوى نماذج تحويل النص إلى صورة لبناء هوية بصرية حول شخصية مولّدة بالذكاء الاصطناعي، ثم يستخدمون نماذج تحويل الصورة إلى فيديو مثل Wan 2.7 I2V أو Kling v3 Video لتحريك هذه الشخصية عبر منشورات متعددة. تصبح الشخصية حضورًا متكررًا في الحساب، ويتابعها الجمهور كما لو كانوا يتابعون شخصًا حقيقيًا.
كيف تبني محتوى TikTok الخاص بالذكاء الاصطناعي
الخطوة 1: اختر الصيغة أولًا
الصيغة تحدد الأداة التي تحتاجها. كل سير عمل مما يلي ينتج نوعًا مختلفًا من محتوى TikTok:
- أفاتار أو رأس متحدث: ولّد بورتريهًا، ثم حرّكه باستخدام Kling Avatar v2 أو Wan 2.7 I2V
- مقطع مشهد سينمائي: اكتب أمرًا نصيًا مفصّلًا، واستخدم Kling v2.6 أو Veo 3
- فيديو تزامن شفاه: ولّد أو احصل على بورتريه، واستخدم Wan 2.2 S2V
- انتقال تحوّل الوجه: استخدم صورتين مصدريتين مع Wan 2.7 R2V
- عرض شرائح الصور: ولّد سلسلة بورتريهات بأي نموذج تحويل نص إلى صورة على PicassoIA
الخطوة 2: اكتب أوامر تعمل فعلًا
جودة الأمر النصي هي أكبر متغير منفرد في جودة الإخراج. الأوامر الغامضة تنتج نتائج متوسطة بغض النظر عن النموذج الذي تستخدمه. الأوامر المحددة تنتج مخرجات محددة.
سيئ: "امرأة تمشي في مدينة"
أفضل: "امرأة شابة ترتدي معطفًا من الكتان البيج تمشي ببطء في شارع باريسي مبلل بالمطر عند الغسق، وضوء مصباح أصفر دافئ ينعكس على حجارة الرصف المبللة، عمق ميدان ضحل، عدسة 85 ملم، حبيبات فيلم، حركة بطيئة ومقصودة"
النسخة الأفضل تحدد الموقع والطقس ووقت اليوم والملابس ومصدر الإضاءة وتفاصيل الانعكاس واختيار العدسة والملمس. كل تفصيل إضافي يزيل الغموض ويزيد فرصة أن ينتج النموذج شيئًا قريبًا مما تخيلته.
الخطوة 3: فكّر في الصوت قبل التصدير
TikTok منصة صوتية تصادف أن لديها فيديو. أكثر المقاطع المولّدة بالذكاء الاصطناعي مشاركةً هذا الأسبوع كلها تحمل صوتًا يتناسب مع الصورة تمامًا. بالنسبة إلى النماذج التي تملك صوتًا أصليًا مثل Veo 3 و Seedance 1.5 Pro، يُولَّد الصوت إلى جانب الفيديو. أما النماذج التي تنتج مخرجات صامتة، فسير العمل المعتاد هو إضافة مقطع صوتي رائج من TikTok في المحرر المدمج بعد التوليد.
استراتيجية الصوت الرائج بسيطة: اعثر على الأصوات في صفحة "For You" هذا الأسبوع، ولاحظ الإيقاع والمزاج، ثم طابق مرئياتك مع هذه الصفات قبل النشر.
ما الذي يستحق انتباهك فعلًا
أبرز التطورات
ليس كل محتوى فيديو الذكاء الاصطناعي الذي يحقق أداءً جيدًا هذا الأسبوع مثيرًا للإعجاب تقنيًا. بعضه يعتمد على أنماط التفاعل أكثر من الجودة الحقيقية. لكن هناك فئات قليلة تبرز كإشارات حقيقية إلى الاتجاه الذي تسير فيه الأمور:
توليد الصوت الأصلي هو أهم تطور من الناحية العملية. النماذج التي تنتج صوتًا أو موسيقى أو ضوضاء محيطية متزامنة مع الفيديو تزيل أكبر نقطة احتكاك متبقية في إنشاء فيديو الذكاء الاصطناعي. Veo 3 وSeedance 2.0 وWan 2.2 S2V هي أوضح الأمثلة الآن.
دقة 1080p كخيار افتراضي يصبح معيارًا بدلًا من أن يكون استثنائيًا. LTX 2 Pro وKling v3 Omni Video ينتجان بدقة تتحمل ضغط TikTok دون تدهور ملحوظ، وهذا لم يكن صحيحًا بشكل موثوق قبل ستة أشهر.
ثبات الشخص عبر الإطارات تحسّن بشكل كبير. النماذج الأقدم كانت تنحرف بين الإطارات، أي أن وجه الشخصية يتغير بشكل طفيف بطريقة لا يستطيع المشاهدون تسميتها لكنهم يشعرون بها. النماذج الحالية تحافظ على الثبات بشكل أفضل بكثير، ما يجعل المقاطع الأطول والمحتوى القائم على الشخصيات ممكنًا لأول مرة.
ما الذي يستحق الحذر
| الادعاء | الواقع |
|---|
| "حسابات TikTok مؤتمتة بالكامل" | ما زالت تتطلب تكرار الأوامر النصية والتنقيح لكل منشور |
| "الذكاء الاصطناعي يحل محل التصوير تمامًا" | أفضل النتائج ما زالت تجمع الذكاء الاصطناعي مع توجيه إبداعي حقيقي |
| "مطابق للقطات الحقيقية" | قوي في معظم الدقات، وليس مثاليًا في كل الظروف |
| "أمر واحد، ونتيجة رائجة" | الأوامر الجيدة ما زالت تتطلب مهارة ومحاولات متعددة |
جرّبه بنفسك هذا الأسبوع
كل ما في هذا المقال متاح بالفعل. النماذج المذكورة هنا، من Kling v2.6 وVeo 3 إلى Seedance 1.5 Pro و Pixverse v5 وWan 2.7 T2V وHailuo 02، متاحة للتشغيل مباشرة عبر PicassoIA. لا حاجة إلى إعداد. لا مفاتيح API. لا GPU محلي.
الفجوة بين مشاهدة اتجاهات TikTok بالذكاء الاصطناعي وصنعها أصغر مما كانت عليه في أي وقت مضى. أمر نصي جيد، ونموذج يناسب صيغتك، وفهم معقول لأي صوت يناسب المخرجات. هذا هو سير العمل كاملًا. وينجز في عصر يوم واحد.
اختر اتجاهًا واحدًا من هذه القائمة. اكتب أمرًا محددًا بما يكفي لأن يفاجئك. ولّد مقطعًا. انشره. صنّاع الحسابات الأسرع نموًا على TikTok الآن لا ينتظرون تحسّن التقنية. إنهم يستخدمون ما هو موجود اليوم، وما هو موجود اليوم جيد جدًا.
لدى PicassoIA النماذج. الأوامر النصية من كتابتك أنت.


