إن دفع اشتراك شهري في موسيقى خالية من حقوق الملكية، لكنها ما زالت تُعلَّم بتنبيهات حقوق النشر عند الرفع، من أكثر التكاليف المتكررة إحباطًا في صناعة المحتوى. لكن الوضع تغيّر. فقد نضج توليد الموسيقى بالذكاء الاصطناعي بسرعة كافية في 2027 بحيث يمكنك إنتاج أغانٍ أصلية خالية من حقوق الملكية من أمر نصي واحد في أقل من دقيقة، وتوليد تعليقات صوتية بجودة الاستوديو دون توظيف مُعلّق صوتي محترف. الأدوات التالية هي التي تستحق فعلًا أن تدمجها في سير عملك.
لماذا تفشل معظم الصوتيات على YouTube
مشكلة المكتبات الجاهزة
تعتمد مكتبات الموسيقى الجاهزة على فكرة بسيطة: ادفع اشتراكًا شهريًا، واستخدم مقاطعها، وابتعد عن المشاكل مع Content ID. المشكلة أن هذه المقاطع نفسها تُستخدم لدى مئات الآلاف من صنّاع المحتوى الآخرين. ونظام Content ID الخاص بمنصة YouTube لا يكتفي بالإبلاغ عن الاستخدام غير المصرّح به، بل يختلط عليه الأمر أيضًا عندما تظهر بصمة مقطع مرخّص بشكل قانوني بتكرار مفرط. وقد رأيت النتيجة: نزاع على تحقيق الربح من فيديو دفعت ثمن موسيقاه.
المشكلة الأعمق أن الموسيقى الخلفية العامة تجعل قناتك تبدو عامة. فمقطع lo-fi hip-hop متكرر من مكتبة قد يناسب محتوى الدراسة، لكنه لا يبني أي هوية صوتية لعلامتك. والمشاهدون الذين يتابعون عدة فيديوهات من قناتك بمقاطع جاهزة مختلفة يلاحظون التفاوت بشكل لاواعٍ، حتى لو لم يستطيعوا وصفه.
ما الذي يغيّره توليد الذكاء الاصطناعي
لا تأخذ مولّدات الموسيقى بالذكاء الاصطناعي عيّنات من أغانٍ موجودة. بل تُنشئ تأليفات أصلية من الصفر بناءً على وصفك النصي، ما يعني أن المخرجات لا تملك بصمة في أي قاعدة بيانات لـ Content ID. وإلى جانب أمان حقوق النشر، تتيح لك أفضل الأدوات تحديد النوع الموسيقي والإيقاع والمزاج والآلات، وحتى كلمات الأغنية كاملة، لتتلاءم الموسيقى فعلًا مع ما يظهر على الشاشة، بدلًا من أن تكون أقرب تقريب ممكن تجده في مكتبة.
💡 الميزة الحقيقية هي سرعة التكرار. يمكنك توليد عشر نسخ مختلفة من المقطع في الوقت الذي تحتاجه لتصفّح مكتبة جاهزة، ومع ذلك قد لا تجد ما تحتاجه.
التحوّل الآخر يخص التعليقات الصوتية. فالقنوات التي لا تستطيع تحمّل تكلفة مُعلّق صوتي ثابت، أو التي تحتاج إلى توسيع السرد الصوتي على حجم كبير من المحتوى، يمكنها الآن إنتاج صوت بجودة الاستوديو دون جلسات تسجيل. وقد تقلّصت الفجوة بين ما يستطيع صانع محتوى منفرد إنتاجه وما يقدّمه فريق إنتاج بشكل كبير.
أفضل مولّدات الموسيقى بالذكاء الاصطناعي الآن
MiniMax Music 2.6
MiniMax Music 2.6 هو الخيار الأقوى بشكل عام لصنّاع المحتوى على YouTube الآن. يولّد أغانٍ كاملة بالغناء أو الآلات الموسيقية أو كليهما من أمر نصي. ومعالجته للكلمات قوية بشكل خاص: الصق كلماتك الخاصة، وسيجد النموذج لحنًا وأسلوبًا صوتيًا يناسب الكلمات بدلًا من فرضها على قالب عام.
ما يميّزه عن المولّدات الأقدم هو الاتساق العاطفي عبر المقطع كاملًا. كانت النماذج السابقة تُتقن المقدمة، ثم تنحرف عن النوع الموسيقي بحلول المنتصف. أما Music 2.6 فيحافظ على المزاج المحدد والتوزيع الموسيقي حتى النهاية، وهذا مهم جدًا عندما يمتد الفيديو خمس عشرة دقيقة ويجب أن تبقى الموسيقى الخلفية متسقة.
الأنسب لـ: موسيقى المقدمة والخاتمة الخاصة بالعلامة التجارية، والمقاطع الخلفية الكاملة، والمحتوى الذي يكون فيه الاتساق في المزاج مهمًا عبر فيديو طويل.
Google Lyria 3 Pro
Google Lyria 3 Pro هو نموذج توليد الموسيقى الرئيسي من Google. جودة الصوت فيه أعلى بوضوح من معظم البدائل، مع فصل نظيف للآلات ونطاق ديناميكي واقعي. تُوسّع النسخة Pro النموذج Lyria 3 القياسي بمدة توليد أطول وتحكم أدق في التوزيع.
بالنسبة إلى محتوى السفر أو الوثائقيات أو المحتوى السينمائي على YouTube، حيث تحتاج الموسيقى إلى أن تبدو منتجة بعناية، يقدّم Lyria 3 Pro نتائج لا تبدو مولّدة آليًا عند الاستماع الأول. المخرجات الأوركسترالية والأكوستيكية مقنعة بشكل خاص. ويظل Google Lyria 2 خيارًا جيدًا للمقاطع القصيرة والاستخدامات الأخف حيث لا تكون المدة الممتدة لمستوى Pro ضرورية.
الأنسب لـ: القنوات السينمائية، ومدوّنو الفيديو في السفر، والمحتوى على طراز الوثائقيات، وأي محتوى تكون فيه قيمة الإنتاج الصوتي جزءًا من هوية القناة.
Stable Audio 2.5
Stable Audio 2.5 من Stability AI يتبنى نهجًا مختلفًا عن مولّدات الأغاني. يتفوّق في تصميم الصوت والصوت الخلفي القابل للتكرار، ما يجعله مثاليًا للمحررين الذين يحتاجون إلى مقاطع تنقطع بسلاسة عند تغيّر المشهد. فكّر في الأجواء الصوتية المحيطة، وقواعد التوتر المتصاعد، والمقاطع الصوتية القصيرة بدلًا من التأليفات الكاملة.
التحكم بالأمر النصي دقيق بشكل استثنائي. يمكنك تحديد BPM والمقام الموسيقي والتوزيع الآلي باللغة الطبيعية، ويستجيب النموذج لهذه المعايير بموثوقية. وسيجد المحرر ذو الخبرة هذه الأداة أكثر فائدة من مولّد الأغاني الكاملة في مشاريع متعددة المشاهد ومعقدة.
الأنسب لـ: محررو الفيديو الذين يُراكبون عدة مسارات صوتية، وصنّاع المحتوى الذين يحتاجون مقاطع أجوائية قصيرة بدلًا من مقاطع كاملة.
ElevenLabs Music
ElevenLabs Music ينقل سمعة ElevenLabs في جودة الصوت إلى توليد الموسيقى. النموذج قوي في مطابقة النبرة العاطفية: صِف شعورًا بدلًا من نوع موسيقي، وسيفسّر النية بدقة. فالأمر النصي مثل "ترقّب عصبي يتصاعد نحو لحظة كشف" ينتج شيئًا يلتقط ذلك التوتر، بدلًا من الاكتفاء بمقطع تشويق عام.
MiniMax Music 2.5 خيار قوي آخر لتوليد الأغاني الكاملة بأصوات بشرية، ويناسب بشكل خاص صنّاع المحتوى الذين يريدون تعديل فكرة الأغنية تدريجيًا بتعديلات متزايدة على الأمر النصي قبل الاعتماد عليها.
الأنسب لـ: قنوات السرد القصصي، والفيديوهات على شكل المقالات، والمحتوى الذي يهم فيه القوس العاطفي أكثر من تصنيفات النوع الموسيقي.
MiniMax Song Restyle
نموذج MiniMax لإعادة تصميم الأغاني يعمل بطريقة مختلفة عن غيره. فبدلًا من التوليد من الصفر، يأخذ أغنية موجودة وينقلها إلى نوع موسيقي مختلف. تمنحه مقطعًا وتحدد أسلوبًا أكوستيكيًا أو أوركستراليًا أو هيب هوب أو أسلوبًا آخر، فينتج نسخة محوّلة بهوية صوتية جديدة.
هذا مفيد لصنّاع المحتوى الذين يريدون نشر لمستهم الخاصة على صوت رائج دون مخاطر حقوق النشر الناتجة عن استخدام الأصل. والمخرج صوت أصلي لا يحمل أي بصمة من المادة المصدر.
الأنسب لـ: قنوات ردود الفعل، ومحتوى الريمكس، والصنّاع الذين يريدون نسخًا بنوع موسيقي مختلف من مقاطع رائجة.
أفضل أدوات الصوت بالذكاء الاصطناعي لتعليقات YouTube الصوتية
الموسيقى الجيدة ليست سوى نصف معادلة الصوت. إذا جاء التعليق الصوتي باهتًا أو آليًا، فإنه يُضعف كل ما سواه في الإنتاج. هذه أدوات تحويل النص إلى كلام بالذكاء الاصطناعي التي تقدّم نتائج جيدة بما يكفي لاستخدامها في محتوى YouTube المنشور.
MiniMax Speech 2.8 HD
MiniMax Speech 2.8 HD هو أقرب شيء إلى صوت مسجّل في استوديو متاح من أي أداة ذكاء اصطناعي الآن. النبرة والتنفس والتنوع العاطفي مُحاكاة بإتقان يكفي لأن تبدو المقاطع القصيرة كأنها مسجّلة بصوت بشري في كثير من الأحيان. بالنسبة إلى YouTube، هذه هي أداة الصوت التي ينبغي استخدامها عندما تحتاج إلى راوٍ ثابت عبر سلسلة طويلة دون حجز وقت في استوديو.
النسخة Speech 2.8 Turbo تنتج عمليات تصيير أسرع مع دقة أقل قليلًا في الحد الأعلى، وهذا تنازل مقبول في معاينات المسودات أو خطوط إنتاج المحتوى الكثيف حيث تكون السرعة أهم من الجودة القصوى.
الأنسب لـ: القنوات التي تعتمد على السرد، ومحتوى الوثائقيات، والسلاسل التعليمية التي تحتاج مخرجات صوتية ثابتة.
ElevenLabs V3
ElevenLabs V3 هو أكثر نموذج تحويل نص إلى كلام تعبيرًا بين النماذج المستخدمة على نطاق واسع. والفرق عن الإصدارات السابقة يظهر أوضح ما يكون في طريقة تعامله مع علامات الترقيم والتأكيد: فهو لا يقرأ النص فحسب، بل يؤدّيه. فالسخرية والحماس والتردد تنتقل إلى الصوت بطرق لم تستطع الأدوات السابقة إتقانها بإقناع.
يمدّ نموذج ElevenLabs v2 Multilingual هذه الجودة عبر أكثر من 30 لغة للقنوات الدولية. ويتكامل استنساخ الصوت جيدًا مع MiniMax Voice Cloning، الذي يتيح لك تسجيل عيّنة قصيرة من صوتك وتوليد سرد لا نهائي بذلك الصوت دون تسجيل كل سطر يدويًا.
الأنسب لـ: القنوات ذات الشخصية القوية للمقدّم، ومحتوى الترفيه المكتوب مسبقًا، والصنّاع الذين يريدون توسيع نطاق صوتهم الخاص.
Google Gemini 3.1 Flash TTS
Google Gemini 3.1 Flash TTS يقدّم 30 صوتًا مختلفًا عبر أكثر من 70 لغة. وبالنسبة إلى صنّاع المحتوى الذين يستهدفون جمهورًا دوليًا أو يديرون قنوات متعددة اللغات، فهذه قدرة مهمة. وتبقى جودة الصوت ثابتة عبر اللغات، وهو ما لا ينطبق على معظم أدوات تحويل النص إلى كلام متعددة اللغات.
كما يتعامل مع التبديل بين اللغات، أي انتقال المتحدث بين لغتين في منتصف الجملة، بشكل أفضل من أي نموذج منافس. وإذا كان جمهورك يمتد عبر أسواق لغوية متعددة، فهذا هو الخيار العملي.
الأنسب لـ: القنوات الدولية، والمحتوى متعدد اللغات، وصنّاع المحتوى الذين يبنون جمهورًا في أسواق لغوية متعددة.
Qwen3 TTS
يتميز Qwen3 TTS بمرونة في تصميم الصوت. فبدلًا من الاختيار من مكتبة إعدادات مسبقة ثابتة، تصف خصائص الصوت التي تريدها، فينتج النموذج صوتًا مخصصًا يطابقها. طبقة صوت أعمق، وإيقاع أسرع، ونبرة أكثر سلطة: كل ذلك يمكن تحديده باللغة الطبيعية بدلًا من التحكم عبر المنزلقات.
هذه هي الأداة المناسبة لبناء العلامة التجارية للقناة على مستوى الصوت. فتحصل قناتك على صوت يخصّها بدلًا من صوت يشاركه كل من اختار الإعداد المسبق نفسه.
الأنسب لـ: القنوات التي تبني هوية صوتية مميزة، والصنّاع الذين يريدون صوتًا مصمَّمًا خصيصًا لا يستخدمه أي منافس.
Resemble AI Chatterbox Pro
يركّز Resemble AI Chatterbox Pro على التحكم في التعبير العاطفي لكل جملة. يمكنك تحديد حالات عاطفية مختلفة لجمل مختلفة داخل المقطع نفسه، فيبدو الراوي متفاعلًا فعلًا بدلًا من قراءة النص بنبرة مسطحة. وPlayHT Play Dialog خيار قوي آخر للمحتوى الحواري كثيف الحوار، حيث يحتاج صوتان إلى التفاعل بشكل طبيعي.
تعمل النسخة Chatterbox Turbo بسرعة أعلى للحالات التي تكون فيها إنتاجية التوليد أهم من التعبير الأقصى. وكلاهما متاح على PicassoIA.
الأنسب لـ: قنوات الترفيه، ومحتوى السرد القصصي، وصنّاع المحتوى الذين يكتبون مادة متنوعة عاطفيًا.
كتابة أوامر نصية تحقق نتائج حقيقية
لا تتجاوز جودة الأدوات أعلاه جودة الأوامر النصية التي تعطيها إياها. فالأوامر العامة تُنتج نتائج عامة.
أوامر موسيقية تنجح
عامة أكثر من اللازم: "موسيقى حماسية لفيديو على YouTube"
محددة بما يكفي: "جيتار أكوستيكي حماسي بلحن مقروص بالأصابع، وإيقاع خفيف على الطبل البونغو، 118 BPM، نبرة دافئة ومتفائلة، بدون أصوات بشرية، مدة 90 ثانية، تتلاشى في آخر 10 ثوانٍ"
التحديد لا يقتصر على الحصول على صوت أفضل. بل على الحصول على صوت متسق عبر سلسلة كاملة. فإذا حفظت الأمر النصي الدقيق، يمكنك إعادة توليد مقطع بطابع مشابه للفيديو التالي في السلسلة، فتبني تناغمًا صوتيًا عبر قناتك.
مع MiniMax Music 2.6 وGoogle Lyria 3 Pro، تنتج الأوصاف مثل "بيانو كهربائي Fender Rhodes"، أو "طقم طبول بفرشاة"، أو "أربيجيوات تشيللو في المجال العالي" نتائج أدق بوضوح من أسماء الأنواع الموسيقية وحدها.
💡 احفظ أفضل أوامرك النصية: أنشئ مكتبة شخصية للأوامر مرتبة حسب المزاج ونطاق BPM. إعادة استخدام الأوامر المصقولة هي أسرع طريقة للحفاظ على هوية صوتية متسقة في قناتك.
أوامر صوتية تنجح
في تحويل النص إلى كلام، يكون الأمر النصي هو السيناريو نفسه. لكن طريقة كتابة السيناريو تؤثر بشكل كبير على جودة المخرج. الجمل القصيرة ذات علامات الترقيم الطبيعية تنتج إيقاعًا أفضل من التراكيب الطويلة والمعقدة.
💡 نصيحة لتحويل النص إلى كلام: أضف فاصلة في أي موضع تريد فيه أن يتوقف الذكاء الاصطناعي بشكل طبيعي. وأضف نقطة حيث تريد توقفًا تامًا. تجنّب الجمل الاعتراضية بين أقواس، فمعظم نماذج تحويل النص إلى كلام لا تعالجها بسلاسة وستُسطّح القراءة.
مع ElevenLabs V3 وResemble AI Chatterbox Pro، يمكنك إضافة وسوم عاطفية أو تحديد إعدادات عاطفية لكل جملة، لجعل الراوي يبدو متحمسًا فعلًا للحظة كشف، لا مجرد أعلى صوتًا قليلًا.
كيفية توليد الصوت على PicassoIA
تتيح لك PicassoIA الوصول إلى كل النماذج أعلاه دون إدارة عدة اشتراكات أو التنقل بين منصات مختلفة.
توليد مقطع باستخدام MiniMax Music 2.6
- انتقل إلى MiniMax Music 2.6 على PicassoIA.
- اكتب أمرًا نصيًا محددًا: المزاج، والإيقاع، والآلات، وتفضيل الصوت، والمدة.
- إذا كانت لديك كلمات تريد غناءها، فالصقها في حقل الكلمات.
- وَلِّد الملف الصوتي ونزّله فورًا.
- إذا لم تكن النتيجة الأولى مناسبة، فحسّن الأمر النصي بدلًا من إعادة توليد الأمر نفسه. أسماء الآلات الأكثر تحديدًا وقيم BPM تحقق تحسنًا أسرع من تغيير أسماء الأنواع الموسيقية.
إضافة تعليق صوتي باستخدام Speech 2.8 HD
- انتقل إلى MiniMax Speech 2.8 HD.
- الصق السيناريو مع فواصل فقرات طبيعية للحصول على إيقاع أفضل في المخرج.
- اختر صوتًا من الإعدادات المسبقة، أو استخدم MiniMax Voice Cloning مع عيّنة قصيرة من صوتك لتوليد سرد يشبه صوتك.
- نزّل الصوت وضعه فوق مسار الموسيقى في المحرر، مع بقاء الصوت واضحًا فوق الموسيقى الخلفية.
💡 نصيحة سير العمل: وَلِّد التعليق الصوتي أولًا، ثم أنشئ موسيقى تتناسب مع إيقاعه الطبيعي. يجب أن يحدد الصوت مستوى الطاقة في الموسيقى الخلفية، لا أن ينافسها.
موسيقى الذكاء الاصطناعي مقابل اشتراكات الموسيقى الخالية من حقوق الملكية
| العامل | توليد موسيقى الذكاء الاصطناعي | اشتراك الموسيقى الخالية من حقوق الملكية |
|---|
| مخاطر حقوق النشر | لا يوجد (مخرج أصلي) | منخفضة لكنها ليست صفرًا |
| تنوع الصوت | تنويعات غير محدودة | مكتبة ثابتة |
| التخصيص | تحكم كامل عبر الأمر النصي | محدود (فلتر BPM، وسوم الأنواع) |
| تميّز العلامة | عالٍ | منخفض (المقاطع نفسها تُستخدم من آلاف) |
| المقاطع الغنائية | نعم، بكلمات مخصصة | غالبًا آلية فقط |
| أمان Content ID | بصمة نظيفة 100% | تنبيهات خاطئة أحيانًا |
| سرعة التكرار | 1 إلى 2 دقيقة لكل مقطع | أكثر من 20 دقيقة للتصفح |
تتغيّر الحسابات بسرعة عندما تحسب وقت التصفح. فتوليد مقطع يناسب مشهدك المحدد يستغرق نحو دقيقتين. أما إيجاد مقطع قريب بما يكفي في مكتبة جاهزة فيستغرق غالبًا وقتًا أطول بكثير، وقد لا تجد بالضبط ما تحتاجه.
بالنسبة للقنوات كثيفة الإنتاج التي تنشر ثلاثة فيديوهات أو أكثر في الأسبوع، يُنتج توليد موسيقى الذكاء الاصطناعي هوية صوتية أكثر اتساقًا، لأنك تستطيع طلب طابع متشابه في كل فيديو بدلًا من التقاط مقاطع مختلفة تصادف أن تشترك في تسمية النوع نفسها.
أي أداة تناسب قناتك؟
القنوات عالية الإنتاج
تحتاج إلى السرعة والاتساق قبل أي شيء آخر. فـMiniMax Music 2.6 للمقاطع الخلفية وElevenLabs Flash v2.5 لتصيير التعليقات الصوتية يغطيان معظم الحالات دون الوقوع في طوابير توليد بطيئة. وكلاهما محسَّن للإنتاجية.
قنوات الوثائقيات والمقالات
تهم جودة الصوت والملاءمة العاطفية أكثر من السرعة. فـGoogle Lyria 3 Pro للموسيقى التصويرية وElevenLabs V3 للسرد سينتجان نتائج تصمد أمام المحتوى المنتج باحترافية دون الحاجة إلى فريق إنتاج كامل.
القنوات متعددة اللغات
Google Gemini 3.1 Flash TTS مع دعمه لأكثر من 70 لغة هو الخيار العملي. فتشغيل أدوات تحويل نص إلى كلام منفصلة لكل لغة يخلق تفاوتًا في جودة الصوت. أما النموذج الواحد المدرَّب عبر لغات متعددة فينتج مخرجات أكثر تماسكًا عبر كل نسخك المحلية.
بالنسبة للموسيقى في السياقات متعددة اللغات، ينتج ElevenLabs Music وGoogle Lyria 3 مقاطع آلية لا تحمل الارتباطات الثقافية لتقاليد البوب في أي لغة بعينها، ما يجعلها أسهل انتشارًا عبر الجماهير الدولية.
القنوات ذات العلامة المميزة التي تبني هوية خاصة
استخدم Qwen3 TTS لتصميم الصوت، وStable Audio 2.5 للمشاهد الصوتية المحيطة. تتيح لك هذه الأدوات بناء الحمض النووي الصوتي لقناتك بدلًا من الاقتراض من قالب مشترك يستخدمه آلاف الصنّاع الآخرين.
جودة الصوت أصبحت عاملًا تنافسيًا
قبل ثلاث سنوات، كانت أي موسيقى خلفية لفيديو على YouTube أفضل من الصمت، وكان أي تعليق صوتي مقبولًا ما دام واضحًا. وقد تغيّر هذا المعيار. بات الجمهور معتادًا على صوت عالي الجودة إلى حد أن مقطعًا جاهزًا رخيصًا أو صوتًا آليًا مسطحًا يبدو فورًا كأنه إنتاج منخفض القيمة، غالبًا قبل أن يدرك المشاهد بوعي سبب فقدانه للاهتمام.
تُزيل الأدوات في هذا المقال عامل التكلفة كعائق. فـGoogle Lyria 3 Pro ينتج موسيقى بمستوى كان يتطلب في السابق عازفًا محترفًا في جلسة تسجيل. وMiniMax Speech 2.8 HD يولّد سردًا يبدو كأن مُعلّقًا صوتيًا محترفًا سجّله في كابينة معالجة. وقد تقلّصت الفجوة بين ما يستطيع صانع المحتوى المنفرد تحقيقه وما يقدّمه فريق إنتاج كامل إلى حد أن الفرق كثيرًا ما يعود إلى المونتاج، لا إلى جودة الصوت الأصلي.
💡 ما يعنيه هذا عمليًا: يمكنك المنافسة في جودة الصوت دون ميزانية. التمايز اليوم يكمن في مدى عنايتك بكتابة أوامرك النصية لهذه الأدوات، ومدى دقة مزج المخرجات في محررك.
القنوات التي تحقق نتائج حقيقية من الصوت بالذكاء الاصطناعي الآن ليست تلك التي تملك أكثر الإعدادات تعقيدًا. بل هي التي اختارت أداتين أو ثلاث تناسب سير عملها المحدد، وبنت عادات متسقة في استخدامها، وتحتفظ بمكتبات أوامر نصية لتكرار نتائج مشابهة عبر سلسلة كاملة.
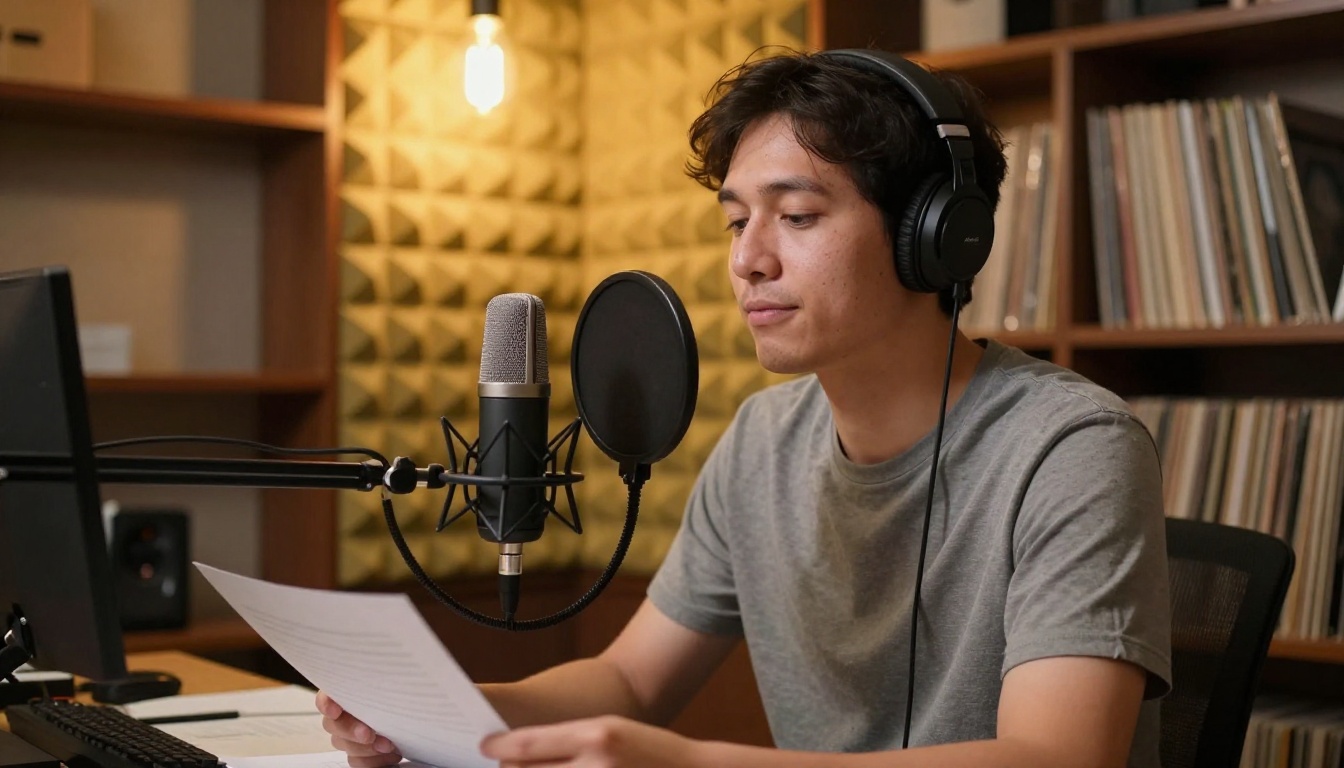
ابدأ في بناء صوتك
كل أداة في هذا المقال متاحة على PicassoIA دون إدارة اشتراكات أو حسابات منفصلة. يمكنك توليد مقطع خلفي باستخدام MiniMax Music 2.6، وإنتاج سرد بصوتك المستنسخ باستخدام MiniMax Voice Cloning، وإعادة تصميم مقطع رائج باستخدام نموذج MiniMax لإعادة تصميم الأغاني، كل ذلك في الجلسة نفسها.
لا تحتاج الموسيقى والصوت لفيديوهك القادم إلى مكتبة جاهزة أو جلسة تسجيل. يمكن أن يأتيا من أمر نصي يصف بدقة كيف يبدو محتواك في أفضل حالاته. ولّده، ومزجه، وانشر فيديو يبدو وكأن وراءه ميزانية إنتاج حقيقية.
جرّب PicassoIA وابنِ الهوية الصوتية التي تستحقها قناتك.


