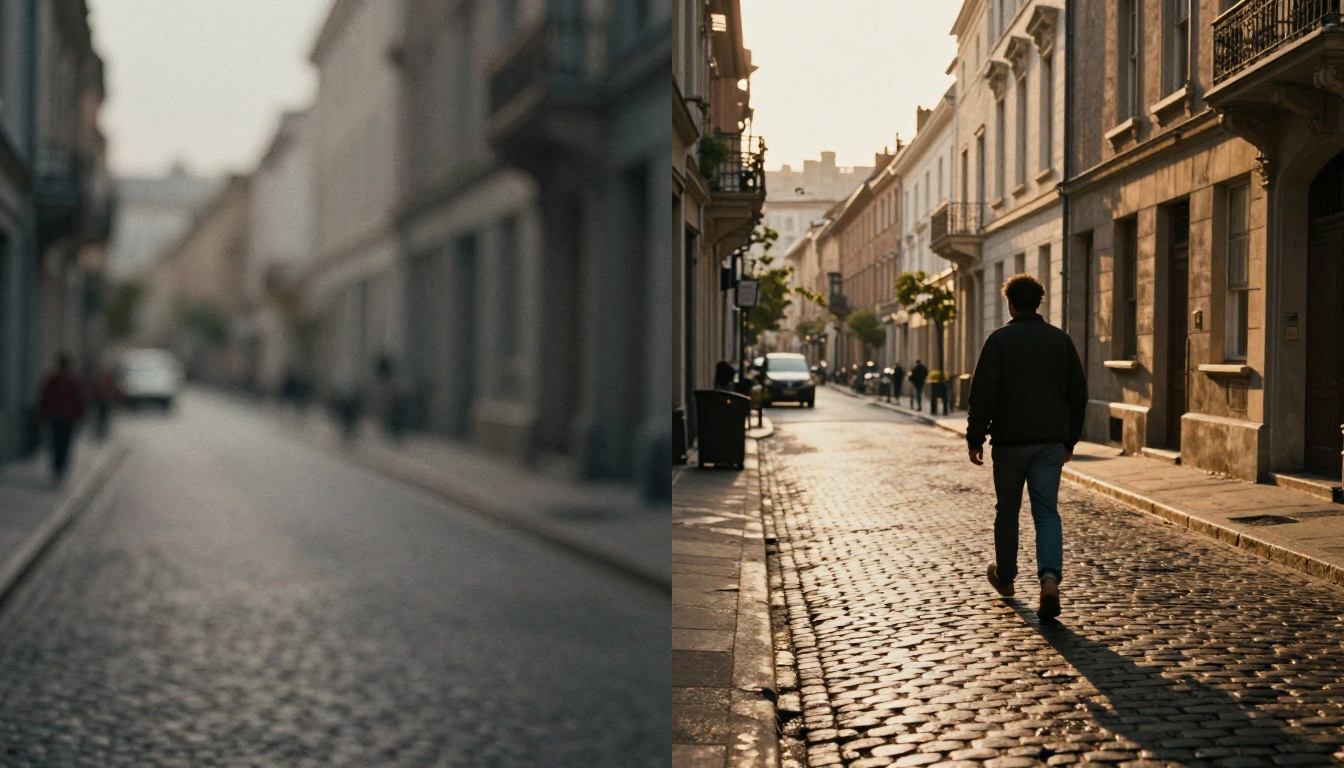
لماذا تبدو فيديوهات الذكاء الاصطناعي الخاصة بك مملّة (وما الخطأ الذي ترتكبه)
إذا بدت فيديوهات الذكاء الاصطناعي التي تنتجها بلا روح وسهلة النسيان، فالمشكلة ليست في الأداة، بل في المدخلات. يشرح هذا المقال كل سبب يجعل فيديوهات الذكاء الاصطناعي تبدو مملّة، بدءًا من الأوامر النصية الغامضة وغياب توجيه الكاميرا، مرورًا بالإضاءة المسطحة واختيار النموذج الخاطئ، مع حلول محددة يمكنك تطبيقها فورًا لإنتاج لقطات سينمائية وجذابة.
كتبتَ أمرًا نصيًا. شغّل النموذج. عاد الفيديو. وهو لا يبدو شيئًا. مسطّح. جامد. كشريحة PowerPoint نسي أحدهم تحريكها. إذا كنت تضغط على "توليد" وتشعر بخيبة أمل، فالمشكلة على الأرجح ليست في النموذج أو المنصة أو جهازك. المشكلة في ما تطلبه. يشرح هذا المقال كل سبب يجعل فيديوهات الذكاء الاصطناعي تبدو مملّة، ويوضح لك بالتحديد كيف تصلح كل واحد منها.
المشكلة الحقيقية ليست في النموذج
الحقيقة المزعجة هي أن معظم من يلومون أداة الفيديو بالذكاء الاصطناعي يكتبون أوامر من خمس كلمات، ثم يتوقعون مخرجات بمستوى الأفلام الروائية. نماذج مثل Kling v3 وVeo 3 وWan 2.7 T2V قادرة بشكل استثنائي. يمكنها إنتاج لقطات تبدو كأنها كلّفت آلاف الدولارات. لكنها تحتاج إلى تفاصيل تعمل عليها.
النموذج ليس "سيئًا". إنه ينفّذ بالضبط الطلب الذي أعطيته له. الطلب فقط كان فارغًا.
ماذا يعني "مملّ" فعليًا
عندما يقول الناس إن فيديو الذكاء الاصطناعي الخاص بهم مملّ، فغالبًا ما يقصدون واحدًا أو أكثر من هذه الأمور:
لا توجد حركة: الأشخاص يقفون جامدين كالتماثيل
إضاءة مسطحة: كل شيء مضاء بالدرجة نفسها دون ظلال أو عمق
لا توجد أجواء: خلفيات معقمة بلا ملمس ولا بيئة
تأطير عادي: أشخاص في منتصف الكادر تمامًا وبلا تكوين سينمائي
لا يوجد توتر درامي: لا شيء يحدث، ولا سبب للاستمرار في المشاهدة
كل واحد من هذه الأمور يرتبط مباشرة بشيء ناقص في أمرك النصي. لنمر عليها واحدًا تلو الآخر.
كل شيء يبدأ من الأمر النصي
الأمر النصي ليس استعلام بحث. إنه موجز إبداعي لمصوّر سينمائي ومصمم ديكور ومدير إضاءة ومشغّل كاميرا، كل ذلك في الوقت نفسه. معاملته كبحث في Google هو أكبر خطأ يرتكبه المبتدئون.
أوامرك النصية غامضة أكثر من اللازم
الأوامر النصية الغامضة تنتج فيديوهات غامضة. هذا ليس عيبًا في النظام، بل علاقة سبب بنتيجة. النموذج يملأ المعلومات الناقصة بأكثر أمثلة التدريب "متوسطًا"، والمتوسطات، بحكم تعريفها تقريبًا، لا تلفت النظر.
فخ الأمر العام
قارن بين هذين الأمرين:
أمر ضعيف
أمر قوي
"امرأة تمشي في مدينة"
"امرأة ترتدي معطفًا مطريًا أحمر تسير بخطى سريعة في شارع طوكيوي مبلل بالمطر عند منتصف الليل، وانعكاسات النيون ترقص على الرصيف الرطب، ضباب خفيف، تُصوَّر من أسفل قليلًا، عدسة 85 ملم، عمق ميداني ضحل"
"رجل على الشاطئ"
"راكب أمواج في الأربعينيات (40s) من عمره، وجه أنهكته الشمس، يجلس وحده عند الفجر على شاطئ المحيط الهادئ تغطيه الضبابة، يراقب الأمواج، يُصوَّر من الخلف عند مستوى الأرض، عدسة واسعة، ضوء ذهبي قبل الشروق يأتي من الأفق الأيمن"
"قطة على طاولة"
"قطة مين كون كبيرة بعينين كهرمانيتين تجلس على طاولة خشبية ريفية في مطبخ مزرعة، ضوء شمس بعد الظهر يتسلل عبر نافذة نصف مفتوحة، جزيئات غبار في الهواء، لقطة مقربة، عدسة 50 ملم"
العمود الأيسر ينتج فيديوهات مملّة. أما العمود الأيمن فيمنح النموذج مشهدًا بصريًا كاملًا يعمل عليه.
كيف تضيف التحديد
كل أمر نصي قوي لفيديو يحتاج إلى خمس طبقات:
الشخص أو الشيء: من أو ما هو. أضف العمر والمظهر والملابس والتعبير.
الحركة: ماذا يفعل. ليس "يمشي" بل "يتحرك بخطى مستعجلة، ويلقي نظرة إلى الخلف عبر كتفه".
البيئة: أين. ليس "مدينة" بل "زقاق ضيق من حجارة مرصوفة في روما، جدران حجرية من العصور الوسطى، ملابس معلّقة فوق الرؤوس".
الإضاءة: كيف يُضاء المشهد. الاتجاه ودرجة حرارة اللون وطبيعة الضوء (قاسٍ، ناعم، منتشر، حاد).
الكاميرا: الزاوية والعدسة والمسافة والحركة.
إذا أغفلت أيًا من هذه الطبقات الخمس، ستحصل على نتيجة مسطحة.
غياب الحركة وتوجيه الكاميرا
غالبًا ما يكون هذا أكثر سبب شيوعًا لظهور فيديوهات الذكاء الاصطناعي ثابتة وباهتة. معظم الأوامر تصف مشهدًا لكنها لا تخبر النموذج كيف يجب أن يتحرك المشهد. نماذج الفيديو بالذكاء الاصطناعي لا تملأ إطارًا فقط، بل تولّد حركة عبر الزمن. إذا لم توجّه هذه الحركة، يلجأ النموذج إلى أقل قدر ممكن منها.
الأوامر الثابتة مقابل الديناميكية
أمر ثابت: "غابة بأشجار وضوء شمس."
أمر ديناميكي: "الكاميرا تدفع ببطء إلى الأمام عبر غابة قديمة كثيفة عند الفجر، وضباب الصباح ينجرف بين جذوع أشجار قديمة مغطاة بالطحالب، وأشعة ذهبية تتسلل عبر المظلة الخضراء، والأوراق تحفّ بلطف في نسمة هواء خفيفة."
الأمر الثاني يصف الحركة على كل المستويات: حركة الكاميرا (دفع بطيء إلى الأمام)، والحركة البيئية (انجراف الضباب، حفيف الأوراق)، والتغير الجوي (تسلل الضوء وتحوله). النموذج يملك الآن لغة حركة يعمل بها.
كلمات حركة الكاميرا المجدية
استخدم أوصاف حركة الكاميرا هذه في أوامرك النصية:
Dolly in (اقتراب): "الكاميرا تدفع ببطء نحو..."
Pull back reveal (ابتعاد يكشف): "الكاميرا تبتعد لتكشف..."
Pan (مسح أفقي): "مسح أفقي بطيء عبر..."
Tilt up (ميل للأعلى): "الكاميرا تميل إلى الأعلى لتكشف السماء..."
Orbit (دوران حول الهدف): "الكاميرا تدور ببطء حول الشخص..."
Crane rise (صعود بالرافعة): "الكاميرا ترتفع من مستوى الأرض إلى ارتفاع جوي..."
نماذج مثل Kling v3 Motion Control وKling v2.6 Motion Control تذهب أبعد من ذلك، إذ تتيح لك تحديد مسارات كاميرا دقيقة عبر واجهة مرئية. إذا كنت تريد حركة كاميرا مثالية إطارًا بإطار، فهذه النماذج مصممة لذلك تحديدًا.
💡 نصيحة احترافية: حركة الشخص وحركة الكاميرا أمران مختلفان. صِف الاثنين. "امرأة تركض تحت المطر" (الشخص) مع "الكاميرا تتبعها على مستوى الكتف، وضبابية حركة خفيفة" (الكاميرا) يساويان مشهدًا يحمل طاقة سينمائية حقيقية.
الإضاءة المسطحة تفسد كل شيء
الإضاءة هي أقوى عنصر في التصوير السينمائي على الإطلاق. المشهد المصوّر بإضاءة مسطحة وغير موجّهة يبدو هاويًا مهما كان محتواه. المشهد نفسه المصوّر بإضاءة موجّهة وجوية يبدو باهظ الثمن. هذا صحيح مع الكاميرات الحقيقية، وهو صحيح تمامًا مع نماذج الفيديو بالذكاء الاصطناعي.
لماذا تهم أوصاف الإضاءة
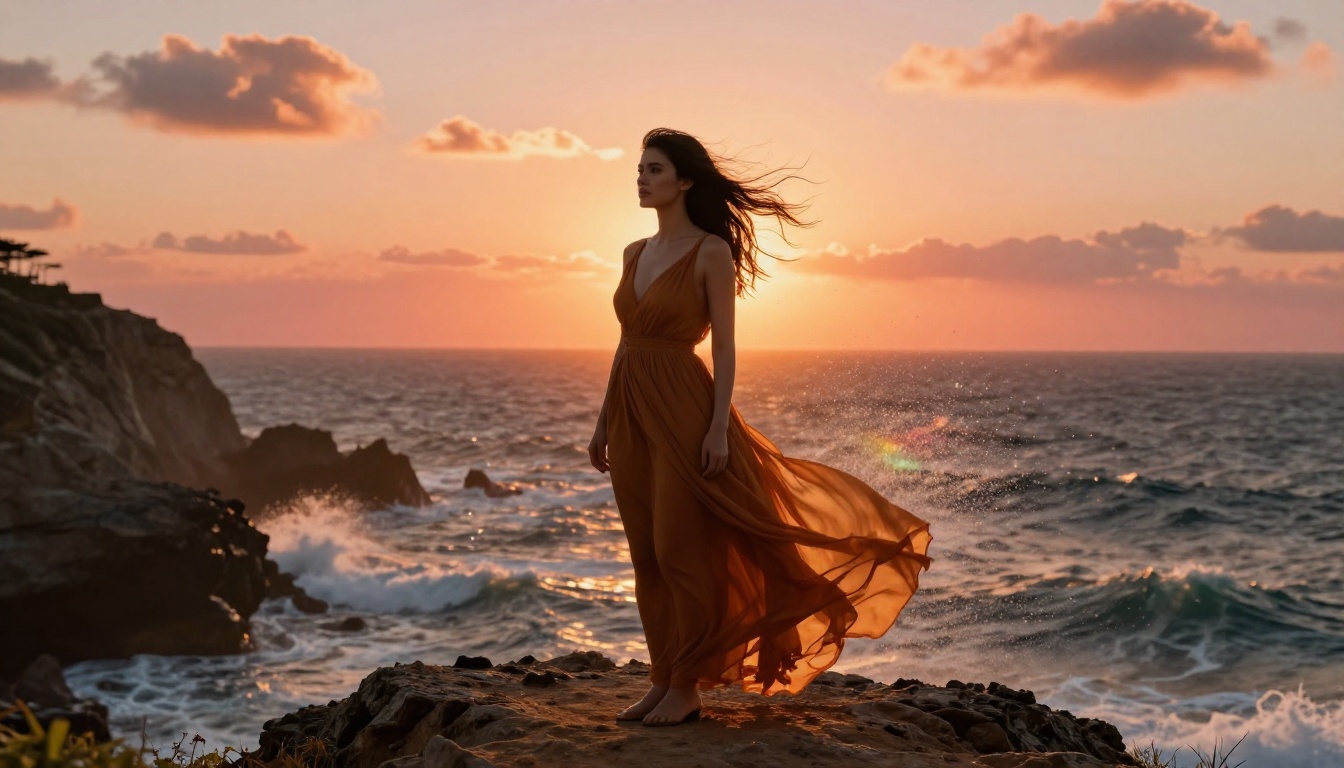
معظم الناس يكتبون أوامر تصف الأشخاص بمعزل عن الضوء. يكتبون "امرأة ترتدي فستانًا أحمر" بينما كان ينبغي أن يكتبوا "امرأة ترتدي فستانًا أحمر، مضاءة من اليسار بضوء شمس دافئ بعد الظهر يلقي ظلًا طويلًا نحو اليمين، إضاءة تعبئة ناعمة من عاكس على الجانب الأيمن، وضوء شعر خفيف يفصلها عن الخلفية الداكنة."
النسخة الثانية تمنح النموذج إعداد إضاءة ثلاثية النقاط بلغة بسيطة. ستبدو المخرجات كأنها أُضيئت باحتراف.
3 إعدادات إضاءة تبرز في الفيديو
إضاءة جانبية في الساعة الذهبية: "شمس بعد الظهر المتأخرة بزاوية 30 درجة عن المحور، ضوء كهرماني دافئ، ظلال طويلة، وهج عدسة خفيف." هذا يخلق دفئًا وعمقًا فوريين.
ضوء نافذة داخلي: "ضوء موجّه ناعم من نافذة كبيرة على اليسار، وتدرّج لطيف نحو الجانب الأيمن، تعبئة محيطة داخلية، لمعات ساطعة على الحواف المواجهة للنافذة." نظيف وطبيعي وسينمائي.
💡 أضف درجة حرارة اللون: "تنغستن دافئ 3200 كلفن" مقابل "ضوء نهار بارد 6500 كلفن" مقابل "ضوء الساعة السحرية 4500 كلفن". النماذج تستجيب لهذه التفاصيل، ويظهر ذلك في تدرّج الألوان وسلوك الظلال في الفيديو الناتج.
النموذج الخاطئ للعمل الخطأ
ليس كل نموذج فيديو بالذكاء الاصطناعي ينتج النوع نفسه من اللقطات. استخدام نموذج مصمم للقطات الوثائقية الواقعية لإنتاج تسلسل حركي أسلوبي، أو العكس، سيؤدي دائمًا إلى نتائج مخيبة. اختيار النموذج جزء من العملية الإبداعية.
طابق النموذج مع المحتوى
إليك تفصيلًا سريعًا لما تبدو عليه نقاط قوة النماذج المختلفة عمليًا:
إذا كنت تنتج محتوى يجب أن يبدو كفيلم حقيقي، فإن Kling v3 يقدم باستمرار فيزياء حركة أكثر قابلية للتصديق سينمائيًا واستجابة أفضل للإضاءة. محرك الفيزياء فيه يتعامل مع حركة الأقمشة وديناميكية الشعر ومحاكاة الماء بطريقة لا تستطيع النماذج الأخف مجاراتها.
أما في إنتاج المحتوى بكميات كبيرة حيث تكون سرعة التكرار مهمة، فإن Seedance 1.5 Pro من أسرع الخيارات التي لا تضحّي بالجودة البصرية بدقة 1080p.
وإذا كانت نقطة انطلاقك صورة ثابتة تريد تحريكها بالحياة والحركة، فإن Wan 2.7 I2V أو Pixverse v4.5 سينتجان نتائج أكثر تماسكًا من نموذج تحويل نص إلى فيديو خالص يعمل دون مرجع بصري.
لا قصة، لا عاطفة
هذه المشكلة أعمق من مسألة التقنية. فحتى أكثر فيديوهات الذكاء الاصطناعي إتقانًا من الناحية التقنية سيبدو فارغًا إذا لم يكن في المشهد توتر إنساني. المشاهدون يتفاعلون مع العاطفة. يتفاعلون مع القصص. يتفاعلون مع لحظات تبدو فيها شيء على وشك الحدوث، أو شيء حدث للتو، أو شيء معلّق على حافة الانهيار.
لماذا يخلق السياق التوتر
قارن بين هذين الأمرين على مستوى القصة:
بلا قصة: "رجل يقف بجوار نافذة ليلًا."
مع قصة: "رجل في الخمسينيات (50s) من عمره يقف بجوار نافذة شقة تسيل عليها قطرات المطر عند منتصف الليل، يمسك هاتفًا لم يتصل به بعد، فكّه مشدود، ويراقب سيارة أجرة تبتعد في الشارع أسفل النافذة."
المكان نفسه. الشخصية نفسها. ثقل عاطفي مختلف تمامًا. الأمر الثاني يلمّح إلى سرد كامل دون أن يصرّح به. النموذج يستجيب لذلك بتوليد حركات دقيقة: التوتر الخفيف في الفك، وسكون اليد التي تمسك الهاتف، والعينان تتابعان سيارة الأجرة المبتعدة.
إضافة ثقل عاطفي إلى الأوامر
استخدم هذه التقنيات لبث القصة في أي مشهد:
أضف علاقة: ليس "شخصان على طاولة" بل "أختان متباعدتان على طاولة مطبخ صغيرة، وكعكة عيد الميلاد بينهما لم تُمس"
لمّح إلى حركة سابقة: "عائد للتو من" أو "على وشك المغادرة إلى" يخلق سياقًا زمنيًا
أظهر الحالة الداخلية من خلال التفاصيل الجسدية: "يداه متشابكتان بقوة في حجره"، "يتجنب النظر في العينين"، "ابتسامة صغيرة لا إرادية في زاوية الفم"
استخدم الطقس والبيئة كاستعارة عاطفية: المطر للتوتر، والساعة الذهبية للحنين، والغيوم للحزن الذي لم يجد حلًا
💡 إذا كان فيديوك يهدف إلى بيع شيء ما، فالعاطفة ليست خيارًا. الناس يشترون بالإحساس، لا بالمواصفات. فيديو المنتج الذي يجعل شخصًا يشعر بشيء سيتفوق دائمًا على فيديو يكتفي بعرض المنتج.
كيف تصلحه: عملية قابلة للتكرار
الآن بعد أن غطينا كل طبقة من المشكلة، إليك عملية قابلة للتكرار لبناء أوامر تنتج فيديوهات سينمائية وجذابة في كل مرة.
بناء أمر سينمائي
استخدم هذا الهيكل واملأ كل خانة قبل التوليد:
[Subject: who/what + appearance + emotional state]
[Action: specific movement or behavior]
[Environment: location + time of day + weather + specific details]
[Lighting: source + direction + color temperature + quality]
[Camera: angle + lens + movement + distance]
[Atmosphere: texture, particles, ambient details]
مثال على مخرجات باستخدام هذا الهيكل:
"شيف شاب يرتدي مئزرًا أبيض، يداه مغطاتان بالدقيق، يعجن عجينة الخبز بتركيز شديد. في مطبخ مخبز حرفي دافئ عند الساعة 6 صباحًا، مقالٍ حديدية معلّقة على جدران من الطوب في الخلفية، وبخار خفيف يتصاعد من فرن قريب. ضوء صباحي خافت من نافذة عالية يلقي ظلالًا دافئة على طاولة التحضير الخشبية. الكاميرا تدفع ببطء من مستوى الخصر، عدسة 50 ملم، عمق ميداني ضحل يركّز على اليدين."
هذا الأمر الواحد يحتوي على الطبقات الخمس: الشخص، والحركة، والبيئة، والإضاءة، والكاميرا. نموذج مثل Wan 2.7 T2V أو Kling v3 سينتج منه شيئًا مدهشًا بصريًا لأن أمامه مشهدًا حقيقيًا ليعمل على تصييره.
استخدام التحكم في الحركة لتحقيق الدقة
بالنسبة للمستخدمين المتقدمين الذين يريدون تحكمًا على مستوى الإطار في مكان تحرك الكاميرا، يتيح Kling v3 Motion Control رسم مسار الكاميرا مباشرة على الواجهة. هذا يزيل الغموض عن حركة الكاميرا تمامًا.
هكذا يحصل صنّاع المحتوى المحترفون على لقطات رافعة دقيقة، وحركات دائرية، وتسلسلات كشف معقدة يستحيل وصفها بالنص وحده.
💡 ادمج التحكم في الحركة مع أمر شخص عالي التفاصيل. تصميم حركة الكاميرا يحدد أين ننظر. والأمر النصي يحدد ما نراه. يجب أن يكون الاثنان قويين كي تصمد النتيجة.
الفرق حقيقي
الفرق بين فيديو ذكاء اصطناعي مملّ وآخر جذاب ليس صدفة. وليس في الأداة التي دفعت ثمنها. ولا حتى في النموذج الذي اخترته. بل في جودة المعلومات التي قدّمتها للنظام ليعمل عليها.
كل فيديو ذكاء اصطناعي مسطّح وثابت وبلا روح أنتجته هو نتاج مدخلات مسطحة وثابتة وبلا روح. وهذا في الحقيقة خبر جيد، لأنه يعني أن الحل بيدك بالكامل.
إليك قائمة تحقق سريعة قبل أن تضغط "توليد" في المرة القادمة:
هل يتضمن أمري شخصًا محددًا مع تفاصيل المظهر؟
هل يصف حركة محددة، لا مجرد وجود؟
هل يسمّي البيئة مع وقت اليوم والملمس؟
هل يحدد مصدر الإضاءة واتجاهها وطبيعتها؟
هل يحدد زاوية الكاميرا ونوع العدسة والحركة؟
هل يحمل قدرًا من الثقل العاطفي أو السردي؟
إذا استطعت وضع علامة صح على الخانات الستة كلها، فلن يكون فيديوك مملًّا.
ابدأ الإنشاء الآن
النماذج موجودة بالفعل، بانتظارك. Kling v3، وVeo 3، وSora 2، وLTX 2 Pro، وSeedance 1.5 Pro، وRay كلها متاحة دون تثبيت أي شيء، ودون بطاقة ائتمان مسجلة، ودون انتظار في قائمة انتظار. يمكنك فتح المنصة، وكتابة أمر قوي باستخدام الإطار الوارد في هذا المقال، والحصول على فيديو سينمائي في أقل من دقيقتين.
خذ أسوأ أمر كتبته مؤخرًا. الأمر ذو الخمس كلمات. طبّق عليه كل طبقة من طبقات هذا المقال. ثم ولّد. النتيجة ستتحدث عن نفسها.