Generador de covers de canciones con IA gratis con tu propia voz: lo que de verdad funciona
¿Quieres escuchar tu propia voz y tu melodía convertidas en una pista terminada sin pagar un estudio? Este artículo describe un flujo de trabajo que puedes probar gratis: reinterpretar una canción a partir de un prompt de texto, clonar tu voz hablada para las capas habladas y animar una foto para crear un video cantando. También explica con claridad lo que la IA puede y no puede hacer hoy con tu voz.
Tarareas una melodía en el teléfono a medianoche y, por la mañana, quieres escucharla como una pista pulida, cantada en un estilo que nunca podrías grabar tú mismo. Esa es la promesa de cada generador de canciones con IA que se presenta como gratuito y personal. La realidad es más interesante, y algo más matizada, de lo que sugieren los anuncios. Algunas herramientas reconstruyen una canción en un género nuevo. Otras clonan tu voz hablada. Y otras animan tu rostro para que parezca que cantas cada verso. Ningún botón hace las tres cosas a la perfección, pero puedes encadenarlas en PicassoIA y conseguir un resultado sorprendentemente parecido sin pagar un estudio.
Este artículo te ofrece un mapa honesto de lo que funciona hoy, los ajustes exactos de cada modelo y los errores que más tiempo hacen perder. Cada modelo mencionado enlaza a su página, así que puedes abrir uno y probarlo mientras lees.
Qué significa realmente "tu propia voz"
Si buscas una herramienta gratuita de canciones con IA que use tu propia voz, encontrarás tres tipos de producto muy distintos. Confundirlos es la razón número uno por la que la gente se siente decepcionada tras el primer intento, así que conviene separarlos antes de pulsar ningún botón.
Tres funciones, tres tipos de herramienta
Función
Qué hace
Qué se conserva de ti
Modelo en PicassoIA
Reinterpretar una canción
Reconstruye una pista en un género nuevo con una voz nueva
Fíjate en lo que falta en esa tabla: un solo botón que cambie la voz de un cantante famoso por el timbre exacto de tu canto. Existen aplicaciones de conversión de voz diseñadas para esa tarea, y exigen mucha más configuración. Los modelos de este artículo siguen otro camino, uno que funciona por completo en el navegador y que aun así te da una canción terminada, una capa de voz y un video.
Dónde entra tu voz
Tu voz entra en el proceso en tres puntos:
Tu melodía. Tararea o canta una melodía en el teléfono. El modelo de reinterpretación conserva la línea melódica y reconstruye todo lo demás a su alrededor.
Tu voz hablada. Clona una muestra de entre 10 segundos y 5 minutos, y úsala para introducciones habladas, ad-libs o un verso narrado.
Tu rostro. Una foto más el audio terminado te da un video en el que tú pareces cantar.
💡 Fija las expectativas desde el principio: el modelo de reinterpretación cambia al cantante. Si necesitas que la voz final coincida nota a nota con el timbre de tu canto, graba esa parte tú mismo y deja que la IA se encargue del arreglo, de las capas habladas y del video.
Qué ofrece realmente lo gratuito
La palabra gratis esconde mucha letra pequeña. Varios de los modelos siguientes se describen como gratuitos para probar en sus páginas de PicassoIA, lo que significa que puedes hacer una primera generación, escuchar el resultado y decidir antes de comprometerte con nada. Probar gratis no es lo mismo que uso ilimitado para siempre, así que revisa los detalles de los planes en el sitio antes de planear un álbum completo.
Gratis para probar frente a gratis para siempre
Gratis para probar: ejecuta un modelo una o dos veces y juzga el resultado con tus propios auriculares.
Créditos y planes: las sesiones más largas y las ejecuciones repetidas pueden depender de tu plan.
Materiales de entrada gratuitos: un flujo de trabajo sin costo también necesita material de origen sin costo. Usa canciones que hayas escrito, melodías de dominio público o pistas para las que tengas licencia.
Music 2.6: escribe una canción original completa a partir de un prompt de estilo y, opcionalmente, una letra.
Voice Cloning: crea una voz reutilizable a partir de una muestra corta.
Qwen3 TTS: voces predefinidas, voces clonadas o voces que describes con palabras sencillas, en 10 idiomas.
Omni Human 1.5: convierte una foto y un clip de audio corto en un video con sincronización labial.
¿Cuál usar primero? Si ya tienes una melodía, empieza por el modelo de reinterpretación. Si solo tienes palabras, empieza por Music 2.6. Acepta letras con etiquetas de estructura como [Intro], [Verse], [Chorus], [Bridge] y [Outro], y puede escribir la letra por ti a partir de un prompt de estilo cuando el campo de letra está vacío. También tiene un interruptor instrumental, muy útil para una pista de acompañamiento limpia debajo de tu voz clonada.
Prepara tu pista de origen
Una entrada deficiente produce un resultado deficiente, y el audio perdona menos que casi cualquier otro medio. Diez minutos de preparación te ahorrarán diez regeneraciones.
Elige una canción que puedas usar
El modelo de reinterpretación necesita una canción de origen. Las opciones seguras son:
Tu propia obra original, incluso una maqueta grabada rápidamente con el teléfono.
Una melodía de dominio público, como una canción folclórica tradicional o un himno antiguo.
Una pista que tengas licencia para adaptar.
Descarta cualquier material que no puedas usar con permiso si planeas publicar el resultado. Más sobre esto en la sección de derechos más abajo. Mientras pruebas prompts, trabaja con un fragmento corto y ejecuta la canción completa una vez que el estilo te convenza.
Graba una toma vocal limpia
Si tu propio canto es la referencia de la melodía, grábalo en seco:
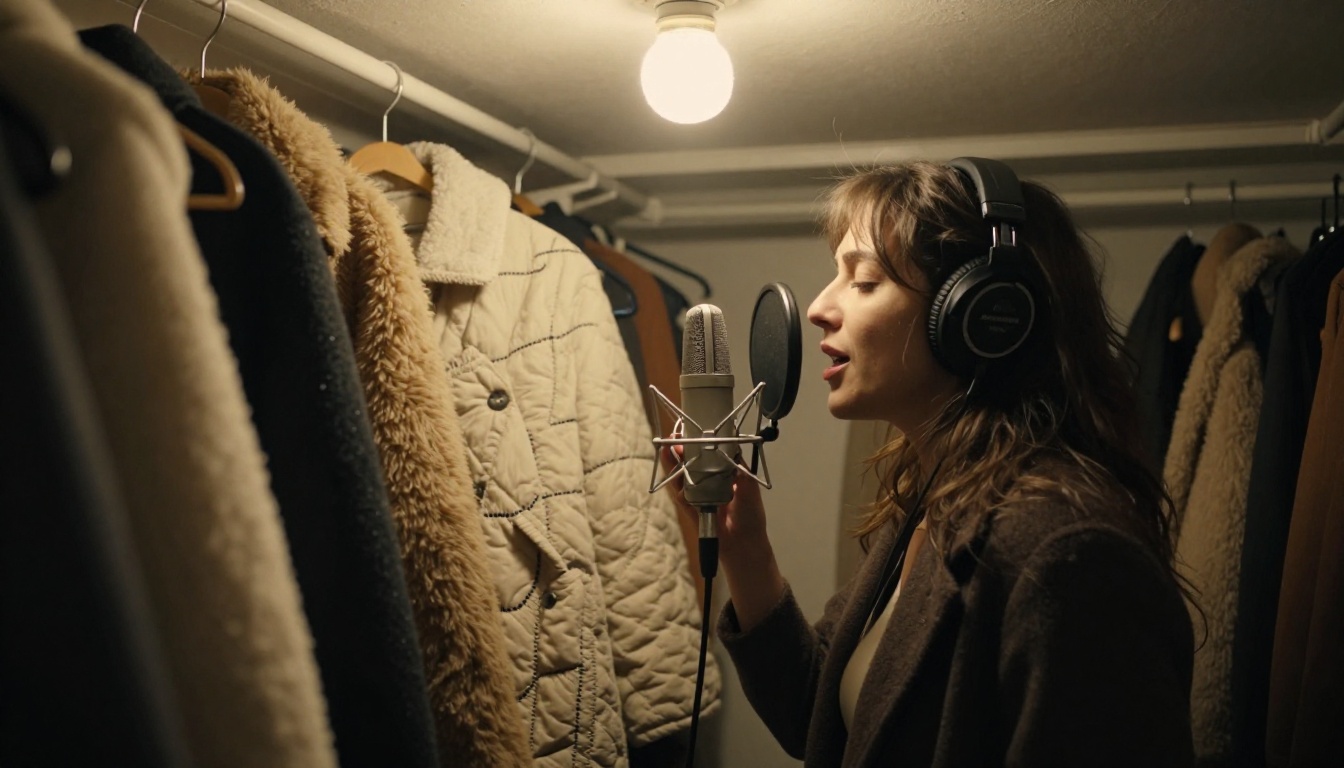
Canta dentro de un armario lleno de abrigos colgados. La ropa absorbe el eco mejor que la mayoría de los dormitorios.
Sostén el teléfono o el micrófono a unos diez centímetros de la boca.
Apaga ventiladores, música de fondo y notificaciones.
Canta la melodía con claridad y de forma constante. Es lo único que el modelo conserva, así que haz que cuente.
Después exporta un MP3 o un WAV. El modelo de reinterpretación lee tu pista desde un enlace, y ese enlace debe ser de acceso público. Sube el archivo a un lugar que cualquiera con el enlace pueda abrir, y prueba el enlace en una ventana privada del navegador antes de pegarlo.
💡 Prueba rápida: si el enlace te pide iniciar sesión, el modelo tampoco podrá leerlo.
Este es el flujo exacto para el modelo de reinterpretación MiniMax Music, el que hace el trabajo pesado en este proceso. La página lo describe de forma sencilla: sube una pista, describe el estilo que quieres y recibe una canción con otra voz, otros instrumentos y otro género, mientras la melodía original se mantiene intacta.
Ajustes paso a paso
Abre la página del modelo en PicassoIA.
Pega tu enlace público de MP3 o WAV en el campo de URL de audio.
Describe el estilo objetivo en el campo de prompt. Acepta hasta 2000 caracteres.
Deja la letra vacía para conservar las palabras originales, o pega las tuyas, hasta 3000 caracteres.
Elige el formato de salida: MP3 para compartir, WAV si vas a editar el audio más adelante.
Mantén los valores predeterminados para la mejor fidelidad y baja la tasa de bits solo cuando el tamaño del archivo importe.
Ejecuta, escucha con auriculares y cambia una sola cosa en el prompt antes de volver a ejecutarlo.
Ajuste
Opciones
Predeterminado
Cámbialo cuando
Formato de salida
MP3, WAV, PCM
MP3
Vayas a editar el audio en otra aplicación
Frecuencia de muestreo
16, 24, 32 o 44,1 kHz
44,1 kHz
Necesites un archivo de borrador más pequeño
Tasa de bits
32, 64, 128 o 256 kbps
256 kbps
Compartas una vista previa rápida
Prompt
Hasta 2000 caracteres
Obligatorio
En cada ejecución, para orientar el estilo
Letra
Hasta 3000 caracteres
Vacía
Quieras palabras nuevas en lugar de las originales
Prompts que funcionan
Estos cinco prompts provienen directamente de los ejemplos ejecutados en la página del modelo. Cada uno indica un género, un instrumento o sonido principal y un tipo de voz.
Objetivo
Prompt
Versión relajada
Lo-fi hip hop version, vinyl crackle, chill beat, warm midrange, dreamy reverb
Remix para bailar
EDM remix, 128 BPM, heavy synth bass, atmospheric pads, driving four-on-the-floor beat, euphoric drop
Hard rock, distorted electric guitar riffs, powerful drums, raw male vocal, arena energy
Club de madrugada
Jazz arrangement, saxophone lead, smooth female vocal, mellow piano chords, late night club
Una fórmula fiable es género + tempo o ánimo + instrumento principal + tipo de voz + una palabra de escena. Mantén un solo género por ejecución, porque mezclar cuatro estilos en un mismo prompt es la forma más segura de acabar con un resultado embarrado. Para orientar al cantante, describe la voz en la misma frase: warm female vocal, raw male vocal, smooth female vocal o soft intimate vocal.
Añade tu propia letra
Con el campo de letra vacío, el cantante interpreta las palabras extraídas de tu canción original. Para cantar las tuyas, pégalas con etiquetas de sección como [verse], [chorus] y [bridge]:
[verse]
Morning light on the kitchen floor
I hum the tune I hummed before

[chorus]
This is my song, this is my sound
💡 Respeta el ritmo: mantén cada línea nueva cerca del número de sílabas de la línea original. Una línea más larga se comprime y las palabras salen apresuradas.
Pon tu voz real en la mezcla
El modelo de reinterpretación canta con una voz nueva. Tu voz real se incorpora a la pista a través de modelos de habla, y ahí es donde entra la clonación.
Formato y duración: MP3, M4A o WAV, de 10 segundos a 5 minutos, con menos de 20 MB.
Reducción de ruido: actívala si la grabación tiene siseo de fondo.
Normalización de volumen: actívala si tus niveles varían mucho.
Nivel de habla: el predeterminado es Speech 2.6 HD, con opciones turbo y HD anteriores disponibles.
Obtendrás una voz reutilizable que puedes aplicar a todas las ejecuciones de habla que quieras. Escribe una línea de introducción, un puente hablado o un verso narrado y genéralo con tu voz clonada.
💡 Las voces clonadas aquí provienen de modelos de texto a voz, así que trátalas como una capa hablada, no como sustituto de una voz cantada.
Clona tu voz en un solo paso
Qwen3 TTS ofrece una alternativa de un solo paso. Elige el modo de clonación de voz, sube un clip de referencia corto y escribe la transcripción de ese clip en el campo de texto de referencia, tal como recomienda la página del modelo. Añade una instrucción de estilo, como speak slowly and calmly o excited tone, para orientar la entrega. El ejemplo de clonación de la propia página del modelo terminó en unos 14 segundos. Para otra opción de clonación con control de emoción, prueba Chatterbox.
Colócala sobre la pista reinterpretada
Descarga la canción reinterpretada y tus líneas de voz clonada, y luego combínalas en cualquier editor de audio gratuito:
Coloca la canción en una pista y tus líneas de voz en otra.
Baja la música unos decibelios bajo las partes habladas.
Añade un toque de reverberación a la voz para que suene en la misma sala que la banda.
Haz fundidos entre secciones y exporta un MP3 final.
Un arreglo sencillo que funciona para una canción de tres minutos:
Momento
Música
Voz
Primeros 8 segundos
Instrumental tranquilo, de Music 2.6 o de la pista reinterpretada
Tu voz clonada dice una línea de título
Versos
Pista reinterpretada a volumen completo
El cantante reinterpretado
Estribillo
Pista reinterpretada a volumen completo
El cantante reinterpretado más un ad-lib con tu voz clonada
Puente
La música baja unos decibelios
Tu voz clonada dice una línea
Final
Fundido de unos 4 segundos
Silencio o una despedida hablada breve
Crea un video cantando a partir de una foto
Una pista con un rostro viaja más lejos en las redes sociales que un archivo de audio sin imagen, y solo necesitas una foto para conseguirlo.
Foto más audio se convierte en video
Omni Human 1.5 toma una foto y un clip de audio de menos de 35 segundos, y devuelve un video con sincronización labial. El prompt de ejemplo de la propia página del modelo, A woman sings and strums her guitar, muestra el caso de uso del canto.
Usa un retrato de frente con luz uniforme y un fondo liso.
Recorta tu canción al estribillo o al gancho. El audio de más de 35 segundos hace que la generación falle.
Activa el modo rápido mientras pruebas. Los ejemplos ejecutados en la página tardaron entre 3 y 6 minutos aproximadamente.
Añade un prompt corto si quieres orientar los gestos o el movimiento de cámara.
Sincroniza un video existente
Si ya tienes un clip tuyo, Lipsync 2 Pro reescribe los movimientos de los labios para que coincidan con el nuevo audio. Ofrece cinco modos de sincronización (loop, bounce, cut off, silence y remap) más un control de expresividad de 0 a 1, y acepta video MP4 con audio WAV. Kling Lip Sync es otra opción para ajustar una boca al audio en cualquier video.
Antes de publicar nada
Las cuestiones de derechos importan más que cualquier prompt. Esta es información general, no asesoramiento legal.
Reinterpretar no convierte la canción en tuya. Publicar una versión reelaborada de una canción protegida por derechos de autor normalmente sigue requiriendo el permiso de los titulares de la composición original.
El dominio público ayuda, con una salvedad. Una composición antigua puede ser de uso libre, pero una grabación concreta de ella puede seguir protegida.
Clona solo voces que sean tuyas o para las que tengas permiso por escrito.
Etiqueta las pistas asistidas por IA siempre que una plataforma lo pida.
Seis errores hacen perder más horas que cualquier otro:
Un enlace de origen privado. El modelo no puede abrirlo y la ejecución falla.
Una muestra de clonación con ruido. Activa la reducción de ruido o vuelve a grabar en el armario.
Cinco géneros en un solo prompt. Elige un género y un ánimo.
Cambiar cinco ajustes a la vez. No sabrás qué cambio ayudó.
Esperar tu timbre de canto en la reinterpretación. Planifica las capas de voz en su lugar.
Enviar una canción completa al modelo de video. Recórtala a menos de 35 segundos primero.
Crea tu primera pista hoy
Ahora te toca a ti. Elige una melodía que te guste, tararea 30 segundos en el teléfono y ejecútala por el modelo de reinterpretación MiniMax Music con un único prompt claro. Prueba primero el prompt lo-fi y luego el de jazz, y fíjate en cómo la misma melodía cambia de ánimo. Si prefieres una canción nueva, dale tu propia letra a Music 2.6 y deja que construya el arreglo.
Una primera sesión realista podría ser así:
10 minutos: graba la melodía en tu cabina del armario.
10 minutos: dos o tres ejecuciones de reinterpretación, cambiando una cosa cada vez.
10 minutos: clona tu voz y genera dos líneas habladas.
15 minutos: combina y exporta el MP3 final.
10 minutos: convierte el gancho en video con Omni Human 1.5.
Los modelos de música y de voz se pueden probar gratis, así que el único costo de experimentar son unos minutos de curiosidad. También puedes crear la portada del álbum con los modelos de imagen de PicassoIA, de modo que todo el lanzamiento (canción, voz, video y portada) esté en un solo lugar. Explora todo en picassoia.com/en/all-models y crea algo que suene a ti.