Las fotos parlantes solían requerir un estudio completo de animación y semanas de trabajo. Hoy, una sola imagen fija y un clip de audio son todo lo que necesitas.
Los modelos de sincronización labial con IA han llegado a un punto en el que los movimientos de la boca en un video generado son casi indistinguibles de una grabación real. El ritmo, la sutil tensión de la mandíbula, la forma en que los labios se presionan al final de una palabra: todo eso se calcula en tiempo real mediante modelos entrenados con millones de horas de habla humana. Y no necesitas pantalla verde, cámara ni experiencia en edición de video para llegar hasta ahí.
Este artículo lo cubre todo: qué son realmente las fotos parlantes por dentro, qué modelos de IA merecen tu tiempo, un tutorial completo paso a paso con uno de los modelos más precisos disponibles y los casos de uso prácticos que la gente ya está creando con esta tecnología.
Qué es realmente una foto parlante
El término «foto parlante» se usa a la ligera, así que conviene ser precisos sobre lo que ocurre de verdad.
Más allá de la animación simple
Las primeras versiones de esta tecnología no eran más que efectos de temblor aplicados a un rostro. Las zonas de la boca se distorsionaban sutilmente en bucle para simular el habla. El resultado parecía artificial en cuestión de segundos. Lo que cambió fue la llegada de la sincronización labial generativa: el modelo no anima una foto en absoluto. Genera fotogramas nuevos desde cero, condicionados tanto por la imagen original como por la forma de onda del audio.
La diferencia es sustancial. En lugar de deformar píxeles que nunca fueron diseñados para moverse, el modelo sintetiza el rostro en movimiento y conserva la identidad: la estructura ósea, el tono de piel, el cabello, los ojos. La foto actúa como referencia, no como lienzo.
Cómo funciona la capa de sincronización labial
Los sistemas modernos de fotos parlantes con IA combinan dos procesos distintos que trabajan en secuencia.
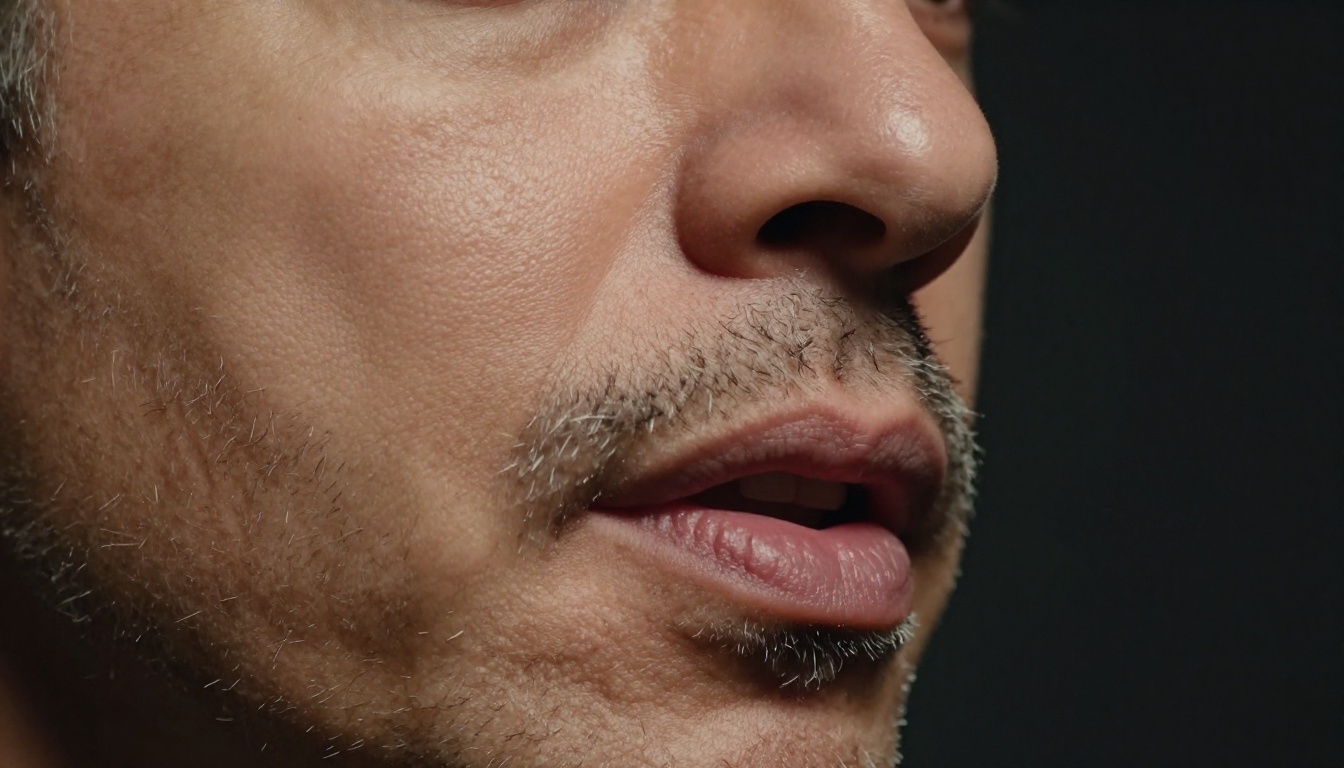
El primero es el análisis de audio: el modelo divide la señal de voz en segmentos a nivel de fonema, identificando cada sonido distinto y su tiempo exacto. El segundo es la síntesis facial: una arquitectura basada en difusión o en transformers genera la región facial fotograma a fotograma, guiada por los datos de fonemas y anclada a la identidad de tu foto original.
El resultado es un video en el que la boca, la mandíbula y los músculos sutiles del rostro se mueven de forma acorde con el audio, sin que nunca parezca que se ha pegado una cara sobre un metraje en movimiento.
💡 La calidad de tu foto de origen importa mucho. Un retrato bien iluminado, de frente y con rasgos faciales nítidos producirá resultados notablemente más nítidos que un selfie borroso o con filtros.
Los mejores modelos de IA para fotos parlantes
No todos los modelos de sincronización labial son iguales. Algunos priorizan la velocidad, otros la precisión, y unos cuantos están creados específicamente para flujos de trabajo de retrato a video. Estos son los que vale la pena conocer.
Omni Human 1.5 de ByteDance
Omni Human 1.5 es actualmente una de las opciones técnicamente más sofisticadas para crear fotos parlantes a partir de un solo retrato. ByteDance lo construyó con una arquitectura de doble flujo que gestiona tanto el movimiento de cuerpo completo como la animación facial aislada. El resultado es que la persona de la foto parece estar hablando de verdad, y no solo tiene la boca animada.
El realismo en los retratos de primer plano es excepcional. Se perciben el movimiento de la mandíbula, la compresión de los labios e incluso la activación sutil de los músculos de las mejillas. Este es el modelo que conviene usar cuando la calidad es el requisito principal.
Fabric 1.0 de VEED
Fabric 1.0 está diseñado específicamente en torno al caso de uso de «hacer que una foto hable». Mientras que muchos modelos de sincronización labial te piden empezar con un video, Fabric 1.0 acepta una imagen fija directamente y genera el video parlante de principio a fin.
Maneja bien una amplia variedad de estilos de retrato: fotos de estudio, selfies informales, imágenes de perfil ilustradas. El modelo destaca especialmente en mantener la coherencia de la identidad en clips de audio más largos, que es uno de los puntos de fallo más comunes en esta categoría.
P Video Avatar
P Video Avatar adopta un enfoque algo distinto al integrar en el flujo de trabajo el concepto de avatar reutilizable. Creas el retrato parlante una vez, y el resultado puede volver a animarse con nuevo audio sin regenerarlo desde cero. Esto lo hace especialmente útil para quien necesita producir varios videos con la misma cara.
Lipsync 2 Pro de Sync
Lipsync 2 Pro viene de Sync.so, un equipo centrado casi por completo en la sincronización labial precisa. La versión Pro supera de forma notable a su predecesor en la precisión de fonemas de grano fino, sobre todo en idiomas distintos del inglés. Su hermano Lipsync 2 también está disponible para resultados más rápidos y ligeros.
Kling Lip Sync de Kwai
Kling Lip Sync viene del equipo detrás de la plataforma de generación de video Kling. Hereda la fortaleza de Kling en coherencia temporal, es decir, el rostro no parpadea ni se desplaza entre fotogramas como ocurre con los modelos más antiguos. Funciona bien con retratos en condiciones de iluminación complejas, donde mantener la precisión del tono de piel es importante.
React 1 de Sync
React 1 es el modelo de Sync para añadir sincronización labial realista a contenido de video existente, pero también gestiona flujos de foto fija a video mediante un paso intermedio de generación. Su punto fuerte es volver a sincronizar un rostro con audio completamente nuevo, lo que lo convierte en una herramienta potente para doblajes o cambios de voz.
Cómo usar Omni Human 1.5 en PicassoIA
La forma más clara de crear fotos parlantes con IA es recorrer el proceso con un modelo concreto. Omni Human 1.5 es el punto de partida recomendado para la mayoría de casos de uso, dado su equilibrio entre realismo y facilidad de uso.
Paso 1: elige la foto adecuada
Tu imagen de origen es la base de la calidad del resultado. Sigue estas reglas para sacarle el máximo partido:
- Resolución: usa una imagen de al menos 512x512 píxeles. Cuanto más, mejor.
- Ángulo del rostro: de frente o con un ligero perfil de tres cuartos. Evita los perfiles laterales completos.
- Iluminación: luz uniforme y difusa. Evita sombras duras que crucen el rostro.
- Expresión: neutra o con una ligera sonrisa. Las expresiones muy marcadas en la foto de origen pueden interferir con la síntesis.
- Fondo: los fondos sencillos o desenfocados ayudan al modelo a aislar el rostro con más precisión.
Paso 2: prepara y sube tu audio
El clip de audio impulsa toda la animación. La calidad aquí importa tanto como la de la foto.
- Formato: MP3 o WAV. Para empezar, mantén el clip por debajo de 60 segundos.
- Claridad de la voz: las grabaciones limpias, con un ruido de fondo mínimo, producen movimientos labiales más nítidos.
- Ritmo: un ritmo de conversación normal funciona mejor. Un habla muy rápida puede hacer que el modelo comprima los fonemas.
En PicassoIA, abre Omni Human 1.5, sube tu retrato en el campo de imagen y después sube tu clip de audio. El modelo acepta tanto una grabación de voz como un clip generado con texto a voz, así que no necesitas una voz grabada previamente si trabajas a partir de un guion.
Paso 3: genera y revisa
El procesamiento suele tardar entre 30 y 90 segundos, según la duración del audio. Cuando aparezca el resultado:
- Revisa el clip completo antes de descargarlo para detectar artefactos fotograma a fotograma.
- Fíjate especialmente en las transiciones entre palabras, sobre todo en las consonantes oclusivas como «p», «b» y «m», que exigen un cierre completo de los labios.
- Si los movimientos de la boca no parecen naturales, prueba a subir de nuevo con una foto de origen de mayor resolución o con un archivo de audio más limpio.
💡 Consejo profesional: usa primero los modelos de Texto a voz de PicassoIA para generar el clip de audio y luego introdúcelo directamente en Omni Human 1.5. Este flujo de trabajo de principio a fin te lleva de un guion escrito a un retrato parlante terminado sin grabar ni una sola palabra.
Comparativa de modelos de un vistazo
5 casos de uso reales ahora mismo
La gente ya está creando flujos de trabajo reales en torno a la IA de fotos parlantes. Así es como aparece de verdad.
1. Videos de marca personal: en lugar de grabar un nuevo video de presentación cada vez que quieres compartir un mensaje, los creadores suben una sola foto de retrato y generan un video nuevo a partir de un guion. El rostro se mantiene coherente en todo el contenido.
2. Materiales de e-learning y formación: los instructores crean avatares presentadores a partir de una única foto de retrato profesional y graban la narración de sus cursos por separado. El resultado es una presencia en pantalla coherente, sin el costo de repetir rodajes de video.
3. Contenido multilingüe: usando Video Translate junto con una foto parlante, los creadores de contenido producen la misma presentación en varios idiomas con una sincronización labial precisa, evitando el desajuste chocante que aparece en un video doblado convencional.
4. Narrativa histórica y de archivo: periodistas y documentalistas usan estas herramientas para animar fotografías históricas de retrato, dando voz a personajes que solo han sobrevivido en imágenes fijas.
5. Videos cortos para redes sociales: los clips cortos de retratos parlantes funcionan bien como ganchos llamativos para anuncios de productos, testimonios y piezas de opinión, donde mostrar un rostro aporta credibilidad sin necesidad de un equipo de rodaje.
4 consejos para resultados más realistas
Conseguir una calidad constante depende de controlar las entradas. Estos cuatro hábitos mejorarán de forma notable cada foto parlante que generes.
1. Ajusta el entorno sonoro a la foto: una grabación de voz cercana al micrófono, íntima, combina de forma natural con un retrato de luz suave. Una foto exterior de gran angular con una grabación de habitación resultará desconectada para el ojo y el oído del espectador.
2. Usa una expresión neutra como base: los modelos que parten de un rostro relajado y neutro tienen más libertad para generar toda la gama de expresiones guiadas por fonemas. Partir de una sonrisa amplia o de un ceño fruncido limita lo que puede producir la síntesis.
3. Mantén cortos tus primeros clips: los clips de 15 a 30 segundos te permiten iterar rápido. Cuando encuentres ajustes que produzcan resultados limpios, aplícalos a audios más largos.
4. Pasa el resultado por Super Resolution: después de generar la sincronización labial, pasar tu video por un modelo de Super Resolution afina los detalles finos que se suavizan ligeramente durante la síntesis, sobre todo alrededor de los labios y los ojos.
Las fotos parlantes rara vez viven aisladas. Son más eficaces cuando se combinan con otras capacidades de IA.
Texto a voz: los modelos de Texto a voz de PicassoIA generan la entrada de audio a partir de cualquier guion escrito, sin que tengas que grabar tu propia voz. Es ideal para crear retratos parlantes de personas que no pueden o no quieren aportar audio directamente.
Generación de música con IA: añadir una pista de fondo sutil de Generación de música con IA convierte un clip bruto de retrato parlante en un video pulido y listo para producción.
Eliminación de fondo: antes de subir tu retrato, pasarlo por Eliminación de fondo para colocar el rostro sobre un fondo limpio de color sólido suele producir una sincronización labial más limpia y facilita mucho integrarlo en otras grabaciones.
Lipsync Speed: para flujos de trabajo de gran volumen en los que necesitas procesar muchos clips rápidamente, este modelo de HeyGen prioriza el rendimiento sin sacrificar la precisión del movimiento labial principal.
Lipsync Precision: cuando la precisión importa más que la velocidad, este modelo complementario de HeyGen está optimizado para la precisión a nivel de fonema en audios exigentes.
Empieza a crear ahora mismo
La barrera para crear una foto parlante con IA es ahora un solo retrato y un solo clip de audio. Sin estudio, sin equipo de rodaje, sin flujo de posproducción.
Ya sea que estés construyendo una marca personal, produciendo contenido educativo, experimentando con animación histórica o simplemente con curiosidad por lo que puede hacer la tecnología, los modelos de PicassoIA están listos para usar.
Empieza con Omni Human 1.5 si quieres la salida de mayor fidelidad a partir de un retrato. Usa Fabric 1.0 si buscas el camino más rápido de una foto fija a un video parlante terminado. Prueba Kling Lip Sync si la prioridad es la coherencia temporal en clips más largos.
Elige cualquier foto. Graba o genera 30 segundos de audio. Sube ambos y mira qué sale. La primera vez que un retrato fijo abre la boca y habla, las posibilidades se vuelven obvias enseguida.
💡 Explora la colección completa de modelos de sincronización labial en PicassoIA para ver todas las herramientas disponibles para fotos parlantes, sincronización de voz a video y doblaje multilingüe en un solo lugar.


