Si ya has trabajado con GPT Image 1.5, sabes que puede hacer dos cosas muy distintas: crear imágenes a partir de un prompt de texto y modificar imágenes que ya tienes. A simple vista, parecen la misma función. No lo son, y elegir la equivocada para tu tarea te costará calidad, tiempo y resultados que no podrás recuperar con un nuevo intento. Elegir bien entre editar y generar es la decisión más importante que tomas antes de pulsar el botón.
Dos modos, un solo modelo
GPT Image 1.5 funciona dentro de la arquitectura multimodal de GPT-4o. No son dos herramientas separadas con motores distintos. Es un único modelo que lee el tipo de entrada y el contexto, y aplica una estrategia de generación diferente según lo que le des. La distinción importa menos en la interfaz y mucho más en el resultado.
Qué hace realmente la generación
Cuando escribes un prompt sin adjuntar ninguna imagen, GPT Image 1.5 crea una escena desde cero mediante un proceso de difusión guiado únicamente por tus palabras. Construye la composición, la iluminación, la textura y el sujeto a la vez, partiendo de la nada. No se conserva nada de ninguna imagen anterior. El resultado refleja el vocabulario de tu prompt, no ninguna referencia visual que tengas.
Esto importa porque generar es, en esencia, un problema de imaginación. El modelo interpreta tus palabras, rellena cada hueco visual con sus datos de entrenamiento y produce algo internamente coherente, pero no anclado a nada concreto que debas conservar. Inventa con libertad.
Qué hace realmente la edición
La edición funciona de otra manera a nivel de arquitectura. Cuando proporcionas una imagen de origen junto con un prompt, GPT Image 1.5 usa esa imagen como señal de condicionamiento. El proceso de difusión parte de tus píxeles originales, o de algo muy cercano a ellos, en lugar de ruido puro. Tu prompt le indica al modelo qué cambiar; la imagen de origen le indica qué conservar.
Esto es mecánicamente parecido a lo que los profesionales llaman inpainting o traducción de imagen a imagen. El modelo no reinventa la escena. Modifica un subconjunto concreto manteniendo la estructura, la identidad del sujeto y las relaciones espaciales que estableció tu imagen de origen.
Por qué la distinción lo cambia todo
La diferencia práctica es enorme. Si tu imagen de origen contiene el rostro de una persona concreta, un producto de marca con proporciones precisas o una composición arquitectónica que debe mantenerse intacta, solo el modo de edición funciona de forma fiable. La generación producirá algo plausible pero incorrecto: un rostro genérico, un producto inventado, un edificio aleatorio que comparte estilo, pero nada más.
Por el contrario, si necesitas algo que todavía no existe físicamente en ninguna parte, el modo de edición tiene dificultades. Se ancla a los píxeles de tu entrada y no puede librarse de ellos del todo. Obtendrás una versión modificada de lo que le diste, no una creación realmente nueva.
Cuándo generar es la opción correcta
Empezar desde cero
Generar brilla cuando tu encargo existe solo como palabras. El concept art para una presentación, las imágenes de un moodboard para una nueva campaña, los fondos para redes sociales de un producto que no saldrá al mercado hasta dentro de seis meses: todo esto parte de cero imágenes de origen utilizables. Generar es rápido, barato por iteración y te permite probar muchas direcciones creativas antes de comprometer un presupuesto de producción con cualquiera de ellas.
El ciclo de retroalimentación es muy ajustado: un prompt débil da una imagen débil, pero puedes iterar 10 veces en 5 minutos y converger en la dirección correcta. El modo de edición te obligaría a empezar con una imagen de origen que ya se parezca a tu objetivo. Todavía no la tienes. Así que primero generas.
Concept art e imagen de marca
Cuando una marca necesita algo que genuinamente aún no existe en el mundo físico, generar es la herramienta correcta. Una firma de moda que quiere una campaña ambientada en un glaciar remoto, una startup que necesita fotos de estilo de vida del producto antes de que salga al mercado, una editorial que necesita la escena de una portada de libro con iluminación dramática y sin una referencia de archivo utilizable: todas estas situaciones exigen construir a partir de vocabulario, no modificar fotografías existentes.
💡 Consejo: Cuanto más específico sea tu prompt de generación, menos iteraciones necesitarás. "Una mujer con un abrigo de lana rojo caminando por una calle nevada de Copenhague, luz matinal nublada, fotografía documental de 35 mm, grano de película" casi siempre superará a "mujer con abrigo en la nieve". La especificidad es la herramienta principal del ingeniero de prompts.
Velocidad frente a control creativo
Generar gana en velocidad pura para el contenido en volumen. Sin preparación de la imagen de origen, sin redimensionar, sin limpieza, sin decisiones de máscara. Escribes un prompt y obtienes resultados. Para los equipos de redes sociales que producen decenas de recursos visuales por semana, los flujos de trabajo basados en generación pueden reducir mucho el tiempo de producción cuando no se requiere una fidelidad fotográfica con los recursos existentes.
La contrapartida es el control. La generación da al modelo más libertad creativa. Si necesitas algo muy concreto, sobre todo algo que deba coincidir exactamente con objetos o identidades del mundo real, esa libertad se convierte en un problema. El modelo rellena los huecos con suposiciones aprendidas, no con tus especificaciones.
Cuándo la edición gana siempre
Corregir lo que ya existe
Aquí la edición es imbatible. Tienes una buena fotografía con un problema concreto: un fondo que distrae, un cielo gris y plano o una pequeña corrección en el sujeto. El modo de edición te permite describir el arreglo en lenguaje natural mientras el modelo conserva todo lo que ya te gusta de la imagen.
La generación no puede hacer esto. No puede tomar tu foto existente y corregir solo el cielo, porque no tiene el concepto de "solo el cielo" frente a "todo lo demás". Producirá una imagen nueva que quizá comparta el ambiente de la tuya, pero no será tu imagen. El sujeto, la pose, el vestuario y las relaciones espaciales desaparecen.
Inpainting para reemplazos precisos
El inpainting es la forma más precisa de edición de imágenes con IA. Defines una región mediante una descripción o una máscara, y el modelo rellena solo esa región y mantiene fijo el resto. GPT Image 1.5 maneja bastante bien el inpainting con lenguaje natural, lo que te permite decir "reemplaza el fondo por un interior de cafetería de tonos cálidos" sin necesidad de un software de máscaras manual.
Este flujo de trabajo es crítico a nivel comercial para:
- Fotografía de producto para e-commerce: La misma toma del producto, varios contextos de fondo y proporciones coherentes
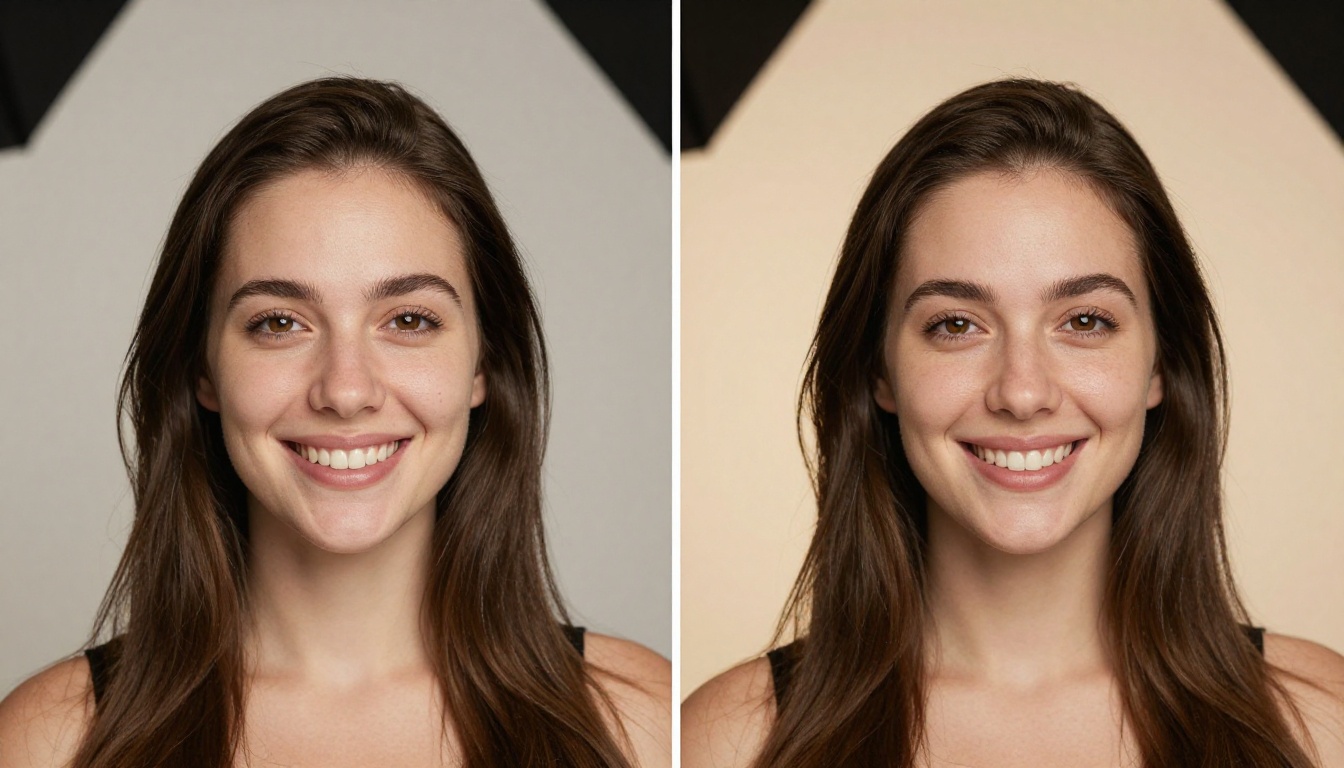
- Trabajo de retrato: Corrección de la piel, eliminación de elementos que distraen y limpieza del fondo manteniendo la identidad del sujeto
- Fotografía inmobiliaria: Reemplazo del cielo, ajustes de interiores y eliminación de muebles o desorden
- Actualizaciones de recursos de marca: Cambio de un elemento dentro de una plantilla visual coherente sin rehacerla desde cero
Cambios de fondo sin perder al sujeto
Uno de los flujos de trabajo más solicitados en la fotografía comercial es: mismo sujeto, entorno distinto. El modo de edición lo resuelve con mucha más precisión que la generación, porque el modelo conserva la identidad del sujeto, la pose y las relaciones de iluminación gracias a la señal de condicionamiento de tu imagen de origen.
La generación produciría un sujeto nuevo en un entorno nuevo. La edición produce tu sujeto en un entorno nuevo. Esa diferencia, entre un sustituto plausible y la persona o el producto reales, es la diferencia comercial entre un resultado utilizable y uno que no lo es.
La brecha real de rendimiento
Una comparación honesta, lado a lado, de dónde rinde cada modo en escenarios creativos habituales:
| Escenario | Generación | Edición |
|---|
| Crear recursos visuales desde cero | Excelente | Deficiente |
| Corregir elementos concretos de una foto | Deficiente | Excelente |
| Conservar la identidad exacta de un sujeto | No fiable | Muy fiable |
| Producción rápida de contenido en volumen | Muy rápida | Moderada |
| Reemplazo de fondo | Crea una escena nueva | Modifica la escena existente |
| Inpainting o cambios selectivos | No puede aislar regiones | Fortaleza principal |
| Composiciones nuevas que todavía no existen | Excelente | Limitada por el origen |
| Fotografía de producto en varios contextos | Crea un producto nuevo | Adapta tu producto real |
Diferencias en la adherencia al prompt
En el modo de generación, tu prompt es la única fuente de verdad. Toda la composición se deriva de tus palabras. Un prompt bien escrito y específico te da una alta adherencia a tu intención.
En el modo de edición, tu prompt compite con una segunda fuente de verdad: la imagen de origen. Cuanto más pida tu prompt algo que entre en conflicto con la estructura existente de la imagen de origen, más tensión sufre el modelo y peor es la calidad. Por eso los cambios sutiles y dirigidos funcionan mejor que las reformas radicales en el modo de edición. Si quieres repensar por completo una escena, te conviene generar desde cero.
💡 Consejo: Si tu prompt de edición describe una escena completamente distinta a la de tu imagen de origen, los resultados serán peores que una generación limpia. La edición funciona mejor cuando cambias entre un 10 y un 40 % de la imagen aproximadamente. Para cambios mayores, genera.
Dónde se determina realmente la calidad
Ninguno de los dos modos es universalmente mejor. La calidad en cada uno depende de:
- Especificidad del prompt: Una descripción visual más concreta casi siempre mejora el resultado en ambos modos
- Calidad de la imagen de origen: Las imágenes de origen de baja resolución o muy comprimidas perjudican directamente los resultados de edición
- Alcance del cambio: Los cambios pequeños y dirigidos se editan limpiamente; los cambios estructurales grandes se generan mejor
- Identidad del sujeto: Los objetos, personas y recursos de marca específicos del mundo real son mucho más seguros en el modo de edición
Casos de uso reales que muestran la diferencia con claridad
Fotografía de producto a escala
Una marca de cosméticos necesita 12 fotos de estilo de vida para el lanzamiento de un nuevo sérum. Tienen una buena foto de estudio del producto, con la etiqueta, las proporciones y el acabado exactos.
Enfoque de generación: Escribir prompts que describan el sérum en cada contexto. Rápido, pero arriesgado. El "producto" generado se alejará del real. Las etiquetas, las proporciones y los acabados de los materiales cambiarán de una imagen a otra. No es comercialmente utilizable para nada que necesite precisión normativa en la etiqueta.
Enfoque de edición: Usar la foto de estudio como origen y describir cada nuevo contexto de fondo. El producto se mantiene fiel al producto físico. El flujo de trabajo lleva más tiempo por imagen, pero produce resultados que sí se pueden publicar.
Veredicto: la edición gana con claridad.
Sesiones de retoque de retratos
Un fotógrafo tiene 200 fotos de una sesión con un cliente. La mayoría necesita el mismo arreglo puntual: elementos que distraen en el fondo, un cielo algo nublado y pequeñas correcciones en el sujeto.
Enfoque de generación: Completamente inaplicable. No puedes recrear a ese cliente concreto, en esa pose concreta y con ese vestuario concreto mediante generación, y menos aún a un volumen de 200 imágenes.
Enfoque de edición: Pasadas de edición coherentes y puntuales aplicadas a imágenes originales reales. La identidad del sujeto se mantiene intacta y la corrección se aplica exactamente donde se indica.
Veredicto: la edición es la única vía viable.
Contenido para redes sociales en volumen
Un equipo de marketing necesita 30 fondos visuales únicos para una serie de publicaciones patrocinadas. No hace falta conservar ningún sujeto concreto. La velocidad importa más que la precisión, y la variedad más que la fidelidad a la identidad.
Enfoque de generación: Escribir 30 prompts variados y generar en lote. No hacen falta imágenes de origen ni decisiones de máscara. Velocidad alta, máxima variedad, poco esfuerzo por imagen.
Enfoque de edición: Requeriría 30 imágenes de origen para empezar, además de decisiones de máscara y más iteraciones por imagen. Más lento y sin ventaja de calidad para esta necesidad concreta.
Veredicto: la generación gana sin discusión.
Los modelos de PicassoIA: qué conviene saber
GPT Image 1.5 es capaz, pero no es la única herramienta de imagen con IA que merece la pena usar. En PicassoIA tienes acceso a modelos diseñados para fines concretos, especializados en generación o en edición, muchos de los cuales superan a GPT Image 1.5 en flujos de trabajo específicos.
Modelos orientados a la edición en PicassoIA
Para equipos que trabajan sobre todo con flujos de edición, estos modelos ofrecen resultados constantes y controlables:
- Flux Fill Pro: Diseñado específicamente para inpainting y outpainting. Una de las herramientas más limpias para la eliminación precisa de fondos y la ampliación del lienzo en flujos de producción.
- Flux Kontext Fast: Optimizado para la edición de imágenes con conciencia de contexto y con iteraciones rápidas. Pensado para la edición en volumen donde importan tanto la velocidad como la coherencia.
- Qwen Image Edit: Edición de imágenes basada en prompts de texto, con buena adherencia a las instrucciones en lenguaje natural. Útil para equipos sin flujos de máscara dedicados que aun así necesitan cambios concretos.
- Edit Fast by Reve: Edición de fotos rápida y guiada por prompts. Buena para cambios rápidos de fondo, modificaciones de objetos y pasadas iterativas de retoque.
- Flux Depth Pro: Edición con conciencia de profundidad que conserva la estructura espacial mientras modifica los detalles superficiales. Especialmente útil en fotos de arquitectura y producto donde la geometría 3D de la escena debe mantenerse precisa.
Potencias centradas en la generación
Para la generación pura de texto a imagen, estos modelos elevan al máximo el listón de calidad en PicassoIA:
- Seedream 5 Pro: Genera imágenes nítidas de 2K con una adherencia al prompt excepcional. Especialmente destacado en sujetos humanos fotorrealistas y escenas compositivamente complejas.
- Ideogram v4 Quality: Resultados fotorrealistas excelentes, con un razonamiento compositivo sólido. Fiable para resultados de generación controlados y repetibles, donde la constancia importa entre lotes.
- Reve 2.1: Modelo flexible de doble modo que gestiona tanto la generación como la edición. Buena opción de entrada si cambias de modo con frecuencia dentro de un mismo proyecto.
- Stable Diffusion 3: Modelo abierto fiable, con amplio soporte de prompts y resultados coherentes en estilos visuales y temáticas diversas.
- Flux Redux Dev: Genera variaciones de imagen a partir de una imagen de referencia. Se sitúa entre la generación pura y la edición en su comportamiento, útil cuando quieres variedad que siga anclada a un punto de partida visual.
Combinar ambos enfoques en secuencia
Los flujos de producción más eficaces no obligan a elegir entre dos opciones. Usan la generación y la edición en secuencia sobre el mismo recurso:
- Genera una imagen base que tenga bien la composición, la iluminación y el ambiente
- Edita esa imagen generada para corregir elementos concretos: sustituye por tomas de producto reales mediante inpainting, corrige rostros, modifica los fondos para distintos contextos
- Repite pasadas de edición dirigidas para cada variación de resultado que necesites
Este proceso produce imágenes generadas con la precisión de las editadas. Es un poco más lento por imagen final, pero te da control creativo en ambas etapas, lo que significa menos reinicios completos cuando algo está cerca pero no del todo bien.
💡 Consejo: Genera a una resolución más alta que tu objetivo final y edita después a la resolución objetivo. Reducir el tamaño antes de editar da al modelo más información visual con la que trabajar y produce resultados más limpios.
La decisión en dos preguntas
No necesitas un árbol de decisión complejo para elegir el modo correcto. Dos preguntas cubren todos los escenarios:
¿Tienes una imagen de origen que necesitas conservar?
- Sí: modo de edición, siempre.
- No: pasa a la segunda pregunta.
¿Tu resultado tiene que coincidir exactamente con un objeto real existente, un recurso de marca o una persona?
- Sí: consigue o haz primero una imagen de origen y luego edita.
- No: genera desde cero.
Todo lo demás, incluido el estilo del prompt, la elección de resolución y el número de iteraciones, depende de esta decisión. Acierta primero con esta.
Empieza a crear en PicassoIA
Ambos enfoques mejoran cuanto más los uses en proyectos reales. La forma más rápida de desarrollar esa intuición no es leer sobre la diferencia, sino pasar trabajo real por los dos modos y ver dónde divergen los resultados.
PicassoIA te da acceso a más de 90 modelos de texto a imagen en un solo lugar, incluidas las opciones orientadas a la edición y a la generación que aparecen arriba. No tienes que comprometerte con una única herramienta para siempre. Empieza por hacer coincidir el modo con la tarea usando las dos preguntas de arriba, ejecuta tu primer lote de resultados y deja que el resultado te diga qué refinar.
Todos los equipos que se dan bien con las imágenes de IA llegaron ahí de la misma manera: proyectos reales, resultados reales, iteración real. Empieza con Flux Kontext Fast si la edición es tu flujo de trabajo principal, o con Seedream 5 Pro si generas desde cero. Ambos están disponibles ahora en picassoia.com/en/all-models. Tu primer resultado está a un prompt de distancia.


