En cuanto OpenAI lanzó GPT Image 2.0, cada profesional creativo que llevaba tiempo probando en silencio herramientas de imagen con IA empezó a prestarle más atención. No por el ruido que la rodea, sino por algo más concreto: la distancia entre lo que describes y lo que recibes se ha reducido de maneras que importan en producción. La iluminación se comporta de forma más natural. La tela parece tela. Los rostros se mantienen coherentes entre iteraciones.
Este es un análisis de cómo se comporta GPT Image 2.0 en casos de uso profesionales reales, desde la fotografía de producto y los retratos editoriales hasta la visualización arquitectónica y el contenido para redes sociales. Sin benchmarks sintéticos, solo lo que ocurre de verdad cuando lo integras en un flujo de trabajo creativo diario, donde los plazos de los clientes son reales y las revisiones cuestan tiempo.
El salto respecto a modelos anteriores no está solo en la resolución o la velocidad. Está en la precisión semántica. GPT Image 2.0 interpreta prompts complejos y con varias capas con una fidelidad en la que los modelos previos solían tropezar.
La fidelidad al prompt tiene una nueva base
Hace un tiempo, en la historia de la generación de imágenes con IA, la ingeniería de prompts era básicamente un parche para las limitaciones de los modelos. Escribías "luz cálida de tarde desde la izquierda" y recibías una iluminación plana y cenital. Describías "profundidad de campo superficial de 85 mm" y obtenías una imagen uniformemente nítida, sin profundidad alguna. GPT Image 2.0 interpreta las indicaciones fotográficas con más fidelidad. No se limita a emparejar palabras clave; construye imágenes donde la iluminación, el ángulo y las características de la lente encajan como un sistema.
Para un flujo de trabajo creativo, esto es importante. Reduce el ciclo de iteración de "generar hasta que aparezca algo aceptable" a "generar y refinar con precisión".
El refinamiento en varios turnos cambia el proceso
Una de las ventajas centrales de GPT Image 2.0 en la producción es su soporte nativo para la edición de imágenes en varios turnos. Puedes describir una imagen base, generarla y luego dar instrucciones de seguimiento sin empezar de cero. Cambia el color de una superficie. Modifica la expresión del modelo. Reencuadra la composición con un recorte más cerrado.
Esto se parece más a trabajar con un retocador humano mediante un brief que a manejar una granja de render. En los flujos editoriales, donde la dirección de arte evoluciona a lo largo de una sesión, esa forma conversacional supone un ahorro de tiempo real.

Fotografía de producto: donde se gana su lugar
La fotografía de producto es una de las pruebas más claras para cualquier modelo de imagen con IA. Los requisitos son concretos: geometría precisa, iluminación coherente, superficies limpias y ningún artefacto de alucinación en la forma del producto. Los clientes notan cuando una botella está deformada, cuando los reflejos se comportan mal o cuando las sombras contradicen la fuente de luz.
Tomas de producto sobre fondo limpio
Para las tomas aisladas de producto sobre fondos blancos o neutros, GPT Image 2.0 rinde a nivel profesional. El modelo maneja los brillos especulares del vidrio, la translucidez de los líquidos y el detalle fino de la superficie en los envases con la precisión suficiente para servir como herramienta de prototipado rápido en revisiones creativas.
💡 Usa GPT Image 2.0 para las presentaciones de primera ronda con clientes y para las aprobaciones de conceptos en fase temprana. Reduce el costo de las sesiones exploratorias antes de comprometerte con un montaje en estudio.
Una vez que tengas el resultado que quieres, herramientas como Clarity Pro Upscaler y Topaz Image Upscale en PicassoIA pueden llevar la resolución a calidad apta para impresión en un solo paso, con ampliaciones de hasta 6x y una introducción mínima de artefactos.
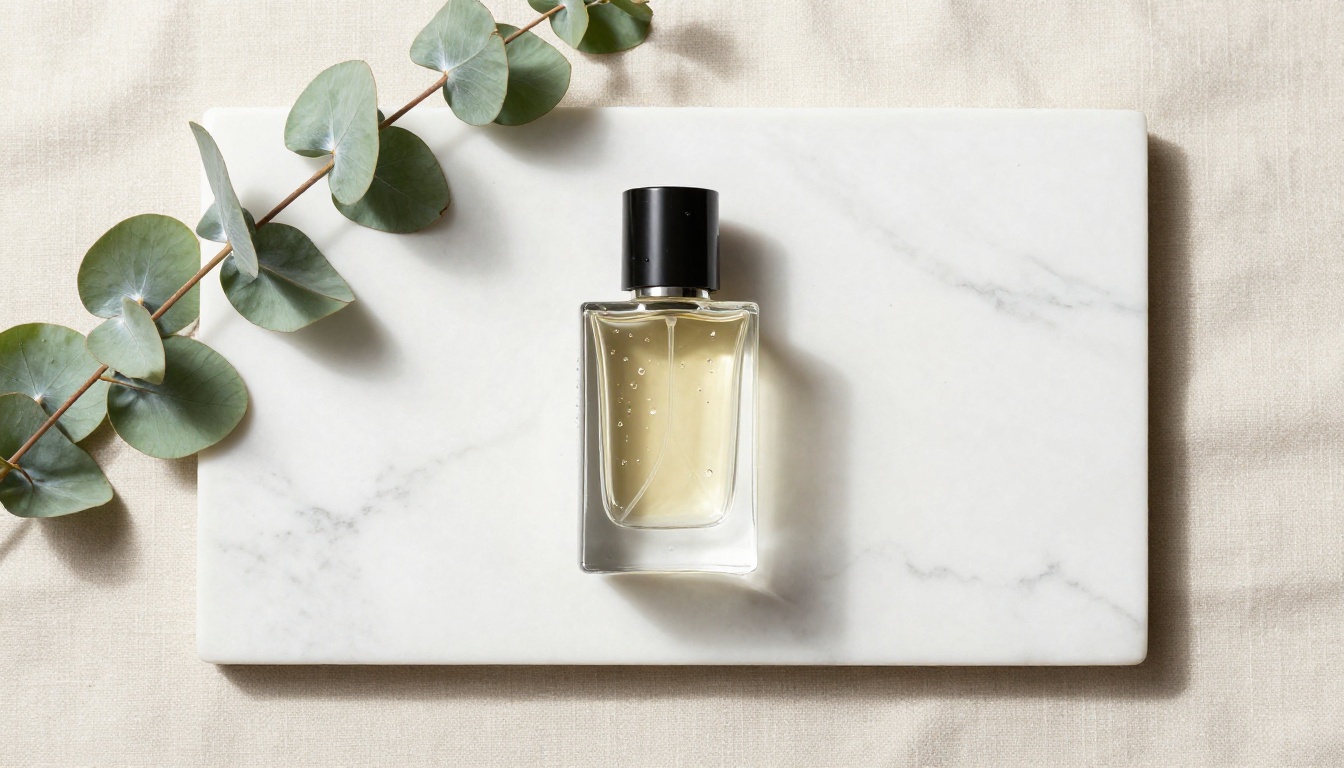
Tomas de estilo de vida y de contexto
Colocar un producto en un contexto de estilo de vida exige que el modelo equilibre dos prioridades: el producto debe verse fiel al original, y el entorno que lo rodea debe resultar auténtico. GPT Image 2.0 lo hace mejor que los modelos anteriores, pero sigue necesitando prompts precisos. Las descripciones vagas producen resultados genéricos. La dirección de arte específica produce contenido utilizable.
Un prompt como "un frasco de cosmética de lujo sobre una encimera de granito negro húmedo, luz matinal de baño que entra por una ventana esmerilada en un ángulo de 45 grados, objetivo de 60 mm, enfoque poco profundo" produce un resultado notablemente más controlado que "producto de cosmética en un baño". La precisión es la instrucción.
Trabajo editorial y de retrato
Retratos con textura plausible
Históricamente, el trabajo de retrato en la generación de imágenes con IA ha producido piel que parece artificial: demasiado lisa, demasiado simétrica, demasiado uniforme. GPT Image 2.0 introduce suficiente microvariación en la textura de la piel, caída de luz a través de los planos faciales y asimetría natural como para producir retratos que aguantan a escala editorial.
El modelo todavía tiene dificultades con los primeros planos extremos, donde la estructura fina de los poros de la piel es el sujeto principal. Sin embargo, a distancias editoriales típicas, el resultado es lo bastante convincente para tableros de inspiración, contenido para redes sociales y presentaciones conceptuales de campañas.
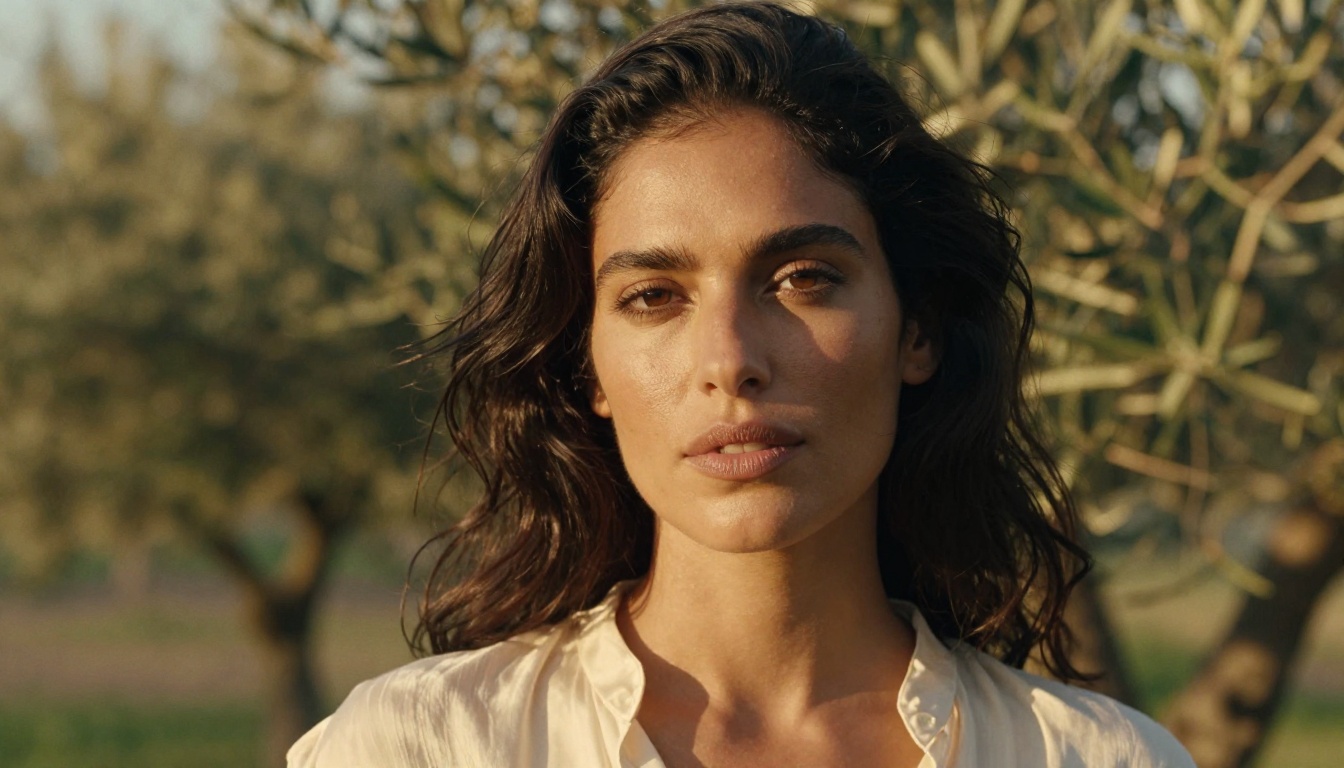
Coherencia a lo largo de una sesión
Una limitación que se hace evidente pronto en los flujos editoriales es la coherencia del sujeto. GPT Image 2.0 no mantiene una identidad estricta entre llamadas de generación separadas. Si generas un "modelo con cabello ondulado oscuro y rasgos mediterráneos" en un prompt, la siguiente generación de la misma sesión puede producir una persona sutilmente distinta.
En campañas que requieren un rostro coherente a lo largo de una serie de imágenes, esto es una restricción real del flujo de trabajo. La solución práctica es generar varias variaciones en una sola sesión, revisarlas juntas, seleccionar los mejores resultados y después usar la edición en varios turnos para refinar esos resultados concretos, en lugar de generar otros nuevos desde cero.
💡 Para series editoriales, genera de 8 a 12 variaciones en una sola sesión. Selecciona las dos mejores como referencia y refina a partir de ahí. Empezar de cero cada vez rompe la coherencia.
Arquitectura y visualización de interiores
Tableros de concepto para el diseño espacial
Arquitectos y diseñadores de interiores tienen un caso de uso inmediato para GPT Image 2.0: la visualización rápida de conceptos. Describir un espacio, su paleta de materiales y sus condiciones de iluminación produce resultados que comunican la intención espacial a los clientes sin necesidad de un pipeline de render 3D.
El modelo representa bien los materiales habituales de interiores: hormigón vertido, madera pulida, terrazo, vidrio y lino. Interpreta las condiciones de luz natural, incluida la calidad de la luz que atraviesa distintas configuraciones de ventanas, con una precisión que sorprende de verdad a profesionales del diseño escépticos.
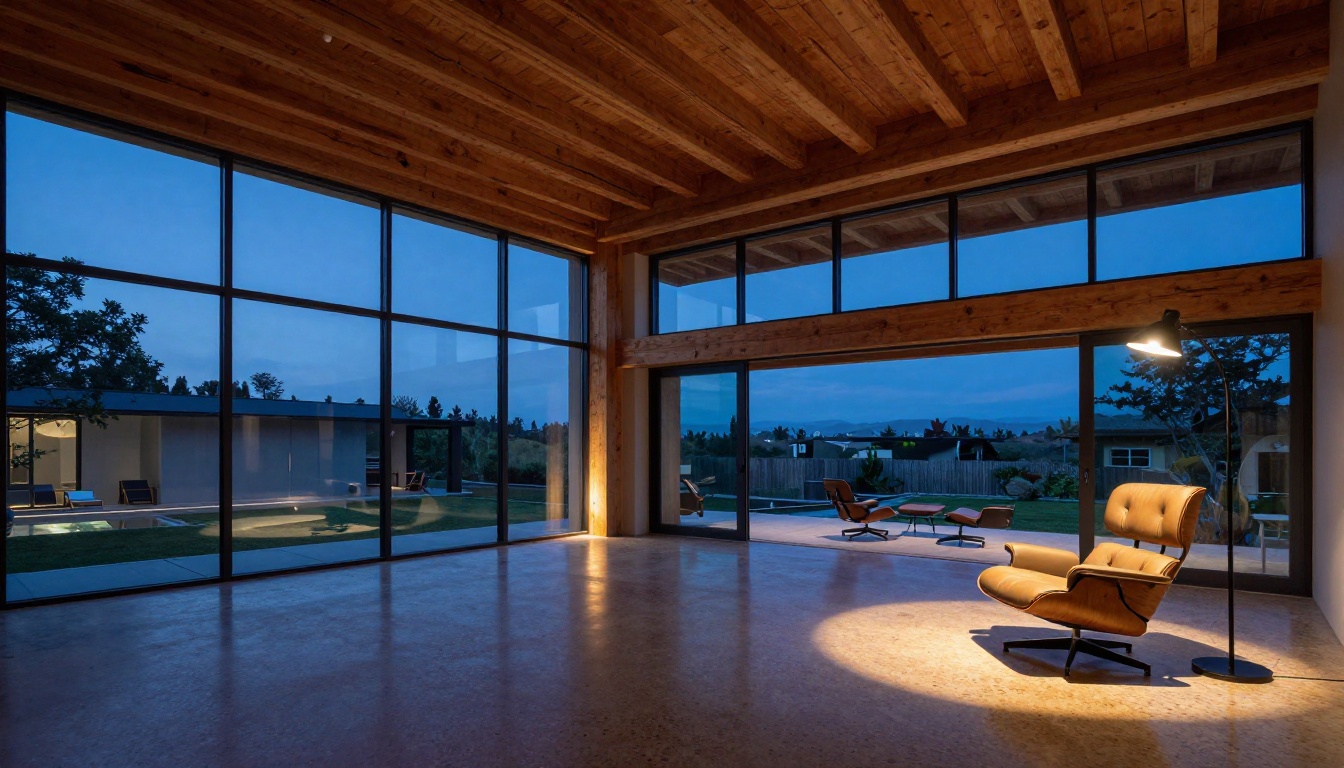
Dónde se rompe la precisión espacial
GPT Image 2.0 no garantiza la precisión arquitectónica. No sabe que una ventana con una orientación concreta produce un ángulo de sombra específico en una latitud y una época del año determinadas. Produce lo que parece plausible, no lo que es técnicamente correcto. Para una visualización a nivel esquemático, esto importa. Para tableros de inspiración y comunicación con clientes, suele ser más que suficiente.
| Caso de uso | Adecuación de GPT Image 2.0 | Notas |
|---|
| Tablero de inspiración y concepto | Excelente | La velocidad y la variedad son ventajas importantes |
| Presentación al cliente | Muy buena | Requiere precisión en el prompt para la fidelidad de los materiales |
| Precisión esquemática | Limitada | No sustituye al software de render técnico |
| Referencia de biblioteca de materiales | Buena | Los materiales habituales se representan de forma convincente |
Contenido de comida y estilo de vida
Fotografía comercial de comida
La fotografía de comida es una prueba exigente porque el atractivo visual depende de detalles finos: el vapor, la condensación, el caramelizado, la consistencia de la salsa. GPT Image 2.0 maneja las imágenes de comida con una calidad lo bastante útil para contenido en redes sociales y conceptos iniciales de campaña.
La corteza del pan se ve texturizada y real. Las salsas tienen un brillo adecuado. El vapor se representa como un elemento suave y naturalista, no como un efecto de dibujos animados. Cuando la iluminación se especifica correctamente, se comporta como debe hacerlo la iluminación de fotografía de comida en estudio.
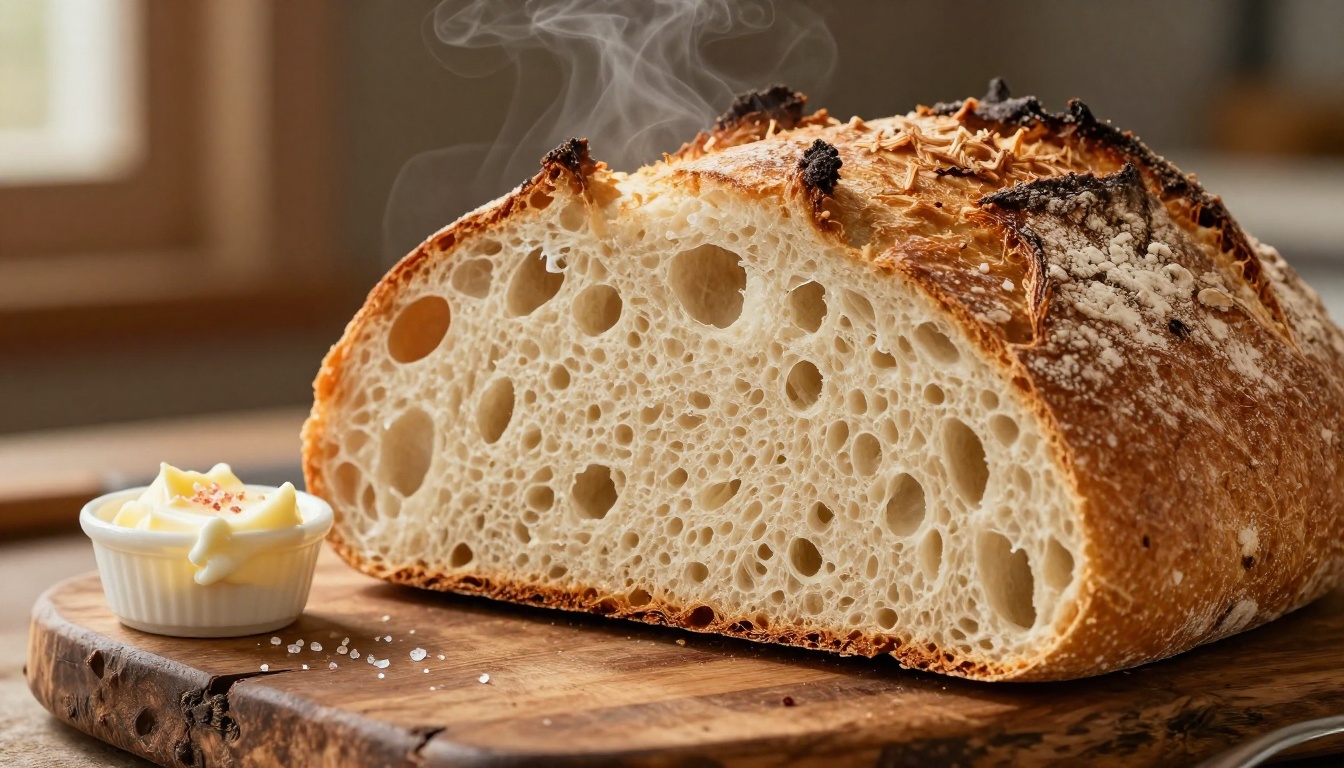
Contenido de viajes y localizaciones
Para las marcas que necesitan imágenes de estilo de vida ambientadas en localizaciones, GPT Image 2.0 puede producir entornos culturalmente específicos con una precisión sorprendente cuando recibe prompts detallados. La textura del yeso envejecido, la calidad de la luz en climas concretos y la profundidad de los entornos de fondo se representan con autenticidad.
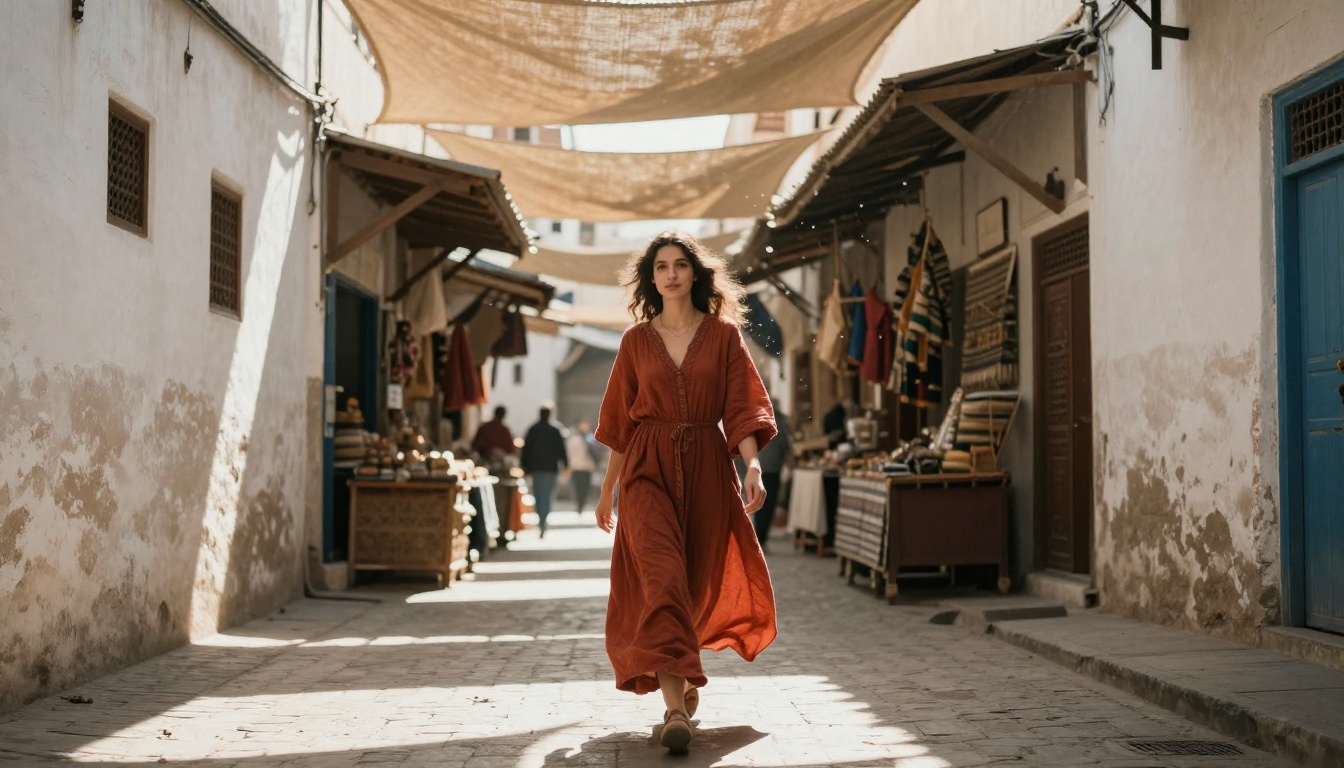
Esto no sustituye a las sesiones en localizaciones reales, pero ofrece una primera ronda rentable para la planificación de contenido, las presentaciones de estrategia visual y el contenido para redes sociales donde los presupuestos de producción son limitados.
GPT Image 2.0 en tu proceso de producción
El papel que desempeña en realidad
El error más común que cometen los equipos creativos al adoptar la generación de imágenes con IA es verla en términos binarios: o sustituye a la fotografía o no la sustituye. El planteamiento más preciso es que GPT Image 2.0 cambia la estructura de costos de etapas concretas de un proceso de producción.
- Preproducción: visualización de conceptos, tableros de inspiración, referencias de dirección de arte
- Apoyo a la producción: contenido de relleno, variantes para redes sociales, extensiones de campaña
- Postproducción: composición de elementos, generación de fondos, colocación de accesorios
Funciona mejor cuando el resultado no necesita coincidir exactamente con una persona o un producto real concreto. Es menos adecuado para situaciones en las que la fidelidad exacta del producto es un requisito legal o contractual.
Escalado y acabado
Los resultados de GPT Image 2.0 suelen tener una resolución moderada. Para impresión o aplicaciones digitales de gran formato, necesitarás escalarlos. El escalado con IA ha alcanzado un nivel de calidad que combina bien con estos resultados.
En PicassoIA, Real ESRGAN ofrece un escalado 4x fiable para contenido fotorrealista. Para trabajos con mucho retrato, Crystal Upscaler está ajustado específicamente para preservar el detalle facial. Para la máxima calidad de salida, Topaz Image Upscale admite ampliaciones de hasta 6x con una introducción mínima de artefactos. Si buscas una alternativa más rápida, P Image Upscale ofrece resultados nítidos en menos de un segundo.
💡 Genera con GPT Image 2.0 y después escala para el resultado final. Este enfoque en dos pasos siempre supera a intentar generar a la máxima resolución en un solo paso.
Eliminación de fondo para la composición
Cuando los elementos generados con GPT Image 2.0 deben componerse sobre fotografía real o diseños existentes, la eliminación limpia del fondo se vuelve esencial. La herramienta Background Removal de PicassoIA trabaja con imágenes generadas por IA con la misma precisión que aplica a las fotografías, conservando el detalle fino de los bordes en el cabello y en las formas complejas de producto.
Limitaciones reales con las que vas a topar
La longitud del prompt no escala de forma lineal
Existe la suposición común de que los prompts más largos y detallados siempre producen mejores resultados. En la práctica, GPT Image 2.0 tiene un punto de rendimientos decrecientes en la complejidad del prompt. Más allá de cierto nivel de detalle, el modelo empieza a ponderar los elementos de forma desigual: algunos detalles especificados aparecen, otros se ignoran y la imagen en conjunto puede volverse menos coherente en lugar de más precisa.
La zona eficaz es un prompt enfocado y estructurado que especifique el sujeto, el entorno, la dirección de la luz, las características de la cámara y uno o dos detalles de material. Más allá de eso, importa más la selección que la exhaustividad.
La representación de texto sigue siendo poco fiable
El texto en las imágenes sigue siendo uno de sus puntos débiles. GPT Image 2.0 es notablemente mejor que los modelos anteriores generando texto legible, pero, para cualquier cosa más allá de una palabra o una frase corta, los errores son frecuentes. En señalización, envases o cualquier imagen que requiera un texto concreto, el resultado debe tratarse como base para una corrección en postproducción.
💡 Genera la imagen sin texto y añádelo después con software de diseño. Así se obtienen resultados más limpios que luchar con el modelo para representar el texto.
Manos y extremidades
La representación de manos y dedos sigue siendo irregular. La mayoría de los resultados son aceptables, pero las posturas complejas de las manos o los primeros planos de manos realizando tareas detalladas producen artefactos con cierta regularidad. En composiciones centradas en las manos, incluye tiempo de iteración en tu flujo de trabajo.
Estructuras de prompt que realmente funcionan
La estructura de prompt más fiable para resultados de calidad de producción sigue un patrón constante.
Sujeto y posición: sé específico sobre lo que aparece en el encuadre y lo que está sucediendo.
Entorno: describe el escenario inmediato con detalles de material y espacio.
Iluminación: dirección, calidad (suave o dura), temperatura de color y tipo de fuente.
Cámara: distancia focal, apertura, distancia al sujeto.
Textura y atmósfera: uno o dos detalles concretos de material o de ambiente.
| Elemento del prompt | Versión débil | Versión fuerte |
|---|
| Iluminación | "Luz natural" | "Luz matinal difusa desde una ventana orientada al norte" |
| Cámara | "Primer plano" | "Objetivo macro de 100 mm f/4, sujeto ocupando el 60 % del encuadre" |
| Entorno | "Escenario de estudio" | "Superficie de mármol blanco con vetas sutiles, fondo de lino" |
| Textura | "Realista" | "Trama de tela visible, cuero de grano fino, brillo mate de cerámica" |
Seguir esta estructura no garantiza resultados perfectos, pero reduce considerablemente la variación entre lo que pretendes y lo que produce el modelo.
Moda y trabajo de campañas
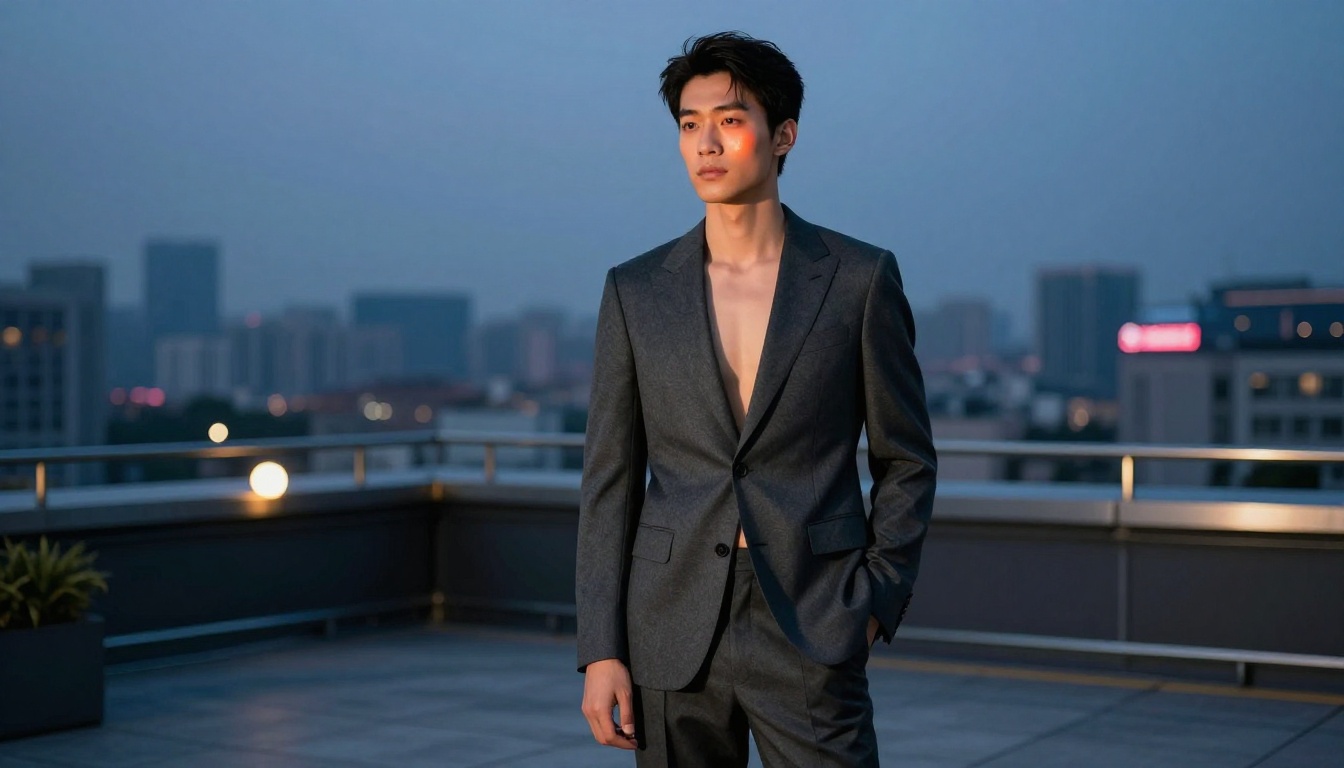
El contenido de moda exige que el modelo maneje la textura de la prenda, la caída de la tela y el movimiento de forma convincente, y que represente al sujeto de un modo que parezca editorial y no genérico. GPT Image 2.0 maneja la tela con más matices que los modelos anteriores: la lana tiene peso visual, la seda parece seda y las prendas en capas se comportan con una lógica física adecuada.
En el trabajo de campañas, la limitación sigue siendo la coherencia del sujeto entre tomas. Construye tu flujo de trabajo en torno a esta restricción en lugar de en contra de ella. Genera planos abiertos, selecciona con criterio y refina en lugar de volver a generar desde cero.
Empieza a crear con tus propios briefs
La prueba real de cualquier herramienta no es lo que puede hacer en condiciones ideales, sino lo que hace cuando le das tu brief concreto, tu dirección de arte y tus requisitos estéticos. GPT Image 2.0 no sustituye a una visión creativa. Es una capa de ejecución rápida y capaz que responde a una buena dirección.
PicassoIA reúne en un solo lugar una biblioteca completa de herramientas de imagen con IA, desde modelos de texto a imagen con más de 91 opciones, hasta upscalers especializados como Clarity Pro Upscaler y herramientas de postproducción como Background Removal, todo ello accesible sin gestionar claves de API ni computación local.
Empieza con uno de tus briefs existentes. Dale tu prompt de producto habitual o tu brief editorial y observa dónde aterriza el resultado. El costo de iterar es bajo, la curva de aprendizaje es real pero corta, y para la mayoría de los profesionales creativos que pasan tiempo en producción, la primera vez que te ahorra tres horas en una ronda de conceptos, la pregunta cambia de "¿debería usar esto?" a "¿dónde más encaja esto?"


