En los últimos dos años ha cambiado algo, y casi nadie se dio cuenta. Las voces generadas por IA dejaron de delatarse. Dejaron de sonar a robots leyendo transcripciones y empezaron a sonar a personas conversando. No a personas perfectas, ni a presentadores de noticias excesivamente articulados, sino a personas reales, con ritmo, vacilaciones, calidez y peso detrás de sus palabras. Este artículo explica con detalle por qué ocurrió, cómo funciona la tecnología por dentro y qué modelos son responsables del mayor salto adelante en la historia de la síntesis de voz.
Por qué las voces de IA antiguas sonaban mal
Durante gran parte de los años 2000 y 2010, los sistemas de texto a voz partían de una premisa sencilla: dividir el habla en fonemas, unirlos y reproducirlos. El problema estaba en la unión. El habla humana no es una serie de unidades de sonido discretas colocadas una detrás de otra. Fluye. Las sílabas se funden unas con otras. La cola de una palabra da forma al inicio de la siguiente.
Las costuras que lo delataban
Los primeros sistemas de síntesis concatenativa tomaban pequeños fragmentos de audio de una base de datos de habla grabada y los pegaban entre sí. Los oyentes podían notar las uniones. Había una monotonía mecánica entre palabras, una uniformidad robótica en el tono que nunca variaba como lo hace el de una persona cuando está emocionada, cansada o de verdad divertida.
La síntesis paramétrica era algo más elegante, pero presentaba sus propios problemas. Estos sistemas generaban el habla a partir de modelos matemáticos del tracto vocal humano, pero los modelos eran demasiado simplificados. El resultado era suave pero hueco, el equivalente sonoro de una figura de cera: reconocible como humano en la forma, pero incorrecto en todos los matices sutiles.
Lo que los oyentes detectaban de verdad
La investigación en psicoacústica muestra que los oyentes humanos son extraordinariamente sensibles a la prosodia: la subida y bajada del tono, el momento de las pausas, el alargamiento sutil de las sílabas acentuadas. Las primeras voces de IA acertaban con las palabras, pero destrozaban la música del habla. Además, carecían de coarticulación, es decir, de la forma en que la lengua y los labios empiezan a prepararse para el siguiente sonido antes de terminar de producir el actual.
La arquitectura que lo cambió todo
La transición de voces de IA robóticas a voces con sonido humano no fue un avance único. Fue una sucesión de cambios de arquitectura, cada uno eliminando una capa de artificialidad.
WaveNet y la era de los vocoders neuronales
En 2016, DeepMind presentó WaveNet, una red neuronal profunda que generaba audio muestra a muestra aprendiendo los patrones estadísticos del habla humana real. En lugar de unir fragmentos o calcular parámetros del tracto vocal, WaveNet aprendió cómo suena realmente el habla a nivel de señal. El salto de calidad se notó de inmediato. Sin embargo, la arquitectura original era demasiado lenta para aplicaciones en tiempo real.
Los años siguientes trajeron variantes más rápidas: Parallel WaveNet, WaveRNN, HiFi-GAN. Cada una sacrificó algo de fidelidad a cambio de velocidad, sin perder la idea central: los vocoders neuronales entrenados con grandes corpus de habla real suenan de forma fundamental más naturales que cualquier cosa basada en métodos anteriores.
Transformers y el avance de la atención
El segundo gran cambio llegó con la adopción de arquitecturas transformer para el componente de modelado acústico del TTS. Los transformers usan mecanismos de autoatención que permiten al modelo considerar toda la secuencia de entrada a la vez, en lugar de procesarla un token cada vez.
En la síntesis de voz, esto significó que el modelo podía razonar sobre cómo debía sonar la palabra en la posición 47 según la trayectoria emocional de la oración a la que pertenece, y no solo según los fonemas vecinos inmediatos. El resultado fue una mejora notable en la coherencia prosódica a larga distancia. Las oraciones empezaron a sonar como si formaran un todo.
Qué hace que una voz parezca humana de verdad
Entender la tecnología es una cosa. Pero ¿qué intenta reproducir realmente el modelo? ¿Qué propiedades concretas hacen que una voz parezca real y no sintética?
La prosodia: la música dentro del habla
La prosodia se refiere a los patrones de acento, ritmo y entonación que transmiten significado más allá de las propias palabras. Cuando alguien dice "ah, ¿en serio?" con entonación plana, señala un reconocimiento cortés. Cuando lo dice con el tono subiendo y una pausa antes, muestra una sorpresa genuina. La palabra "en serio" no ha cambiado, pero su significado se ha transformado por completo.
Los modelos TTS actuales se entrenan con corpus enormes de habla con variedad emocional, a menudo con capas de anotación que etiquetan explícitamente los rasgos prosódicos. Así pueden modelar la relación entre significado, contexto y forma de entrega.
Respiración, pausas y lo inesperado
Las personas reales respiran. Tropiezan de vez en cuando con una palabra. Hacen una pausa antes de una afirmación sorprendente. Acortan las vocales al hablar deprisa y las estiran al enfatizar. Modelos actuales como ElevenLabs V3 se entrenan específicamente para reproducir estas microvariaciones, porque la ausencia de ellas es exactamente lo que hacía que las voces de IA antiguas resultaran extrañas.
💡 El valle inquietante del habla no tiene que ver con los errores. Tiene que ver con la ausencia de esas imperfecciones sutiles que señalan autenticidad.
Emoción e intención
La generación más reciente de modelos de voz va más allá: intentan modelar la intención del hablante. No solo lo que dice, sino por qué lo dice y con qué estado interno. Modelos como Minimax Speech 2.8 HD pueden generar narraciones que cambian de peso emocional a lo largo de un pasaje largo, suavizándose en los momentos tiernos y tensándose en los dramáticos, sin que se les indique explícitamente que lo hagan.
Los modelos que marcan hoy el nuevo estándar
El sector se ha vuelto notablemente competitivo. Varios modelos lanzados en los últimos 12 meses han empujado el límite de lo posible en la síntesis neuronal de voz.
ElevenLabs V3 y V2 Multilingual
ElevenLabs V3 es actualmente uno de los modelos TTS de propósito general más expresivos que existen. Maneja el habla emocional con notable precisión y produce audio que pasa por humano en la mayoría de las pruebas de escucha casual. Su fortaleza está en la entrega matizada: el modelo no solo lee el texto, lo interpreta.
ElevenLabs V2 Multilingual amplía esa capacidad a más de 30 idiomas, manteniendo la autenticidad del acento y la naturalidad prosódica incluso en textos que no están en inglés. Para la producción de contenido global, es una capacidad muy valiosa.
ElevenLabs Flash v2.5 sacrifica algo de expresividad a cambio de velocidad, lo que lo convierte en la opción práctica para aplicaciones en tiempo real donde la latencia importa más que los matices.
Minimax Speech 2.8 HD y Turbo
Minimax Speech 2.8 HD está pensado para la producción de audio profesional. La salida tiene una profundidad y una calidez que los ingenieros de audio describen como algo que encaja bien en una mezcla. Maneja narraciones de larga duración sin los artefactos de fatiga que afectan a algunos modelos. Speech 2.8 Turbo funciona más rápido con una pérdida mínima de calidad y resulta adecuado para flujos de contenido de alto volumen.
Gemini 3.1 Flash TTS
Gemini 3.1 Flash TTS ofrece 30 voces distintas y compatibilidad con más de 70 idiomas. Su integración con la infraestructura de modelado de lenguaje de Google le da una capacidad contextual inusualmente fuerte. Puede analizar estructuras de oración complejas y producir una entrega que refleja el peso semántico de lo que se dice.
Qwen3 TTS y diseño de voz
Qwen3 TTS introduce una capacidad diferente: la posibilidad de clonar cualquier voz o diseñar una personalizada desde cero. Esto abre casos de uso que van más allá de la narración y llegan a la identidad y la personalización.
Cómo funciona realmente la clonación de voz
La clonación de voz es donde la tecnología empieza a parecer genuinamente extraña. La capacidad de tomar una muestra corta de audio de una persona real hablando y producir una versión sintética que coincida con su timbre, su acento y su ritmo plantea preguntas tan rápido como abre puertas.
Audio de referencia y condicionamiento del hablante
La clonación de voz moderna funciona mediante el condicionamiento del hablante: el modelo toma un clip de audio de referencia, extrae un embedding del hablante (una representación matemática de la identidad vocal) y usa ese embedding para limitar el proceso de síntesis. Todo lo que genera el modelo queda teñido por las características del hablante de referencia.
Minimax Voice Cloning gestiona este proceso con una muestra de referencia relativamente corta, normalmente de 10 a 30 segundos, y produce una salida que capta la frecuencia fundamental, la estructura de formantes y el ritmo de habla de la voz objetivo.
Resemble AI Chatterbox añade control de emoción, lo que te permite ajustar no solo la identidad de la voz, sino también el registro emocional de la salida del clon, desde lo calmado y medido hasta lo animado y urgente.
Lo que sí y lo que no se puede replicar
Los modelos actuales pueden reproducir el timbre, el rango tonal, el acento y el ritmo con gran fidelidad. Lo que todavía les cuesta es el conjunto completo de señales paralingüísticas que transmiten significado social: la calidad exacta de una risa nerviosa, la cadencia específica del sarcasmo en un acento regional, las microvariaciones de tiempo que codifican la edad y el estado de salud de un hablante.
Chatterbox Pro y PlayHT Play Dialog están entre los modelos que más se esfuerzan por superar estas limitaciones restantes, sobre todo en aplicaciones conversacionales y de diálogo.
Dónde las voces de IA ya llevan la voz cantante
El despliegue del TTS neuronal ya es mucho más amplio de lo que la mayoría de la gente imagina. Muchas interacciones con voces de IA pasan desapercibidas precisamente porque la tecnología ha mejorado lo suficiente como para no delatarse.
Podcasts, audiolibros y contenido a escala
Los podcasters independientes y los productores de audiolibros usan el TTS para producir contenido a una velocidad y un costo que antes no estaban al alcance. Un narrador que antes dedicaba 8 horas a grabar un audiolibro de 4 horas puede ahora producir un borrador completo en minutos y dedicar el tiempo ahorrado a la edición y la producción.
Modelos como ElevenLabs V2 Multilingual hacen viable localizar ese mismo audiolibro en 10 idiomas a la vez, manteniendo las características de voz del narrador original en todas las versiones.
Atención al cliente y automatización empresarial
Los centros de contacto han sido de los primeros en adoptar el TTS neuronal. El paso de los torpes sistemas IVR a agentes de voz que suenan a personas pacientes y serviciales ha reducido de forma medible la frustración de quienes llaman. Turbo v2.5 y TTS 1.5 Max impulsan muchos de estos sistemas, equilibrando velocidad y naturalidad para la interacción en tiempo real.
Accesibilidad
Para las personas con discapacidad visual o dificultades de lectura, un TTS de alta calidad no es una comodidad. Es acceso a la información. La mejora en la calidad de la voz tiene implicaciones directas para la dignidad: que te lea en voz alta una voz que suena presente y humana es muy distinto a que te lea una máquina.
Cómo crear tu propia voz de IA en PicassoIA
PicassoIA te da acceso directo a los modelos de texto a voz más capaces disponibles, sin la complejidad de una API ni configuraciones complicadas. Así se consigue un resultado profesional con rapidez.
Paso a paso con ElevenLabs V3
- Ve a ElevenLabs V3 en PicassoIA.
- Pega tu texto en el campo de entrada. Escribe con frases naturales y con puntuación, porque las comas y los puntos influyen directamente en el ritmo.
- Elige una voz de los ajustes predefinidos disponibles, o sube un clip de audio de referencia para la clonación de voz.
- Fija el parámetro stability más bajo para obtener una salida más expresiva y variada. Fíjalo más alto para una entrega constante y controlada.
- Pon el similarity boost alto si quieres que la salida se parezca mucho a una voz clonada.
- Genera y escucha. Descarga el resultado en WAV o MP3.
Consejos para obtener mejores resultados
- La puntuación da forma a la entrega. Los puntos suspensivos crean una pausa más larga que una coma. El signo de interrogación cambia el tono final de una oración. Úsalos con intención.
- Los segmentos cortos suenan más naturales. Dividir los párrafos largos en oraciones más breves antes de pasarlos al modelo suele producir un flujo prosódico mejor.
- El contexto emocional del texto importa. Modelos como ElevenLabs V3 responden al contenido semántico de lo que está escrito. Escribir diálogos con emoción producirá una entrega emocionalmente más apropiada sin configuración adicional.
- Para salida multilingüe, Gemini 3.1 Flash TTS funciona mejor cuando el texto está escrito de forma nativa en el idioma de destino, en lugar de traducirse a mitad del prompt.
💡 La mejor salida de TTS surge de pensar como un director de voz, no como un mecanógrafo. La forma en que escribes el texto es tan importante como el modelo que elijas para leerlo.
Lo que todavía no es perfecto
Sería poco honesto sugerir que el TTS neuronal ha resuelto todo. Todavía hay aspectos en los que la tecnología se delata.
Los casos límite que aún desorientan a los modelos
Los textos largos y muy técnicos, con nombres propios poco habituales o siglas, siguen produciendo una pronunciación desigual entre modelos. El humor es notoriamente difícil de transmitir con convicción, porque el ritmo cómico exige una microtemporización muy precisa que la mayoría de los modelos todavía no controla del todo. El sarcasmo, que en el habla humana se señala con una combinación muy concreta de rasgos prosódicos, sigue siendo un desafío real.
PlayHT Play Dialog está diseñado explícitamente para contenido conversacional y maneja el diálogo de varios turnos mejor que los modelos optimizados para la narración, pero incluso así a veces aplana la curva emocional al final de intercambios largos.
El otro problema persistente es la coherencia en documentos largos. Un modelo que genera un archivo de audio de 30 minutos puede desviarse ligeramente en su tratamiento de la voz entre el principio y el final. Minimax Speech 2.8 HD lo gestiona mejor que la mayoría, pero sigue siendo una limitación conocida de la arquitectura.
Por qué esto sigue importando
A pesar de estas limitaciones, la distancia entre "claramente sintético" y "posiblemente humano" se ha acortado tanto que las excepciones definen ahora lo más avanzado, en lugar de la referencia base. Hace un año, la naturalidad era el logro. Hoy, la conversación gira en torno a la precisión emocional y el control estilístico.
Pruébalo tú mismo
La distancia entre leer sobre el TTS neuronal y escucharlo de verdad es enorme. Ninguna descripción del modelado prosódico o de los mecanismos de atención transmite cómo suena cuando un modelo lee un pasaje triste y la voz suena un poco triste de verdad.
PicassoIA te da acceso inmediato a toda la gama de modelos que se comentan en este artículo. Puedes probar ElevenLabs V3 frente a Minimax Speech 2.8 HD con el mismo párrafo y escuchar la diferencia directamente. Puedes clonar una voz con Qwen3 TTS, probar Gemini 3.1 Flash TTS en varios idiomas o crear una pieza de audio narrada completa con Chatterbox Pro.
La tecnología ha cruzado un umbral significativo. Lo que venga después depende de lo que la gente haga realmente con ella.
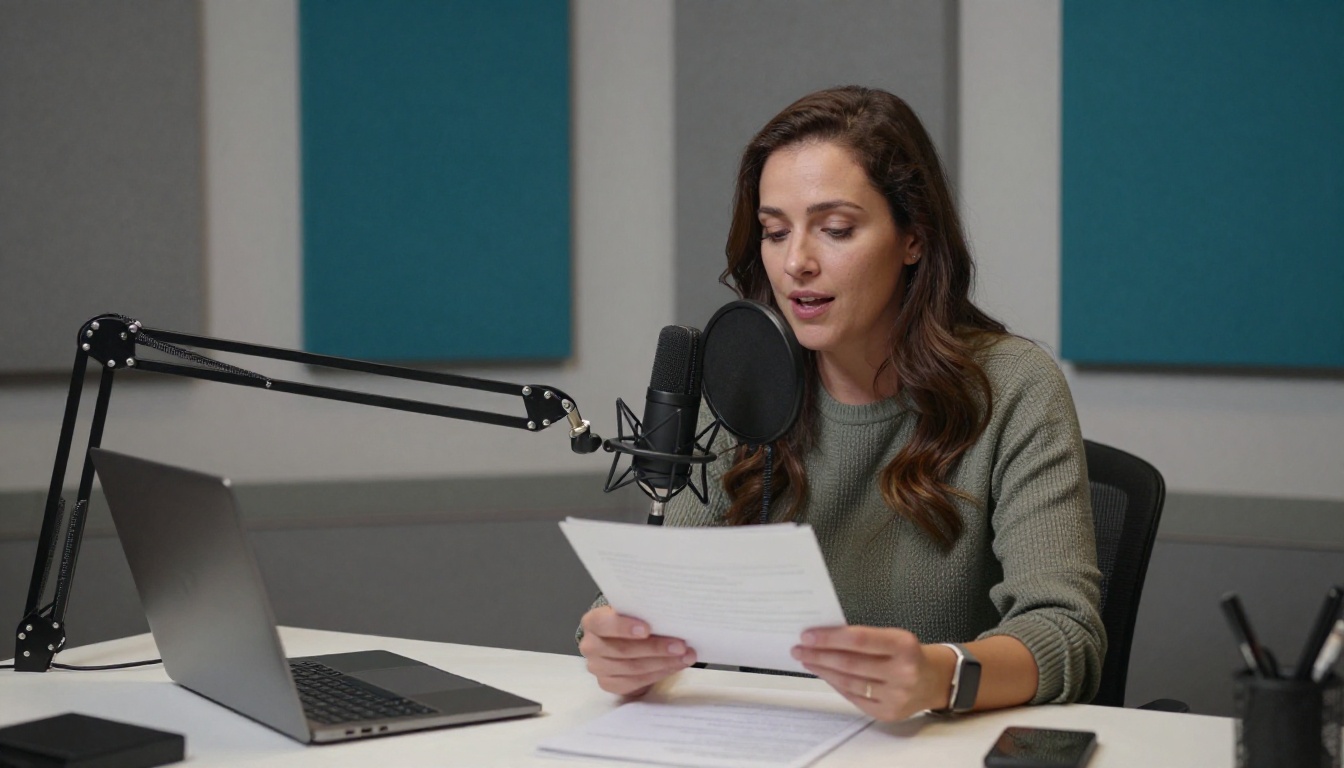
Empieza con un texto que te importe. Usa una voz que encaje con el tono. Escucha el resultado. Esa es la única forma de saber dónde está la tecnología en este momento.


