Todo fotógrafo conoce bien ese momento. Miras una fotografía que te encanta y piensas: ojalá tuviera algo de movimiento. Una ondulación en el agua, una brisa en el pelo, una leve inclinación de la cámara. Antes, eso requería un equipo de rodaje, un presupuesto y mucho tiempo. Seedance 2.0 cambia por completo la ecuación y convierte imágenes fijas en clips de video cinematográficos en cuestión de segundos.
Qué hace realmente Seedance 2.0
ByteDance creó Seedance 2.0 para abordar el problema más difícil del video con IA: lograr un movimiento que parezca real. No animado. No estilizado. Un movimiento real, físico y fotorrealista aplicado a una imagen estática. El modelo acepta como entrada tanto prompts de texto como imágenes, y genera clips de video con sincronización de audio nativa, una función que casi ningún otro modelo de este nivel incluye de serie.
Las imágenes fijas cobran vida
El flujo de trabajo principal es sencillo. Subes una fotografía o cualquier imagen, escribes una breve descripción del movimiento que quieres y, en cuestión de segundos, el modelo genera un clip de video. Las olas se mueven. Las hojas se balancean. El pelo de una persona se mueve con el viento. El fondo respira sutilmente con profundidad y paralaje. Los objetos que estaban congelados en un solo fotograma ahora ocupan espacio y tiempo.
Lo que lo hace impresionante no es solo que las cosas se muevan. Es cómo se mueven. El modelo ha sido entrenado para respetar las restricciones físicas: el agua fluye cuesta abajo, la tela cae por efecto de la gravedad y las fuentes de luz se mantienen coherentes a lo largo del clip. Esto no es una deformación de la imagen. Es física aprendida aplicada a contenido visual.
Audio nativo integrado
La mayoría de los modelos de video con IA producen resultados sin sonido. Generas el clip y luego gestionas el audio por separado con una herramienta como un modelo de texto a voz o un generador de música. Seedance 2.0 adopta un enfoque distinto. El modelo genera audio ambiental que coincide de forma nativa con el contenido visual, sin necesidad de un flujo de trabajo aparte. Una escena de playa tiene el sonido de las olas. Una calle de la ciudad tiene tráfico ambiental y viento. Un primer plano de lluvia tiene el repiqueteo específico de las gotas sobre una superficie.
Solo esto ahorra un número considerable de pasos a los creadores que quieren un resultado pulido sin un largo proceso de posproducción.
Por qué Seedance 2.0 es diferente
Hoy hay muchos modelos de imagen a video disponibles. Kling V3, Veo 3, Hailuo 2.3 y Wan 2.6 I2V producen resultados excelentes en las condiciones adecuadas. Entonces, ¿qué sitúa a Seedance 2.0 en una categoría propia?
Velocidad sin pérdida de calidad
La versión estándar de Seedance 2.0 genera clips con un nivel de calidad que antes requería modelos con tiempos de inferencia mucho más largos. Mientras que la competencia a menudo obliga a elegir entre velocidad y fidelidad, Seedance 2.0 combina ambas cosas. ByteDance también lanzó Seedance 2.0 Fast para los casos en los que la velocidad de iteración importa más que la máxima calidad, lo que ofrece a los creadores dos modos de uso útiles.
💡 Consejo: Usa Seedance 2.0 Fast para hacer prototipos rápidos y probar prompts de movimiento. Cambia a Seedance 2.0 completo para el resultado final cuando la calidad sea crítica.
El problema de la física, resuelto
Aquí es donde tropiezan la mayoría de los modelos de video con IA. Producen un movimiento que parece una secuencia de sueño, con objetos que se deslizan y deforman de formas que resultan extrañas a la vista. Los rostros se distorsionan ligeramente en los límites del movimiento. El agua se mueve, pero no refleja bien. El pelo fluye, pero pierde la estructura de sus mechones.
Seedance 2.0 aborda esto mediante una mayor coherencia temporal y una conciencia de la simulación física integrada en el entrenamiento del modelo. En la práctica, el resultado es que los clips generados se mantienen sólidos durante toda su duración, sin los artefactos sutiles que rompen la ilusión de una grabación real.
Cómo es el resultado
La mejor forma de entender lo que produce un modelo es ver qué hace con distintos tipos de entrada.
Escenas del mundo real
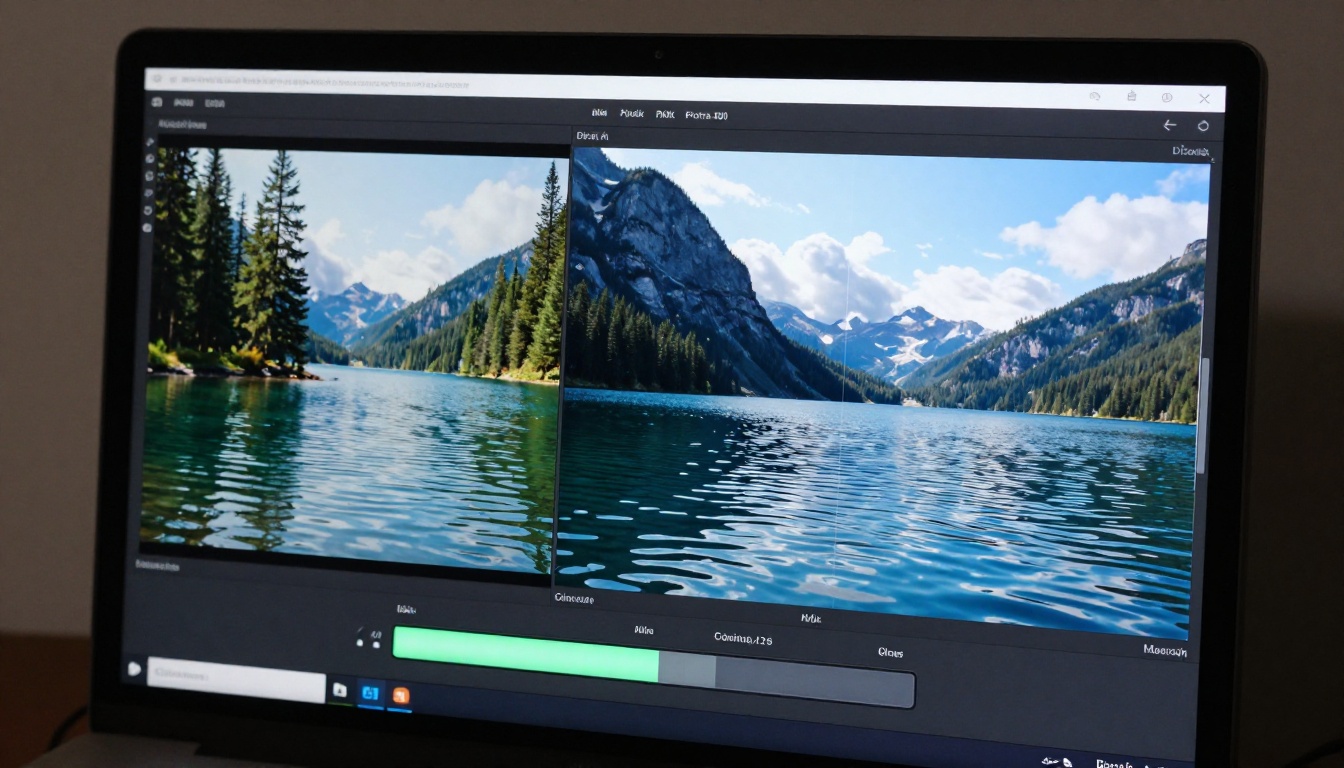
Seedance 2.0 funciona de forma más convincente con los paisajes. Sube una fotografía de un lago de montaña y describe una brisa suave sobre la superficie. El resultado muestra ondas de agua realistas que se extienden desde la orilla más cercana, reflejos de la línea de árboles que se desplazan ligeramente con el movimiento del agua y una leve respiración de cámara que da al clip una sensación de documental grabado a mano. Los bordes del encuadre mantienen su posición correctamente, sin la deformación que afecta a los modelos más antiguos.
La fotografía de naturaleza, las imágenes de viaje y las tomas arquitectónicas responden todas de forma excepcional al modelo. Cuanto más detalle físico tenga la imagen original, más tiene Seedance 2.0 con lo que trabajar.
Retratos y personas
La animación de retratos es un reto más difícil, porque el ojo humano está entrenado para detectar la menor imperfección en la forma en que se mueve una persona. Una rotación de cabeza ligeramente antinatural, unos ojos que parpadean con un ritmo incorrecto o un pelo que se mueve como una sola masa en lugar de mechón a mechón delatan de inmediato la IA ante cualquier espectador.
Seedance 2.0 gestiona esto con notable cuidado. Los sujetos de retrato ganan movimientos sutiles: un giro suave de la cabeza, una respiración que desplaza un poco los hombros, un ciclo de parpadeo natural. El movimiento es deliberadamente contenido, y eso es lo acertado. El movimiento sutil resulta más convincente que la animación dramática cuando se trata de rostros y retratos.
Seedance 2.0 frente a otros modelos
Esta es una comparación directa de los modelos más relevantes para la generación de imagen a video, centrada en los factores que importan en un uso creativo real:
| Modelo | Velocidad | Audio | Física | Ideal para |
|---|
| Seedance 2.0 | Rápida | Sí (nativo) | Excelente | Todo tipo de contenido |
| Seedance 2.0 Fast | Muy rápida | Sí | Buena | Iteración rápida |
| Kling V3 | Media | No | Excelente | Calidad cinematográfica |
| Veo 3 | Media | Sí | Muy buena | Escenas fotorrealistas |
| Hailuo 2.3 | Rápida | No | Buena | Contenido para redes sociales |
| Wan 2.6 I2V | Media | No | Buena | Movimiento estilizado |
| LTX 2.3 Pro | Rápida | Sí | Buena | Flujos de trabajo de creadores |
La tabla deja clara la posición. Seedance 2.0 es el único modelo de este nivel que combina inferencia rápida, audio nativo y una excelente simulación de física en un mismo paquete. La contrapartida es que necesita una imagen de entrada de calidad razonablemente alta. Las fotografías de origen borrosas o de baja resolución producirán resultados notablemente más débiles que los originales nítidos y bien expuestos.
Cómo usar Seedance 2.0 en PicassoIA
PicassoIA te da acceso directo a Seedance 2.0 sin necesidad de una cuenta de API aparte ni de una configuración técnica. Así se pasa de la subida al video terminado, paso a paso.
Paso 1: sube tu imagen
Ve a la página del modelo Seedance 2.0 en PicassoIA. Haz clic en el área de subida de imagen y selecciona tu fotografía de origen. El modelo acepta los formatos JPEG, PNG y WebP. Para obtener mejores resultados, usa una imagen de al menos 1024 píxeles de ancho. Evita las imágenes muy comprimidas con artefactos visibles, porque el modelo intentará animar esos artefactos de compresión junto con el contenido real.
💡 Consejo: Las imágenes con una separación de profundidad clara entre el primer plano y el fondo producen el paralaje más convincente en el clip generado.
Paso 2: escribe tu prompt de movimiento
Este es el paso más importante y en el que más personas se quedan cortas. El prompt debe describir el movimiento, no la escena. El modelo ya ve la escena. Lo que necesita saber es cómo deben moverse las cosas.
Prompt débil: "Una playa con olas y palmeras."
Prompt sólido: "Olas suaves del océano rompiendo hacia la orilla, hojas de palmera meciéndose lentamente con una brisa ligera, cámara quieta."
Describe la dirección del movimiento, la velocidad (lenta, suave, rápida) y cualquier movimiento de cámara (acercamiento lento, leve inclinación hacia arriba, estática). Cuanto más específica sea la descripción del movimiento, más controlado será el resultado.
Paso 3: ajusta la duración y la calidad
La interfaz de PicassoIA para Seedance 2.0 te permite elegir entre varias opciones de duración, normalmente de 3 a 10 segundos. En la mayoría de los casos, de 5 a 7 segundos es el punto ideal: lo bastante largo para parecer una grabación real y lo bastante corto para mantener la coherencia temporal a lo largo de todo el clip.
Si usas Seedance 2.0 Fast para iterar, mantén la duración entre 3 y 5 segundos para reducir el tiempo de generación y los créditos gastados mientras pruebas distintos prompts.
Paso 4: genera y descarga
Pulsa generar y espera a que termine la inferencia. La plataforma muestra el resultado directamente en el navegador. Revisa el clip por si hay algún problema antes de descargarlo. Si el movimiento parece demasiado fuerte o no del todo acertado, ajusta el prompt y vuelve a generar. Como la plataforma gestiona la infraestructura de inferencia, no tienes que configurar nada en el servidor.
💡 Consejo: Guarda tus prompts exitosos en un documento de notas. Un prompt de movimiento que funciona bien con un tipo de imagen suele funcionar también con imágenes similares.
Otros modelos de video que merecen una prueba
Seedance 2.0 es el modelo insignia para el trabajo de imagen a video, pero la plataforma ofrece un amplio catálogo de alternativas según tus necesidades concretas.
Kling V3
Kling V3, de Kwai, destaca en el movimiento cinematográfico con una gran capacidad de movimiento de cámara. Si necesitas travelings dramáticos o movimiento complejo con varios elementos, Kling V3 merece una consideración seria. No tiene audio nativo, pero produce algunos de los clips visualmente más pulidos disponibles.
También disponibles: Kling V3 Omni Video, que acepta entradas de texto e imagen con más control sobre la dinámica del movimiento, y Kling V3 Motion Control, para transferir con precisión patrones de movimiento desde un video de referencia.
Veo 3
Veo 3, de Google, es el modelo al que recurrir cuando las escenas fotorrealistas necesitan audio nativo y el listón visual es extremadamente alto. El tiempo de generación es mayor que el de Seedance 2.0, pero la calidad del resultado justifica la espera en entregas finales. Veo 3 Fast ofrece una variante más rápida cuando la iteración importa más que la fidelidad máxima.
Hailuo 2.3
Hailuo 2.3, de Minimax, es especialmente bueno para crear contenido para redes sociales. Produce clips constantes y visualmente atractivos con una inferencia rápida. Hailuo 2.3 Fast es ideal para flujos de trabajo de contenido de alto volumen en los que necesitas muchos clips rápidamente.
3 cosas que hacen o deshacen tus resultados
Obtener resultados buenos y constantes con cualquier modelo de video con IA depende de un pequeño número de variables que la mayoría de la gente pasa por alto.
La calidad de la imagen importa más de lo que crees
El modelo solo puede animar lo que ve. Una fotografía tomada con un teléfono inteligente con poca luz generará un video que refleja esas limitaciones, con el ruido amplificado a través de los fotogramas en movimiento. Una imagen nítida y bien expuesta, con una separación clara entre sujeto y fondo, le da al modelo la información que necesita para producir un movimiento convincente.
Las exportaciones RAW o en JPEG de alta resolución desde una cámara producen resultados significativamente mejores que las capturas de pantalla o las imágenes comprimidas de redes sociales.
Lista de comprobación rápida antes de subir:
- Mínimo 1024 px de ancho
- Sin artefactos fuertes de compresión JPEG
- Separación clara entre primer plano y fondo
- Iluminación coherente y natural en todo el encuadre
- Sujeto enfocado (los sujetos borrosos producen una animación inestable)
Prompts de movimiento, no prompts de escena
Esta distinción no se puede exagerar. Describir el contenido de la escena no le dice al modelo nada que no pueda ver ya. Describir el movimiento le da al modelo una dirección práctica para cada elemento del encuadre.
Piensa en el prompt como una coreografía del movimiento, no como una descripción de la escena. Palabras como "suavemente", "lentamente", "sutil", "deriva", "se mece", "ondula" e "inclina" son mucho más útiles que describir qué objetos aparecen.
Relación de aspecto y resolución
Cada caso de uso exige formatos de salida distintos. Las redes sociales favorecen el contenido vertical de 9:16. Las cabeceras de sitios web y YouTube funcionan con 16:9. Ajustar la relación de aspecto de la imagen de origen al formato de salida previsto evita recortes o franjas no deseados en el clip final.
Considera usar los modelos de Super Resolution de PicassoIA antes de introducir una imagen en Seedance 2.0 si tu original tiene baja resolución. Escalar a 2x o 4x antes de generar el video suele producir un resultado notablemente más limpio.
La familia Seedance que vale la pena conocer
Si trabajas con video de IA con regularidad, conocer toda la gama de Seedance te ayuda a elegir la herramienta adecuada para cada tarea.
- Seedance 2.0: Modelo insignia. Calidad completa, audio nativo, la mejor simulación de física.
- Seedance 2.0 Fast: Variante optimizada para la velocidad. Ideal para prototipar e iterar prompts rápidamente.
- Seedance 1.5 Pro: Nivel profesional de la generación anterior. Resultados sólidos, ideal para trabajo de alto volumen.
- Seedance 1 Pro: Versión anterior, todavía capaz de cumplir requisitos de contenido estándar.
- Seedance 1 Lite: Modelo de entrada de la familia. Rápido y ligero para necesidades de animación sencillas.
El salto generacional de la 1.x a la 2.0 es lo bastante grande como para que, en cualquier trabajo creativo serio, Seedance 2.0 deba ser la opción por defecto. Las mejoras en coherencia temporal, generación de audio y precisión física no son incrementales. Son la diferencia entre un material que se lee como "video de IA" y uno que se lee como real.
Qué significa esto para tu trabajo creativo
La fotografía fija siempre ha sido la puerta de entrada a la narración visual. Una fotografía bien compuesta captura un momento, transmite un estado de ánimo y reclama la atención. Pero es un artefacto estático en un mundo que consume cada vez más contenido en movimiento. Seedance 2.0 no sustituye a la fotografía. La amplía.
Piensa en lo que se vuelve posible cuando tus fotos de producto se mueven sutilmente en un listado de comercio electrónico. Cuando una imagen de viaje en un blog respira con sonido ambiental. Cuando un retrato en un sitio de portafolio gana una sola respiración y un parpadeo tranquilo. No son trucos. Son la diferencia entre un contenido que retiene la atención y uno que se pasa de largo al hacer scroll.
Las herramientas para hacer esto bien ahora tardan segundos en lugar de días de producción. Solo se necesita una buena imagen, un prompt de movimiento bien escrito y acceso al modelo adecuado.
PicassoIA pone Seedance 2.0 directamente en tu flujo de trabajo, junto con todos los demás modelos capaces de este espacio: Kling V3, Veo 3, LTX 2.3 Pro, Gen-4.5 y decenas más. Empieza con una de tus mejores imágenes. Escribe un prompt de movimiento concreto. Mira lo que Seedance 2.0 hace con él. El resultado cambiará la forma en que piensas en cada fotografía que ya tienes guardada en tu biblioteca.


