Hace dos años, si le pedías a una IA que generara una mujer fotorrealista en una playa, obtenías algo que parecía una figura de cera derritiéndose al sol. Piel rígida, proporciones incorrectas, ojos vidriosos sin profundidad, una iluminación que no tenía ningún sentido físico. Las imágenes se reconocían como "IA" a un metro de distancia. Hoy, ese mismo prompt produce resultados que dejan a la gente boquiabierta, imágenes que hay que examinar de cerca para distinguirlas de una fotografía real. La calidad de la IA para contenido NSFW ha cambiado mucho, y el salto se produjo más rápido de lo que casi nadie en el sector esperaba.
De píxeles borrosos al fotorrealismo
En la generación de imágenes con IA hay un antes y un después que no pasa desapercibido. La línea divisoria está, más o menos, a mitad de 2023, y todo lo que queda al otro lado parece anticuado hoy.
Cómo se veían realmente las primeras imágenes de IA
Los primeros modelos de difusión producían imágenes con defectos característicos que se convirtieron en memes por sí mismos. Manos con seis dedos. Dientes que se difuminaban en una sola masa. Ojos que se desviaban ligeramente de su eje. Una piel con un brillo liso y plástico que nunca llegaba a parecer tejido de verdad. El cabello solía ser una maraña de mechones poco definidos, y la textura de las telas se sugería en lugar de representarse.
En el caso concreto del contenido NSFW, estas limitaciones eran brutales. Lo que define a esa categoría de imagen es la credibilidad. Una pequeña incorrección en el rostro rompe la ilusión al instante. Una figura con proporciones anatómicamente dudosas resulta inquietante en lugar de atractiva. Los modelos generaban cosas que eran técnicamente sugerentes, pero visualmente poco convincentes.
El primer cambio: SDXL y el salto de resolución
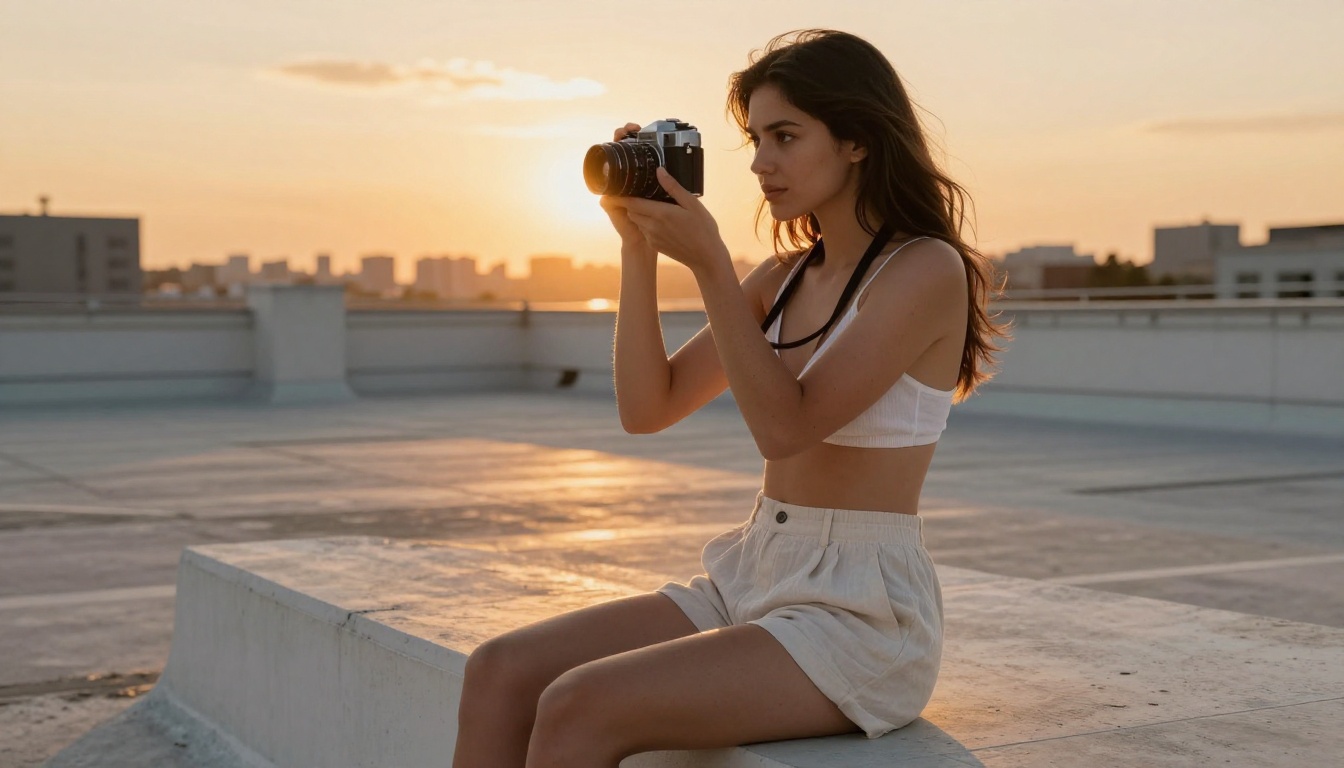
El primer gran salto de calidad llegó con SDXL, la respuesta de Stability AI a las limitaciones de detalle de los modelos anteriores. Pasar a una resolución base más alta y a un pipeline de generación en dos etapas permitió que las imágenes conservaran más detalle fino sin colapsar en ruido. Los rostros se volvieron más estables. Las manos mejoraron, aunque siguieron siendo un punto débil.
Más importante aún, SDXL introdujo el ecosistema de modelos checkpoint ajustados que podían especializarse. Una vez que existía una base sólida, la comunidad creó modelos entrenados específicamente con conjuntos de datos fotográficos, modelos como Realistic Vision v5.1 y RealVisXL v3.0 Turbo que avanzaron hacia un fotorrealismo genuino, con un renderizado de la piel notablemente mejor.
💡 Qué cambió: El paso de SD 1.5 a SDXL no fue un avance gradual. Fue una mejora de otro orden en la capacidad del modelo para mantener el detalle a resolución completa, sobre todo en los rostros y en las texturas finas.
Los modelos que lo cambiaron todo
La verdadera revolución llegó en oleadas, y cada una elevó el nivel mínimo de lo que se consideraba un resultado aceptable.
Flux y el nuevo estándar
Flux Dev, de Black Forest Labs, llegó con una sensación realmente distinta a la de cualquier modelo anterior. Donde los modelos previos tenían dificultades para mantener la coherencia en todo el encuadre, Flux producía imágenes con un detalle constante de borde a borde. La iluminación se comportaba de forma física. Las telas caían con peso. La piel tenía dispersión subsuperficial, esa ligera translucidez donde la luz atraviesa el tejido fino de las orejas y los dedos, algo que los modelos anteriores nunca habían logrado.
Flux 1.1 Pro Ultra fue un paso más allá con la generación nativa en alta resolución, lo que significa que el modelo no escalaba una imagen más pequeña, sino que renderizaba a resolución completa desde el principio. La diferencia se ve: sin el desenfoque que produce el paso de escalado, sin pérdida de detalle de frecuencia media en la textura de la piel. Para las aplicaciones NSFW en concreto, esto marcó una diferencia decisiva.
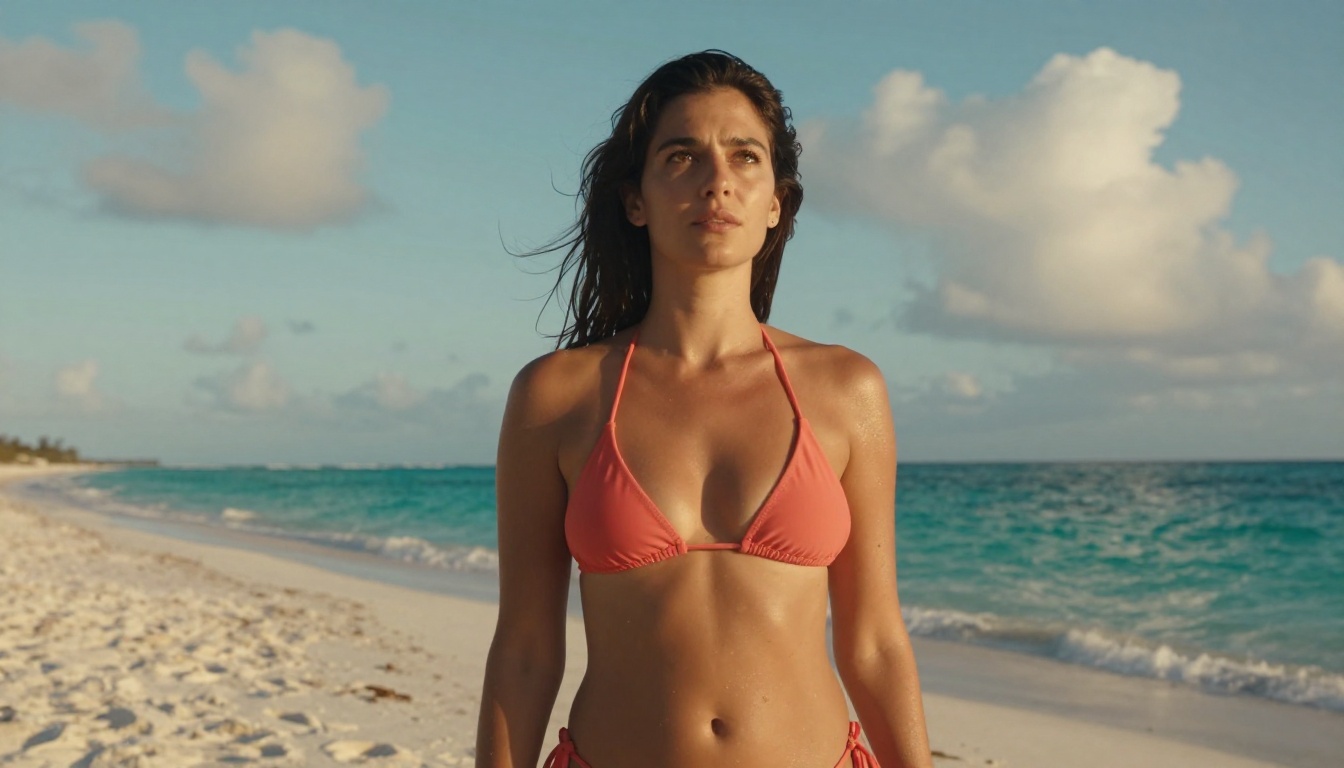
La última generación, Flux 2 Pro y Flux 2 Max, refina aún más la arquitectura. Los colores son más ricos sin llegar a saturarse. El rango tonal en sombras y luces se parece más a una fotografía correctamente expuesta que al rango ligeramente comprimido de los modelos de IA anteriores. Las escenas complejas con varios sujetos se mantienen unidas en lugar de desintegrarse en incoherencia.
Realistic Vision y resultados con piel precisa
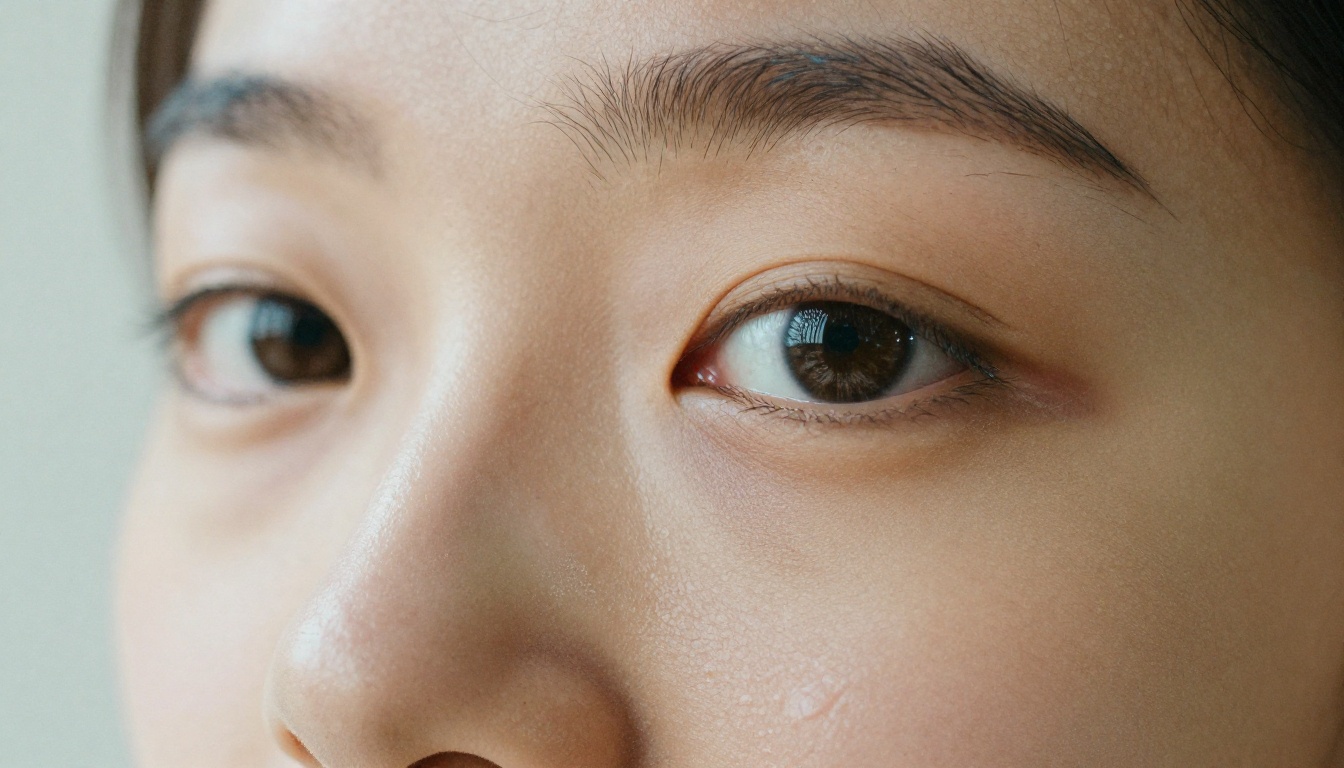
Los modelos de fotorrealismo diseñados específicamente, como Realistic Vision v5.1, demostraron lo que podía lograr el ajuste fino con datos fotográficos seleccionados. Estos modelos se entrenaron con imágenes en las que la referencia era fotografía real, no datos sintéticos, lo que significa que aprendieron los patrones estadísticos de la piel real: la forma en que nunca es perfectamente uniforme, cómo aparecen los poros con luz rasante, cómo cambia el color de la mejilla a la mandíbula.
En el contenido NSFW, esto importó muchísimo. La diferencia entre lo atractivo y lo inquietante en una figura generada por IA suele depender de un puñado de decisiones sobre el renderizado de la piel: ¿la textura tiene variación natural o es uniforme de una forma en que la piel nunca lo es? ¿La iluminación produce degradados de sombra adecuados en las curvas del cuerpo? ¿La imagen tiene el tipo de microimperfecciones que hacen que algo parezca fotografiado y no sintetizado?
Stable Diffusion 3.5 y la profundidad compositiva
Stable Diffusion 3.5 Large aportó algo que los modelos anteriores no tenían: una mejor comprensión de la composición. No se trataba solo de la calidad del render, sino de colocar a los sujetos en entornos que tuvieran sentido físico. Las sombras caían en las direcciones correctas. Las fuentes de luz ambiental afectaban a toda la escena de forma coherente. La profundidad de campo parecía una propiedad óptica real y no un efecto de desenfoque aplicado a posteriori.
Esta mejora compositiva es importante para las escenas NSFW en particular, porque la credibilidad depende tanto del entorno como de la figura. Un sujeto magníficamente renderizado sobre un fondo físicamente imposible rompe el realismo de inmediato. Las mejoras arquitectónicas de SD 3.5 hicieron que todo el encuadre funcionara como un conjunto.
Qué significa realmente "calidad" en la IA NSFW
La calidad, en este contexto, no es una sola cosa. Es un conjunto de problemas de renderizado independientes que hay que resolver a la vez.
La textura de la piel es la prueba real
La piel humana es una de las superficies más complejas que un modelo generativo tiene que reproducir. No tiene un color uniforme, ni una textura uniforme, ni una iluminación uniforme. Una misma zona de piel se ve completamente distinta según el ángulo de la luz que la incide. Con luz lateral rasante, cada poro proyecta una pequeña sombra. Con luz cenital difusa, la textura se aplana. En la oreja, la luz atraviesa el tejido y lo hace ver translúcido y rosado.
Los modelos anteriores producían una piel tan lisa como ninguna piel humana real llega a ser. La generación más reciente, sobre todo los modelos basados en Flux y GPT Image 1.5, trata la piel como un material óptico complejo con propiedades subsuperficiales reales. El resultado son imágenes que parecen fotografiadas y no renderizadas.
| Modelo | Textura de la piel | Precisión de la iluminación | Anatomía | Realismo general |
|---|
| SD 1.5 (2022) | Lisa/plástica | Deficiente | Irregular | Bajo |
| SDXL (2023) | Mejorada | Moderada | Mejor | Moderado |
| Flux Dev (2024) | Alta | Buena | Sólida | Alto |
| Flux 1.1 Pro Ultra | Excelente | Excelente | Muy buena | Muy alto |
| Flux 2 Max | Casi fotográfica | Excelente | Excelente | Casi fotográfico |
Iluminación, sombras y atmósfera
La iluminación es el ámbito en el que los modelos de IA fallaban de forma más evidente en el pasado, y donde la mejora ha sido más espectacular. Los primeros modelos aplicaban la iluminación como una especie de corrección de color, un tinte cálido o frío que sugería una fuente de luz sin simularla de verdad. Las sombras no coincidían con las posiciones de luz implícitas. Las altas luces se quemaban sin la caída gradual de la fotografía real.
Los modelos actuales, sobre todo Imagen 4 e Imagen 4 Ultra de Google, manejan la iluminación con una precisión física genuina. Un sujeto de pie junto a una ventana tendrá reflejos en los ojos que coinciden con la posición de la ventana. La sombra de su cuello caerá en el ángulo correcto. La luz de relleno ambiental del color de la pared rebotada teñirá el lado de sombra de forma adecuada. Esto es fotografía, no una aproximación.
Anatomía y proporciones
El problema de la anatomía en la IA temprana no se limitaba a los dedos. Era un fallo general de razonamiento espacial: el modelo no tenía un modelo interno sólido de cómo ocupa el cuerpo humano el espacio tridimensional. Los torsos a veces eran demasiado largos o demasiado cortos. Los hombros podían ser muy asimétricos. Las figuras sentadas tenían proporciones que no tenían ningún sentido geométrico si se analizaban con cuidado.
Los modelos actuales han resuelto en gran medida esto en el nivel de las poses habituales. Una figura de pie o recostada en un plano medio tendrá proporciones que resisten un análisis detallado. Los fallos que quedan tienden a aparecer en ángulos poco habituales, escorzos extremos o interacciones complejas entre varios sujetos. Para los usos creativos NSFW más típicos, el problema de la anatomía está, en la práctica, resuelto.
💡 Consejo avanzado: Si la anatomía sigue fallando en poses poco habituales, Flux Schnell combinado con la guía de pose de ControlNet puede fijar la estructura de la figura antes de que se ejecute el pase de detalle.
La calidad del modelo por sí sola no determina la calidad del resultado. Las herramientas que rodean al modelo importan igual.
Herramientas de resolución y escalado
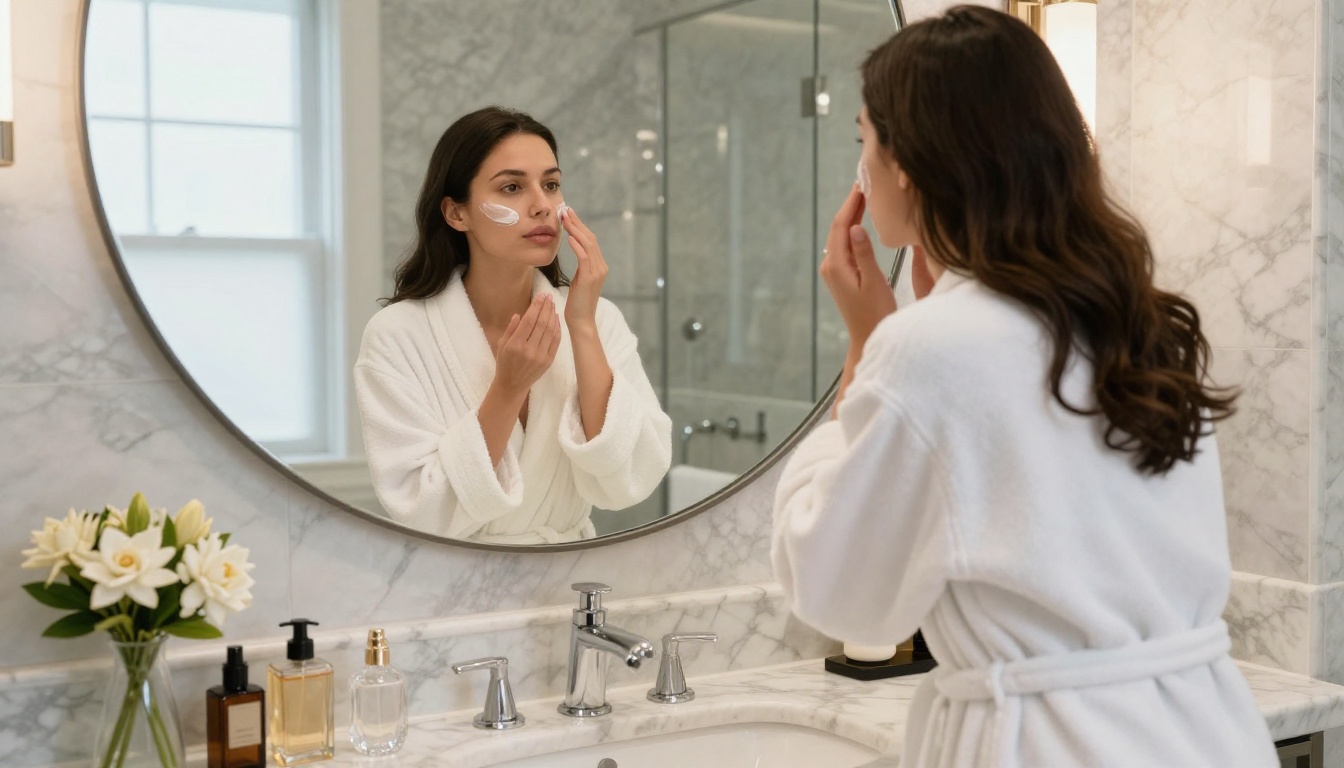
Una de las mejoras con más impacto ha sido el escalado posterior a la generación. Los modelos de superresolución ya pueden tomar una imagen de 1024x1024 y producir una versión de 4096x4096 que parece fotografiada de verdad, en lugar de ampliada por interpolación bilineal. La combinación de un modelo base sólido con un paso de escalado de superresolución dedicado produce resultados que el modelo base por sí solo no puede alcanzar, por muy bueno que llegue a ser. Cada paso de la cadena, desde la generación inicial hasta el pase de escalado, se acumula en la fidelidad general.
Inpainting y corrección de zonas problemáticas
Incluso los mejores modelos producen de vez en cuando una imagen que es un 95 % perfecta con un defecto que distrae. El inpainting ha madurado mucho junto con los propios modelos. Donde el inpainting temprano producía costuras visibles y texturas que no encajaban, las herramientas actuales pueden regenerar un rostro, una mano o un elemento del fondo con una integración sin fisuras. La zona enmascarada se regenera teniendo plenamente en cuenta el contexto que la rodea.
En el contenido NSFW, esto es especialmente útil porque las imágenes suelen tener zonas concretas, un rostro o una región corporal determinada, donde lo que está en juego en cuanto al realismo es mayor. Poder centrarse en esas zonas para un pase de calidad sin alterar el resto de la composición es un cambio de flujo de trabajo que eleva de forma notable la calidad alcanzable.
El prompt también ha cambiado
Los modelos mejores necesitan mejores prompts para aprovechar todo su potencial de calidad. El lenguaje de prompts que funcionaba con SD 1.5 ("a beautiful woman, high quality, 4k") produce resultados mediocres en las arquitecturas modernas.
Escribir para el fotorrealismo
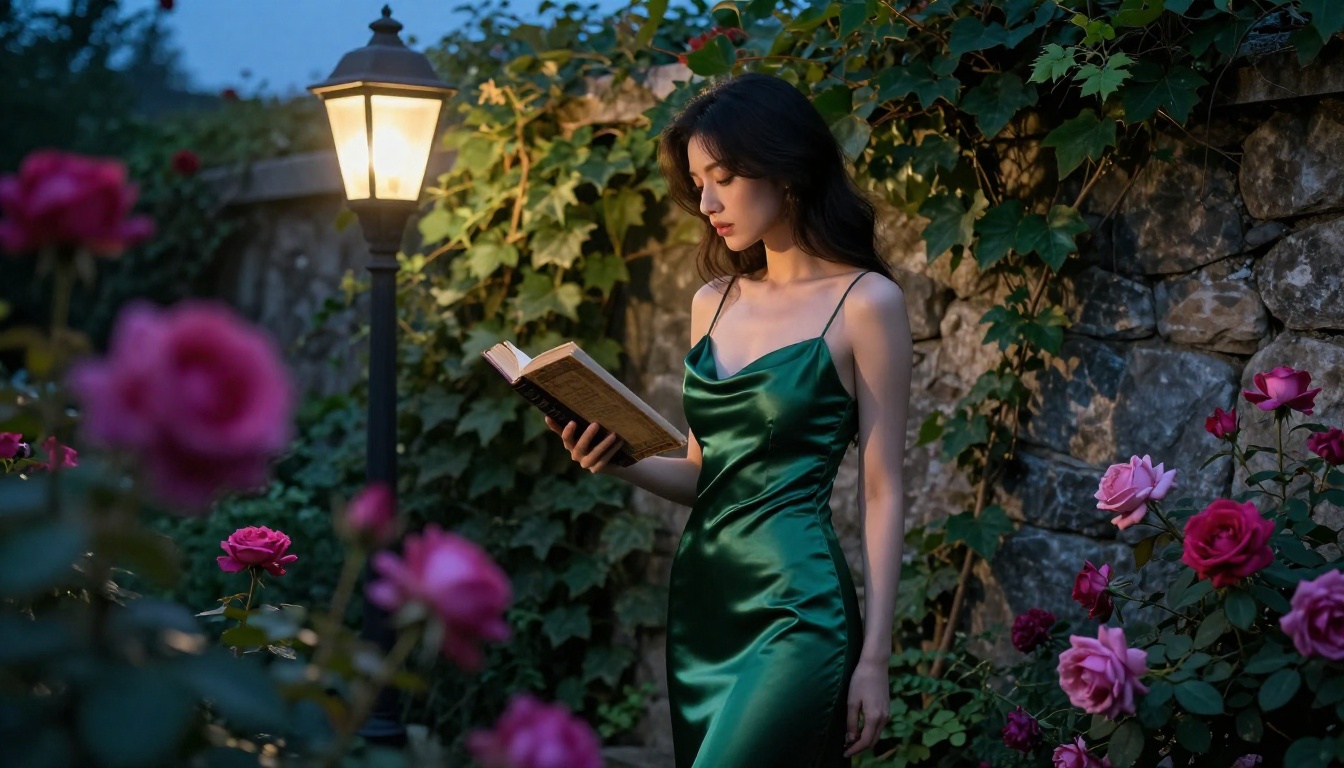
El prompting fotorrealista moderno se parece más a escribir la descripción de un plano de un director de fotografía que a una lista de palabras clave. En lugar de "beautiful skin, realistic", los prompts eficaces describen fenómenos ópticos concretos: "dispersión subsuperficial visible en las orejas", "iluminación Rembrandt que crea un reflejo triangular en el pómulo", "poros que proyectan microsombras con luz rasante lateral".
💡 Lo que funciona ahora: Describe lo que hace la luz, no solo lo que contiene la escena. "Luz de la mañana a 15 grados desde la izquierda que crea sombras largas sobre el lino" produce una iluminación mucho mejor que la frase genérica "luz natural".
Lenguaje de cámara y emulación de película
La evolución más fiable del prompting ha sido la adopción del lenguaje real de la fotografía. Especificar una distancia focal (85 mm frente a 24 mm) cambia la compresión espacial de la imagen y la cantidad de desenfoque de fondo. Especificar una apertura afecta al render de la profundidad de campo. Los términos de emulación de película como "Kodak Portra 400" o "Fujifilm Pro 400H" le dicen al modelo algo concreto sobre la reproducción del color, el carácter del grano y la curva tonal, algo que términos genéricos como "estética de película" no transmiten.
Esta precisión es en parte la razón de que los mismos modelos que dan resultados mediocres a usuarios inexpertos produzcan resultados impresionantes para fotógrafos que escriben prompts con el vocabulario de su oficio.
De 2022 a 2026: una comparación directa
Los números cuentan una historia, pero la comparación visual es más contundente. Esto es lo que realmente cambió, generación tras generación:
| Época | Modelo clave | Piel | Manos | Iluminación | Credibilidad |
|---|
| 2022 | Stable Diffusion 1.5 | Plástica/lisa | 5-6 dedos, habitual | Plana/irregular | Se nota que es IA al instante |
| 2023 | SDXL | Textura mejorada | Mayormente correctas | Profundidad moderada | Reconocible como IA |
| Principios de 2024 | Flux Dev | Casi realista | Fiables | Físicas | A menudo convincente |
| Finales de 2024 | Flux 1.1 Pro Ultra | Fotográfica | Casi perfectas | Excelente | Difícil de distinguir |
| 2025-2026 | Flux 2 Max, Imagen 4 Ultra | Indistinguible | Fotográficas | Casi perfecta | Requiere un examen detallado |
La tendencia no se frena. Cada generación de arquitectura ha traído mejoras que habrían parecido inverosímiles dos años antes.
Dónde está el techo de calidad ahora
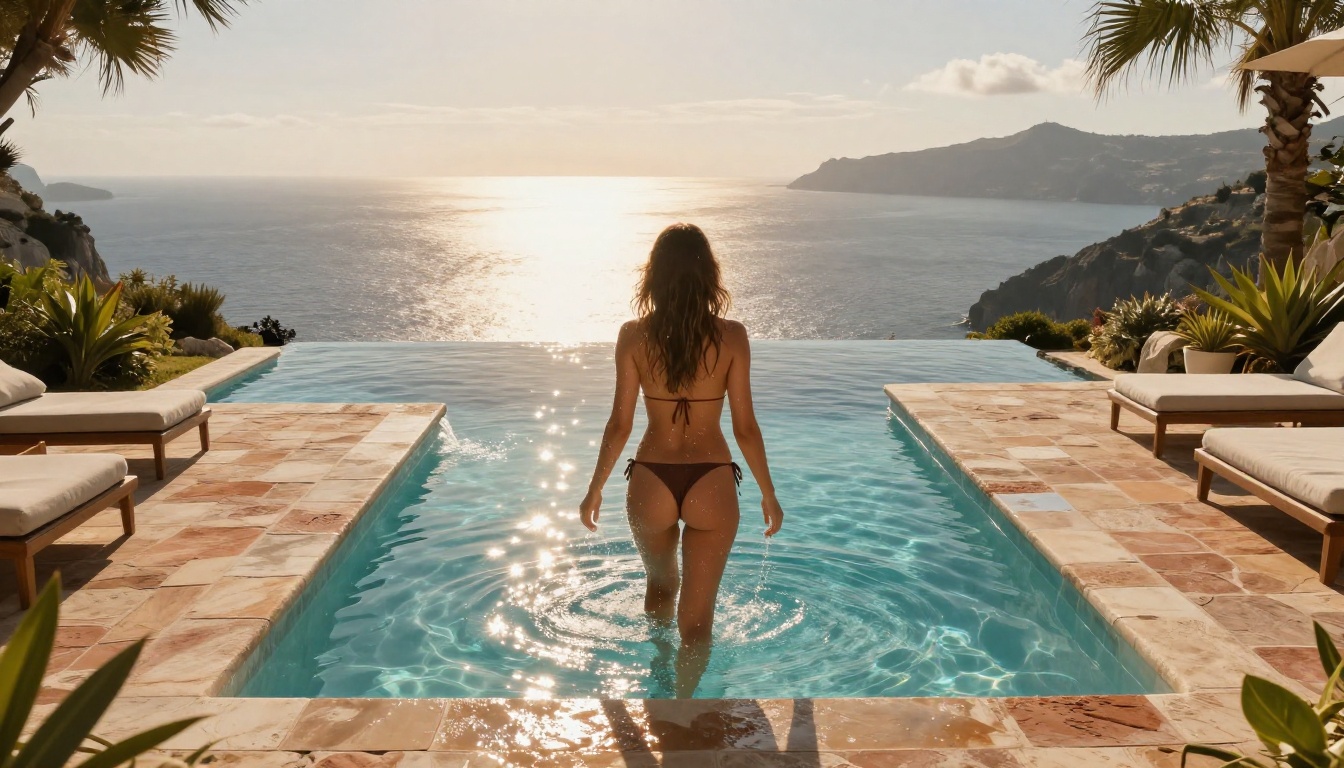
La respuesta honesta es que, en escenarios controlados, con poses habituales, sujetos individuales y una iluminación bien descrita, los modelos actuales han resuelto de forma efectiva el fotorrealismo. Las imágenes generadas con Flux 2 Max, Imagen 4 Ultra y Seedream 4 requieren un análisis detallado para distinguirlas de las fotografías. Las señales técnicas concretas que caracterizaban a la IA anterior, la piel de plástico, la desviación de los ojos, la incoherencia de la luz, han desaparecido en los casos de uso habituales.
Lo que queda son retos en los límites: composiciones complejas con varias figuras, poses extremas, renderizado de texto en entornos y el tipo de escenas caóticas del mundo real que la fotografía captura sin pensarlo dos veces. Son áreas de investigación todavía activas, y mejoran cada pocos meses.
💡 El techo práctico: En el trabajo creativo NSFW en concreto, el techo de calidad ya está limitado casi por completo por la habilidad con el prompt y la elección del modelo, no por las limitaciones arquitectónicas del modelo. Un prompt bien elaborado en un modelo potente como Flux 1.1 Pro Ultra producirá resultados que en 2022 se habrían considerado técnicamente imposibles.
Pruébalo tú mismo
La mejor forma de notar este cambio de calidad es ejecutar el mismo prompt en diferentes generaciones de modelos, una tras otra. PicassoIA reúne todos estos modelos en un solo lugar: Flux Schnell para iterar rápido, Flux 1.1 Pro Ultra para la máxima calidad, Realistic Vision v5.1 para el estilo fotográfico con ajuste fino, y GPT Image 1.5 para la visión de OpenAI sobre el realismo.
Puedes ejecutar el mismo prompt en cada modelo y ver en tiempo real exactamente en qué se diferencian los resultados. Experimenta con el lenguaje de cámara: prueba a escribir "85 mm f/1.4, Kodak Portra 400, luz volumétrica de la mañana desde la izquierda" en tu próxima generación y compáralo con un prompt genérico. Los resultados te mostrarán de forma más concreta que cualquier artículo cómo se ve realmente el cambio de calidad en la práctica. Elige un modelo, escribe una descripción detallada de la escena y comprueba dónde está realmente el techo actual.


