Qué hace que los prompts para modelos 3D a partir de texto funcionen de verdad
Escribir prompts para modelos 3D a partir de texto es un oficio específico. Este artículo desglosa el lenguaje exacto, la estructura y los modificadores que producen profundidad, volumen y detalle de superficie en imágenes generadas con IA, con comparativas de plataformas y ejemplos reales de distintos tipos de objeto.
Los prompts de texto que producen visuales de modelos 3D convincentes no son los mismos que sirven para ilustraciones planas o fotografías. El lenguaje, la estructura y los modificadores específicos que usas cambian por completo el resultado, y la mayoría de quienes escriben estos prompts les faltan algunas piezas clave que marcan la diferencia entre un resultado plano y otro con profundidad y forma percibidas de verdad.
Este es un desglose de lo que funciona, lo que no, y cómo estructurar exactamente los prompts para que los generadores de imágenes con IA produzcan volumen tridimensional, detalle de superficie y verosimilitud espacial.
Por qué los prompts 3D son diferentes
La mayoría de consejos sobre prompts cubren el estilo básico y la descripción del sujeto. Pero generar un visual de modelo 3D convincente a partir de texto exige un enfoque fundamentalmente distinto al de generar un paisaje o un retrato. Le pides al modelo que simule propiedades físicas de un objeto: normales de superficie, reflexión de la luz, proyección de sombras y densidad del material.
Si escribes "una silla" en un modelo de IA, puedes obtener cualquier cosa. Si escribes "una silla de madera Bauhaus, fotografía de estudio, luz principal direccional desde arriba a la izquierda a 45 grados, que proyecta una sombra dura a la derecha, textura de veta de madera lacada mate visible, aislada sobre blanco, objetivo de 50 mm a f/8", obtienes algo que se lee como un objeto tridimensional real que existe en el espacio.
La diferencia está en la precisión sobre el comportamiento de la luz y las propiedades del material.
💡 La regla clave: los modelos de IA interpretan el 3D a través del lenguaje de la luz y el material, no a través de la palabra "3D" en sí.
Qué significa realmente "con aspecto 3D"
Cuando los diseñadores o los artistas de producto hablan de una imagen de IA con aspecto 3D, se refieren a que la imagen se lee como volumétrica. Ciertas señales visuales crean esa percepción:
Sombras direccionales duras que confirman el ángulo de una fuente de luz
Reflejos especulares en superficies curvas (el punto brillante que cambia con la perspectiva)
Sombras de oclusión en zonas cóncavas y socavados
Textura del material que sigue el contorno de la superficie (veta de la madera envolviendo un cilindro, tela ajustándose a la forma del cuerpo)
Separación de planos de profundidad mediante profundidad de campo o contraste de valores en el fondo
Una vez que entiendas estas señales, podrás escribir prompts que activen cada una de ellas de forma específica.
La física detrás del prompt
Los generadores de imágenes con IA entrenados con datos fotográficos han absorbido millones de imágenes en las que la luz se comporta según la física. Cuando describes un escenario de iluminación que coincide con la física real, el modelo recurre a ese conocimiento. Cuando describes una iluminación vaga o físicamente inverosímil, el modelo promedia entre muchos ejemplos de entrenamiento ambiguos y produce un resultado plano.
Por eso "iluminación bonita" produce resultados 3D débiles. Bonito es subjetivo. "Fuente de luz principal única desde arriba a la derecha a 40 grados, que proyecta una sombra direccional hacia abajo a la izquierda, con un relleno sutil de rebote desde abajo" es una descripción física que el modelo sí puede ejecutar.
La anatomía de un prompt 3D sólido
Todo prompt eficaz para resultados de estilo modelo 3D tiene cuatro capas estructurales. Si falta cualquiera, el resultado es más débil.
Capa 1: sujeto con propiedades físicas
No te limites a nombrar el objeto. Describe de qué está hecho y cómo se comporta físicamente ese material.
Débil: "un jarrón de cerámica"
Sólido: "un jarrón de gres torneado a mano con borde irregular, esmalte celadón mate, anillos de torneado sutiles visibles en la superficie exterior"
La segunda versión le da a la IA propiedades físicas reales que simular. El gres tiene un peso y una densidad concretos que implican un comportamiento de las sombras. El esmalte celadón tiene un nivel de brillo específico. Los anillos de torneado implican una variación de superficie que la luz capta en ángulo.
Capa 2: configuración de la iluminación
Es el elemento más influyente para lograr verosimilitud 3D. Especifica:
Dirección de la fuente de luz: "luz principal desde arriba a la izquierda a 30 grados"
Calidad de la luz: dura (fuente pequeña, sombras nítidas) frente a suave (fuente grande, sombras difusas)
Relación de relleno: "relleno de luz mínimo, sombra intensa en el lado derecho"
Contraluz de borde: "contraluz sutil que recorre el borde trasero de la forma"
Una luz dura desde un ángulo concreto es lo que crea la sombra nítida que asienta un objeto en el espacio tridimensional. Sin ella, obtienes una iluminación ambiental plana que borra la profundidad.
Capa 3: cámara y objetivo
La elección del objetivo afecta de forma notable a la profundidad percibida. Un macro de 100 mm comprime el espacio de manera distinta a un gran angular de 24 mm. Para presentaciones de modelos 3D, el rango estándar es de 50 a 85 mm. La apertura controla la profundidad de campo y, por tanto, la separación del fondo.
"Objetivo de 85 mm a f/2.8, enfoque ligero en la cara frontal central, fondo suavemente desenfocado" indica una cámara real que captura un objeto físico real. La IA usa esta señal para calibrar las relaciones espaciales dentro de la imagen.
Capa 4: contexto de superficie y fondo
Lo que rodea al objeto le indica a la IA cómo tratar las sombras y los reflejos. "Fondo de estudio blanco continuo" produce fotografía de producto limpia. "Superficie de pizarra oscura con reflejos sutiles" produce una toma de producto con atmósfera. Ambas se leen como tridimensionales porque el contexto de superficie aporta anclaje espacial. Un objeto flotando sin sombra sobre la superficie no tiene punto de apoyo y se lee como plano.
Plantillas de prompt que funcionan
Estas son estructuras de prompt probadas, organizadas por categoría de objeto:
Para productos y objetos industriales
[Object description with material] on [surface type], studio photography, [primary light direction and quality], [shadow description], [lens and aperture], white seamless background, photorealistic, 8K
Ejemplo: "Caja de reloj mecánico de aluminio cepillado sin correa, sobre superficie de acrílico blanco, fotografía de estudio, luz principal dura desde arriba a la derecha a 45 grados, sombra nítida proyectada a la izquierda, reflejo sutil en el acrílico de abajo, macro de 100 mm a f/5.6, fondo blanco continuo, fotorrealista, 8K"
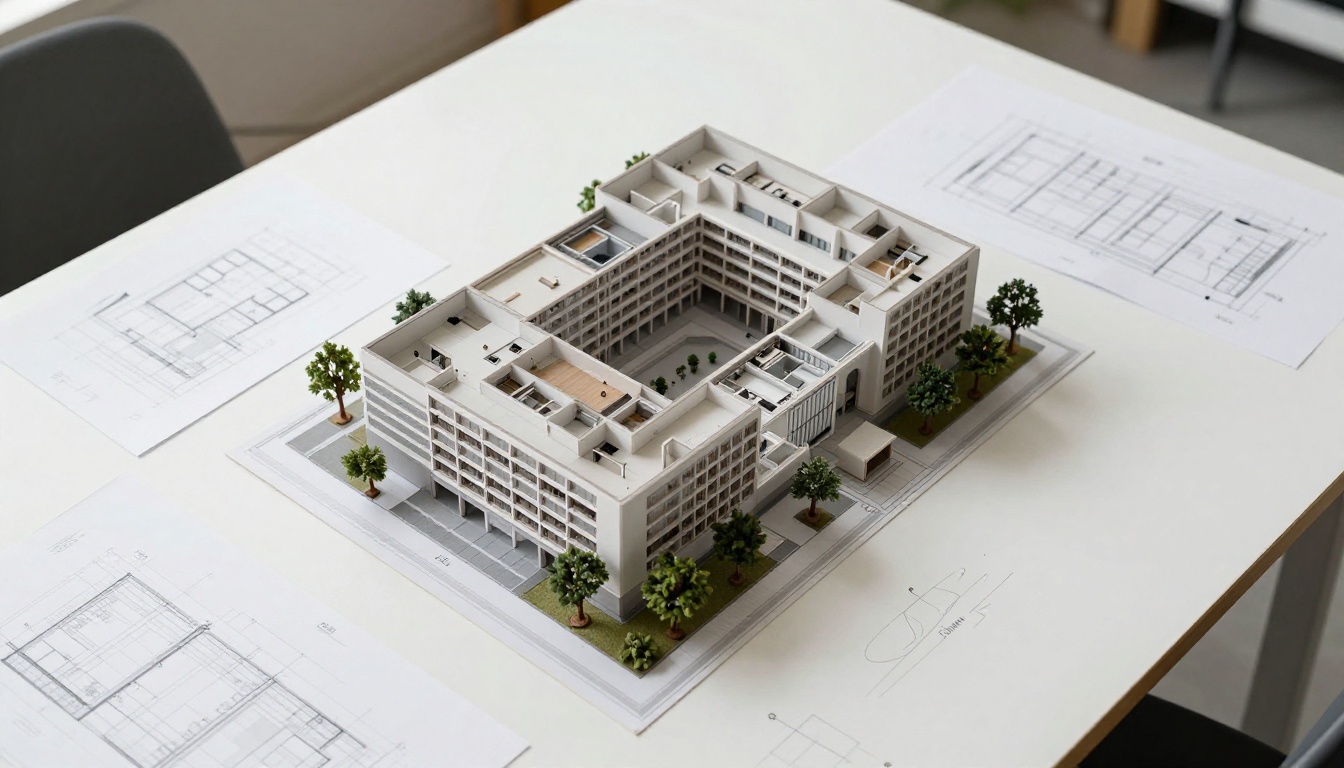
Para formas arquitectónicas y estructurales
[Scale model or architectural form], [viewing angle], [material description], [ambient and directional light], [surface the model rests on], 35mm documentary photography
Ejemplo: "Maqueta arquitectónica de volúmenes en yeso blanco de un pabellón modernista, vista de tres cuartos desde ligeramente arriba, acabado de yeso liso y mate, luz suave y difusa del norte procedente de una gran ventana de estudio, apoyada sobre una mesa de dibujo de madera, 35 mm a f/4, fotorrealista"
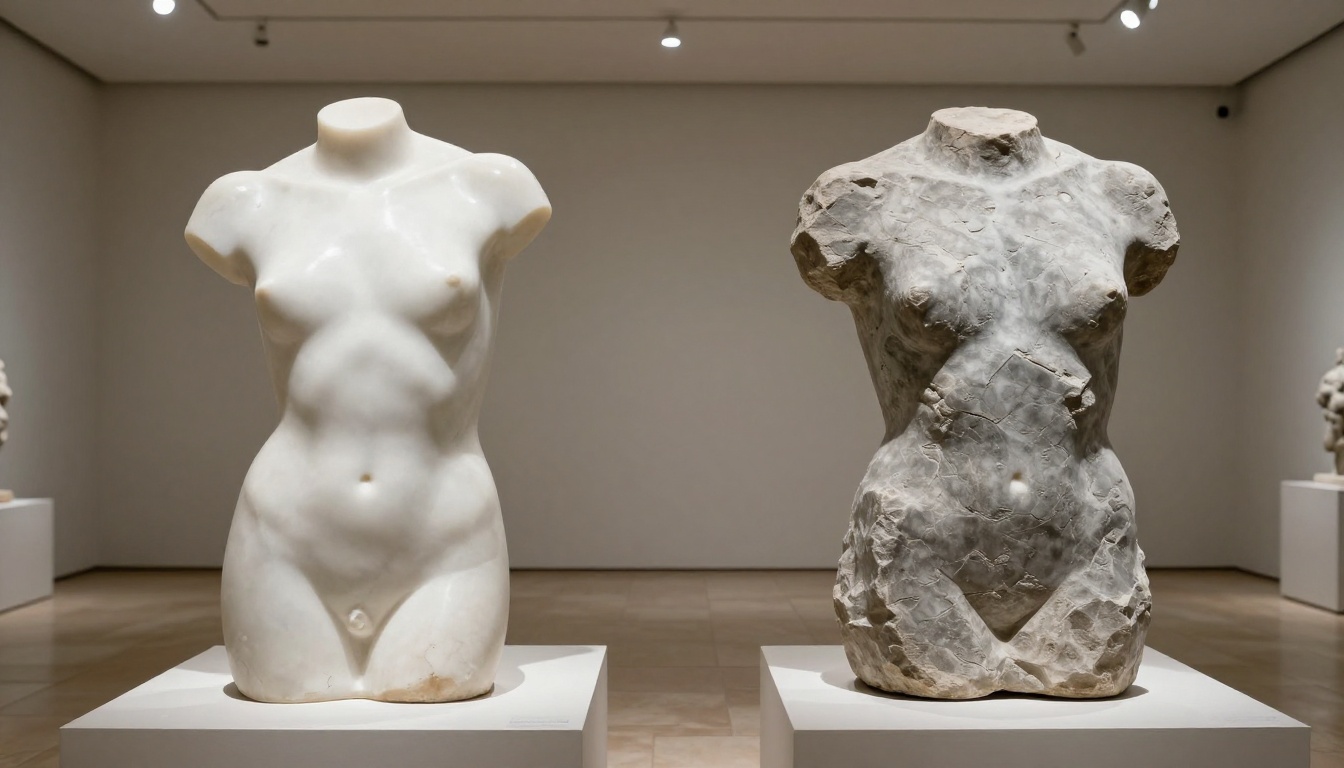
Para formas orgánicas y escultóricas
[Material] [sculptural form description], [texture detail], [directional lighting with angle], [shadow quality], [background context], [lens specs]
Ejemplo: "Escultura de torso humano abstracto en bronce fundido con pátina moderada, superficie de musculatura detallada, luz rasante lateral desde la derecha a 90 grados que revela cada plano de la superficie, sombra profunda a la izquierda, colocada sobre una peana de hormigón gris rugoso, objetivo de 50 mm a f/4, fotografía de museo, fotorrealista"
💡 Consejo: el término "luz rasante" es uno de los más potentes en la escritura de prompts 3D. Rasante significa que la luz incide sobre una superficie en un ángulo muy rasante, casi paralelo, lo que revela de forma dramática la textura y el contorno tridimensional. Úsalo para formas escultóricas y orgánicas.
Longitud del prompt y nivel de detalle
La investigación es clara: los prompts más largos y específicos producen mejores resultados 3D que los cortos. Un prompt de 15 palabras deja demasiado margen al modelo para inventar. Un prompt de 60 palabras con información específica de material, iluminación, cámara y superficie limita el espacio de salida lo suficiente como para producir una profundidad constante y físicamente plausible.
Apunta a entre 50 y 80 palabras en tus prompts de modelos 3D. Si te encuentras escribiendo menos, probablemente te falta una de las cuatro capas estructurales.
Los modelos que mejor manejan la forma 3D
No todos los modelos de texto a imagen manejan la simulación de la luz igual de bien. Algunos se entrenan con datos fotorrealistas más sólidos, lo que les ayuda a producir un comportamiento de la luz físicamente plausible. Así se comparan los mejores modelos de PicassoIA para resultados de estilo modelo 3D:
Para presentaciones de producto limpias, Flux 1.1 Pro y GPT Image 2 producen los resultados más limpios. Manejan bien los fondos blancos y los reflejos especulares sin introducir ruido visual.
Para formas escultóricas y orgánicas, Seedream 4.5 y Stable Diffusion 3.5 Large Turbo producen una mejor simulación de la textura de superficie y una variedad de materiales más rica.
Para modelos arquitectónicos y objetos estructurales, Wan 2.7 Image Pro maneja bien la profundidad espacial y la complejidad geométrica, y produce salidas 4K nítidas en las que los bordes estructurales finos siguen definidos.
Para iterar rápido y probar variaciones de prompt, Flux Schnell genera resultados en segundos, lo que te permite probar 10 variaciones de prompt antes de comprometerte con un render de calidad final en un modelo más lento y de mayor fidelidad.
Genera visuales de modelos 3D en PicassoIA
PicassoIA te da acceso a todos los modelos anteriores en un solo lugar. El flujo de trabajo para generar visuales convincentes de modelos 3D es sencillo:
Paso 1: elige el modelo adecuado para tu tipo de objeto
Para la presentación de modelos 3D, 1:1 (cuadrado) y 4:3 imitan las proporciones de la fotografía de producto estándar. 16:9 funciona para vistas arquitectónicas con escena, donde el objeto existe dentro de un entorno.
Paso 3: escribe tu prompt por capas
Usa la estructura de cuatro capas: sujeto y material, configuración de la luz, especificaciones de cámara y contexto de superficie. No saltes ninguna capa. Cada capa añade una dimensión de precisión física que reduce la planitud del resultado.
Paso 4: itera primero con la iluminación
Si tu primer resultado se ve plano, el problema casi siempre está en la especificación de la luz. Cambia el ángulo de la luz, añade un modificador "rasante" o "direccional", o describe una sombra concreta. La sombra es lo que asienta el objeto en el espacio.
Paso 5: afina el detalle de superficie
Una vez que la luz se lee correctamente, usa Flux Kontext Pro para hacer ediciones puntuales en el material o la textura de la superficie sin regenerar desde cero. Este modelo reescribe zonas visuales concretas según nuevas instrucciones de texto y conserva lo que ya funciona.
💡 Para tener aún más control, PicassoIA Image Editor Pro ofrece ediciones de imagen ilimitadas con inpainting y outpainting. Pinta una máscara sobre la zona que quieres cambiar, escribe un nuevo prompt solo para esa sección, y el resto se mantiene intacto.
Consejos sobre parámetros
Prompt upsampling: actívalo para estructuras de prompt 3D complejas. Ayuda a los modelos a interpretar prompts de varias capas con más precisión física.
Control de semilla: cuando encuentres una configuración de luz que funcione, guarda el número de semilla. Puedes reutilizar la misma composición espacial con objetos distintos y las relaciones espaciales se mantendrán coherentes.
Prompts negativos (donde se admitan): "plano, ilustración, dibujos animados, solo luz ambiental suave, sin sombras, sobreexpuesto, lavado" evita los fallos más habituales.
5 errores que aplanan tus prompts 3D
La mayoría de los prompts 3D fallidos comparten los mismos problemas. Estos son los cinco que verás con más frecuencia:
1. Usar "render 3D" como descriptor de estilo
Esto le indica al modelo que produzca un resultado de aspecto sintético, justo lo contrario de lo que necesitas para una visualización fotorrealista de objetos. La expresión se nutre de datos de entrenamiento de CGI e imágenes generadas digitalmente. Elimínala por completo y sustitúyela por un lenguaje específico de materiales e iluminación.
2. Describir el objeto sin describir el material
"Un robot" no le da a la IA propiedades físicas que simular. "Brazo robótico de titanio cepillado, juntas visibles con leves marcas de mecanizado, acabado de barniz transparente mate" le da al modelo todo lo que necesita para simular el comportamiento correcto de la superficie bajo la luz.
3. Falta especificar la sombra
Si no indicas la dirección de la sombra, la IA la inventa, y a menudo resulta físicamente incoherente. Especifica "sombra dura proyectada hacia abajo a la derecha" o "sombra difusa y suave justo debajo del objeto". Esto asienta el objeto en el espacio. Sin sombra, el objeto parece flotar sobre el fondo.
4. Iluminación solo ambiental
Los prompts que solo mencionan un brillo general, como "luz natural suave" o "estudio luminoso", producen resultados planos. La tridimensionalidad real surge de la luz direccional. Una fuente de luz dominante con un ángulo claro se lee como 3D. Incluso en entornos ambientales como "luz de día nublada", combinarla con "detalle de sombra sutil conservado, ligera direccionalidad desde el norte" mejora de forma notable el volumen percibido.
5. No hay superficie sobre la que apoyar el objeto
Los objetos que flotan sobre fondos blancos puros, sin sombra en la superficie, resultan poco creíbles. Incluso una simple "sombra fina bajo el objeto sobre una superficie blanca mate" o "objeto colocado sobre un estante de nogal oscuro" crea suficiente contexto ambiental para que el ojo lea bien la profundidad.
Ejemplos reales por tipo de objeto
Personajes y figuritas
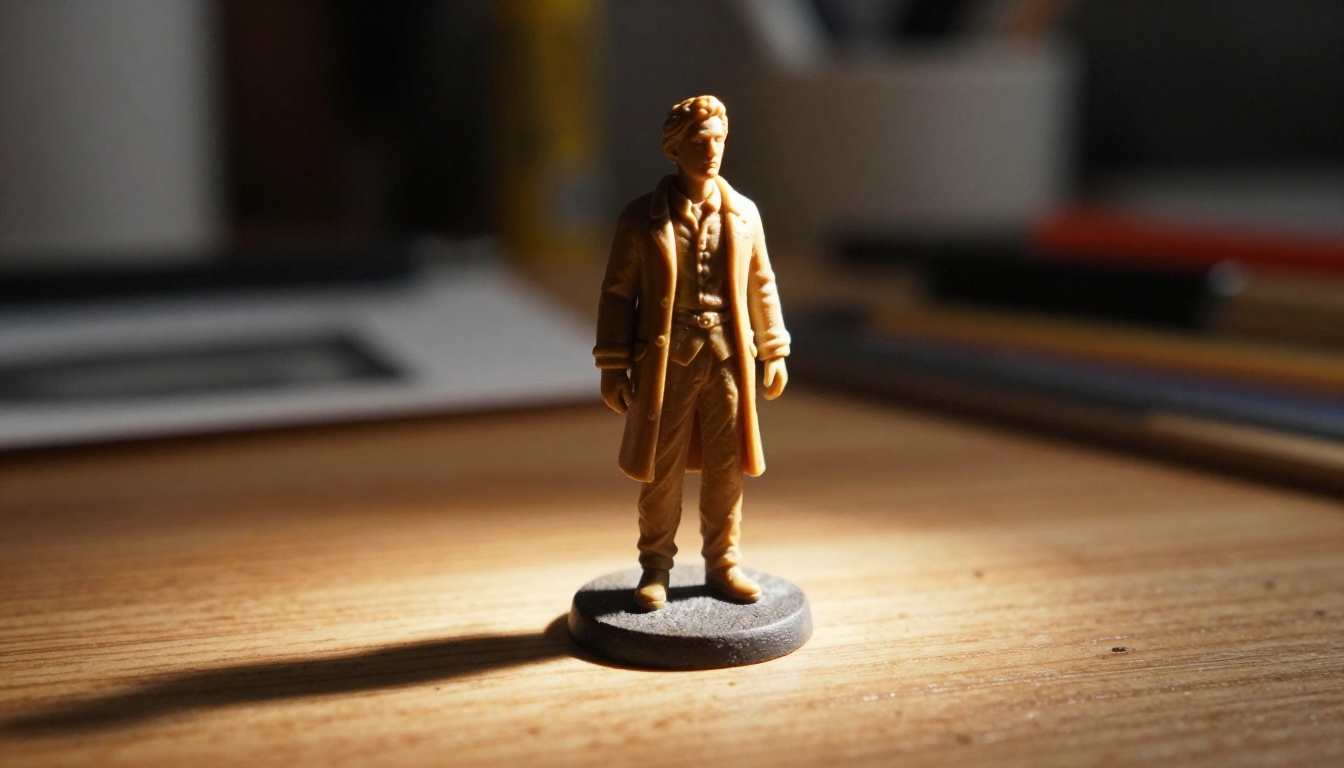
El reto con los objetos 3D basados en personajes es conseguir una anatomía coherente y una coherencia de superficie. Esta es una estructura que ya ha funcionado:
"Figurita de resina pintada a mano de [descripción del personaje], de pie sobre una base redonda de acrílico negro, luz de estudio rasante desde la izquierda que revela el detalle escultórico fino, desgaste de la pintura visible en las superficies en relieve, sombra nítida sobre la superficie de la base, macro de 100 mm a f/4, fotografía de producto, fotorrealista, 8K"
Las palabras "figurita de resina" y "pintada a mano" hacen mucho trabajo. Le indican al modelo que se trata de una miniatura física, no de una ilustración ni de una fotografía de una persona real. El encuadre de objeto físico activa los datos de entrenamiento del modelo procedentes de la fotografía de miniaturas y coleccionables.
Para figuritas de personajes en PicassoIA, Recraft v4 maneja bien el detalle de superficie intrincado. Ideogram v3 Balanced es sólido para formas de personajes en las que las proporciones generales y la legibilidad importan más que la precisión de la microtextura.
Joyería y objetos pequeños
Los objetos pequeños requieren especificaciones de objetivo macro y descripciones de luz muy precisas. "Anillo" no sirve de nada sin "anillo de sello de plata de ley, textura martillada, huecos oxidados, fotografía macro de estudio, luz principal única desde arriba a la derecha, reflejo especular en el punto más alto de la parte superior del anillo, colocado sobre una superficie de terciopelo negro, macro de 100 mm a f/8, fotorrealista, 8K".
La especificación de macro indica al modelo que muestre un detalle de superficie extremo. "Reflejo especular en el punto más alto" crea directamente la señal visual que se lee como curvatura metálica y forma tridimensional.
Objetos arquitectónicos
Las formas arquitectónicas se benefician de vistas de tres cuartos ligeramente elevadas que muestran varias caras a la vez. "Vista de tres cuartos desde arriba a unos 30 grados" es un punto de partida fiable que muestra en una sola composición la cara frontal, la cara lateral y la cara superior.
"Maqueta arquitectónica en yeso blanco de un [tipo de edificio], vista de tres cuartos desde 30 grados por encima, superficie de yeso mate con grano leve, luz suave del norte procedente de una gran ventana de estudio a la izquierda, sombras limpias y definidas que revelan la masa del edificio, colocada sobre una superficie de mesa de dibujo de madera con veta, 35 mm a f/4, fotografía documental fotorrealista"
Hunyuan Image 3 maneja la complejidad espacial de las formas arquitectónicas de varias caras mejor que la mayoría de modelos. Para un detalle extremo en escalas arquitectónicas, Wan 2.7 Image Pro produce salidas 4K nítidas que conservan el detalle estructural fino en los bordes.
Vehículos y objetos mecánicos
Los vehículos necesitan una vista frontal de tres cuartos para mostrar a la vez el frontal y el perfil lateral. Es el "ángulo heroico" estándar de la fotografía de automoción, y se aplica directamente a los prompts de modelos 3D.
"Maqueta a escala detallada de un [tipo de vehículo], vista frontal de tres cuartos, acabado de pintura metalizada que capta la luz del estudio, elementos de cristal transparentes visibles, apoyada sobre una superficie oscura reflectante, luz principal dura desde delante a la derecha, relleno suave desde el lado opuesto, reflejos en la superficie inferior, objetivo de 85 mm a f/4, fotografía de automoción de estudio, fotorrealista"
Flux Krea Dev es especialmente sólido para objetos mecánicos con geometría compleja. Evita el aspecto sobreprocesado que algunos modelos producen en sujetos muy detallados, algo crucial cuando el objetivo es la verosimilitud fotográfica.
Escalado y edición después de generar
Una vez que generas una imagen base sólida, las herramientas de superresolución pueden aumentar de forma notable el detalle percibido de tu visual de objeto 3D. La categoría de superresolución de PicassoIA ofrece escalado de 2x a 4x, que recupera la microtextura de superficie perdida en la primera pasada de generación.
Para editar zonas concretas de un objeto 3D generado, el inpainting es especialmente valioso. Si la luz de una cara del objeto es incoherente, pinta esa región y vuelve a describir solo la iluminación de esa cara. Es mucho más rápido que regenerar desde cero y arriesgarse a perder todo lo que ya funcionaba.
Flux Kontext Pro es la opción más sólida para esto en PicassoIA. Acepta una imagen de referencia y un prompt de texto que describe solo lo que hay que cambiar, y ejecuta ese cambio conservando todo lo demás con alta fidelidad.
💡 Secuencia de iteración: genera con Flux Schnell por velocidad, afina el prompt y haz el render final con Flux 1.1 Pro Ultra para la máxima calidad. Post-procesa con Flux Kontext Pro para los arreglos puntuales.
Pruébalo ahora en PicassoIA
Los prompts de este artículo son puntos de partida. La habilidad real viene de leer tus resultados con espíritu crítico: identifica qué señal visual falta, ajusta una variable cada vez e itera. La mayoría de los usuarios con experiencia consiguen un buen resultado 3D en 3 a 5 iteraciones una vez que interiorizan las cuatro capas estructurales.
PicassoIA te da acceso a más de 90 modelos de texto a imagen en una sola interfaz. Puedes probar el mismo prompt en Flux 1.1 Pro Ultra, Seedream 4.5 e Imagen 4 lado a lado. Comprueba cuál maneja mejor tu tipo de objeto y afina desde ahí.
Para generaciones ilimitadas sin límites de créditos, PicassoIA Image está pensado específicamente para flujos de iteración de alto volumen. Escribe, genera, compara. El volumen es el camino más rápido para dominar la escritura de prompts de modelos 3D.
Explora todos los modelos disponibles en picassoia.com/en/all-models y empieza por el tipo de objeto más cercano a tu proyecto actual.