La distancia entre "generado por IA" y "parece real" en el video nunca ha sido tan corta, y Wan 2.6 es uno de los ejemplos más claros de por qué. Publicado como parte de la serie de modelos en curso de wan-video, la versión 2.6 apunta a los dos puntos de fallo más graves en el video generado por IA: coherencia temporal (lo fluido que es el movimiento entre fotogramas) y retención del detalle espacial (lo bien que se mantienen texturas, bordes y estructuras finas a lo largo del clip). Si has trabajado con cualquier versión anterior de Wan o con un modelo rival y has notado que el pelo, la tela o el agua se convierten en una mancha borrosa a mitad del clip, Wan 2.6 es la respuesta directa a ese problema.
Qué es Wan 2.6
Wan 2.6 se sitúa en el centro de la escala de generación de wan-video, por encima de la 2.5 y por debajo de la nueva serie 2.7. Usa una arquitectura de transformador de difusión entrenada con 14 000 millones de parámetros, lo que le da bastante más capacidad que las variantes ligeras de 1.300 millones de la misma familia. El mayor número de parámetros no se nota tanto en los benchmarks abstractos como en una capacidad muy concreta: la de mantener la identidad de los objetos y la apariencia de las superficies a lo largo de los fotogramas sin necesidad de pasos de eliminación de ruido agresivos.
La arquitectura que hay detrás
El modelo procesa el video como una secuencia de fotogramas latentes mediante un mecanismo de atención completa, en lugar de atención por ventana deslizante, y esa es una de las razones por las que maneja mejor los arcos de movimiento largos que los modelos limitados por ventana. La atención temporal completa significa que cada fotograma de la secuencia puede influir directamente en todos los demás, lo que evita el problema de "deriva", en el que un objeto en movimiento va cambiando poco a poco de forma o de color a medida que avanza el clip.
Por qué importa el número de parámetros
Un modelo de 14B tiene aproximadamente diez veces más capacidad de representación que uno de 1,3B. En la práctica, esto significa que la red puede almacenar y aplicar priors de movimiento más precisos a partir de los datos de entrenamiento. Cuando escribes un prompt como "una mujer caminando por un campo", un modelo pequeño tiene que generalizar mucho. El modelo grande ha visto suficiente variedad como para saber cómo se mueve una tela realista a distintas velocidades de paso, qué le hace la hierba al pisarla con el viento y cómo mantener una dirección de luz coherente durante toda la duración del clip.
💡 El modelo de 14B es más lento que las variantes rápidas, pero produce una textura y una estabilidad de bordes claramente mejores. Para renders de calidad final, prefiérelo siempre frente a las versiones optimizadas para velocidad.
El problema del movimiento en el video con IA
La generación de video con IA lleva años arrastrando un problema constante: los fotogramas se ven muy bien por separado, pero la transición entre ellos genera artefactos visuales, texturas parpadeantes o deformaciones en las extremidades. Este es el problema de la coherencia temporal, y es justo lo que distingue a los buenos modelos de video de los mediocres.
La coherencia temporal explicada
La coherencia temporal significa que la identidad visual de un objeto se mantiene constante con el tiempo. Una chaqueta roja sigue siendo roja. El pelo conserva la misma longitud. Una mano que se mueve hacia la izquierda sigue moviéndose hacia la izquierda sin temblores aleatorios. Los modelos de difusión generan video eliminando ruido de los fotogramas y, sin un acoplamiento temporal fuerte, cada fotograma es básicamente una versión ligeramente modificada de ruido aleatorio limitado por el prompt. Las conexiones entre fotogramas son débiles, así que las pequeñas inconsistencias se acumulan y terminan convertidas en artefactos visibles.
Qué hace que el movimiento parezca "de IA"
Hay tres fallos concretos que los espectadores reconocen con más facilidad:
- Texturas que se deslizan: patrones de superficie como la veta de la madera, el tejido de una tela o la textura de la piel parecen desplazarse y derivar aunque el objeto esté quieto
- Deformación de extremidades: dedos, brazos o piernas cambian de forma durante el movimiento porque el modelo pierde la coherencia anatómica
- Parpadeo del fondo: los elementos estáticos del fondo laten o centellean entre fotogramas por las variaciones de ruido en cada uno
Wan 2.6 aborda los tres a través de su arquitectura de atención y de un proceso de entrenamiento diseñado específicamente en torno a la pérdida de coherencia del movimiento, que penaliza al modelo durante el entrenamiento precisamente por este tipo de artefactos.
Cómo maneja Wan 2.6 el detalle
El detalle espacial en el video es más difícil que en las imágenes porque el modelo tiene que mantenerlo a lo largo del tiempo. Generar un solo fotograma nítido ya es un reto. Mantener ese mismo nivel de nitidez 40 fotogramas después, cuando la cámara se ha movido o el sujeto ha cambiado de posición, es un problema fundamentalmente más difícil.
Renderizado de texturas finas
Wan 2.6 usa un VAE (autoencoder variacional) con una relación de compresión espacial más alta que las versiones anteriores, lo que conserva más información de textura en el paso de codificación latente. En términos de resultado, esto significa que el tejido de una tela, los poros de la piel, la separación de los mechones de pelo y los materiales de superficie rugosa mantienen mejor su estructura que en la 2.5 o en modelos anteriores.
La diferencia entre 480p y 720p
Wan 2.6 genera a 720p nativos en su configuración estándar, un paso por encima de los 480p de las variantes antiguas. Pero la cifra de resolución por sí sola no lo explica todo. Un video de 720p con poca textura se ve peor que un clip nítido de 480p. Lo que Wan 2.6 ofrece es contenido de alta frecuencia espacial a 720p, es decir, renderiza detalles pequeños y densos en lugar de manchas de color suaves y de baja frecuencia. El detalle fino del pelo, el pelaje, los textiles y el follaje es donde esto se ve con más claridad en los resultados reales.
💡 Para planos cercanos en los que el detalle de textura es crítico, como demostraciones de productos, animación de retratos o movimiento de telas, Wan 2.6 es una opción más sólida que muchos modelos de mayor resolución que sacrifican detalle por velocidad.
T2V frente a I2V: cuál usar
Wan 2.6 tiene dos variantes principales que sirven a flujos de trabajo creativos distintos. Elegir la adecuada cambia tanto lo que tienes que preparar como el tipo de resultado que puedes esperar.
Texto a video con Wan 2.6 T2V
Wan 2.6 T2V toma un prompt de texto y genera un clip de video desde cero. Es la opción adecuada cuando creas contenido a partir de una idea y no de una imagen de origen. Funciona mejor con:
- Prompts centrados en la acción: las descripciones de movimiento dan mejores resultados que las descripciones de escenas estáticas
- Prompts atmosféricos: el clima, las condiciones de luz y el movimiento del entorno (viento, lluvia, multitudes) son áreas en las que Wan 2.6 T2V destaca
- Bucles de clips cortos: clips de 4 a 8 segundos con una dirección de movimiento clara
El modelo responde bien a las instrucciones de movimiento de cámara en el prompt. Frases como "dolly lento hacia delante", "plano de seguimiento" o "cámara estática" afectan de forma notable al comportamiento del resultado.
Imagen a video con Wan 2.6 I2V
Wan 2.6 I2V toma una imagen fija y la anima. Es la opción más controlada porque defines con precisión el estado visual de partida. Después, el modelo genera un movimiento coherente tanto con el contenido de tu imagen como con el prompt de texto que describe el movimiento.
Para animar retratos, fotografía de producto, imágenes arquitectónicas o ilustraciones en video, I2V es el flujo de trabajo superior. El modelo es especialmente bueno en:
- Animación ambiental natural (árboles, agua, cielo, tela)
- Movimiento sutil del rostro y del cuerpo sin distorsión
- Movimientos de cámara con paralaje en fotografía de paisaje y arquitectura
Wan 2.6 I2V Flash es la versión más rápida del mismo modelo, que cambia algo de fidelidad de detalle por un tiempo de generación bastante menor. Úsala para iterar y hacer borradores, y luego pasa al I2V completo para el resultado final.
Cómo usar Wan 2.6 en PicassoIA
Ambas variantes de Wan 2.6 están disponibles directamente en la plataforma de PicassoIA. Este es el proceso paso a paso para cada una.
Paso a paso: texto a video
- Abre Wan 2.6 T2V en PicassoIA
- Escribe tu prompt en el campo de texto. Empieza por el sujeto principal y su movimiento, y luego añade el entorno y la luz
- Fija la resolución en 720p para conservar mejor el detalle
- Fija la duración entre 4 y 6 segundos para obtener los resultados más coherentes
- Ajusta el guidance scale entre 6 y 8 (los valores más altos siguen el prompt de forma más literal; los más bajos permiten más variación creativa)
- Haz clic en Generate y espera a que se renderice el clip
💡 Añadir descriptores de velocidad de movimiento a tu prompt ("lentamente", "rápidamente", "derivando con suavidad") tiene un efecto medible en la velocidad del resultado. Wan 2.6 T2V interpreta estos modificadores de forma más fiable que muchos modelos rivales.
Paso a paso: imagen a video
- Abre Wan 2.6 I2V en PicassoIA
- Sube tu imagen de origen. Para mejores resultados usa una imagen 16:9 de 1280x720 o superior
- Escribe un prompt de movimiento que describa qué debe moverse y cómo. No describas el contenido de la imagen, solo el movimiento ("el pelo fluye suavemente con una brisa cálida, las hojas del fondo se agitan despacio")
- Fija la fuerza de movimiento entre 50 y 70 para obtener un movimiento de aspecto natural sin distorsión excesiva
- Genera el clip
Consejos de parámetros que importan
| Parámetro | Rango recomendado | Efecto |
|---|
| Guidance Scale | 6,5 a 7,5 | Adherencia al prompt frente a calidad visual |
| Fuerza de movimiento (I2V) | 45 a 75 | Cantidad de movimiento frente a fidelidad de la imagen |
| Pasos de inferencia | 30 a 50 | Calidad frente a velocidad de generación |
| Duración | 4 a 6 segundos | Coherencia a lo largo del tiempo |
Los ajustes de fuerza de movimiento más bajos en I2V son ideales para animar retratos y productos, cuando buscas una vida sutil en lugar de un movimiento dramático. Los valores más altos funcionan en planos de entorno y de acción, donde el movimiento a gran escala es precisamente el objetivo.
Wan 2.6 frente a modelos cercanos
Saber dónde se sitúa Wan 2.6 respecto a los modelos vecinos te ayuda a elegir la herramienta adecuada para cada proyecto.
Frente a Wan 2.5 y Wan 2.7
Wan 2.5 T2V es un predecesor capaz, pero muestra las debilidades del modelo anterior en el renderizado de texturas finas. En clips con tela, pelo o materiales de superficie complejos, la 2.5 tiende a producir más texturas que se deslizan. Wan 2.6 resuelve esto de forma directa con su VAE mejorado y su acoplamiento de atención.
Wan 2.7 T2V y Wan 2.7 I2V representan el siguiente paso, con mejoras adicionales en resolución y dinámica de movimiento. Para el resultado de mayor calidad dentro de la serie Wan, la 2.7 es el techo actual. Pero Wan 2.6 sigue siendo una opción sólida cuando importa el tiempo de generación, ya que con ajustes comparables es más rápido que la 2.7 de forma constante.
Frente a otros estudios
Una comparación centrada en las métricas en las que Wan 2.6 se distingue:
| Modelo | Fluidez del movimiento | Detalle de textura | Velocidad | Resolución |
|---|
| Wan 2.6 T2V | Muy alta | Alta | Media | 720p |
| Wan 2.6 I2V | Muy alta | Muy alta | Media | 720p |
| Wan 2.5 T2V | Media | Media | Rápida | 480p a 720p |
| Wan 2.7 T2V | Excelente | Muy alta | Lenta | 1080p |
| Wan 2.6 I2V Flash | Alta | Media | Muy rápida | 720p |
La variante Flash sacrifica detalle de textura a cambio de velocidad, lo que la convierte en la herramienta adecuada para iterar rápido y no para el resultado final.
Cuándo Wan 2.6 es la elección correcta
No todos los proyectos necesitan Wan 2.6. Saber cuándo recurrir a él frente a una alternativa más rápida o de mayor resolución te ahorra tiempo y créditos.
Escenarios en los que destaca
- Animación de productos: animar una foto de producto con movimiento sutil, reflejos que rotan o movimiento de tela. La variante I2V lo resuelve con una distorsión mínima.
- Animación de retratos: añadir respiración natural, movimiento de ojos o desplazamiento del pelo a un retrato fijo
- Clips de naturaleza y entorno: agua, viento, follaje y movimiento atmosférico son áreas en las que la coherencia temporal importa más
- Contenido corto para redes sociales: bucles de 4 a 6 segundos en los que un movimiento fluido y pulido es el requisito de calidad principal
Cuándo elegir otra cosa
- Clips largos de más de 10 segundos: La coherencia temporal se degrada en duraciones más largas. Para clips de más de 8 segundos, Wan 2.7 I2V u otros modelos con mejor coherencia a largo plazo merecen el tiempo de generación extra.
- 1080p es un requisito indispensable: Wan 2.6 llega como máximo a 720p. Para una salida en 1080p, pasa a Wan 2.7.
- Prototipado rápido en volumen: Si necesitas 20 clips de prueba antes de decidirte por un estilo, Wan 2.6 I2V Flash o las versiones más rápidas te ahorrarán mucho tiempo.
💡 Usa Flash para las iteraciones de concepto y cambia al modelo completo cuando hayas fijado el enfoque del movimiento y la redacción del prompt. Este flujo de trabajo suele dar mejores resultados finales que ir directamente al modelo completo sin iterar.
Lo que muestran los resultados reales
Al observar los resultados de Wan 2.6 con distintos tipos de sujeto aparecen patrones constantes. La animación de telas y ropa es donde supera a la mayoría de alternativas de su misma clase de velocidad. Un prompt sencillo como "vestido ligero moviéndose con el viento" produce una simulación de tela que hace pocos años habría requerido un renderizado basado en físicas.
El movimiento humano es fiable en velocidades de lenta a media. Caminar, girar la cabeza y los gestos con las manos se renderizan con buena coherencia anatómica. El movimiento atlético rápido es el único terreno en el que los artefactos siguen apareciendo con más frecuencia.
La animación de entornos es una fortaleza constante. El agua, las nubes, el fuego y la vegetación responden a los prompts de maneras que parecen físicamente plausibles. El modelo parece haberse entrenado con volúmenes importantes de metraje de naturaleza, y eso se nota en la calidad de salida para estos tipos de sujeto.
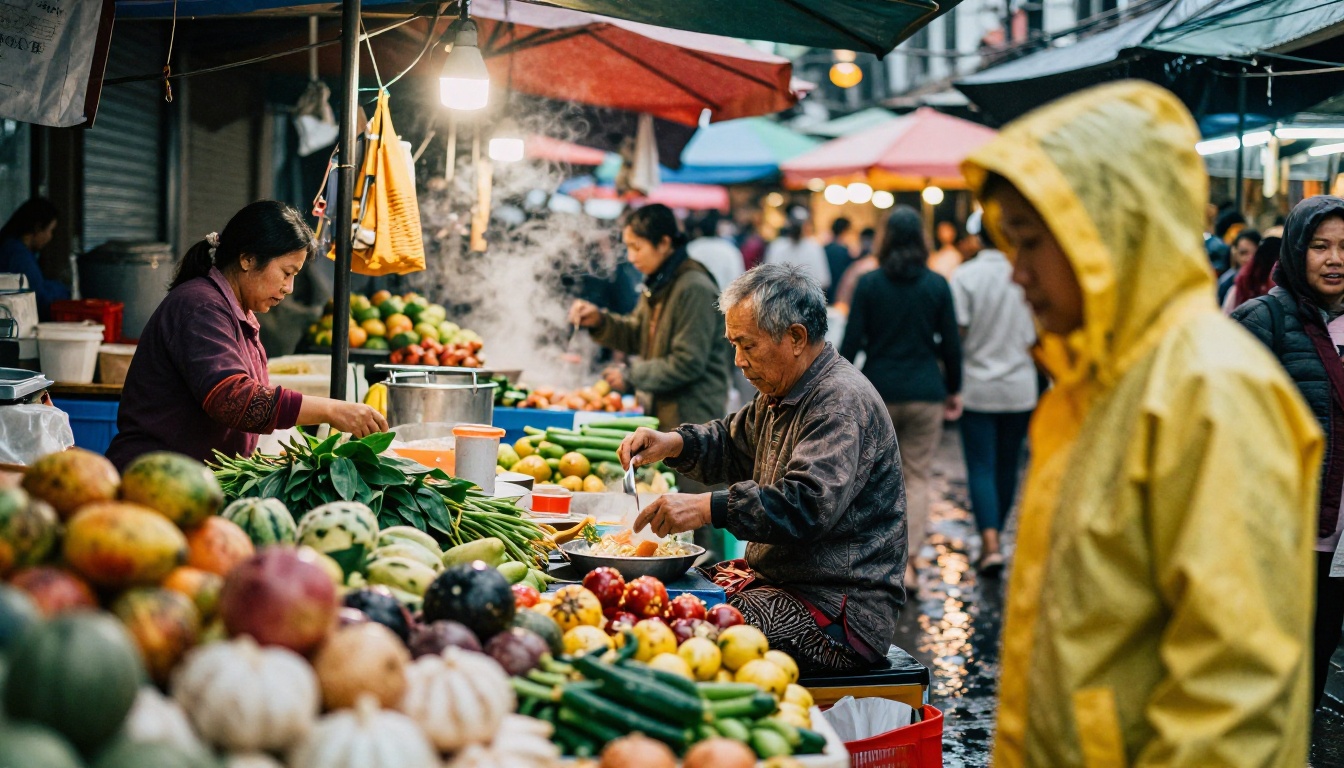
La animación arquitectónica y de producto a través de la vía I2V produce resultados limpios con una distorsión mínima. Los movimientos de cámara con paralaje sobre fotografía fija son especialmente sólidos y crean una ilusión de profundidad convincente a partir de imágenes de origen planas.
Empieza a crear tus propios videos en PicassoIA
La mejor forma de ver lo que Wan 2.6 hace de verdad en tu caso concreto es probar tus propios prompts. PicassoIA te da acceso a Wan 2.6 T2V y Wan 2.6 I2V, junto con la familia Wan completa, incluido Wan 2.5 T2V Fast, Wan 2.7 T2V y más de 100 otros modelos de texto a video, todo en una única interfaz.
Si empiezas con la animación por primera vez, comienza con la variante I2V. Sube una fotografía que ya tengas, escribe un prompt de movimiento sencillo (de 15 a 25 palabras que describan solo qué se mueve y cómo) y genera con la configuración predeterminada. Ese primer resultado te dará una línea base clara de lo que el modelo hace bien con tu tipo de contenido.
A partir de ahí, ajustar una sola variable cada vez, ya sea la redacción del prompt, la fuerza de movimiento o el guidance scale, es el camino más rápido hacia la calidad que buscas. Wan 2.6 premia la experimentación, y con la variante Flash disponible para iterar rápido, el costo de experimentar es bajo.


