Si sigues de cerca el mundo del video con IA, ya sabes lo rápido que avanza todo. Los modelos que parecían impresionantes hace seis meses ahora se ven lentos comparados con lo que hay hoy. Kling 3.0 Omni está en la cima de esa evolución. Desarrollado por Kuaishou, representa un replanteamiento de cómo la generación de video con IA maneja la complejidad, la física del movimiento y las entradas multimodales a gran escala. Los resultados hablan por sí solos, de una forma que las versiones anteriores simplemente no podían alcanzar.
Qué hace diferente a Kling 3.0 Omni
La mayoría de las herramientas de video con IA caen en uno de dos grupos: rápidas pero de baja calidad, o de alta calidad pero muy lentas. Kling 3.0 Omni evita esa contrapartida gracias a su arquitectura Omni, que hace referencia a su capacidad para procesar varios tipos de entrada a la vez y mantener una fidelidad de salida completa en 1080p. No es una mejora añadida a posteriori. La arquitectura se rehizo específicamente para manejar la complejidad que los sistemas de texto a video anteriores no podían gestionar con esta resolución.
El "Omni" del nombre indica algo concreto: este modelo acepta texto, imágenes y datos de movimiento de referencia como entradas en una sola pasada de generación. Es un cambio importante respecto a las versiones anteriores de Kling, que requerían modos de modelo separados para los flujos de texto a video y de imagen a video. Ahora todo funciona a través de un único sistema unificado.
La arquitectura "Omni"
A nivel técnico, la arquitectura Omni introduce un espacio de tokens unificado para la generación de video. En lugar de codificar las entradas de texto e imagen por caminos separados y combinarlas al final del proceso, Kling 3.0 Omni fusiona estas señales desde el principio. El resultado es una coherencia espacial más sólida entre fotogramas y una interpretación más natural de la relación entre los sujetos y los entornos durante toda la duración del clip.
En la práctica, esto significa que cuando escribes un prompt que describe a una persona caminando bajo la lluvia, el modelo no genera una persona y luego añade la lluvia como un efecto aparte. Genera la escena como un evento físico unificado, con la lluvia afectando el pelo, la ropa y los reflejos del pavimento de forma coherente y realista. El entorno y el sujeto existen en el mismo mundo físico, no como dos elementos generados por separado y luego combinados.
Este enfoque también mejora cómo el modelo gestiona las transiciones. En la mayoría de los sistemas de video con IA, el primer y el último fotograma de un clip suelen alejarse bastante de lo que ocurre en el centro. Kling 3.0 Omni mantiene la coherencia visual desde el fotograma inicial hasta el final, algo que importa muchísimo a quien une clips en la posproducción.
Modos de calidad frente a velocidad
Kling v3 Omni Video funciona con dos niveles de salida. El modo estándar entrega clips de 720p en menos de dos minutos, adecuados para iterar rápidamente y probar prompts. El modo de alta fidelidad genera salida a 1080p completos con un tiempo de procesamiento más largo, pensado para clips de calidad de producción en los que cada detalle importa.
No se trata solo de una diferencia de resolución. El modo de alta fidelidad aplica pasadas adicionales de coherencia temporal que suavizan el movimiento entre fotogramas y reducen los artefactos de parpadeo que afectan a los modelos más baratos durante movimientos rápidos de cámara o cuando hay varios sujetos activos en el mismo fotograma. Para la entrega final, es el único modo que merece la pena usar.
Capacidades principales que vale la pena conocer
Kling 3.0 Omni abarca mucho terreno, pero hay algunas capacidades que destacan por ser realmente mejores que lo que ofrecen hoy los modelos competidores. Son las funciones que cambiarán la forma en que ves el video con IA como herramienta de producción y no como una novedad.
Texto a video que de verdad funciona
La primera decepción de la mayoría de personas con las herramientas de video con IA es la distancia entre lo que describe el prompt y lo que genera el modelo. Kling 3.0 Omni reduce esa distancia de forma notable gracias a un análisis del lenguaje natural de alta precisión. Los prompts largos y detallados que incluyen instrucciones de movimiento de cámara, acciones de los sujetos y condiciones ambientales se respetan uno a uno, en lugar de promediarse en una interpretación vaga.
Prompts como "una mujer con un abrigo rojo camina despacio por una calle empedrada y mojada, la cámara hace un paneo a la izquierda, luz de mañana nublada" producen resultados en los que cada elemento descrito está presente y colocado correctamente. El abrigo es rojo. La calle está mojada y refleja la luz. La cámara hace el paneo. La iluminación corresponde a una mañana nublada. Ese nivel de fidelidad solía requerir edición posterior en herramientas aparte o varios intentos de regeneración con prompts ajustados.
Coherencia de movimiento y física
El mayor salto técnico de Kling 3.0 Omni respecto a versiones anteriores es la coherencia de movimiento. Los modelos anteriores generaban un movimiento aceptable de un solo sujeto, pero les costaba cuando varios elementos se movían a la vez. Una persona caminando mientras le sopla el pelo y las palomas se dispersan al fondo producía resultados irregulares, a veces caóticos. Los sujetos cambiaban de aspecto a mitad del clip. Los fondos parpadeaban.
La generación v3 aborda esto mediante un modelado de movimiento que tiene en cuenta la física más avanzado. La dinámica de la ropa, las interacciones con fluidos y las composiciones con varios sujetos se mantienen coherentes de forma más fiable durante toda la duración del clip. Observa cómo se mueve la tela con el viento, cómo cae el agua de un recipiente o cómo interactúan dos personas en el mismo fotograma, y verás la diferencia de inmediato respecto a lo que producían las versiones anteriores.
Sensibilidad al prompt
Una cualidad poco valorada de Kling v3 Omni Video es cómo gestiona el espacio negativo y el contexto implícito. Si tu prompt describe una escena interior con una ventana al fondo, el modelo infiere la iluminación exterior y la profundidad adecuadas sin que se le indique explícitamente. Este tipo de inferencia contextual reduce la cantidad de ingeniería de prompts necesaria para obtener resultados profesionales.
También responde bien al lenguaje de dirección de cámara. Términos como "ángulo bajo", "plano de seguimiento", "cambio de enfoque" y "travelling hacia delante" se interpretan y aplican de forma constante, lo que da una ventaja clara a quien conoce el lenguaje de la cinematografía. No es un modelo que te obligue a dar forma antinatural a tus prompts. Escribe como hablaría un director y el modelo te seguirá.
Kling 3.0 Omni frente a otras herramientas de video con IA
Así se compara Kling v3 Omni Video con otros modelos líderes disponibles actualmente:
| Modelo | Resolución máxima | Entrada multimodal | Coherencia de movimiento | Velocidad |
|---|
| Kling v3 Omni | 1080p | Sí (texto + imagen) | Excelente | Moderada |
| Kling v2.6 | 1080p | Parcial | Buena | Moderada |
| Kling v2.5 Turbo Pro | 1080p | No | Buena | Rápida |
| Kling v3 Video | 1080p | No | Muy buena | Rápida |
| Veo 3 | 1080p | Solo texto | Muy buena | Lenta |
| Sora 2 | 1080p | Solo texto | Buena | Lenta |
La tabla muestra dónde se sitúa Kling 3.0 Omni en el panorama general. Su soporte de entradas multimodales y su coherencia de movimiento lo colocan a la cabeza, mientras que la generación de audio nativo sigue siendo una carencia frente a algunos competidores. En calidad visual pura y control preciso del prompt, es actualmente la opción más sólida disponible a través de una plataforma para particulares.
Cómo usar Kling 3.0 Omni en PicassoIA
Kling v3 Omni Video está disponible directamente en PicassoIA, sin necesidad de credenciales de API, cuenta de desarrollador ni ninguna configuración local. Todo el proceso, desde el prompt hasta el clip descargado, lleva menos de diez minutos una vez que sabes lo que haces.
Paso 1: escribe un prompt sólido
Ve a la página de Kling v3 Omni Video en PicassoIA y localiza el campo de entrada del prompt. Tu prompt debe seguir una estructura de Sujeto + Acción + Entorno + Iluminación + Cámara:
💡 Estructura del prompt: "[Sujeto haciendo una acción], [descripción del entorno], [condiciones de iluminación], [ángulo y movimiento de cámara]."
Ejemplo de prompt que funciona bien:
"Un chef con delantal blanco emplata con cuidado un plato colorido sobre una encimera de mármol oscuro, lámparas colgantes de luz cálida suave sobre él, plano cenital cerrado que se aleja poco a poco para revelar la cocina entera"
Evita descriptores vagos como "bonito" o "increíble". La especificidad siempre gana. El modelo ha sido entrenado con datos suficientes para saber cómo se ve "un callejón parisino estrecho al atardecer con adoquines mojados". Necesita ese nivel de descripción para rendir al máximo.
Paso 2: elige la duración y el modo
PicassoIA muestra los parámetros principales de generación justo debajo del campo del prompt:
- Duración: 5 segundos o 10 segundos. Para probar prompts y revisar la composición, empieza con 5 segundos. Para la salida final, usa 10 segundos.
- Modo: estándar (720p, más rápido) o alta fidelidad (1080p, más lento). Genera primero en estándar para verificar la composición de la escena y luego cambia a alta fidelidad para el clip final.
- Relación de aspecto: 16:9 para formato horizontal o panorámico, 9:16 para formatos verticales de redes sociales y 1:1 para salida cuadrada.
El flujo de dos pasos, probar en calidad estándar antes de comprometerte con una generación de alta fidelidad, ahorra mucho tiempo. Una composición que no funciona a 720p no se salvará por renderizarla a 1080p.
Paso 3: añade una imagen de referencia (opcional)
La arquitectura Omni acepta una imagen de entrada junto con tu prompt de texto. Esta imagen actúa como ancla visual de la escena. Sube una foto de un lugar concreto y el modelo la usará como referencia del entorno mientras aplica las acciones y el movimiento descritos en tu prompt.
Esto resulta especialmente útil para contenido de marca, cuando necesitas escenas ambientadas en un lugar concreto o con un producto específico visible en el encuadre. En lugar de describir cada detalle del entorno con texto, dejas que la imagen aporte esa información y centras el prompt en lo que se mueve y cómo lo hace.
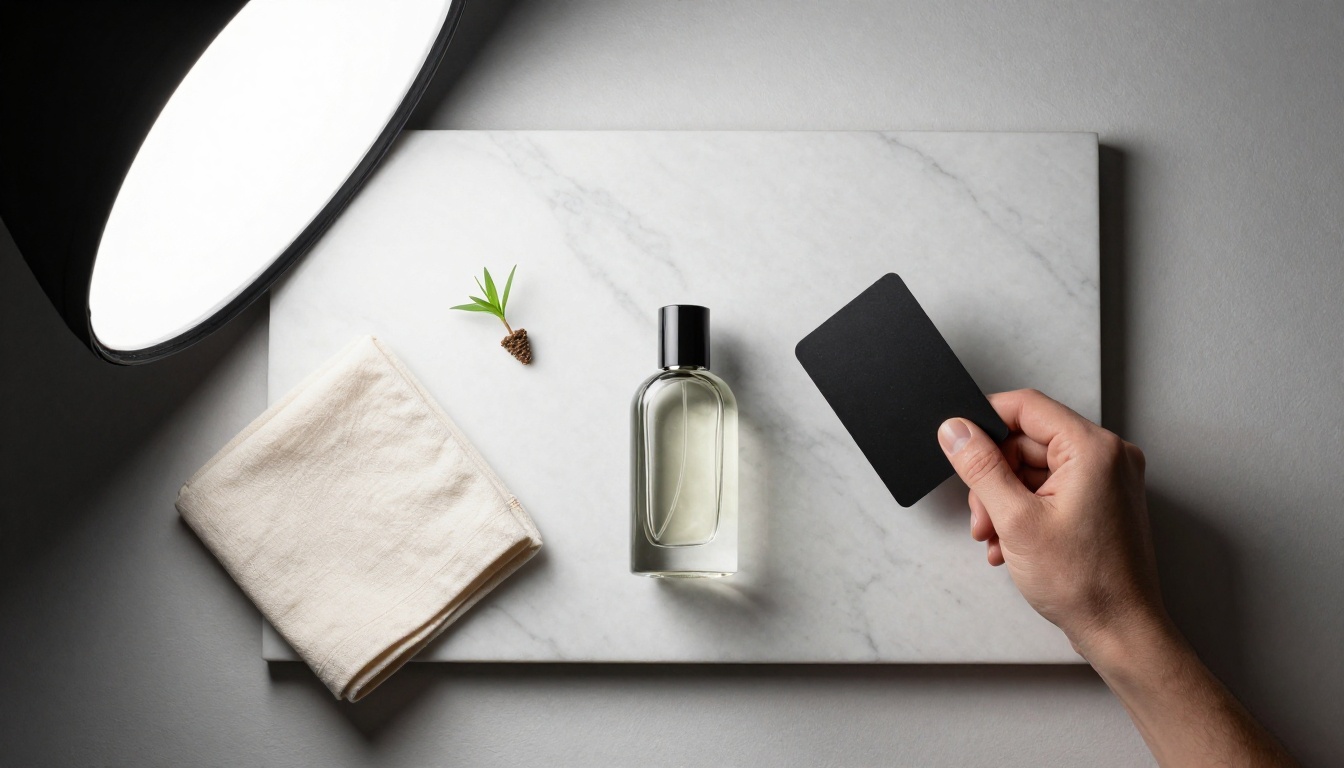
💡 Consejo: usa una imagen de referencia limpia y bien iluminada, sin retoques intensos ni filtros. El modelo lee la información de iluminación de la imagen de referencia, así que una foto sobreexpuesta o estilizada desviará el resultado en una dirección no deseada.
Paso 4: genera e itera
Haz clic en generar y espera a que se procese. El modo estándar suele completarse en 60 a 90 segundos en la infraestructura de PicassoIA. El modo de alta fidelidad tarda entre 3 y 5 minutos según la carga.
Cuando llegue el clip, revisa estos puntos antes de darlo por definitivo:
- Coherencia del sujeto durante toda la duración (¿los rostros y los objetos se mantienen coherentes de un fotograma a otro?)
- Estabilidad del fondo (fíjate en temblores o parpadeos en los elementos estáticos del entorno)
- Inicio y final del movimiento (¿la acción empieza y termina de forma natural dentro del clip?)
- Artefactos en los bordes de los sujetos en movimiento, sobre todo alrededor del pelo y las manos
Si alguno de estos fallos aparece, la solución más eficaz suele ser añadir un lenguaje espacial más preciso al prompt y regenerar primero en modo estándar. Los prompts vagos producen resultados irregulares; los detallados, resultados fiables.
Cómo escribir bien prompts para Kling 3.0 Omni
La diferencia entre un resultado mediocre y un clip listo para producción suele depender por completo de cómo está estructurado el prompt. Kling 3.0 Omni premia la especificidad más que ninguna versión anterior de la familia Kling, y más que la mayoría de los modelos competidores de este nivel.
Fórmula Sujeto-Acción-Entorno
La estructura de prompt más fiable para Kling v3 Omni Video sigue cinco componentes:
[QUIÉN] + [QUÉ HACE] + [DÓNDE] + [FUENTE DE LUZ] + [INSTRUCCIÓN DE CÁMARA]
- Quién: describe brevemente la apariencia física. "Una mujer en la treintena con el pelo corto y oscuro y una americana de lino" funciona mejor que solo "una mujer". Cuanto más anclada esté la descripción del sujeto, más coherente será entre fotogramas.
- Qué hace: usa verbos activos y concretos. "Sirve café despacio en una taza de cerámica blanca" supera a "prepara café". El verbo y el objeto juntos dan al modelo una trayectoria de movimiento específica que seguir.
- Dónde: incluye texturas de superficies, pistas de profundidad y escala. "Una calle estrecha de París con adoquines mojados, edificios altos de piedra a ambos lados y una terraza de café visible al fondo" le da al modelo suficientes datos espaciales para construir una profundidad y una perspectiva precisas.
- Fuente de luz: especifica dirección y calidad. "Luz cálida de media tarde desde la izquierda, que proyecta sombras largas sobre el suelo" supera a "día luminoso", porque le da al modelo un ángulo de iluminación concreto que aplicar de forma constante.
- Cámara: usa términos cinematográficos reales. "Plano general de establecimiento que se acerca despacio hasta un primer plano medio" supera a "la cámara avanza". El modelo ha sido entrenado con lenguaje cinematográfico y responde con precisión a él.
Qué evitar en los prompts
Algunos hábitos de prompts que funcionan bien en los generadores de imágenes perjudican activamente a los resultados de video con IA. Ser consciente de ellos evita muchas generaciones fallidas:
- Palabras clave de estilo sin especificidad visual, como "cinematográfico" o "fotorrealista", son demasiado vagas para un modelo de video. Describe la calidad visual real: "filmado en película de 35 mm con grano natural y profundidad de campo reducida".
- Acumular adjetivos sin contexto. "Atardecer precioso espectacular magnífico" se lee como ruido para el modelo. "Atardecer con tonos ámbar y rosados, sol situado 10 grados por encima del horizonte, nubes con contraluz" funciona porque da al modelo parámetros visuales reales que aplicar.
- Pedir posiciones de cámara contradictorias. Describir a la vez un primer plano y un plano general de establecimiento genera una confusión espacial que el modelo no puede resolver de forma coherente.
- Saturar la escena con demasiados sujetos y acciones simultáneas. Kling v3 Omni Video maneja bien de uno a tres sujetos activos. Con más, la coherencia de movimiento empieza a romperse, sobre todo en escenas con movimiento rápido.
Casos de uso reales que funcionan
Saber cómo funciona el modelo es útil. Ver dónde aporta un valor constante y real es todavía más útil. Estos tres casos de uso representan los ámbitos en los que Kling 3.0 Omni ha demostrado su valor en flujos de producción reales.
Contenido para redes sociales
Los creadores de formatos cortos usan Kling v3 Omni Video para generar metraje de apoyo (B-roll) que, de otro modo, requeriría rodajes en exteriores y un equipo completo. Una marca de fitness puede generar clips de alguien entrenando en distintos entornos sin reservar ni un solo día de producción. Una cuenta de viajes puede producir planos de establecimiento de ciudades sin estar allí. Una marca de estilo de vida puede crear contenido de temporada sin volver a rodar cada trimestre.
El soporte de relación de aspecto 9:16 significa que los resultados encajan directamente en Instagram Reels, TikTok y YouTube Shorts sin recortes ni reformateo. Para las cuentas que publican varias veces por semana, el ahorro de tiempo es considerable.
Videos de demostración de productos
La entrada de imagen de referencia resulta especialmente potente para el contenido de productos. Sube una foto limpia del producto, describe el entorno y el movimiento de cámara en el prompt, y el modelo genera un clip que muestra el producto en contexto. Frascos de perfume sobre encimeras de mármol, zapatillas sobre el pavimento exterior, tazas de café con luz de la mañana, productos de cuidado de la piel en estantes de baño: todo es posible con un prompt bien estructurado y una imagen de producto limpia.
Lo que antes requería reservar un estudio, un estilista de atrezo, un fotógrafo y un equipo de video ahora puede prototiparse en menos de una hora. El resultado final puede seguir yendo a un rodaje real para el contenido principal, pero el proceso de ideación y aprobación se acelera mucho cuando los clientes pueden reaccionar a imágenes en movimiento en lugar de a tableros de inspiración estáticos.
Escenas de cortometrajes
Los cineastas independientes usan Kling v3 Omni Video junto con Kling v3 Motion Control para prototipar composiciones de escena antes de comprometerse con la producción. Genera primero la escena con IA, revisa el encuadre y la dinámica del movimiento, y luego rueda con actores reales usando el resultado de la IA como referencia visual para el director y el director de fotografía.
Este flujo de trabajo cambia la preproducción de forma fundamental. El storyboard pasa a ser interactivo en lugar de estático. Puedes probar tres enfoques de cámara distintos para la misma escena en el tiempo que te llevaría dibujar un solo panel del storyboard. Decisiones que antes se tomaban en el set ahora se toman antes de que nadie llegue a la localización.
Otros modelos de Kling que vale la pena probar
La familia Kling en PicassoIA cubre una gran variedad de casos de uso más allá de la v3 Omni. Elegir el modelo adecuado para cada tarea importa más que recurrir siempre al modelo insignia:
Si tu flujo de trabajo consiste más en animar fotos existentes que en generar escenas desde cero, Kling v2.6 Motion Control merece la pena probarlo junto con Kling 3.0 Omni. Los dos modelos se complementan bien en distintas etapas de una producción de video.
Empieza a crear con Kling 3.0 Omni
Kling 3.0 Omni eleva el techo de lo posible en la generación de video con IA a partir de un solo prompt. La arquitectura Omni, la mejora del modelado de física y el soporte de entradas multimodales se combinan en una herramienta que de verdad acelera los flujos de producción de video, en lugar de limitarse a generar clips de demostración impresionantes que no sirven de nada en un proceso de producción real.
Los prompts más eficaces son específicos, orientados a la dirección y apoyados en un lenguaje visual real. Empieza con la estructura Sujeto-Acción-Entorno-Luz-Cámara, prueba en calidad estándar antes de comprometerte con la salida en alta fidelidad y usa la entrada de imagen de referencia siempre que necesites anclar la escena a un lugar o producto concreto.
Ve a Kling v3 Omni Video en PicassoIA y prueba con un prompt real, algo de un proyecto en el que estés trabajando ahora mismo. Los resultados te mostrarán exactamente dónde encaja en tu flujo de trabajo y dónde seguirás necesitando un equipo de rodaje. La biblioteca completa de modelos de texto a video de PicassoIA te da la flexibilidad de elegir el modelo adecuado para cada trabajo. Kling 3.0 Omni es ahora mismo el modelo insignia, pero la herramienta correcta siempre depende de la salida concreta que quieras conseguir.


