Quelque chose a changé dans la génération de vidéos par IA avec l’arrivée de Kling v3 Omni Video. Pas au sens d’une simple mise à jour de version, mais d’une façon qui vous fait marquer une pause sur une image et vous demander sincèrement si ce que vous voyez a été généré ou filmé. La physique est différente. Le mouvement est différent. La conservation du sujet d’une image à l’autre est différente. Cette analyse présente ce que Kling v3 Omni Video fait réellement, sa position face à chaque concurrent sérieux, et la manière exacte de l’utiliser sur PicassoIA pour obtenir des résultats qui tiennent à plein écran.
Ce que fait réellement Kling v3 Omni
Kling v3 Omni Video est un modèle de texte vers vidéo et d’image vers vidéo développé par Kuaishou Technology (kwaivgi). La désignation « Omni » traduit un changement d’architecture précis : le modèle gère la génération conditionnée par le texte et celle conditionnée par l’image dans un seul pipeline unifié, au lieu d’utiliser deux modèles distincts reliés par des étapes de traitement intermédiaires.
Le résultat concret de cette architecture est des sorties plus cohérentes, une meilleure synthèse du mouvement et une cohérence du sujet nettement améliorée sur la fenêtre de génération de 5 à 10 secondes. Cette cohérence est ce qui distingue ce modèle de tout ce qui a précédé dans la lignée Kling.
Du texte à la vidéo de qualité cinéma
Le modèle convertit des prompts en langage naturel en vidéo, avec un son natif synchronisé. Décrivez une scène, un personnage, l’éclairage, le mouvement de caméra et ce qui change pendant la durée du clip, et vous obtenez des séquences qui tiennent en plein écran, sans cette dérive typique de l’IA qui caractérise encore la plupart des sorties des modèles vidéo.
Ce qui distingue Kling v3 Omni des versions précédentes de Kling n’est pas la seule résolution. C’est la physique du mouvement. Les cheveux bougent mèche par mèche. Le tissu réagit aux mouvements du corps avec un tombé réaliste. L’eau reflète et réfracte selon une optique correcte. Les visages génèrent des micro-expressions qui paraissent authentiques à une distance de visionnage normale. Ce sont ces détails précis qui déterminent si le public lit une séquence comme réelle ou comme synthétique.
L’architecture Omni expliquée
Les versions précédentes de Kling, comme Kling v2.1 et Kling v2.6, utilisaient des voies de conditionnement distinctes pour le texte et pour l’image. L’architecture Omni fusionne les tokens de texte et les tokens d’image dans un espace latent partagé grâce à un mécanisme d’attention unifié. Ce traitement commun explique pourquoi les générations conditionnées par une image dans Kling v3 Omni conservent l’identité visuelle avec autant de précision pendant toute la durée du clip.
Pour les flux de travail d’image vers vidéo, cela compte beaucoup. Fournissez au modèle une image source, et le visage, les vêtements et l’environnement du sujet sont conservés de la première image à la dernière, sans cette dérive progressive qui était un problème récurrent dans les modèles précédents.
Spécifications principales
| Spécification | Kling v3 Omni Video |
|---|
| Résolution maximale | 1080p |
| Fréquence d’images | 24 fps |
| Durée maximale | 10 secondes |
| Audio | Synchronisé natif |
| Modes de génération | Texte vers vidéo, image vers vidéo |
| Contrôle du mouvement | Piloté par le prompt |
La génération audio native mérite une mention particulière. Vous obtenez un son adapté au contexte, en même temps que la vidéo, en une seule étape de génération. Pas de passage audio séparé, pas de travail de synchronisation après coup.
Kling v3 Omni face à tous les grands concurrents
Le marché de la vidéo par IA compte en 2027 plus de modèles crédibles que jamais. Une comparaison honnête consiste à voir où Kling v3 Omni prend l’avantage, où la lutte est réellement serrée, et où certains concurrents disposent d’atouts structurels qu’il vaut la peine de connaître.
Face à Sora 2 Pro et Veo 3
Sora 2 Pro d’OpenAI produit une vidéo longue très cohérente, avec une bonne compréhension spatiale de la scène. Sa capacité à maintenir un monde cohérent sur un clip plus long est exceptionnelle. Là où Kling v3 Omni prend l’avantage : la qualité du mouvement image par image et la vitesse de génération par rapport à la fidélité de la sortie. Les clips plus longs de Sora présentent parfois une gigue temporelle que l’architecture de Kling gère plus en douceur dans sa fenêtre de durée.
Veo 3 de Google est sans doute le concurrent le plus proche sur la qualité visuelle brute. Sa synthèse audio native est excellente et son esthétique est soignée. Dans des tests à prompts équivalents, la cohérence de scène de Veo 3 est solide, mais Kling v3 Omni prend l’avantage sur la conservation de l’identité du sujet en image vers vidéo, ainsi que sur la maîtrise littérale des descripteurs de mouvement dans le prompt.
💡 Pour les créateurs qui ont besoin de mouvements prévisibles à partir de prompts précis, la réponse de Kling v3 Omni au langage de mouvement est plus littérale et plus contrôlable que le style plus interprétatif de Veo 3.
Face à Hailuo 02 et Seedance 2.5
Hailuo 02 de Minimax offre une sortie 1080p solide, avec une esthétique cinématographique qui convient bien aux contenus narratifs. C’est un concurrent sérieux. Son retard face à Kling v3 Omni se voit surtout dans la simulation physique : la dynamique du tissu, des fluides et des cheveux est nettement plus simplifiée dans les sorties de Hailuo 02.
Seedance 2.5 de ByteDance possède un avantage structurel réel pour les contenus plus longs, en produisant jusqu’à 30 secondes de vidéo cohérente. Pour ce cas d’usage précis, c’est le bon outil. Pour les clips cinématographiques de 5 à 10 secondes où la fidélité visuelle maximale est l’objectif, le plafond de qualité de Kling v3 Omni est plus élevé.
L’écart de qualité du mouvement
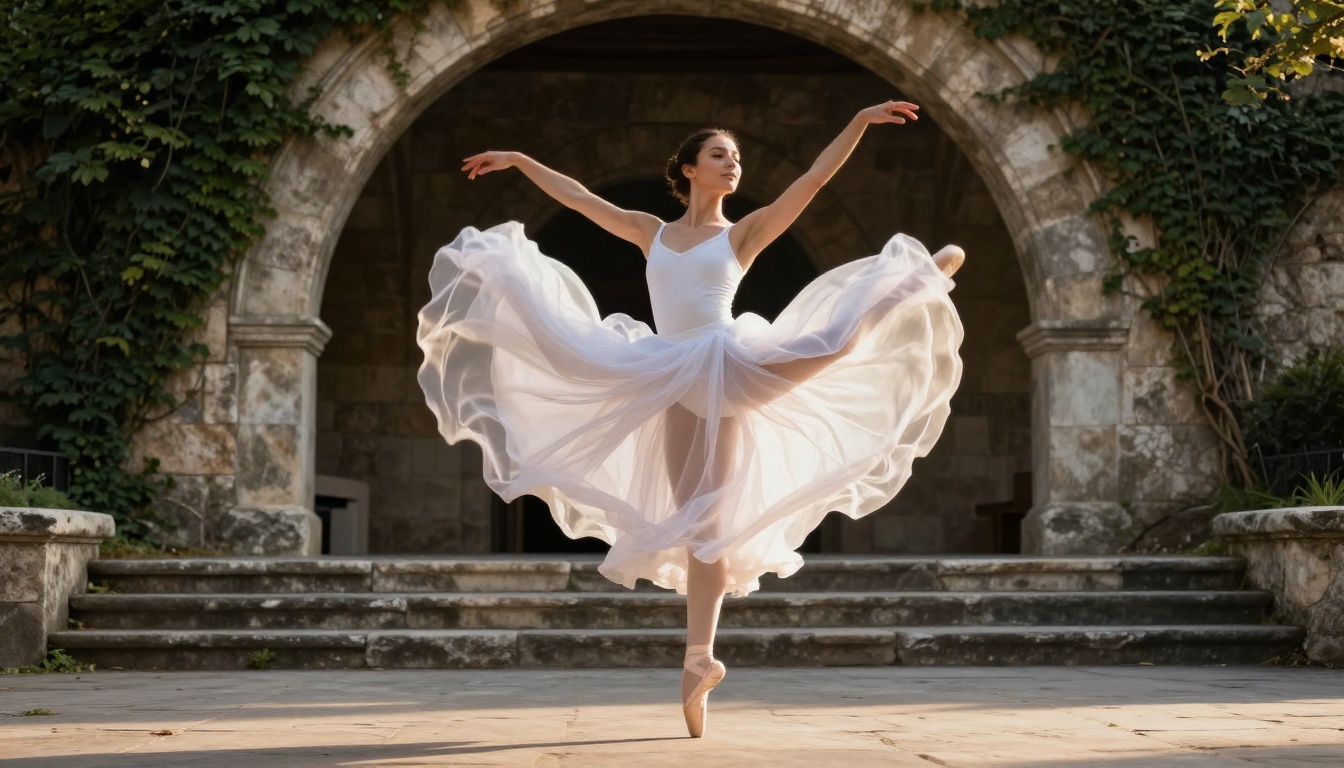
La qualité du mouvement est souvent confondue avec une lecture fluide, mais la véritable mesure est la fidélité physique au niveau de la matière. Les questions qui comptent vraiment :
- Dynamique du tissu : le tissu suit-il le corps ou glisse-t-il comme un plan distinct sur le sujet ?
- Comportement des cheveux : réagissent-ils mèche par mèche sous le vent, ou se soulèvent-ils comme une masse unique ?
- Micro-expressions : les muscles du visage s’activent-ils selon les schémas subtils qui paraissent être une émotion authentique ?
- Physique de l’environnement : une main déplace-t-elle réellement l’eau lorsqu’elle entre dans une surface liquide ?
- Mouvement secondaire : lorsqu’un personnage bouge, tout ce qui lui est attaché répond-il avec le décalage physique approprié ?
Kling v3 Omni obtient de meilleurs résultats que tout autre modèle actuellement disponible sur PicassoIA sur chacune de ces dimensions. C’est le modèle à privilégier lorsque le réalisme est non négociable.
Comparaison rapide en un coup d’œil :
Kling v3 Omni Video est disponible sur PicassoIA sans installation locale, sans configuration d’API et sans complexité liée aux crédits. Ouvrez la page du modèle et commencez à générer.
Rédiger des prompts qui donnent des résultats
Le changement le plus efficace que vous puissiez faire : rédigez vos prompts sous forme de séquence de mouvement chronologique plutôt que de description de scène statique. Kling v3 Omni est conçu, au niveau de son architecture, pour répondre au langage du mouvement.
Prompt faible : « Une femme qui marche à Paris »
Prompt efficace : « Une femme en manteau bleu marine ajusté avance lentement vers la caméra sur un boulevard pavé et mouillé, la tour Eiffel visible en arrière-plan au flou doux, son manteau bougeant doucement dans la brise matinale, la caméra effectue un travelling avant lent à mesure qu’elle s’approche, lumière matinale naturelle et couverte, 35 mm »
La version efficace indique quatre choses au modèle :
- Ce qui bouge et à travers quoi il bouge (le manteau dans l’air matinal, la caméra qui avance dans l’espace)
- Comment il bouge (lentement, doucement, à l’allure régulière d’un travelling)
- L’atmosphère (pavés mouillés, qualité de la lumière matinale couverte)
- L’objectif (35 mm, ce qui suggère une compression de perspective et une profondeur de champ précises)
Chaque génération construite selon cette structure en quatre parties produit un résultat exploitable. La plupart produisent un résultat excellent.
Flux de travail image vers vidéo
Pour la génération d’image vers vidéo sur PicassoIA :
- Préparez votre image source. Le modèle donne ses meilleurs résultats avec des images au sujet bien défini et à la composition solide. Générez-en une avec les outils d’image de PicassoIA ou importez la vôtre.
- Rédigez un prompt de mouvement décrivant ce qui change dans la vidéo, et non ce que l’image montre déjà. Concentrez-vous sur le mouvement, le comportement de la caméra et la dynamique de l’environnement.
- Choisissez votre durée. Commencez par 5 secondes lorsque vous testez un nouveau prompt. Itérez rapidement avant de lancer une génération complète de 10 secondes.
- Générez et examinez. L’architecture unifiée de Kling v3 Omni signifie que le sujet de votre image source persiste avec précision sur toute la durée du clip.
💡 Générez un test de 5 secondes avant de passer à 10 secondes. Le style de mouvement se conserve à l’identique aux deux durées, donc l’itération sur le prompt est deux fois plus rapide sur la durée la plus courte.
Obtenir une sortie 1080p constante
Le modèle vise automatiquement le 1080p via PicassoIA. Si une génération donne une qualité inférieure, essayez :
- Des prompts plus courts et plus ciblés. Les prompts complexes à plusieurs sujets déclenchent parfois un comportement de génération prudent.
- Des descripteurs de mouvement plus précis. Un langage de mouvement vague produit des sorties moins assurées, avec moins de détails.
- Des images source plus propres pour l’image vers vidéo. Les sujets bien éclairés, au contraste élevé et bien détachés de l’arrière-plan donnent systématiquement de meilleurs résultats.
Cas d’usage concrets
Vidéos commerciales et de marque
La fidélité physique de Kling v3 Omni le rend particulièrement efficace pour la visualisation de produits. Une montre au poignet. Un tissu qui bouge sur un mannequin. Un liquide versé dans un verre. De la vapeur qui s’élève d’une tasse de café. Ce sont autant de scénarios où les modèles vidéo IA précédents produisaient des résultats qui paraissaient manifestement synthétiques.
Avec Kling v3 Omni, le mouvement des produits est rendu avec l’authenticité matérielle qu’exige la photographie commerciale. Les marques bénéficient d’un parcours d’itération rapide, du concept au livrable : prompt, génération, examen, affinage. Le pipeline d’image vers vidéo permet aussi de conserver un même cadrage produit avec des scénarios de mouvement distincts pour chaque variante, ce qui est précieux pour des campagnes personnalisées à grande échelle.
Récit et courts métrages
La gestion des micro-expressions faciales par le modèle fait que les contenus centrés sur les personnages franchissent désormais la vallée de l’étrange à une distance de visionnage normale. Les moments d’émotion portent. Les interprétations paraissent crédibles. C’est un changement de capacité significatif pour les cinéastes indépendants.
Le flux combiné de Kling v3 Video pour les plans standard et de Kling v3 Motion Control pour les séquences chorégraphiées donne aux cinéastes une boîte à outils de préproduction avec une sortie de qualité réellement professionnelle. Pré-visualisez des plans complexes, générez des plans de coupe qui correspondent à l’étalonnage de votre tournage principal, et testez des concepts d’éclairage sans coût avant une mise en place physique.
Contenus pour les réseaux sociaux
Les créateurs de formats courts ont besoin d’itération rapide, d’une identité visuelle distinctive et d’une qualité constante sur plusieurs clips par jour. Kling v3 Omni gère cela mieux que tout modèle précédent, car le temps de génération reste faible par rapport à la qualité obtenue. L’audio natif supprime une étape de production distincte pour les créateurs qui veulent un son d’ambiance ou quelques effets sonores légers dans leurs clips.
Le pipeline d’image vers vidéo permet aussi aux créateurs de construire une identité visuelle reconnaissable : utilisez une image de personnage ou d’environnement cohérente comme source, et générez de nouveaux scénarios de mouvement pour chaque nouveau contenu.
La famille de modèles Kling sur PicassoIA
Kuaishou a bâti une famille de modèles complète, et PicassoIA propose la gamme entière. Savoir quelle version choisir vous fait gagner du temps de génération.
Quelle version pour quel usage
La règle pratique : utilisez Kling v3 Omni Video dès que la qualité finale est le critère principal. Utilisez Kling v2.6 ou des versions antérieures pour itérer rapidement sur des concepts avant de lancer une génération à qualité finale. Utilisez Kling v3 Motion Control lorsque vous avez besoin d’un mouvement de caméra précis et littéral au sein d’une séquence chorégraphiée.
Pour les contenus pilotés par un avatar, Kling Avatar v2 gère les vidéos centrées sur le visage avec un pipeline dédié qui maintient l’identité faciale sur toute la durée du clip.
Stratégie de prompt pour de meilleurs résultats
Une structure qui fonctionne à coup sûr
La structure de prompt en quatre parties de Kling v3 Omni, celle qui donne les résultats les plus fiables :
[Sujet + état initial] + [séquence de mouvement dans le temps] + [comportement de la caméra] + [atmosphère et éclairage]
Exemple appliqué :
- Sujet + état initial : « Un chef en tenue blanche se tient devant un plan de travail en inox, les mains le long du corps, posture détendue »
- Séquence de mouvement : « il tend la main pour saisir une poêle en cuivre brillant, se tourne vers la caméra avec une assurance tranquille, de la vapeur s’élevant de la surface de la poêle au premier plan »
- Comportement de la caméra : « la caméra reste fixe pendant deux secondes, puis effectue un lent rapprochement jusqu’à un plan poitrine sur son visage »
- Atmosphère : « cuisine professionnelle, éclairage tungstène chaud au-dessus, début de service matinal, légère brume de vapeur au second plan »
Ce prompt complet produit des sorties au comportement du sujet assuré, à l’expression lisible et à la texture cinématographique que les prompts courts n’atteignent jamais de façon fiable.
Les erreurs courantes qui nuisent à la qualité
Décrire l’état final au lieu du mouvement. « Une danseuse sur scène » donne au modèle un point de départ sans vecteur de mouvement. « Une danseuse immobile, les bras le long du corps, les lève lentement au-dessus de la tête en pivotant d’un demi-cercle, le projecteur de scène suivant son mouvement » lui fournit une séquence comportementale complète.
Surcharger la scène d’éléments. Trois à quatre éléments forts et précis donnent systématiquement de meilleurs résultats que dix éléments vagues. Des prompts diffus produisent des sorties diffuses.
Omettre le comportement de la caméra. « Travelling avant lent » ou « caméra fixe » ou « légère dérive à la main » produisent des textures émotionnelles très différentes. Préciser le comportement de la caméra vous donne un contrôle direct sur le résultat final.
Employer uniquement des descripteurs esthétiques génériques. « Cinématographique » et « photoréaliste » constituent le socle de base. Ajoutez des paramètres photographiques précis : « pellicule Kodak 5219 poussée en tungstène, 28 mm, f/2.0 » donne au modèle un comportement de lentille et de pellicule réel à exploiter, et non une simple cible stylistique floue.
💡 Ajouter une focale précise à votre prompt (24 mm, 50 mm, 85 mm, 200 mm) change fondamentalement la manière dont le modèle rend la compression de perspective, la profondeur de champ et la relation entre le sujet et l’arrière-plan. C’est l’élément de prompt le plus sous-utilisé de la génération de vidéos par IA.
Des verbes de mouvement vagues. « Bouger lentement » est moins utile que « dérive à une allure de demi-marche ». « Tourner » est moins utile que « pivoter de 90 degrés pour faire face à la caméra en trois secondes ». Plus votre langage de mouvement est littéral, plus la sortie l’est aussi.
Commencez à créer avec Kling v3 Omni
Tout ce qui est couvert dans cet article est disponible sur PicassoIA dès maintenant. Pas de liste d’attente, pas d’installation locale, pas de configuration d’API. Kling v3 Omni Video fonctionne dans le navigateur, aux côtés de la famille complète de modèles Kling et de dizaines d’autres générateurs vidéo haut de gamme, dans une seule interface.
Si vous abordez la vidéo par IA pour la première fois, commencez par une simple génération d’image vers vidéo. Prenez une image avec un sujet et une composition clairs, rédigez un prompt de mouvement décrivant un seul mouvement précis, et générez sur 5 secondes. La première sortie vous montrera immédiatement ce que la technologie sait faire et jusqu’où vous voudrez la pousser.
Pour les créateurs qui travaillent déjà régulièrement avec la vidéo par IA, la différence de qualité est visible dès le premier clip. La simulation physique, la conservation du sujet, la cohérence du mouvement et l’audio natif produisent ensemble un niveau de qualité qu’aucune version précédente de Kling n’avait atteint.
Le catalogue complet des modèles vidéo de PicassoIA, dont Ray 3.2, LTX 2.3 Pro, Wan 2.7 T2V et Pixverse v5, est disponible sur picassoia.com/en/all-models. Tous les modèles sur la même interface. Passer de l’un à l’autre pour comparer prend quelques secondes.
Le plafond de qualité de la vidéo par IA a bougé avec la sortie de Kling v3 Omni. Voici où il se situe aujourd’hui.


