2027 में सबसे अच्छा AI वीडियो जनरेटर कौन सा है, इस होड़ में अब दो गंभीर दावेदार बचे हैं: ByteDance का Seedance 2.0 और Google DeepMind का Veo 3.1। दोनों मॉडल कुछ ही महीनों के अंतर पर आए और उन क्षमताओं के साथ AI वीडियो की दुनिया में हलचल मचा दी, जिनकी इस कीमत पर किसी को उम्मीद नहीं थी। लेकिन सवाल यह है कि इनमें से कौन सा सच में आपके वर्कफ़्लो में स्थायी जगह बनाता है?
यह सिर्फ़ ऊपरी स्पेक्स की तुलना नहीं है। हम वीडियो क्वालिटी, नेटिव ऑडियो, जनरेशन की स्पीड, प्रॉम्प्ट की सटीकता और असल दुनिया में प्रदर्शन की गहराई से पड़ताल कर रहे हैं। चाहे आप अकेले कंटेंट क्रिएटर हों, स्टूडियो प्रोफ़ेशनल हों, या बस ऐसे कोई हों जो औसत नतीजों के लिए सब्सक्रिप्शन फ़ीस देना बंद करना चाहते हों, यह विश्लेषण आपको सही फ़ैसला लेने की जानकारी देगा।
ये मॉडल असल में क्या हैं
दोनों को एक-दूसरे के सामने रखने से पहले यह समझना ज़रूरी है कि हर मॉडल असल में किस काम के लिए बनाया गया था। ये एक ही प्रोडक्ट के दो वर्ज़न नहीं हैं। ये अलग-अलग संस्थाओं से आते हैं, जिनकी रिसर्च की प्राथमिकताएँ अलग हैं, और यह फ़र्क उनके आउटपुट में साफ़ दिखता है।
Seedance 2.0 एक नज़र में
Seedance 2.0 ByteDance का प्रमुख वीडियो जनरेशन मॉडल है, जो पहले से प्रभावशाली Seedance 1.5 Pro की नींव पर बना है। 2.0 वर्ज़न में एक बड़े स्तर पर अपग्रेड की गई आर्किटेक्चर है, जो टेक्स्ट-टू-वीडियो और इमेज-टू-वीडियो, दोनों इनपुट संभालती है। यह प्रति क्लिप 10 सेकंड तक 1080p रेज़ोल्यूशन सपोर्ट करता है, और नेटिव ऑडियो जनरेशन इसके मॉडल में ही बनी है, बाद में जोड़ी नहीं गई।
Seedance 2.0 को अलग बनाने वाली चीज़ है मानव गति की रियलिज़्म में ByteDance का गहरा निवेश। इस मॉडल को असली इंसानी हरकतों के एक विशाल डेटासेट पर प्रशिक्षित किया गया है, इसलिए यह चलते, बात करते, नाचते या शारीरिक क्रियाएँ करते लोगों वाले दृश्यों में खास तौर पर मज़बूत है। Seedance 2.0 Fast वेरिएंट कुछ विज़ुअल फ़िडेलिटी छोड़कर जनरेशन का समय काफ़ी घटा देता है, जिससे क्रिएटर्स को तेज़ी से इटरेट करने का विकल्प मिलता है और नतीजे फिर भी प्रकाशित करने लायक रहते हैं।
इंटीग्रेटेड ऑडियो पाइपलाइन वाकई नई है। बाद में अलग से परिवेशी ध्वनि या संगीत जोड़ने के बजाय, Seedance 2.0 एक ही जनरेशन चरण में वीडियो के साथ सिंक्रोनाइज़्ड ऑडियो तैयार करता है। सिर्फ़ यही बात कंटेंट क्रिएटर्स के प्रोडक्शन वर्कफ़्लो के सोचने का तरीका बदल देती है।
Veo 3.1 एक नज़र में
Veo 3.1 Google DeepMind का अब तक का सबसे परिष्कृत टेक्स्ट-टू-वीडियो मॉडल है। यह Veo 3 और Veo 2 का उत्तराधिकारी है, जिसमें सिनेमैटिक फ़्रेमिंग, प्राकृतिक भाषा के निर्देशों का पालन और लंबी क्लिप्स में दृश्य की स्थिरता में काफ़ी सुधार हुआ है। Google के पास मौजूद विशाल कंप्यूट इंफ़्रास्ट्रक्चर और उसकी मालिकाना ट्रेनिंग डेटा पाइपलाइन Veo 3.1 को फ़ोटोरियलिज़्म और सुसंगत सीन स्टोरीटेलिंग में एक अलग बढ़त देती हैं।
Veo 3.1 Fast वेरिएंट भी उन इस्तेमालों के लिए मौजूद है जहाँ स्पीड सबसे ज़रूरी है, लेकिन गंभीर आमने-सामने की तुलनाओं में पूरा मॉडल ही दिखाई देता है। Veo 3.1 कुछ कॉन्फ़िगरेशन में 4K आउटपुट तक सपोर्ट करता है। हालाँकि यह Seedance 2.0 जितनी गहराई से नेटिव ऑडियो जनरेट नहीं करता, फिर भी 2027 में इसकी विज़ुअल क्वालिटी की सीमा किसी भी सार्वजनिक रूप से उपलब्ध वीडियो मॉडल से शायद सबसे ऊँची है।
स्पेक्स आमने-सामने
| फ़ीचर | Seedance 2.0 | Veo 3.1 |
|---|
| डेवलपर | ByteDance | Google DeepMind |
| अधिकतम रेज़ोल्यूशन | 1080p | 4K तक |
| अधिकतम क्लिप अवधि | 10 सेकंड | 8 सेकंड |
| नेटिव ऑडियो | हाँ, इंटीग्रेटेड | सीमित |
| इनपुट मोड | टेक्स्ट, इमेज | टेक्स्ट, इमेज |
| मानव गति की क्वालिटी | असाधारण | बहुत उच्च |
| सीन की जटिलता | अच्छी | उत्कृष्ट |
| सिनेमैटिक फ़्रेमिंग | अच्छी | उत्कृष्ट |
| वीडियो में टेक्स्ट की पठनीयता | मध्यम | मज़बूत |
| प्रॉम्प्ट का पालन | उच्च | बहुत उच्च |
| फ़ास्ट वेरिएंट उपलब्ध | हाँ | हाँ |
| प्रति सेकंड लागत | कम | अधिक |
नोट: दोनों मॉडल बार-बार अपडेट होते हैं। हर रिलीज़ के साथ बेंचमार्क बदलते हैं, इसलिए केवल स्थिर स्पेक्स पर भरोसा करने के बजाय हमेशा अपने खास इस्तेमाल के मामले के साथ परखें।
ऐसी वीडियो क्वालिटी जो स्क्रॉल रोक दे
यहीं ज़्यादातर लोग अपना फ़ैसला करते हैं। दोनों मॉडल ऐसा आउटपुट देते हैं जो दो साल पहले असंभव लगता, लेकिन वे अलग-अलग दिशाओं में उत्कृष्ट हैं और अलग-अलग क्रिएटिव तरीकों को इनाम देते हैं।
मोशन रियलिज़्म और फ़िज़िक्स
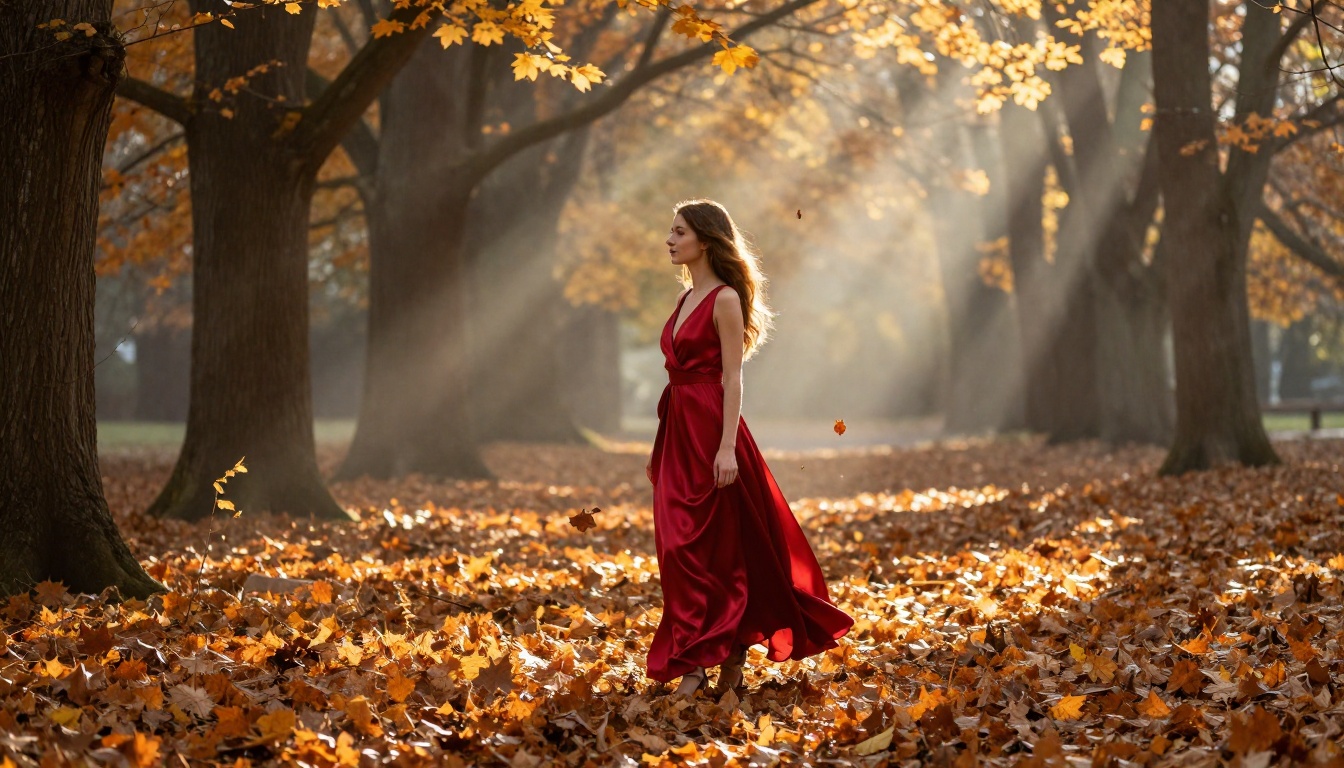
Seedance 2.0 इस समय मानव गति की रियलिज़्म के लिए सबसे मज़बूत सार्वजनिक रूप से उपलब्ध मॉडल है। पात्र प्राकृतिक भार वितरण के साथ चलते हैं, कपड़े की फ़िज़िक्स हरकत पर विश्वसनीय ढंग से प्रतिक्रिया देती है, और बालों की गतिशीलता इतनी प्रामाणिकता से रेंडर होती है कि असली दर्शकों की पहली नज़र में लगातार पास हो जाती है। इसे बारिश से भीगी गली में दौड़ते इंसान या नियंत्रित क्रम में नाचती डांसर का वीडियो बनाने को कहें, तो आउटपुट में सच्ची बायोमैकेनिकल विश्वसनीयता होती है।
यह संयोग नहीं है। ByteDance ने मोशन-विशिष्ट ट्रेनिंग डेटा जुटाने और लेबल करने में भारी निवेश किया है, जो इस बात को पकड़ता है कि अलग-अलग भौतिक परिस्थितियों में इंसानी शरीर असल में कैसे चलता है। नतीजा एक ऐसा मॉडल है जो मानो असलियत पर प्रशिक्षित हुआ हो, सिर्फ़ विज़ुअल अनुमानों पर नहीं।
Veo 3.1 गति को अलग तरह से संभालता है। जहाँ Seedance 2.0 मानव सब्जेक्ट में बायोमैकेनिकल सटीकता को प्राथमिकता देता है, वहीं Veo 3.1 बड़े पैमाने की पर्यावरणीय गति में उत्कृष्ट है: टकराती लहरें, तेज़ हवा वाले लैंडस्केप, भीड़ के दृश्य और हवाई कैमरा मूवमेंट, जहाँ पूरा दृश्य लगातार बदलता रहता है। यह मॉडल साफ़ तौर पर सिनेमैटिक कहानी कहने को ध्यान में रखकर बनाया गया है, न कि करीबी इंसानी परफ़ॉर्मेंस कैप्चर के लिए।
सीन की जटिलता और गहराई
मल्टी-एलिमेंट सीन कंपोज़िशन में Veo 3.1 निर्णायक रूप से जीतता है। नावों, पानी, चलती भीड़ और दूर की इमारतों वाला व्यस्त बंदरगाह दृश्य एक ही सुसंगत फ़्रेम में बनाना, Veo 3.1 प्रभावशाली स्थिरता के साथ संभालता है। तत्व अपनी तय जगहों पर बने रहते हैं, रोशनी की दिशा लगातार एक जैसी रहती है, और क्लिप के दौरान अग्रभूमि और पृष्ठभूमि का रिश्ता बना रहता है।
जैसे-जैसे सीन की जटिलता बढ़ती है, Seedance 2.0 कभी-कभी संघर्ष करता है। अलग-अलग एलिमेंट बेहतरीन दिखते हैं, लेकिन कई वस्तुओं के बीच स्थानिक रिश्ते फ़्रेम-दर-फ़्रेम थोड़े बिगड़ सकते हैं, जिससे वे हल्के कृत्रिम लगते हैं। Seedance 2.0 इसकी भरपाई सब्जेक्ट कंसिस्टेंसी में करता है: किसी भी Seedance 2.0 क्लिप का मुख्य पात्र पहले फ़्रेम से आखिरी फ़्रेम तक अपनी विज़ुअल पहचान उल्लेखनीय सटीकता के साथ बनाए रखता है। ऐसी कहानी वाली सामग्री के लिए जिसमें कोई खास व्यक्ति पूरे समय पहचाना जाना चाहिए, यह कंसिस्टेंसी बैकग्राउंड की जटिलता से ज़्यादा मायने रखती है।
नेटिव ऑडियो: असली फ़र्क
ऑडियो वह जगह है जहाँ इन मॉडलों का अंतर रोज़ के वर्कफ़्लो के लिए व्यावहारिक रूप से मायने रखने लगता है।
Seedance 2.0 ऑडियो जनरेशन
Seedance 2.0 सिंक्रोनाइज़्ड परिवेशी ऑडियो नेटिव रूप से जनरेट करता है, यानी मॉडल वीडियो के साथ ही ध्वनि भी बनाता है, बाद में जोड़ी गई पोस्ट-प्रोसेस ध्वनि की तरह नहीं। जब आप समुद्र तट का दृश्य प्रॉम्प्ट करते हैं, तो आपको लहरें मिलती हैं। व्यस्त सड़क में ट्रैफ़िक का माहौल आता है। जंगल के रास्ते में पक्षियों की चहचहाहट और पत्तियों से गुज़रती हवा होती है। ऑडियो क्वालिटी ब्रॉडकास्ट-ग्रेड नहीं है, लेकिन वह संदर्भ के हिसाब से सटीक है और समय के साथ इस तरह सिंक्रोनाइज़्ड है कि यह हर उस मॉडल से अलग दिखता है जिसे अलग ऑडियो पाइपलाइन चरण की ज़रूरत पड़ती है।
सोशल प्लेटफ़ॉर्म पर प्रकाशित करने वाले कंटेंट क्रिएटर्स के लिए यह वाकई वर्कफ़्लो का फ़ायदा है। दो या तीन चरणों की जगह एक ही जनरेशन चरण, और मैन्युअल सिंक के काम के बिना विज़ुअल से मेल खाता ऑडियो, हर प्रोजेक्ट से काफ़ी समय बचाता है। ज़्यादा वॉल्यूम में यह बचत तेज़ी से जुड़ती जाती है।
Veo 3.1 ऑडियो हैंडलिंग
Veo 3.1 ऑडियो के प्रति ज़्यादा सतर्क तरीका अपनाता है। Google ने अपने व्यापक वीडियो रिसर्च में ऑडियो क्षमताएँ दिखाई हैं, लेकिन मानक Veo 3.1 आउटपुट इंटीग्रेटेड ऑडियो जनरेशन से ज़्यादा विज़ुअल फ़िडेलिटी को प्राथमिकता देता है। Veo 3.1 के आउटपुट के लिए ध्वनि थर्ड-पार्टी ऑडियो टूल्स, टेक्स्ट-टू-स्पीच सिस्टम और म्यूज़िक जनरेटर संभालते हैं। इससे चरण बढ़ते हैं, लेकिन अनुभवी क्रिएटर्स को अंतिम ध्वनि परिणाम पर ज़्यादा सोच-समझकर नियंत्रण भी मिलता है।
उन प्रोफ़ेशनल प्रोडक्शन के लिए जहाँ ऑडियो को वैसे भी खास तकनीकी मानकों पर खरा उतरना होता है, यह ट्रेड-ऑफ़ अक्सर सही लगता है। ब्रांड कैंपेन फ़िल्म में आप वैसे भी ऑटो-जनरेटेड परिवेशी ऑडियो इस्तेमाल नहीं करेंगे, इसलिए Veo 3.1 की विज़ुअल क्वालिटी की बढ़त उसकी ऑडियो सीमाओं से ज़्यादा मायने रखती है।
स्पीड, कीमत और एक्सेस
हर एक कितनी तेज़ चलता है
कच्चा जनरेशन समय आउटपुट रेज़ोल्यूशन, क्लिप की अवधि और उस समय के सर्वर लोड पर निर्भर करता है। फिर भी दोनों मॉडल फ़ास्ट वेरिएंट देते हैं, जो कुछ क्वालिटी की कीमत पर इंतज़ार का समय काफ़ी घटा देते हैं।
Seedance 2.0 Fast आम तौर पर 5 सेकंड की 720p क्लिप 90 सेकंड से कम में बना देता है, जो इस क्वालिटी स्तर के लिए प्रतिस्पर्धी है। मानक Seedance 2.0 को 1080p क्लिप के लिए 3 से 5 मिनट लगते हैं, जो अंतिम आउटपुट के लिए ठीक है, लेकिन प्रोजेक्ट के डेवलपमेंट चरण में तेज़ प्रॉम्प्ट इटरेशन के लिए बहुत धीमा है।
Veo 3.1 Fast फ़ास्ट वेरिएंट पर तुलनीय स्पीड देता है। अधिकतम रेज़ोल्यूशन पर पूरा Veo 3.1 एक जनरेशन में 5 मिनट से ज़्यादा ले सकता है, हालाँकि Google का इंफ़्रास्ट्रक्चर छोटे प्रदाताओं की तुलना में व्यस्त समय में भी कतार का समय अधिक स्थिर रखता है।
टिप: प्रॉम्प्ट टेस्टिंग और इटरेशन के लिए फ़ास्ट वेरिएंट इस्तेमाल करें, और अंतिम आउटपुट के लिए ही पूरी क्वालिटी वाले मॉडल पर जाएँ। इस तरीके से अंतिम नतीजे पर असर डाले बिना काफ़ी समय और क्रेडिट बचते हैं।
प्रति सेकंड कीमत
दोनों मॉडल वीडियो की अवधि और आउटपुट रेज़ोल्यूशन के आधार पर कीमत तय करते हैं। बराबर रेज़ोल्यूशन पर Seedance 2.0 आम तौर पर Veo 3.1 की तुलना में थोड़ी कम प्रति सेकंड लागत पर आता है, जिससे यह ज़्यादा वॉल्यूम वाले इस्तेमाल के लिए अधिक सुलभ हो जाता है। Veo 3.1 की ऊँची कीमत उसकी 4K आउटपुट सीमा और Google के इंफ़्रास्ट्रक्चर खर्च को दर्शाती है।
व्यक्तिगत क्रिएटर्स के लिए एक जनरेशन पर लागत का अंतर इतना छोटा है कि शायद ही कोई फ़ैसला बदलता है। यह अंतर सिर्फ़ प्रोडक्शन के स्तर पर मायने रखने लगता है, जहाँ महीने में सैकड़ों जनरेशन बजट के हिसाब को किसी एक दिशा में झुका देते हैं।
प्रॉम्प्ट कंट्रोल और सटीकता
वीडियो में टेक्स्ट
वीडियो फ़्रेम के भीतर पठनीय टेक्स्ट बनाना जेनरेटिव मॉडलों के लिए कुख्यात रूप से कठिन है। Seedance 2.0 और Veo 3.1, दोनों इसे अपने पिछले वर्ज़न से बेहतर संभालते हैं, लेकिन फ़्रेम-दर-फ़्रेम टेक्स्ट कोहेरेंस में Veo 3.1 की साफ़ बढ़त है। Veo 3.1 वीडियो में कोई साइन, दुकान का नाम या लेबल पूरी क्लिप में एक जैसी स्पेलिंग और साफ़ विज़ुअल पहचान बनाए रखता है। Seedance 2.0 स्थिर या लगभग स्थिर फ़्रेम में पढ़ने लायक टेक्स्ट देता है, लेकिन मोशन सीक्वेंस में टेक्स्ट की स्थिरता बनाए रखने में संघर्ष करता है, खासकर जब कैमरा एंगल बदलते हैं।
जटिल निर्देश
जब प्रॉम्प्ट में एक साथ कई शर्तें, खास कैमरा मूवमेंट, तय लाइटिंग परिदृश्य और विस्तृत सब्जेक्ट-विवरण हों, तो Veo 3.1 ब्रीफ़ का ज़्यादा सटीकता से पालन करता है। यह सिनेमैटिक निर्देशों को स्वाभाविक रूप से संभालता है। "जब विषय कैमरे की ओर मुड़े तब धीमे पुश-इन से क्लोज़-अप, नरम बैकलाइट, उथली डेप्थ ऑफ़ फ़ील्ड" जैसा प्रॉम्प्ट ऐसा आउटपुट देता है जो सचमुच इरादे को पकड़ता है।
Seedance 2.0 सब्जेक्ट-ड्रिवन प्रॉम्प्ट पर बेहतर प्रतिक्रिया देता है, जहाँ फ़ोकस किसी खास पात्र, क्रिया या वातावरण पर हो, न कि जटिल मल्टी-एक्सिस कैमरा कोरियोग्राफ़ी पर। Seedance 2.0 पर छोटे, साफ़ प्रॉम्प्ट जिनमें स्पष्ट सब्जेक्ट और तय सेटिंग हो, लगातार लंबे, बहु-उपवाक्य निर्देशों से बेहतर प्रदर्शन करते हैं। निष्कर्ष यह है कि Seedance 2.0 सादगी को इनाम देता है, जबकि Veo 3.1 विस्तार को।
PicassoIA पर Seedance 2.0 कैसे इस्तेमाल करें
Seedance 2.0 और Veo 3.1, दोनों सीधे PicassoIA पर बिना किसी API कॉन्फ़िगरेशन या डेवलपर सेटअप के उपलब्ध हैं। यहाँ बताया गया है कि अभी Seedance 2.0 से अच्छे नतीजे कैसे पाएँ।
चरण-दर-चरण ट्यूटोरियल
चरण 1: मॉडल पेज खोलें
PicassoIA पर Seedance 2.0 पर जाएँ और जनरेशन पैनल खोलें। ऊपर मुख्य प्रॉम्प्ट इनपुट दिखेगा, और उसके नीचे इमेज-टू-वीडियो मोड के लिए वैकल्पिक इमेज अपलोड फ़ील्ड होगा।
चरण 2: मज़बूत प्रॉम्प्ट लिखें
अपने दृश्य का वर्णन साफ़ और ठोस शब्दों में करें। सब्जेक्ट और उसकी क्रिया से शुरू करें, फिर वातावरण के विवरण, रोशनी की स्थिति और कैमरा की स्थिति जोड़ें। उदाहरण के लिए: "रात में बारिश वाली गली में चलती छोटे काले बालों वाली एक युवा महिला, फ़ुटपाथ की जाली से उठती भाप, गीले पत्थरों पर पड़ती दुकान की गर्म एम्बर खिड़की की रोशनी, कैमरा आँख के स्तर पर थोड़ा पीछे से उसका पीछा करता हुआ।"
चरण 3: शुरुआती इमेज अपलोड करें (वैकल्पिक)
इमेज-टू-वीडियो जनरेशन के लिए अपनी बेस रेफ़रेंस इमेज अपलोड करें। Seedance 2.0 उसी शुरुआती फ़्रेम से आगे एनिमेट करता है और स्रोत के साथ मज़बूत विज़ुअल कंसिस्टेंसी बनाए रखता है। यह प्रोडक्ट फ़ोटोग्राफ़ी, पोर्ट्रेट हेडशॉट और लैंडस्केप फ़ोटो के लिए खास तौर पर अच्छा काम करता है।
चरण 4: अवधि और रेज़ोल्यूशन चुनें
अपनी क्लिप की लंबाई (10 सेकंड तक) और रेज़ोल्यूशन लक्ष्य चुनें। सोशल प्लेटफ़ॉर्म के कंटेंट के लिए 5 सेकंड पर 720p अक्सर आउटपुट क्वालिटी और जनरेशन समय के बीच सबसे अच्छा संतुलन होता है। अंतिम डिलीवरेबल के लिए पूरी अवधि पर 1080p सबसे अच्छे नतीजे देता है।
चरण 5: जनरेट करें, परखें, सुधारें
पहली जनरेशन चलाएँ और देखें कि आपके इरादे के मुकाबले क्या बदला। प्रॉम्प्ट को उस आधार पर सुधारें जो आउटपुट ने असल में दिखाया, न कि जो आपने शुरू में कल्पना की थी। साफ़, ठोस शब्दों में छोटे बदलावों का असर अक्सर पूरे प्रॉम्प्ट को नए सिरे से लिखने से ज़्यादा होता है।
बेहतर आउटपुट के लिए टिप्स
- कैमरा की दूरी साफ़ बताएँ: "चेहरे पर क्लोज़-अप" या "पूरी गली दिखाता वाइड एस्टैब्लिशिंग शॉट" सिर्फ़ सब्जेक्ट का वर्णन करने से ज़्यादा काम करता है
- रोशनी का स्रोत और दिशा बताएँ: "कैमरे के दाईं ओर से देर दोपहर की धूप" धुंधले लाइट-वर्णन से ज़्यादा दिशात्मक और प्राकृतिक नतीजे देती है
- भावनात्मक अमूर्तता से बचें: Seedance 2.0 अकेले मूड वाले शब्दों की तुलना में भौतिक, देखे जा सकने वाले वर्णनों पर बेहतर प्रतिक्रिया देता है
- Seedance 2.0 Fast से इटरेट करें: फ़ास्ट वेरिएंट पर अपना सबसे अच्छा प्रॉम्प्ट खोजें, फिर डेवलपमेंट के दौरान क्रेडिट बचाने के लिए अंतिम साफ़ वर्ज़न पूरे मॉडल पर जनरेट करें
2027 के अन्य मज़बूत प्रतिस्पर्धी
Seedance 2.0 और Veo 3.1 इस श्रेणी का नेतृत्व करते हैं, लेकिन AI वीडियो की दुनिया में कुछ मज़बूत विकल्प भी हैं, जिन्हें खास इस्तेमाल के मामलों के लिए जानना उपयोगी है:
- Kling v3 Kwai की ओर से आता है और शानदार सिनेमैटिक मोशन देता है, साथ ही मज़बूत कैमरा कंट्रोल फ़ीचर भी, खासकर ट्रैकिंग शॉट्स और सब्जेक्ट के चारों ओर घूमने वाली गतियों के लिए
- Kling v3 Omni टेक्स्ट, इमेज और ऑडियो कंडीशनिंग को एक ही जनरेशन चरण में संभालने वाला मल्टी-मोडल इनपुट जोड़ता है
- Sora 2 Pro OpenAI से आता है और अभी उपलब्ध सबसे सुसंगत लंबे नैरेटिव वीडियो बनाता है, हालाँकि इसका जनरेशन समय अधिकांश प्रतिस्पर्धियों से ज़्यादा रहता है
- Hailuo 2.3 MiniMax से आता है और पोर्ट्रेट व क्लोज़-अप कैरेक्टर एनिमेशन के लिए अपनी कीमत से कहीं बेहतर प्रदर्शन करता है
- LTX-2.3 Pro Lightricks का है और बिना क्वालिटी को पूरी तरह छोड़े जनरेशन स्पीड को प्राथमिकता देता है, जिससे जब टर्नअराउंड समय विज़ुअल सीमा से ज़्यादा मायने रखे, तो यह सबसे अच्छा विकल्प बन जाता है
- Gen-4.5 Runway का है और उन क्रिएटर्स के लिए ठोस विकल्प बना हुआ है जो पहले से Runway इकोसिस्टम में हैं और अपने मौजूदा वीडियो एडिटिंग वर्कफ़्लो के साथ कसकर इंटीग्रेशन चाहते हैं
व्यावहारिक सच्चाई यह है कि कोई एक मॉडल हर श्रेणी में नहीं जीतता। गंभीर क्रिएटर्स कंटेंट के प्रकार के हिसाब से यह मानसिक सूची बनाकर रखते हैं कि कौन सा मॉडल कब उठाना है, न कि हर काम एक ही विकल्प पर दांव लगाते हैं।
असली फ़ैसला
कोई भी मॉडल बिना शर्त नहीं जीतता। दोनों अलग-अलग क्रिएटिव प्राथमिकताओं के लिए बने हैं, और सही विकल्प पूरी तरह इस पर निर्भर करता है कि आप असल में क्या बना रहे हैं।
Seedance 2.0 चुनें जब:
- कंटेंट के केंद्र में इंसानी विषय और यथार्थवादी शरीर की गति हो
- आप अलग जनरेशन या सिंक चरण के बिना नेटिव ऑडियो चाहते हैं
- आप 1080p को लक्ष्य बना रहे हैं और श्रेणी में सबसे अच्छा प्रति-सेकंड लागत अनुपात चाहते हैं
- आप बार-बार सोशल प्लेटफ़ॉर्म पर प्रकाशित करते हैं, जहाँ प्रोडक्शन की स्पीड और ऑडियो सिंक मायने रखते हैं
Veo 3.1 चुनें जब:
- 4K आउटपुट या सबसे ऊँची विज़ुअल क्वालिटी सीमा ही प्राथमिकता हो
- आपके दृश्यों में परतदार गहराई वाली जटिल मल्टी-एलिमेंट कंपोज़िशन हों
- वीडियो फ़्रेम के भीतर टेक्स्ट की पठनीयता कंटेंट की ज़रूरत हो
- आपको विस्तृत, बहु-उपवाक्य निर्देशों पर मज़बूत प्रॉम्प्ट पालन चाहिए
ज़्यादातर स्वतंत्र क्रिएटर्स के लिए Seedance 2.0 रोज़ का अधिक व्यावहारिक विकल्प है, क्योंकि इसमें नेटिव ऑडियो, कम लागत वाला कर्व और असाधारण मानव गति क्वालिटी है। Veo 3.1 तब चुनने वाला मॉडल है जब विज़ुअल सीमा सबसे बड़ी चिंता हो और उसे पाने के लिए आप हर जनरेशन पर ज़्यादा खर्च करने को तैयार हों।
दोनों मॉडल PicassoIA पर 87 से ज़्यादा अन्य टेक्स्ट-टू-वीडियो विकल्पों के साथ सीधे उपलब्ध हैं। अगर आपने दोनों मॉडलों पर एक ही प्रॉम्प्ट से अपना साइड-बाय-साइड टेस्ट नहीं किया है, तो इस लेख की कोई बात उसकी जगह नहीं ले सकती। किसी वास्तविक राय तक पहुँचने का सबसे तेज़ तरीका है कि आप अपने खास कंटेंट प्रकार को दोनों पर जनरेट करें और आउटपुट की सीधी तुलना करें।
Seedance 2.0 मॉडल पेज से शुरू करें या सीधे Veo 3.1 पर जाकर अपनी पहली जनरेशन चलाएँ। प्लेटफ़ॉर्म पर 87+ वीडियो मॉडल उपलब्ध हैं और शुरू करने के लिए किसी सब्सक्रिप्शन की ज़रूरत नहीं है, इसलिए प्रयोग करने में कुछ मिनटों के अलावा कोई लागत नहीं है। 2027 का सबसे अच्छा AI वीडियो जनरेटर वही है जो आपके असली वर्कफ़्लो में फ़िट बैठे, और आप तब तक नहीं जान पाएँगे कि वह कौन सा है, जब तक उसके साथ कुछ बनाकर न देखें।


