सालों तक AI इमेज जनरेटर में एक साफ़ कमज़ोरी थी, जिससे डिज़ाइनर, मार्केटर और कंटेंट क्रिएटर सीमाओं से जूझते हुए काम करना सीख गए थे: वे पढ़ने लायक टेक्स्ट नहीं बना सकते थे। हर लोगो अक्षरों के भंवर में बदल जाता था। जनरेट किए गए स्टोरफ़्रंट का हर साइनबोर्ड ऐसा लगता था जैसे किसी आधी-अधूरी याद वाले सपने से आया हो। बिलबोर्ड, पैकेजिंग, मेन्यू और सोशल मीडिया मॉकअप, सबका हाल एक जैसा था: जैसे ही सिंथेटिक इमेज के अंदर असली शब्दों की ज़रूरत पड़ती, नतीजा बिखर जाता था।
GPT Image 2.0, जो OpenAI के GPT-4o सुइट में बना है, इस समस्या तक एक अलग संरचनात्मक तरीके से पहुँचता है। नतीजे परफ़ेक्ट नहीं हैं, लेकिन डिफ़्यूज़न मॉडल के दौर में बनी किसी भी चीज़ से यह साफ़ तौर पर बेहतर है।
AI इमेज में टेक्स्ट हमेशा क्यों बिगड़ता था
इसकी जड़ आर्किटेक्चर में थी। Stable Diffusion, SDXL और शुरुआती Midjourney जैसे पारंपरिक डिफ़्यूज़न मॉडल इमेज-कैप्शन जोड़ियों पर प्रशिक्षित किए गए थे, जहाँ मॉडल ने विज़ुअल पैटर्न को सांख्यिकीय रूप से सीखा। मॉडल के नज़रिए से टेक्स्ट के अक्षर भी बस एक और विज़ुअल टेक्सचर थे, जो फ़र, छाल या कपड़े की बुनाई से अलग नहीं थे।
मॉडल को असल में कभी पता नहीं था कि "A" एक "A" है। उसे बस इतना पता था कि पिक्सल की एक खास त्रिकोणीय बनावट अक्सर उन पिक्सल के साथ दिखती है जो क्रॉसबार जैसे लगते हैं। यह सांख्यिकीय नकल सजावट के लिए काफ़ी ठीक थी, लेकिन जैसे ही पठनीयता की ज़रूरत पड़ी, यह ढह गई।
तीन विफलता के तरीके लगभग हर जनरेटर में एक जैसे थे:
- अक्षरों का बिगड़ना: अक्षर आपस में मिल जाते थे, टूट जाते थे, या ऐसे आकारों से बदल जाते थे जो दिखते तो सही थे, पर असली अक्षर नहीं थे।
- स्पेलिंग का बिगड़ना: भले ही अलग-अलग अक्षर सही दिखें, शब्द की लंबाई में गलतियाँ जमा होती जाती थीं। "COFFEE" "COFFE3" या "COFFFE" बन जाता था।
- असंगत बेसलाइन: अक्षर अलग-अलग ऊँचाई पर तैरते थे, जिससे टेक्स्ट सबसे बुरे तरीके से हाथ से लिखा हुआ लगता था।
💡 यह ट्रेनिंग डेटा की समस्या नहीं थी। यह प्रतिनिधित्व की समस्या थी। मॉडल के भीतर "एक शब्द" की कोई अवधारणा नहीं थी, जो उसे एक अलग इकाई के रूप में पहचान सके।
GPT Image 2.0 ने क्या बदला
GPT Image 2.0 सिर्फ़ डिफ़्यूज़न मॉडल की तरह काम नहीं करता। यह GPT-4o की भाषा समझने की क्षमताओं के साथ जुड़ा हुआ है, यानी इमेज बनाने वाले सिस्टम के पास उस टेक्स्ट की स्पष्ट, टोकन-स्तर की समझ होती है जिसे वह रेंडर करने जा रहा है।
जब आप इसे "a coffee shop sign that reads OPEN" जैसा प्रॉम्प्ट देते हैं, तो भाषा मॉडल वाला हिस्सा "OPEN" को चार खास अक्षरों के खास क्रम के रूप में पार्स करता है। फिर वह इमेज सिंथेसिस प्रक्रिया को उन्हीं अक्षरों को उसी क्रम में बनाने का निर्देश देता है। विज़ुअल जेनरेशन उस भाषाई विनिर्देश से बंधी होती है, जैसा पहले की पाइपलाइनों ने कभी नहीं किया था।
इसे कभी-कभी हाइब्रिड आर्किटेक्चर कहा जाता है: इसमें आधा भाषा मॉडल है और आधा इमेज सिंथेसाइज़र, और भाषा मॉडल सिर्फ़ प्रॉम्प्ट-एन्कोडिंग के चरण में इस्तेमाल होने के बजाय निर्देशक की भूमिका निभाता है।
इससे क्या संभव होता है:
| क्षमता | पिछले मॉडल | GPT Image 2.0 |
|---|
| एक-दो छोटे शब्द | कभी-कभी सफल | लगातार |
| कई शब्दों के वाक्यांश | दुर्लभ | भरोसेमंद |
| ब्रांड नाम और लोगो | लगभग कभी नहीं | अक्सर सटीक |
| लंबे वाक्य | विफल | आंशिक सफलता |
| संख्याएँ और प्रतीक | असंगत | ज़्यादातर सही |
| मिश्रित भाषाएँ | कमज़ोर | सुधर रहा है |
यह असल में अक्षर कैसे पढ़ता है
GPT Image 2.0 की टेक्स्ट रेंडरिंग के पीछे की प्रक्रिया में मॉडल टेक्स्ट को एक सिमेंटिक इरादे के रूप में लेता है, न कि विज़ुअल पैटर्न के रूप में। व्यवहार में इसका मतलब यह है:
जब सिस्टम दिखने वाले टेक्स्ट की माँग वाला प्रॉम्प्ट प्रोसेस करता है, तो वह:
- टेक्स्ट स्ट्रिंग की पहचान करता है, जो खास अक्षर-संरचना वाला एक अलग तत्व है।
- टाइपोग्राफ़िक लेआउट की योजना बनाता है, यानी फ़ॉन्ट वेट, इमेज के हिसाब से आकार, पोज़िशनिंग और बेसलाइन अलाइनमेंट, इन सबको एक स्थानिक विनिर्देश मानकर।
- इमेज सिंथेसिस को निर्देश देता है कि वह ऐसे पिक्सल बनाए जो दृश्य की सौंदर्य-शैली और अक्षरों की सटीकता, दोनों की ज़रूरतें पूरी करें।
- जेनरेशन के दौरान अंतर्निहित जाँच करता है, ताकि लंबे अनुक्रमों में अक्षरों का बिगड़ना कम हो।
यह उस तरीके से काफ़ी अलग है जहाँ डिफ़्यूज़न मॉडल से "अनुमान लगाने को कहा जाता है कि टेक्स्ट कैसा दिखता है" और उम्मीद की जाती है कि लाखों ट्रेनिंग इमेज का सांख्यिकीय औसत कुछ पठनीय बना देगा।
💡 इसे ऐसे समझें: पुराने मॉडल टेक्स्ट का सपना देखते थे। GPT Image 2.0 उसे लिखता है और फिर उसकी इमेज बनाता है।
मॉडल को अपनी निर्देश-पालन की क्षमता से भी फ़ायदा मिलता है। वह "bold sans-serif font इस्तेमाल करें" या "टेक्स्ट गहरे बैकग्राउंड पर सफ़ेद होना चाहिए" जैसे प्रॉम्प्ट का जवाब दे सकता है और उन स्टाइल निर्देशों का काफ़ी सटीकता से पालन करता है।
अक्षर-सीमा की समस्या
लंबाई बढ़ने के साथ सटीकता घटती है। GPT Image 2.0 की टेक्स्ट रेंडरिंग में यह सबसे साफ़ पैटर्न में से एक है।
छोटी स्ट्रिंग, यानी 1 से 6 अक्षर, ज़्यादातर मामलों में बहुत अच्छी सटीकता से रेंडर होती हैं। "NOVA" जैसा प्रोडक्ट नाम या "SALE" जैसा लेबल ज़्यादातर जनरेशन में सही दिखेगा।
मध्यम स्ट्रिंग, यानी 7 से 15 अक्षर, अक्सर सफल होती हैं, पर कभी-कभार अक्षर बदलते हैं या स्पेसिंग गड़बड़ाती है। "FRAGILE" और "HAND MADE" अच्छे से काम करते हैं। "SATISFACTION" में कभी-कभी एक अक्षर गायब हो जाता है।
लंबी स्ट्रिंग, यानी 20 से ज़्यादा अक्षर, वहाँ चीज़ें अनुमान से बाहर हो जाती हैं। इमेज में पूरे वाक्य जेनरेशन प्रक्रिया आगे बढ़ने के साथ गलतियाँ जमा करते जाते हैं। वाक्य की शुरुआत आमतौर पर सही होती है, पर अंत बिगड़ सकता है।
मॉडल के साथ काम करने के व्यावहारिक नियम:
- जब सटीकता मायने रखती हो, तो इमेज के अंदर का टेक्स्ट छोटे, असरदार शब्दों तक सीमित रखें।
- लंबे टेक्स्ट के लिए इमेज बिना टेक्स्ट के बनाएँ और डिज़ाइन टूल में पोस्ट-प्रोडक्शन में टेक्स्ट जोड़ने पर विचार करें।
- मध्यम लंबाई वाले टेक्स्ट के लिए मॉडल का उपयोग मॉकअप में करें, जहाँ पिक्सल-परफ़ेक्ट सटीकता अंतिम आउटपुट न हो।
जहाँ यह अब भी टूट जाता है
विफलता के मामलों को जानना उतना ही उपयोगी है जितना ताक़तों को जानना। GPT Image 2.0 की टेक्स्ट रेंडरिंग पहले की तुलना में प्रभावशाली है, लेकिन इसकी कुछ कमज़ोरियाँ लगातार बनी रहती हैं:
स्क्रिप्ट और हैंडराइटिंग फ़ॉन्ट: मॉडल कर्सिव और कैलिग्राफ़िक स्टाइल में संघर्ष करता है। आपस में जुड़े अक्षर-रूप यह अस्पष्ट कर देते हैं कि एक अक्षर कहाँ खत्म होता है और दूसरा कहाँ शुरू होता है, और मॉडल का अक्षर-दर-अक्षर तरीका लिगेचर को अच्छे से नहीं संभालता।
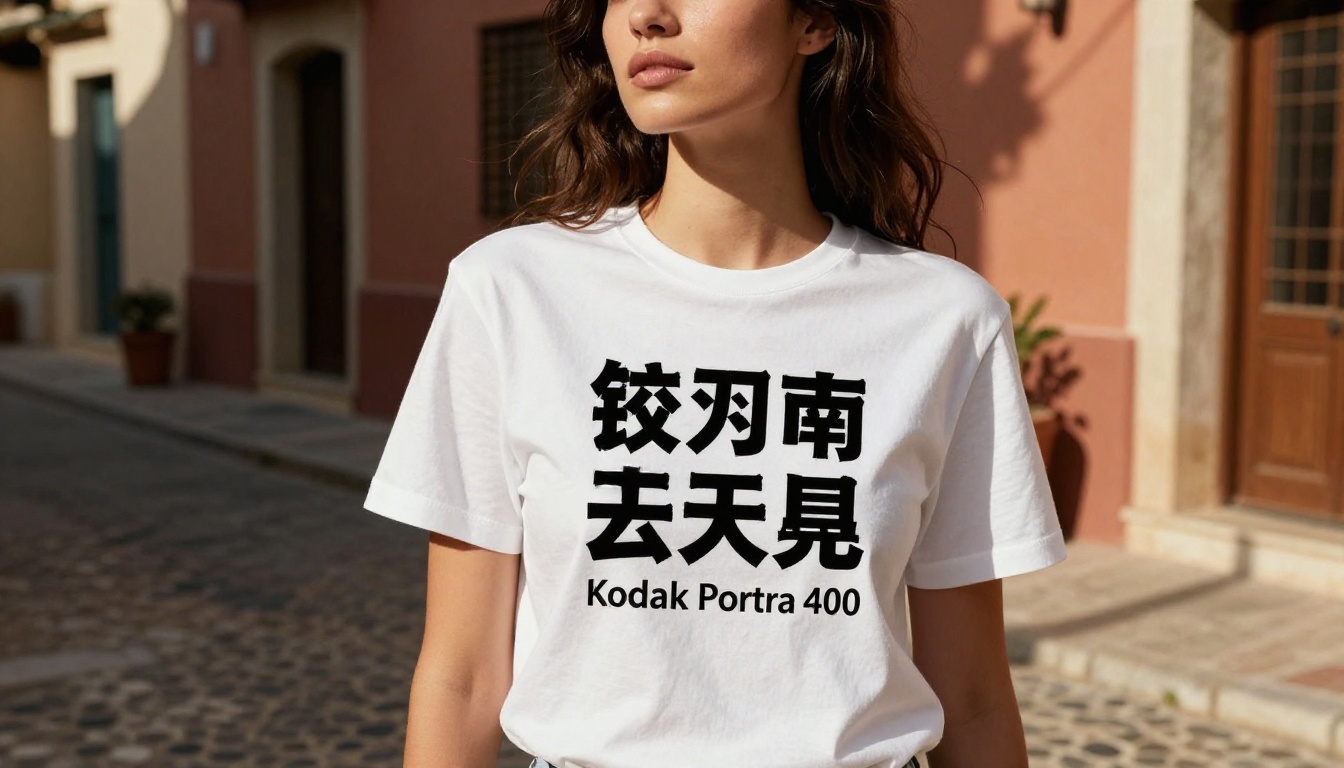
गैर-लैटिन लिपियाँ: अरबी, चीनी, जापानी, कोरियाई और अन्य जटिल लेखन प्रणालियाँ काफ़ी ज़्यादा मुश्किल हैं। मॉडल ऐसा टेक्स्ट बना सकता है जो दूर से सही लगे, लेकिन उसमें अक्षरों की गलतियाँ हों जो किसी मूल भाषी पाठक को तुरंत साफ़ दिख जाएँगी।
अत्यधिक स्टाइलाइज़ेशन: जो टेक्स्ट बहुत विकृत है, अजीब कोणों पर है, या जटिल पैटर्न में घुला हुआ है, उसे सटीक रूप से रेंडर करना मुश्किल होता है। जब आसपास की इमेज की विज़ुअल जटिलता ज़्यादा होती है, तो मॉडल का अक्षर-मार्गदर्शन कमज़ोर पड़ता दिखता है।
छोटा टेक्स्ट: जो टेक्स्ट इमेज के छोटे हिस्से में है, जैसे किसी लेबल पर बारीक प्रिंट, वह सामान्य रिज़ॉल्यूशन पर अक्सर शोर में बदल जाता है।
💡 प्रोफ़ेशनल काम के लिए GPT Image 2.0 को अपना पहला ड्राफ़्ट मानें, अंतिम आउटपुट नहीं। यह आपको किसी भी पिछले टूल से तेज़ी से लगभग 80% तक पहुँचा देता है।
अब काम करने वाले असली उपयोग
जो व्यावहारिक उपयोग अब भरोसेमंद हो गए हैं, उन्हें साफ़ नाम देना उपयोगी है, क्योंकि यहीं GPT Image 2.0 सचमुच वर्कफ़्लो बदलता है:
मार्केटिंग मॉकअप: क्लाइंट प्रेज़ेंटेशन के लिए पठनीय हेडलाइन टेक्स्ट वाली प्लेसहोल्डर विज्ञापन इमेज बनाना। पहले इसके लिए जनरेशन के बाद डिज़ाइनर को Photoshop में टेक्स्ट जोड़ना पड़ता था। अब पहला ड्राफ़्ट अक्सर प्रेज़ेंटेशन के लायक तैयार निकलता है।
प्रोडक्ट पैकेजिंग कॉन्सेप्ट: पैकेजिंग इमेज पर छोटे ब्रांड नाम और वज़न या आयतन के लेबल इतनी सटीकता से रेंडर होते हैं कि शुरुआती डिज़ाइन समीक्षा में कॉन्सेप्ट साफ़ तौर पर समझाया जा सके।
सोशल मीडिया कंटेंट: 3 से 5 शब्दों के टेक्स्ट ओवरले, हैशटैग या छोटे कैप्शन वाले पोस्ट मॉकअप बेहद भरोसेमंद हैं। कंटेंट टीमें जल्दी दर्जनों विज़ुअल वेरिएंट बना सकती हैं।
साइनेज और वेफ़ाइंडिंग: "EXIT," "RECEPTION," "LEVEL 2" जैसे लेबल वाले साइनेज के साथ यथार्थवादी इंटीरियर या एक्सटीरियर दृश्य बनाना आर्किटेक्चरल विज़ुअलाइज़ेशन और प्रेज़ेंटेशन के लिए लगातार काम करता है।
किताब और मैगज़ीन कवर: जनरेट की गई इमेज पर प्रमुखता से रखे गए 1 से 4 शब्दों के शीर्षक अब ज़्यादातर जनरेशन में सही आते हैं, जिससे कवर कॉन्सेप्ट बनाने वाले डिज़ाइनरों के लिए यह एक असली शॉर्टकट बन जाता है।
इवेंट मटीरियल: जब टेक्स्ट संक्षिप्त रखा जाए, तो इवेंट के नाम, तारीखों और स्थानों वाले फ़्लायर और पोस्टर शुरुआती बिंदु के रूप में व्यवहार्य बन गए हैं।
सटीक टेक्स्ट के लिए प्रॉम्प्ट कैसे लिखें
आप प्रॉम्प्ट कैसे लिखते हैं, इसका सीधा असर इस पर पड़ता है कि टेक्स्ट कितनी सटीकता से रेंडर होता है। ये रणनीतियाँ लगातार काम करती हैं:
अपने प्रॉम्प्ट में टेक्स्ट को कोट्स में रखें। इससे मॉडल को संकेत मिलता है कि अंदर की स्ट्रिंग शाब्दिक विज़ुअल टेक्स्ट के लिए है। "A storefront with a sign that reads "BARISTA"" "a storefront with a BARISTA sign" से बेहतर परिणाम देता है।
टाइपोग्राफ़िक संदर्भ बताएँ। फ़ॉन्ट वेट, रंग और प्लेसमेंट का वर्णन करें। "Bold uppercase white letters" मॉडल को ज़्यादा बाधाएँ देता है और आम तौर पर साफ़ आउटपुट बनाता है।
इमेज के विवरण को टेक्स्ट की सामग्री से अलग रखें। जो प्रॉम्प्ट साफ़ तौर पर "दृश्य कैसा दिखता है" और "दृश्य में कौन सा टेक्स्ट दिखता है" को अलग करते हैं, उनमें उन प्रॉम्प्ट की तुलना में कम गलतियाँ आती हैं जिनमें टेक्स्ट विज़ुअल वर्णन में मिला होता है।
हर टेक्स्ट तत्व के लिए कम शब्द माँगें। अगर आपको कई टेक्स्ट ब्लॉक वाला पोस्टर चाहिए, तो अक्सर बेहतर होता है कि अलग-अलग हिस्सों के लिए अलग इमेज बनाएँ और उन्हें जोड़ें, बजाय इसके कि एक ही जनरेशन में जटिल मल्टी-लाइन लेआउट माँगें।
सीड के साथ बार-बार सुधार करें। जब आपको ऐसा जनरेशन मिल जाए जिसमें टेक्स्ट ज़्यादातर सही हो, तो उसी सीड का इस्तेमाल करके ज़्यादा क्वालिटी पर या प्रॉम्प्ट में छोटे बदलावों के साथ दोबारा जनरेट करें। अगर रैंडम सीड को स्थिर रखा जाए, तो टेक्स्ट की सटीकता बनी रहने की संभावना ज़्यादा होती है।
💡 टेक्स्ट प्रॉम्प्टिंग को विज़ुअल वर्णन नहीं, बल्कि टाइपसेटिंग का निर्देश समझें। सटीकता विशिष्टता से आती है।
GPT Image 2.0 बनाम दूसरे टेक्स्ट-सक्षम जनरेटर
AI इमेज में टेक्स्ट रेंडरिंग का प्रतिस्पर्धी परिदृश्य तेज़ी से बदला है। यहाँ दिखाया गया है कि GPT Image 2.0 उन दूसरे टूल्स के मुकाबले कहाँ खड़ा है जिन्हें लोग आम तौर पर इस्तेमाल करते हैं:
| मॉडल | छोटा टेक्स्ट | लंबा टेक्स्ट | गैर-लैटिन | स्टाइल कंट्रोल |
|---|
| GPT Image 2.0 | उत्कृष्ट | मध्यम | आंशिक | अच्छा |
| Midjourney v6 | अच्छा | कमज़ोर | खराब | अच्छा |
| Adobe Firefly | अच्छा | मध्यम | सीमित | उत्कृष्ट |
| FLUX.1 Dev | मध्यम | कमज़ोर | खराब | अच्छा |
| Ideogram 2.0 | उत्कृष्ट | अच्छा | मध्यम | मध्यम |
Ideogram ने अपनी पहचान खास तौर पर टेक्स्ट की सटीकता पर बनाई है, और लगातार लंबे टेक्स्ट रेंडरिंग की ज़रूरत वाले उपयोगों के लिए यह अब भी एक मज़बूत विकल्प है। Adobe Firefly प्रोफ़ेशनल डिज़ाइन टूल्स के साथ सबसे भरोसेमंद इंटीग्रेशन देता है। GPT Image 2.0 की बढ़त जटिल, विस्तार से वर्णित दृश्यों के लिए टेक्स्ट की सटीकता और निर्देश-पालन का संयोजन है।
PicassoIA पर टेक्स्ट-भरी इमेज जनरेशन कैसे करें
PicassoIA आपको शक्तिशाली टेक्स्ट-टू-इमेज मॉडल तक पहुँच देता है, जिनसे आप अपने प्रोजेक्ट्स में टेक्स्ट रेंडरिंग के साथ अभी प्रयोग कर सकते हैं। PicassoIA Image जनरेटर ठीक इसी तरह के रचनात्मक काम के लिए बना है, और P Image Trainer बेस मॉडल के ऊपर कस्टम स्टाइल ट्रेन करके आपको और आगे जाने देता है।
Step 1: PicassoIA Image मॉडल खोलें और एक साफ़ सीन विवरण से शुरुआत करें।
Step 2: प्रॉम्प्ट के भीतर उद्धरण चिह्नों में अपनी टेक्स्ट विशिष्टता जोड़ें। उदाहरण के लिए: "A product label for a skincare brand that reads "LUMINA", minimalist white packaging, soft studio lighting, photorealistic."
Step 3: विज्ञापन मॉकअप के लिए आस्पेक्ट रेशियो 16:9 रखें, या सोशल मीडिया कंटेंट के लिए 1:1 रखें।
Step 4: 4 से 8 वेरिएशन जनरेट करें और सबसे सटीक टेक्स्ट रेंडरिंग वाला चुनें।
Step 5: अपने सबसे अच्छे नतीजे के स्टाइल-कंसिस्टेंट वेरिएशन के लिए PicassoIA पर Flux Redux Dev आज़माएँ। यह मौजूदा विज़ुअल रेफ़रेंस पर आधारित होता है और कम्पोज़िशनल कोहेरेंस बनाए रखता है, जो तब काम आता है जब आपको किसी स्थापित विज़ुअल पहचान से मेल खाते दृश्य में टेक्स्ट चाहिए।
डिज़ाइनरों और कंटेंट टीमों के लिए इसका मतलब
GPT Image 2.0 की टेक्स्ट क्षमताओं का व्यावहारिक मतलब यह नहीं है कि डिज़ाइनरों की ज़रूरत खत्म हो गई है। इसका मतलब यह है कि विज़ुअल कंटेंट बनाने के पहले-ड्राफ़्ट चरण में मूलभूत बदलाव आ गया है।
क्लाइंट प्रेज़ेंटेशन के लिए 20 मार्केटिंग मॉकअप वेरिएंट का सेट बनाने का मतलब पहले घंटों का काम होता था: दृश्य बनाना, स्टॉक इमेज ढूँढना, पोस्ट-प्रोडक्शन में टेक्स्ट जोड़ना। AI जनरेशन में भरोसेमंद टेक्स्ट रेंडरिंग के साथ वह पहला ड्राफ़्ट चरण बहुत छोटा हो जाता है।
नया वर्कफ़्लो ऐसा दिखता है:
- टेक्स्ट प्रॉम्प्ट के साथ AI इमेज जनरेशन का उपयोग करके एक घंटे से कम में 15 से 20 मोटे कॉन्सेप्ट वेरिएंट बनाएँ।
- कंपोज़िशन, टोन और टेक्स्ट की सटीकता के आधार पर सबसे मज़बूत 3 से 5 कॉन्सेप्ट चुनें।
- डिज़ाइन टूल में परिष्कृत करें: टेक्स्ट की गलतियाँ सुधारें, टाइपोग्राफ़ी समायोजित करें और ज़रूरत हो तो ब्रांड-विशिष्ट फ़ॉन्ट जोड़ें।
- पॉलिश्ड वर्ज़न प्रस्तुत करें, जो AI-जनरेटेड आधार पर बने थे।
यह डिज़ाइन चरण की जगह लेने के बारे में नहीं है। यह खोज के चरण को संक्षिप्त करने के बारे में है, ताकि क्रिएटिव टीमें शुरुआती वेरिएशन शून्य से बनाने के बजाय मज़बूत विचारों को निखारने में ज़्यादा समय लगाएँ।
GPT Image 2.0 में सटीकता के सुधार उस संक्षिप्त पहले चरण को सिर्फ़ विज़ुअली अनुमानित नहीं, बल्कि सचमुच उपयोगी बनाते हैं। जब आपके मॉकअप का टेक्स्ट सचमुच सही पढ़ा जाता है, तो आप उसे बिना किसी अगर-मगर के किसी स्टेकहोल्डर को दिखा सकते हैं।
PicassoIA पर खुद आज़माएँ
अगर आप इसे खुद अनुभव करना चाहते हैं, तो PicassoIA आपको उन टूल्स तक सीधी पहुँच देता है जो इसे संभव बनाते हैं। PicassoIA Image मॉडल से शुरुआत करें और ऐसा प्रॉम्प्ट लिखें जिसमें कोई खास शब्द या वाक्यांश हो जिसे आप इमेज में दिखाना चाहते हैं। ऊपर बताई गई कोट्स वाली तकनीक का इस्तेमाल करें। कुछ वेरिएशन जनरेट करें और देखें कि टेक्स्ट कैसा आता है।
अधिक प्रयोगात्मक या स्टाइलाइज़्ड आउटपुट के लिए, Flux Redux Dev मॉडल आपको मौजूदा विज़ुअल संदर्भों के आधार पर काम करने देता है और कंपोज़िशनल कोहेरेंस बनाए रखता है — तब उपयोगी है जब आपको किसी ऐसे सीन में टेक्स्ट चाहिए जो एक स्थापित विज़ुअल पहचान से मेल खाता हो।
यह तकनीक तेज़ी से आगे बढ़ रही है। जो काम दो साल पहले घंटों की पोस्ट-प्रोडक्शन माँगता था, वह अब एक प्रॉम्प्ट से सेकंडों में आ जाता है। PicassoIA पर आज उपलब्ध टूल्स आपको इस बदलाव की अग्रणी तकनीक तक पहुँच देते हैं, बिना API एक्सेस सेट किए, क्रेडिट मैनेज किए या कुछ भी लोकली इंस्टॉल किए।
ब्राउज़र खोलें, एक प्रॉम्प्ट लिखें और देखें कि क्या निकलता है। हो सकता है टेक्स्ट सचमुच पढ़ने लायक निकले।


