दो AI वीडियो मॉडल कई महीनों से क्रिएटिव कम्युनिटी में बहस छेड़े हुए हैं। Seedance 2.0, जिसे ByteDance ने रिलीज़ किया है, और WAN 2.7 (Alibaba की open-source टीम की WAN सीरीज़ का नवीनतम वर्ज़न) AI वीडियो जनरेशन की दो बिल्कुल अलग सोच को दर्शाते हैं। एक एक पॉलिश्ड, कमर्शियल रूप से समर्थित प्रोप्राइटरी मॉडल है जिसमें नेटिव ऑडियो सपोर्ट है। दूसरा एक ओपन-सोर्स पावरहाउस है जिसने दुनियाभर के स्वतंत्र डेवलपर्स का ध्यान खींचा है। लेकिन जब बात असली आउटपुट क्वालिटी की आती है, तो कौन सा जीतता है?
इस विश्लेषण में वह सब कुछ शामिल है जो मायने रखता है: टेम्पोरल कोहेरेंस, प्रॉम्प्ट फ़िडेलिटी, सिनेमैटिक रियलिज़्म, जनरेशन स्पीड और ऑडियो सपोर्ट। अंत तक आप ठीक-ठीक जान जाएँगे कि कौन सा मॉडल आपके क्रिएटिव वर्कफ़्लो में फिट बैठता है और कौन सी स्थितियों में किसे चुनना चाहिए।
ये दोनों मॉडल असल में क्या हैं
आउटपुट की तुलना से पहले हर मॉडल के आर्किटेक्चर और उसके पीछे की मंशा को समझना मददगार है। ये अलग तरीकों से बने हैं, अलग डेटा पर ट्रेन हुए हैं और अलग क्रिएटिव नतीजों के लिए ऑप्टिमाइज़ किए गए हैं।
एक नज़र में Seedance 2.0
Seedance 2.0 ByteDance का फ़्लैगशिप AI वीडियो जनरेटर है, जो अपने पिछले वर्ज़न से एक बड़ी छलांग है। यह टेक्स्ट-टू-वीडियो और इमेज-टू-वीडियो दोनों जनरेशन को सपोर्ट करता है, और इसकी सबसे खास विशेषता है नेटिव ऑडियो सिंथेसिस: यह सिर्फ़ विज़ुअल नहीं बनाता, बल्कि जनरेशन पाइपलाइन के भीतर ही सिंक्रोनाइज़्ड एम्बिएंट साउंड भी तैयार करता है। इससे यह मौजूदा वीडियो डिफ़्यूज़न मॉडल्स में दुर्लभ श्रेणी में आ जाता है।
स्पेक्स:
- रिज़ॉल्यूशन: 1080p तक
- अवधि: प्रति क्लिप 10 सेकंड तक
- ऑडियो: नेटिव एम्बिएंट और स्पीच ऑडियो जनरेशन
- इनपुट मोड: टेक्स्ट प्रॉम्प्ट, इमेज, या दोनों मिलाकर
- स्पीड: स्टैंडर्ड और फ़ास्ट दोनों वर्ज़न उपलब्ध हैं। बिना core क्वालिटी खोए तेज़ी से इटरेट करने के लिए Seedance 2.0 Fast आज़माएँ।
एक नज़र में WAN 2.7
Alibaba की open-source रिसर्च टीम की WAN सीरीज़ ओपन वीडियो सिंथेसिस में सबसे अहम विकासों में से एक रही है। WAN 2.6 अभी तक सार्वजनिक रूप से तैनात नवीनतम वर्ज़न है, और WAN 2.7 उसी वीडियो डिफ़्यूज़न आर्किटेक्चर पर आगे बढ़ता है। यह हाई मोशन क्वालिटी और सीन फ़िडेलिटी पर केंद्रित है, और जटिल प्रॉम्प्ट विवरणों पर इसका प्रदर्शन मज़बूत है।
स्पेक्स:
- रिज़ॉल्यूशन: 720p तक (टेक्स्ट-टू-वीडियो), 1080p तक (इमेज-टू-वीडियो)
- अवधि: स्टैंडर्ड में 5 सेकंड तक, एक्सटेंडेड कॉन्फ़िगरेशन में 10 सेकंड तक
- ऑडियो: नेटिव रूप से इंटीग्रेटेड नहीं, इसके लिए अलग ऑडियो पाइपलाइन चाहिए
- इनपुट मोड: टेक्स्ट प्रॉम्प्ट, इमेज रेफ़रेंस
- स्पीड: कई वर्ज़न उपलब्ध हैं, फ़ास्ट-इनफ़रेंस से लेकर हाई-क्वालिटी धीमी जनरेशन तक
वीडियो क्वालिटी: फ़्रेम दर फ़्रेम
कच्ची विज़ुअल क्वालिटी तय करती है कि AI से बना फ़ुटेज प्रोफ़ेशनली शूट किए गए मटीरियल की बराबरी कर पाएगा या नहीं। ज़्यादातर क्रिएटर अपना मूल्यांकन यहीं से शुरू करते हैं, और यह सही भी है।
रियलिज़्म और टेक्सचर
Seedance 2.0 मानव सब्जेक्ट्स पर असाधारण टेक्सचर फ़िडेलिटी देता है। त्वचा के रोम-छिद्र, कपड़े की बुनाई और बालों की अलग-अलग लटें बेहद वास्तविक दिखती हैं। क्लोज़-अप पोर्ट्रेट और डायनेमिक आउटडोर सीन वाले प्रॉम्प्ट्स के कंट्रोल्ड टेस्ट में Seedance 2.0 ने लगातार ऐसा फ़ुटेज दिया जिसमें क्लिप के हर फ़्रेम में टेक्सचर डिटेल साफ़ और कोहेरेंट थे।
WAN 2.7 यहाँ कमज़ोर नहीं है, लेकिन इसकी ताकत पर्यावरण और लैंडस्केप रेंडरिंग में है। जंगलों, शहरों के दृश्यों और प्राकृतिक माहौल के वाइड शॉट्स सच में सिनेमैटिक लगते हैं। WAN को कभी-कभी क्लोज़-अप मानव सब्जेक्ट्स में दिक्कत होती है, खासकर जब सब्जेक्ट सीन में चलते हैं तब त्वचा के टेक्सचर की स्थिरता बनाए रखने में।
💡 पोर्ट्रेट-भारी कंटेंट के लिए Seedance 2.0 को मापने योग्य बढ़त है। विस्तृत पर्यावरणीय शॉट्स के लिए WAN 2.7 अक्सर ज़्यादा गहराई और वायुमंडलीय डिटेल वाले नतीजे देता है।
कलर ग्रेडिंग और सिनेमैटिक फ़ील
दोनों मॉडल स्वाभाविक रूप से कलर-ग्रेडेड फ़ुटेज देते हैं, लेकिन उनकी सौंदर्य शैली में साफ़ अंतर है।
Seedance 2.0 गर्म, ज़्यादा कमर्शियल रूप से पॉलिश्ड टोन की ओर झुकता है, हल्के कॉन्ट्रास्ट बूस्ट के साथ, जिससे फ़ुटेज बिना पोस्ट-प्रोसेसिंग के सोशल मीडिया या मार्केटिंग के लिए तैयार लगता है।
WAN 2.7 ठंडा, ज़्यादा फ़िल्मी पैलेट देता है, मिडटोन में हल्के डीसैचुरेशन के साथ, जो आधुनिक सिनेमा की कलर साइंस की याद दिलाता है। शॉर्ट फ़िल्में या कलात्मक प्रोजेक्ट्स पर काम करने वाले क्रिएटर्स के लिए यह सौंदर्य बढ़त काफ़ी मायने रख सकती है।
मोशन कोहेरेंस और टेम्पोरल स्टेबिलिटी
AI वीडियो जनरेशन में मोशन क्वालिटी शायद सबसे अहम मेट्रिक है। पहला फ़्रेम कितना भी सुंदर हो, अगर क्लिप के बीच में सब्जेक्ट विकृत हों, झिलमिलाएँ या अपना स्ट्रक्चरल इंटीग्रिटी खो दें, तो उसका कोई मतलब नहीं। यहीं दोनों मॉडल अपने सबसे अहम अंतर दिखाते हैं।
सब्जेक्ट्स कैसे चलते हैं
Seedance 2.0 मानव मोशन के लिए इंडस्ट्री-अग्रणी टेम्पोरल कोहेरेंस दिखाता है। चलने के चक्र, हाथों के इशारे और चेहरे के भाव सभी फ़्रेम में अपनी स्ट्रक्चरल इंटीग्रिटी बनाए रखते हैं। इसका एक हिस्सा ByteDance के उस व्यापक ट्रेनिंग डेटा से आता है जो उसने अपने कंज़्यूमर वीडियो प्लेटफ़ॉर्म्स के असली मानव मूवमेंट पर आधारित किया है, जिससे मॉडल को बॉडी मैकेनिक्स की असामान्य रूप से मज़बूत नींव मिलती है।
WAN 2.7 फ़िज़िक्स-आधारित मोशन को बेहद अच्छी तरह संभालता है: बहता पानी, हवा में लहराता कपड़ा, धुआँ छँटना और गिरती वस्तुएँ, सब उल्लेखनीय रियलिज़्म के साथ व्यवहार करते हैं। हालाँकि, ओवरलैपिंग मूवमेंट वाले जटिल मल्टी-पर्सन सीन में कभी-कभी टेम्पोरल अस्थिरता दिख सकती है, खासकर तेज़ मोशन वाले हिस्सों में।
| मेट्रिक | Seedance 2.0 | WAN 2.7 |
|---|
| मानव मोशन कोहेरेंस | उत्कृष्ट | अच्छा |
| फ़िज़िक्स सिमुलेशन | अच्छा | उत्कृष्ट |
| कैमरा मूवमेंट की स्मूदनेस | उत्कृष्ट | बहुत अच्छा |
| तेज़ एक्शन की स्थिरता | बहुत अच्छा | अच्छा |
| चेहरे के भाव बरकरार रखने की क्षमता | उत्कृष्ट | मध्यम |
| पर्यावरणीय मोशन | बहुत अच्छा | उत्कृष्ट |
सीन ट्रांज़िशन और कैमरा मूवमेंट
दोनों में से कोई भी मॉडल एक ही जनरेशन में मल्टी-सीन वीडियो के लिए डिज़ाइन नहीं किया गया था, लेकिन दोनों कैमरा मूवमेंट को प्रॉम्प्ट दिशा के ज़रिए अलग तरीके से संभालते हैं।
Seedance 2.0 प्रॉम्प्ट में साफ़ कैमरा निर्देशों पर भरोसेमंद तरीके से प्रतिक्रिया देता है: slow pan, dolly-in, orbital shot और static, ये सब लगातार, पूर्वानुमेय नतीजे देते हैं। WAN 2.7 भी कैमरा निर्देशों पर अच्छी प्रतिक्रिया देता है, लेकिन लंबी क्लिप्स में तेज़ दिशा-परिवर्तन के दौरान हल्का जर्क दिखा सकता है।
प्रॉम्प्ट एडहेरेंस: क्या यह वही करता है जो आप माँगते हैं?
प्रॉम्प्ट एडहेरेंस मापता है कि कोई मॉडल लिखे गए विवरणों को वीडियो में कितनी वफ़ादारी से बदलता है। प्रोफ़ेशनल वर्कफ़्लो के लिए यह खासतौर पर अहम है, जहाँ कई दौर के इटरेशन के बिना खास सीन को क्रिएटिव ब्रीफ़ से मेल खाना होता है।
जटिल सीन विवरण
Seedance 2.0 विस्तृत प्रॉम्प्ट्स के लिए मज़बूत शाब्दिक एडहेरेंस दिखाता है। किसी खास पोशाक का रंग, दिन का तय समय और विशिष्ट तत्वों वाला बैकग्राउंड बताएँ, तो मॉडल उसे बहुत सटीकता से पूरा करता है। बड़े कमर्शियल डेटासेट पर इसकी ट्रेनिंग का मतलब है कि इसे रोज़मर्रा की वस्तुओं, सेटिंग्स और मानवीय स्थितियों की विस्तृत समझ है।
WAN 2.7 अमूर्त और वायुमंडलीय प्रॉम्प्ट्स को ज़्यादा प्रभावी ढंग से संभालता है। कोई मूड, भावना या इम्प्रेशनिस्टिक सीन बताएँ, तो WAN अक्सर ऐसी व्याख्याओं से चौंकाता है जो सिनेमैटिक रूप से जानबूझकर लगती हैं। कॉन्सेप्चुअल या कलात्मक क्रिएटिव प्रोजेक्ट्स के लिए यह व्याख्यात्मक गुण एक असली ताकत हो सकता है, कोई सीमा नहीं।
💡 Seedance 2.0 को एक सटीक executor और WAN 2.7 को एक व्याख्यात्मक सहयोगी समझें। सही चुनाव इस पर पूरी तरह निर्भर करता है कि आपको शाब्दिक सटीकता चाहिए या क्रिएटिव व्याख्या।
कैरेक्टर और ऑब्जेक्ट कंसिस्टेंसी
दोनों मॉडल मल्टी-टर्न सब्जेक्ट कंसिस्टेंसी के साथ संघर्ष कर सकते हैं, यानी एक लंबे जनरेटेड सीक्वेंस में एक ही कैरेक्टर को लगातार एक जैसा दिखाना। यह मौजूदा सभी वीडियो डिफ़्यूज़न मॉडल्स की ज्ञात सीमा है, किसी एक की खास कमज़ोरी नहीं।
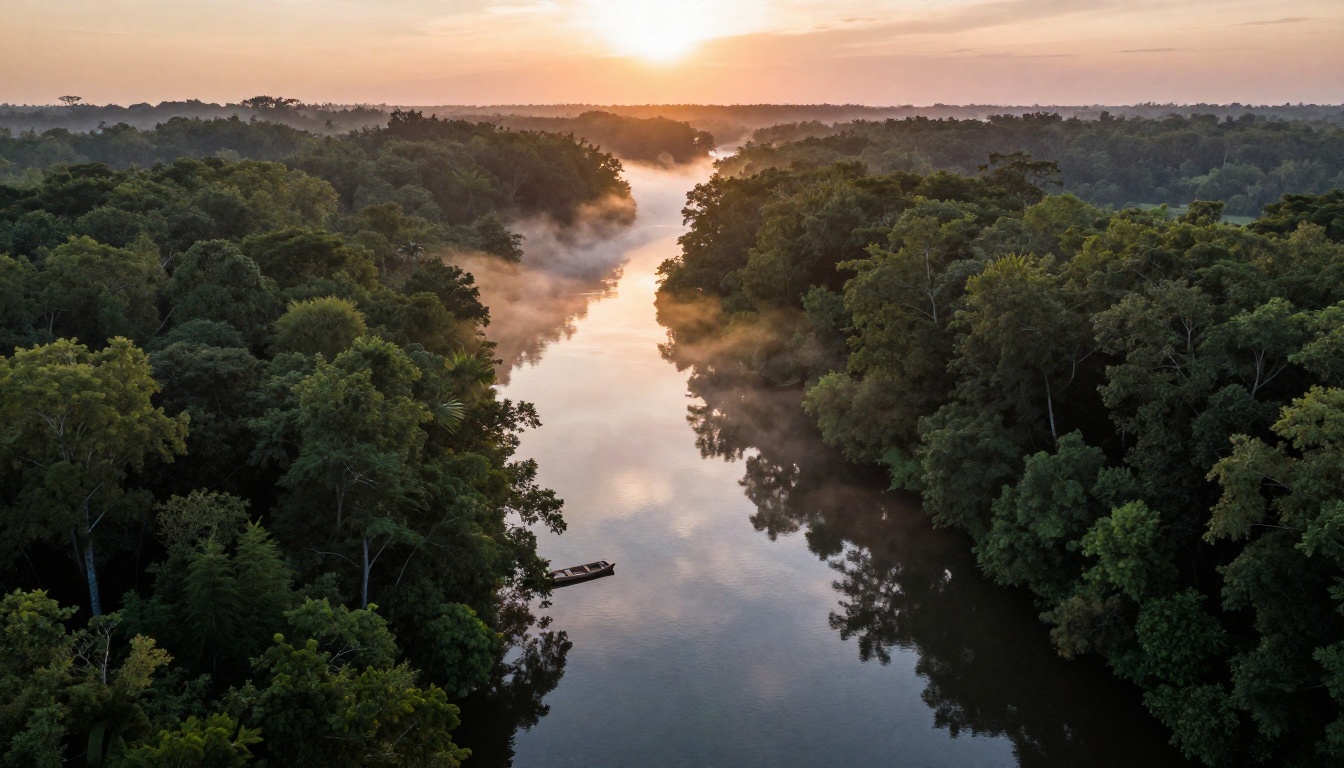
हालाँकि, एक ही क्लिप के भीतर Seedance 2.0 कैरेक्टर की उपस्थिति को ज़्यादा स्थिरता के साथ बनाए रखता है। WAN 2.7 लंबी क्लिप्स में, खासकर 5 सेकंड के निशान के बाद, कपड़ों के रंग और चेहरे की विशेषताओं की स्थिति में कभी-कभार बदलाव दिखाता है।
स्पीड और रिज़ॉल्यूशन आउटपुट
काम करने वाले क्रिएटर्स के लिए जनरेशन स्पीड सीधे तय करती है कि एक सेशन में कितने इटरेशन व्यावहारिक हैं। स्पीड-से-क्वालिटी अनुपात उतना ही मायने रखता है जितनी पीक क्वालिटी।
जनरेशन टाइम की तुलना
तेज़ प्रोटोटाइपिंग के लिए Seedance 2.0 Fast टेक्स्ट से वीडियो तक का सबसे तेज़ रास्ता देता है, बहुत ज़्यादा क्वालिटी खोए बिना। एक ही वर्क सेशन में कई प्रॉम्प्ट वैरिएशन टेस्ट करते समय यही मॉडल चुनें।
अधिकतम रिज़ॉल्यूशन और अवधि
रिज़ॉल्यूशन की सीमा में Seedance 2.0 की साफ़ बढ़त है, यह टेक्स्ट प्रॉम्प्ट से पूरे 1080p आउटपुट तक पहुँचता है। WAN 2.7 के टेक्स्ट-टू-वीडियो आउटपुट स्टैंडर्ड कॉन्फ़िगरेशन में आम तौर पर 720p पर सीमित रहते हैं, हालाँकि WAN 2.6 I2V के ज़रिए इमेज-टू-वीडियो वेरिएंट इससे ऊपर जा सकते हैं।
क्लिप की अवधि के लिए, दोनों मॉडल प्रति जनरेशन 10 सेकंड तक सपोर्ट करते हैं। Seedance 2.0 पूरी 10-सेकंड अवधि में ज़्यादा स्थिर आउटपुट क्वालिटी बनाए रखता है। WAN के आउटपुट में लंबी क्लिप्स के अंत के पास हल्का क्वालिटी गिरावट दिख सकती है, खासकर मोशन कोहेरेंस में।
ऑडियो: एक असली अंतर
यहीं Seedance 2.0 उस श्रेणी में आगे निकल जाता है जिसमें WAN 2.7 अभी प्रतिस्पर्धा ही नहीं करता। कई क्रिएटर्स के लिए यही एक अंतर फ़ैसला करने के लिए काफ़ी है।
Seedance 2.0 में नेटिव ऑडियो
Seedance 2.0 सिंक्रोनाइज़्ड एम्बिएंट ऑडियो बनाता है और, कुछ कॉन्फ़िगरेशन में, वॉइस भी उसी पाइपलाइन के हिस्से के रूप में। शहर की सड़क पर बारिश का प्रॉम्प्ट एक ही जनरेशन पास में बारिश का दृश्य और आवाज़ दोनों देता है। भीड़भाड़ वाले आउटडोर बाज़ार के सीन में अपने आप भीड़ का शोर, आसपास की बातचीत और माहौल की बनावट आ जाती है।
ऑडियो क्वालिटी स्टूडियो-ग्रेड नहीं है, लेकिन सोशल कंटेंट, शॉर्ट-फ़ॉर्म वीडियो और प्रोटोटाइप प्रेज़ेंटेशन के लिए काफ़ी भरोसेमंद है। जिन क्रिएटर्स को अतिरिक्त ऑडियो प्रोडक्शन स्टेप्स के बिना पब्लिश-रेडी क्लिप्स चाहिए, उनके लिए यही एक फ़ीचर Seedance 2.0 चुनने को सही ठहराने के लिए काफ़ी है।
WAN 2.7 का साउंड के प्रति दृष्टिकोण
WAN 2.7 में नेटिव ऑडियो जनरेशन शामिल नहीं है। WAN से बने फ़ुटेज में आवाज़ जोड़ने के लिए एक अलग ऑडियो पाइपलाइन चाहिए, चाहे वह समर्पित टेक्स्ट-टू-स्पीच टूल हो, म्यूज़िक जनरेशन मॉडल हो, या पारंपरिक ऑडियो प्रोडक्शन सॉफ़्टवेयर।
यह ज़रूरी नहीं कि यह कोई बड़ी रुकावट हो। कई वीडियो क्रिएटर्स अपने ऑडियो पोस्ट-प्रोडक्शन पर पूरा नियंत्रण पसंद करते हैं और मॉडल को ऑडियो के फ़ैसले अपने आप लेने देना नहीं चाहते। लेकिन इसका मतलब वर्कफ़्लो में एक अतिरिक्त स्टेप है, और समय के दबाव में काम करने वाले क्रिएटर्स के लिए यह स्टेप दर्जनों क्लिप्स में जुड़कर भारी पड़ता है।
PicassoIA पर Seedance 2.0 कैसे इस्तेमाल करें
चूँकि Seedance 2.0 सीधे PicassoIA पर उपलब्ध है, यहाँ बताया गया है कि बिना किसी तकनीकी सेटअप या लोकल हार्डवेयर के इससे अच्छे नतीजे कैसे पाएँ।
अपनी पहली जनरेशन सेट करना
स्टेप 1: मॉडल तक पहुँचें
PicassoIA पर Seedance 2.0 पेज पर जाएँ। किसी डेवलपर एनवायरनमेंट या GPU की ज़रूरत नहीं है।
स्टेप 2: अपना इनपुट मोड चुनें
आप सिर्फ़ टेक्स्ट प्रॉम्प्ट दे सकते हैं या इमेज-टू-वीडियो जनरेशन के लिए रेफ़रेंस इमेज अपलोड कर सकते हैं। टेक्स्ट-टू-वीडियो के लिए एक साफ़ और वर्णनात्मक प्रॉम्प्ट लिखें, जिसमें सब्जेक्ट, एक्शन, एनवायरनमेंट, लाइटिंग और कैमरा मूवमेंट बताएँ। जितनी ज़्यादा स्पेसिफ़िसिटी, उतने बेहतर नतीजे।
स्टेप 3: असरदार प्रॉम्प्ट लिखें
अपने प्रॉम्प्ट को इस फ़ॉर्मेट में बनाएँ: सब्जेक्ट + एक्शन + एनवायरनमेंट + लाइटिंग + कैमरा मूवमेंट। उदाहरण के लिए: "पीले समर ड्रेस में एक युवा महिला धूप से भरे लैवेंडर खेत में धीरे-धीरे चलती हुई, कैमरा पीछे से धीरे-धीरे dolly-in करता हुआ, पश्चिम से आती गर्म गोल्डन आवर रोशनी।"
स्टेप 4: अवधि और क्वालिटी सेट करें
अपनी क्लिप की लंबाई (10 सेकंड तक) और आउटपुट रिज़ॉल्यूशन चुनें। तेज़ ड्राफ़्ट के लिए Seedance 2.0 Fast इस्तेमाल करें। फ़ाइनल-क्वालिटी आउटपुट के लिए स्टैंडर्ड मॉडल चुनें।
स्टेप 5: जनरेट करें और रिफ़ाइन करें
जनरेट पर क्लिक करें और अपनी क्लिप का इंतज़ार करें। अगर नतीजा उम्मीद के मुताबिक न हो, तो प्रॉम्प्ट में बदलाव करें। कैमरा दिशा या लाइटिंग के विवरण में छोटे बदलाव भी आउटपुट के चरित्र को काफ़ी बदल सकते हैं।
बेहतर नतीजों के लिए टिप्स
- कैमरा मूवमेंट के बारे में साफ़-साफ़ बताएँ: "slow pan left," "static wide shot," "aerial dolly-out" सब भरोसेमंद रूप से अलग-अलग नतीजे देते हैं
- लाइट की दिशा बताएँ: "बाईं ओर से सुबह की रोशनी" बनाम "ऊपर से दोपहर का सूरज" सीन के पूरे मूड और परछाई के चरित्र को बदल देता है
- अकेले भावनात्मक भाषा से बचें: "एक उदास दृश्य" की तुलना में "बारिश से ढकी खिड़की के पास अकेली बैठी एक महिला, अपने हाथों को देखती हुई" कहीं ज़्यादा असरदार है
- ऑडियो फ़ीचर को सोच-समझकर इस्तेमाल करें: अगर आपको एम्बिएंट साउंड चाहिए, तो प्रॉम्प्ट में उसका ज़िक्र करें: "पृष्ठभूमि में लहरों की आवाज़, हल्की समुद्री हवा"
- इमेज इनपुट के साथ मिलाएँ: टेक्स्ट प्रॉम्प्ट के साथ रेफ़रेंस इमेज देने से उस खास कैरेक्टर या एनवायरनमेंट के साथ कंसिस्टेंसी काफ़ी बेहतर होती है जो आपके मन में है
आपको कौन सा चुनना चाहिए?
दोनों मॉडल सच में प्रभावशाली हैं। सही जवाब पूरी तरह आपके खास उपयोग पर निर्भर करता है, न कि इस पर कि कौन सा मॉडल किसी अमूर्त बेंचमार्क पर ज़्यादा अंक लाता है।
Seedance 2.0 कब चुनें...
- आपको एक ही पास में ऑडियो चाहिए: नेटिव साउंड जनरेशन पब्लिश-रेडी कंटेंट के लिए वर्कफ़्लो का असली फ़ायदा है
- आपके सीन के केंद्र में मानव सब्जेक्ट हैं: कैरेक्टर कंसिस्टेंसी और चेहरे के डिटेल बनाए रखने की क्षमता मापने योग्य रूप से मज़बूत है
- आपको 1080p आउटपुट चाहिए: प्रोफ़ेशनल या ब्रॉडकास्ट उपयोग के लिए रिज़ॉल्यूशन की सीमा मायने रखती है
- आप तेज़ी से कंटेंट बना रहे हैं: फ़ास्ट वर्ज़न लंबे इंतज़ार के बिना तेज़ इटरेशन व्यावहारिक बनाता है
- आपके प्रॉम्प्ट स्पेसिफ़िक और शाब्दिक हैं: मॉडल सटीक, विस्तृत विवरणों को उच्च फ़िडेलिटी के साथ पूरा करने में माहिर है
WAN 2.7 कब चुनें...
- पर्यावरणीय सीन हावी हों: लैंडस्केप, मौसम के प्रभाव, प्रकृति के सीक्वेंस और वायुमंडलीय दृश्य
- आपको फ़िल्मी कलर पैलेट चाहिए: सिनेमैटिक लुक बिना पोस्ट-ग्रेडिंग के कलात्मक और नैरेटिव प्रोजेक्ट्स पर फ़िट बैठता है
- ओपन-सोर्स लचीलापन मायने रखता है: WAN का आर्किटेक्चर तकनीकी उपयोगकर्ताओं के लिए गहरी कस्टमाइज़ेशन और लोकल डिप्लॉयमेंट की अनुमति देता है
- अमूर्त या मूड-आधारित प्रॉम्प्ट आपकी शैली हैं: व्याख्यात्मक जनरेशन एक असली ताकत है, सीमा नहीं
- आप ऑडियो वैसे भी अलग से संभालते हैं: अगर आपके पास समर्पित ऑडियो पोस्ट-प्रोडक्शन वर्कफ़्लो है, तो दोनों मॉडलों के बीच का फ़र्क पूरी तरह खत्म हो जाता है
💡 गंभीर क्रिएटर्स के लिए सबसे असरदार तरीका: दोनों का इस्तेमाल करें। पर्यावरण और लैंडस्केप शॉट्स WAN 2.7 से जनरेट करें, और मानव सब्जेक्ट या सिंक्रोनाइज़्ड ऑडियो वाले सीन के लिए Seedance 2.0 का इस्तेमाल करें। आउटपुट एक ही एडिटिंग टाइमलाइन में अच्छी तरह मेल खाते हैं।
जो लोग WAN इकोसिस्टम को और खंगालना चाहते हैं, उनके लिए WAN 2.6 T2V, WAN 2.6 I2V, WAN 2.5 T2V और WAN 2.5 I2V जैसे मॉडल उपलब्ध हैं, जो स्पीड और आउटपुट क्वालिटी के बीच अलग-अलग समझौते देते हैं।
अपने AI वीडियो बनाना शुरू करें
तुलना पढ़ना एक हद तक ही काम आता है। Seedance 2.0 बनाम WAN 2.7 की बहस सुलझाने का असली तरीका यह है कि अपने प्रॉम्प्ट से क्लिप्स जनरेट करें और नतीजों को अपनी आँखों से परखें।
दोनों मॉडल PicassoIA पर बिना किसी लोकल हार्डवेयर, डेवलपर सेटअप या GPU की ज़रूरत के उपलब्ध हैं। प्रॉम्प्ट लिखें, जनरेट पर क्लिक करें, और दो मिनट से कम में फ़ुटेज तैयार। एक ही प्रॉम्प्ट दोनों मॉडलों पर एक के बाद एक आज़माएँ, तो आपको संदर्भ में ही शैली और क्वालिटी के अंतर तुरंत दिख जाएँगे।
अगर आप देखना चाहते हैं कि दूसरे अत्याधुनिक वीडियो मॉडल कैसा प्रदर्शन करते हैं, तो PicassoIA Kling V3, LTX 2.3 Pro और Veo 3 जैसे विकल्प भी होस्ट करता है, जिससे आपको एक ही जगह वीडियो AI टूल्स का पूरा इकोसिस्टम मिलता है। जिस प्रॉम्प्ट की आपको परवाह है, उससे शुरुआत करें, उसे दो-तीन मॉडलों पर चलाएँ, और फ़ैसला नतीजों को करने दें।


