Stability AI ने 20 मई 2026 को Stable Audio 3 जारी किया, और सबसे पहला सवाल यही है कि क्या यह वर्ज़न 2.5 की जगह ले लेता है। ऐसा नहीं है। अब दोनों अलग-अलग काम करते हैं। नए परिवार में ऐसे ओपन वेट्स हैं जिन्हें आप अपनी मशीन पर चला सकते हैं, छह मिनट से ज़्यादा लंबे ट्रैक, और इनपेंटिंग जैसे एडिटिंग टूल। Stable Audio 2.5 अब भी एक मिनट से कम में साफ़ इंस्ट्रुमेंटल पाने का तेज़, बिना सेटअप वाला तरीका है। नीचे आपको स्पेक्स साथ-साथ, लाइसेंस और API लागत सीधे संख्याओं में, दोनों पर काम करने वाले प्रॉम्प्ट टिप्स, और आज PicassoIA पर 2.5 चलाने का तरीका मिलेगा।
Stable Audio 3 एक नज़र में
Stable Audio 3 एक ही मॉडल नहीं है। यह चार मॉडलों का परिवार है, जो एक नए आर्किटेक्चर पर बना है: एक सेमांटिक-एकूस्टिक ऑटोएन्कोडर, जो ऑडियो को लगभग 4096 गुना तक सिकोड़ता है और मॉडल को सेकंड तक की किसी भी लंबाई का ऑडियो जनरेट करने देता है। इनमें से तीन ओपन वेट्स के रूप में Hugging Face पर उपलब्ध हैं। सबसे बड़ा वाला सिर्फ़ API पर है।
चार मॉडल
| मॉडल | पैरामीटर | अधिकतम लंबाई | एक्सेस |
|---|
| Small SFX | 459 मिलियन | लगभग 2 मिनट | ओपन वेट्स |
| Small (म्यूज़िक) | 459 मिलियन | लगभग 2 मिनट | ओपन वेट्स |
| Medium | 1.4 बिलियन | 6 min 20 sec | ओपन वेट्स |
| Large | 2.7 बिलियन | 6 मिनट से ज़्यादा | API या एंटरप्राइज़ होस्टिंग |
सभी चारों एक टेक्स्ट प्रॉम्प्ट लेते हैं। परिवार audio-to-audio को भी संभालता है, जो मौजूदा क्लिप को उसकी टाइमिंग बनाए रखते हुए फिर से आकार देता है, और inpainting को भी, जो ट्रैक के एक हिस्से को फिर से जनरेट करता है जबकि बाकी हिस्सा अछूता रहता है। इनपेंटिंग के तीन रूप हैं: एक सेगमेंट, एक साथ कई सेगमेंट, और कॉज़ल कंटिन्यूएशन, जो ट्रैक को जहाँ वह खत्म होता है वहीं से आगे बढ़ाता है। Small और Medium LoRA फाइन-ट्यूनिंग स्वीकार करते हैं, और लॉन्च के दिन ही ComfyUI सपोर्ट आ गया।
💡 ध्यान देने वाली बात: चारों में से कोई भी मॉडल नहीं गाता। पूरे परिवार में कहीं भी वोकल या बोल नहीं हैं। अगर किसी ट्रैक को आवाज़ चाहिए, तो आप उसे एक अलग मॉडल से जोड़ते हैं, और आख़िरी सेक्शन बताते हैं कि यह कैसे करना है।
2.5 के बाद क्या बदला
Stable Audio 2.5 हर जनरेशन में अधिकतम 190 सेकंड, यानी लगभग तीन मिनट, तक पहुँचता है। Stable Audio 3 Medium इसे दोगुना कर देता है, 6 मिनट 20 सेकंड तक। ट्रेनिंग भी ज़्यादा साफ़ हुई है: डेटासेट लगभग 1.28 मिलियन लाइसेंस्ड रिकॉर्डिंग का बताया गया है, जिनमें लगभग 806,000 ट्रैक AudioSparx से और लगभग 473,000 Creative Commons फ़ाइलें Freesound से हैं। कॉपीराइट वाली सामग्री छानकर हटाई गई थी, और यह मायने रखता है अगर आप जो जनरेट करें उसे प्रकाशित करने की योजना बना रहे हैं।
स्पेक्स साथ-साथ
यहाँ एक ही टेबल में छोटा सार है। कीमतें और लंबाइयाँ सार्वजनिक लॉन्च रिपोर्ट और PicassoIA के मॉडल पेज से ली गई हैं, इसलिए किसी बड़े प्रोजेक्ट का बजट बनाने से पहले आधिकारिक प्राइसिंग पेज ज़रूर देख लें।
| फ़ीचर | Stable Audio 2.5 | Stable Audio 3 |
|---|
| अधिकतम लंबाई | 190 सेकंड | 6 min 20 sec (Medium) |
| वेट्स | केवल होस्टेड | Small SFX, Small, Medium के लिए ओपन |
| आपकी मशीन पर चलाना | नहीं | Small CPU पर, Medium GPU पर |
| वोकल्स | इंस्ट्रुमेंटल पर फ़ोकस | कोई नहीं |
| API कीमत प्रति रन | लगभग $0.20 (20 क्रेडिट) | $0.26 (26 क्रेडिट) |
| एडिटिंग टूल | PicassoIA पर टेक्स्ट प्रॉम्प्ट | टेक्स्ट, audio-to-audio, इनपेंटिंग, कंटिन्यूएशन |
| फाइन-ट्यूनिंग | नहीं | Small और Medium पर LoRA |
| सेटअप | कोई नहीं, ब्राउज़र में चलता है | वेट्स डाउनलोड करें या API कॉल करें |
2.5 अब भी कहाँ जीतता है
गति और सरलता। Stable Audio 2.5 पेज पर चलाए गए उदाहरणों में 90 सेकंड के ट्रैक डिफ़ॉल्ट 8 स्टेप पर हर एक लगभग छह सेकंड में बने। आप एक पेज खोलते हैं, प्रॉम्प्ट टाइप करते हैं, और जनरेट दबाते हैं। कोई Python एनवायरनमेंट नहीं, कोई GPU ड्राइवर नहीं, कोई लाइसेंस फ़ॉर्म नहीं।
प्रति रन कीमत। लगभग 20 क्रेडिट बनाम 26 क्रेडिट पर, जब आपको सिर्फ़ एक छोटा लूप चाहिए, तब 2.5 सस्ता API कॉल है।
भरोसेमंद इटरेशन। सीड दोबारा इस्तेमाल करें तो आपको वही ऑडियो वापस मिलता है, इसलिए आप प्रॉम्प्ट का एक शब्द बदलकर ठीक-ठीक सुन सकते हैं कि वह शब्द क्या बदलता है।
3 कहाँ आगे निकलता है
लंबाई। छह मिनट का Medium ट्रैक शॉर्ट फ़िल्म के कयू या पॉडकास्ट बेड के लिए काफ़ी है, बिना क्लिप्स को जोड़े।
नियंत्रण। इनपेंटिंग से आप पूरा गाना दोबारा जनरेट किए बिना बार 40 को ठीक कर सकते हैं। कंटिन्यूएशन ट्रैक को जहाँ वह रुकता है वहीं से आगे बढ़ाता है। Audio-to-audio आपके पास पहले से मौजूद क्लिप को फिर से आकार देता है।
वर्कफ़्लो पर आपका अपना नियंत्रण। ओपन वेट्स का मतलब है कि आप ऑफ़लाइन चला सकते हैं, अप्रकाशित सामग्री को तीसरे-पक्ष के सर्वरों से दूर रख सकते हैं, और अपनी साउंड लाइब्रेरी पर LoRA से फाइन-ट्यून कर सकते हैं। उदाहरण के लिए, एक गेम स्टूडियो Small SFX को अपनी फ़ोली रिकॉर्डिंग पर ट्रेन कर सकता है, ताकि हर फ़ुटस्टेप स्टूडियो की अपनी शैली से मेल खाए।
ईमानदार गुणवत्ता जाँच। एक रिव्यू ने इस परिवार को 10 में से 7.8 अंक दिए और इसकी खूबियाँ गिनाईं: एम्बिएंट ड्रोन, फ़ोली, साउंड इफ़ेक्ट, इंस्ट्रुमेंटल लूप और एटमॉस्फ़ेरिक बेड। उसी रिव्यू ने नोट किया कि संगीत सही तो लग सकता है पर दिलचस्प नहीं लगता, और रिदमिक शैलियाँ सपाट हो जाती हैं। 3 को बेड और इफ़ेक्ट्स के लिए एक मज़बूत टूल मानें, बैंड का विकल्प नहीं।
ओपन वेट्स: आप क्या चला सकते हैं
ओपन वेट्स इस बात को बदल देते हैं कि इसका इस्तेमाल कौन कर सकता है। पहले इस क्वालिटी के ऑडियो मॉडल सिर्फ़ API के पीछे रहते थे। अब दो छोटे मॉडलों के लिए एक लैपटॉप और एक डाउनलोड काफ़ी है।
CPU पर छोटे मॉडल
Small SFX और Small बिना अलग ग्राफ़िक्स कार्ड वाले CPU पर चलते हैं। लॉन्च रिपोर्टों के अनुसार H200 सर्वर GPU पर जनरेशन का समय आधे सेकंड से कम है, और इस डिज़ाइन का मकसद है ऑन-डिवाइस, ऑफ़लाइन, पूरी म्यूज़िक कंपोज़िशन, उन छोटी सैंपल सीमाओं के बिना जो पुराने ओपन मॉडलों में थीं। इम्पैक्ट्स, एम्बिएंस, फ़ुटस्टेप और व्हूश के लिए Small SFX इस्तेमाल करें। लूप और दो मिनट तक के छोटे इंस्ट्रुमेंटल पीस के लिए Small इस्तेमाल करें।
दोनों छोटे मॉडल LoRA फाइन-ट्यूनिंग भी लेते हैं। LoRA आपकी अपनी क्लिप्स पर ट्रेन किया गया एक छोटा एड-ऑन है, जैसे आपके बैंड की ड्रम रिकॉर्डिंग या किसी गेम की फ़ोली लाइब्रेरी, और यह हर जनरेशन को उसी साउंड की ओर थोड़ा मोड़ देता है। चूँकि एड-ऑन बहुत छोटा है, यह काम पूरे मॉडल को दोबारा ट्रेन करने से कहीं हल्का है।
Medium 1.4 बिलियन पैरामीटर के साथ भारी विकल्प है। सेटअप नोट्स में Flash Attention 2 के साथ CUDA GPU को समर्थित रास्ता बताया गया है, और H200 पर बताई गई गति प्रति ट्रैक दो सेकंड से कम है। एक रिव्यूअर ने MacBook Pro M4 पर कुछ सेकंड मापे, इसलिए योजना बनाने से पहले अपने सटीक हार्डवेयर के लिए रिपॉज़िटरी जाँच लें।
लाइसेंस के नियम, सीधी भाषा में
ओपन मॉडल Stability AI Community License का इस्तेमाल करते हैं।
- सालाना राजस्व $1 मिलियन से कम: Community License के लिए रजिस्टर करने के बाद मुफ़्त में डाउनलोड करें, चलाएँ, फाइन-ट्यून करें और व्यावसायिक रूप से इस्तेमाल करें। कानून जहाँ तक इजाज़त देता है, आउटपुट के मालिक आप हैं।
- $1 मिलियन से ज़्यादा: आपको Enterprise License चाहिए, जो कानूनी इंडेम्निफ़िकेशन भी जोड़ता है।
- Large: इसे कभी डाउनलोड नहीं किया जा सकता। यह Stability API के ज़रिए, fal.ai के ज़रिए, या एंटरप्राइज़ सेल्फ-होस्टिंग के ज़रिए पहुँचा जा सकता है।
💡 प्रकाशित करने से पहले पढ़ें: "आउटपुट आपका है" का मतलब यह नहीं कि "आउटपुट कॉपीराइट से सुरक्षित है।" कई देशों में पूरी तरह मशीन से बने ऑडियो को इंसानी काम के मुकाबले कमज़ोर सुरक्षा मिलती है। अगर कोई ट्रैक आपके ब्रांड का केंद्र है, तो उसके ऊपर अपनी परफ़ॉर्मेंस या एडिट्स जोड़ें।
API का इस्तेमाल
हर कोई कुछ इंस्टॉल करना नहीं चाहता। होस्टेड रास्ता आइडिया से फ़ाइल तक का सबसे छोटा रास्ता है।
हर जनरेशन की लागत
Stability क्रेडिट में कीमत लगाती है, और एक क्रेडिट एक सेंट के बराबर है। एक Stable Audio 3 जनरेशन की लागत 26 क्रेडिट, यानी $0.26 है। Stable Audio 2.5 की रिपोर्ट 20 क्रेडिट, यानी लगभग $0.20 है। एक छोटी सी अड़चन: 25 क्रेडिट का मुफ़्त स्टार्टर बैलेंस एक Stable Audio 3 रन से एक क्रेडिट कम है, इसलिए टेस्टिंग के लिए भी थोड़ा टॉप-अप बजट में रखें।
| मात्रा | $0.26 प्रति रन पर | $0.20 प्रति रन पर |
|---|
| 10 ट्रैक | $2.60 | $2.00 |
| 100 ट्रैक | $26.00 | $20.00 |
| 1,000 ट्रैक | $260.00 | $200.00 |
API कब लोकल से बेहतर है
जब आपको Large मॉडल चाहिए, तब API चुनें, क्योंकि एंटरप्राइज़ कॉन्ट्रैक्ट के अलावा इस तक पहुँचने का यही एक रास्ता है। जब आपके पास GPU न हो, जब आपका वॉल्यूम अचानक बढ़ता-घटता हो, या जब किसी प्रोडक्ट को सर्वर संभाले बिना माँग पर ऑडियो चाहिए, तब भी इसे चुनें। जब आप हज़ारों क्लिप्स जनरेट करें, ऑफ़लाइन काम करें, या फाइन-ट्यून करने की ज़रूरत हो, तब लोकल वेट्स चुनें।
एक सामान्य होस्टेड वर्कफ़्लो कुछ ऐसा दिखता है:
- जेनर, इंस्ट्रुमेंट्स, मूड और टेम्पो के साथ प्रॉम्प्ट लिखें।
- ज़रूरत के मुताबिक पूरे सेकंड में लंबाई सेट करें।
- रिक्वेस्ट भेजें और ऑडियो फ़ाइल का इंतज़ार करें।
- सुनें, फिर एक वेरिएबल बदलें और दोबारा चलाएँ।
- जीतने वाले ट्रैक को अपने एडिटर में ट्रिम करें, फ़ेड करें और लूप करें।
होस्टेड Stable Audio 2.5 स्कीमा छोटा है: एक टेक्स्ट प्रॉम्प्ट, एक अवधि, स्टेप्स की संख्या, एक गाइडेंस स्केल (CFG) और एक वैकल्पिक सीड। ये वही डायल हैं जो आपको ज़्यादातर Stable Audio एंडपॉइंट्स में मिलेंगे, इसलिए जो आप 2.5 पर अभ्यास करेंगे वह आगे भी काम आएगा।
काम करने वाले प्रॉम्प्ट टिप्स
दोनों वर्ज़न के प्रॉम्प्ट साफ़-साफ़ बताए जाने पर सबसे अच्छा नतीजा देते हैं। "chill music" जैसा धुंधला अनुरोध आम वॉलपेपर जैसा नतीजा देता है। ऐसा प्रॉम्प्ट जो जेनर, इंस्ट्रुमेंट्स, मूड और टेम्पो का नाम ले, ऐसा नतीजा देता है जिसे आप इस्तेमाल कर सकें।
पाँच हिस्सों वाला फ़ॉर्मूला
प्रॉम्प्ट इस क्रम में लिखें, कॉमा से अलग करके:
- जेनर: boom bap hip hop, ऐम्बिएंट हाउस, पोस्ट-रॉक, सिनेमैटिक सिंथवेव
- इंस्ट्रूमेंट्स: गंभीर पियानो, SP-1200 ड्रम्स, 808 किक, स्ट्रिंग्स, साइन वेव बास
- मूड: शांत, उल्लासित, उदास, तनावपूर्ण
- टेम्पो: एक संख्या, जैसे 90 BPM या 125 BPM
- टेक्सचर या स्केल: गर्म, धूल भरा, विस्तृत, माइनर टोनैलिटी
| कमज़ोर प्रॉम्प्ट | मज़बूत प्रॉम्प्ट |
|---|
| आरामदायक म्यूज़िक | सोलफ़ुल boom bap hip hop इंस्ट्रुमेंटल, गंभीर पियानो, SP-1200 ड्रम्स, साइन वेव बास, शांत, 90 BPM |
| डांस ट्रैक | ऐम्बिएंट हाउस, 808 ड्रम मशीन, क्लैप्स, शेकर, सिंथ बास, उल्लासित, 125 BPM |
| एपिक मूवी म्यूज़िक | पोस्ट-रॉक, गिटार, ड्रम किट, बास, स्ट्रिंग्स, उत्साहवर्धक, बहता हुआ, भावुक, 125 BPM |
| दरवाज़े की आवाज़ | पत्थर के हॉल में भारी लकड़ी के दरवाज़े का ज़ोर से बंद होना, लंबी इको टेल, कोई म्यूज़िक नहीं |
लंबे ट्रैक के लिए, प्रॉम्प्ट के अंत में टाइमिंग संकेत जोड़ें: "soft pads for the first 20 seconds, drums enter after 20 seconds, slow fade at the end." Stable Audio 3 के लंबे ट्रैक को इससे सबसे ज़्यादा फ़ायदा होता है, क्योंकि छह मिनट के पीस में एक आर्क होना ज़रूरी है। 2.5 पर टाइमिंग संकेत छोटे रखें और नतीजे को कान से परखें।
साउंड इफ़ेक्ट्स के लिए म्यूज़िक वाले फ़ॉर्मूले की जगह तीन बातें लें: ऑब्जेक्ट, वह सतह जिसे वह छूता है, और उसके आसपास का स्पेस। "Boots on wet gravel, empty quarry, distant wind" अक्सर "footsteps" से बेहतर होता है, क्योंकि मॉडल आवाज़ को किसी कमरे में रख सकता है।
💡 शॉर्टकट: दो-तीन शब्द भी काम कर सकते हैं। "Lo-fi Funk" या "Cinematic Synthwave" जैसे छोटे जेनर प्रॉम्प्ट 2.5 के उदाहरणों में इस्तेमाल लायक 90 सेकंड के ट्रैक दे गए। पहला नतीजा भटकने लगे तभी ज़्यादा विवरण जोड़ें।
ऐसी गलतियाँ जो क्रेडिट बर्बाद करती हैं
- वोकल्स माँगना। Stable Audio 3 में कोई वोकल या बोल नहीं हैं, और 2.5 इंस्ट्रुमेंटल और साउंड डिज़ाइन के लिए बना है। गाने के लिए गाने वाला मॉडल इस्तेमाल करें।
- बहुत सारे विशेषण डालना। दस मूड शब्द एक-दूसरे को काट देते हैं। दो चुनें।
- टेम्पो छोड़ देना। BPM के बिना रिदम भटकती है। एक संख्या उसे स्थिर करती है।
- बिना सोचे दोबारा जनरेट करना। एक बार में एक चीज़ बदलें और सीड फिक्स रखें, ताकि पता चले कि कौन सा एडिट मदद कर गया।
- हिट कोरस की उम्मीद करना। ये मॉडल बेड, लूप, एम्बिएंस और इफ़ेक्ट्स में सबसे अच्छे हैं।
कमज़ोर ट्रांज़िशन ठीक करें
जनरेट किए गए संगीत में कमज़ोर ट्रांज़िशन, दोहराव, अस्थिर रिदम, बैकग्राउंड नॉइज़ और अचानक खत्म होने वाले अंत दिख सकते हैं। Stable Audio 3 पर आप खराब हिस्से को इनपेंटिंग से पैच करते हैं, शुरू से दोबारा नहीं। 2.5 पर थोड़ा ज़्यादा लंबा जनरेट करें, किसी भी ऑडियो एडिटर में कमज़ोर अंत ट्रिम करें और एक छोटा फ़ेड जोड़ें।
लिखे जाने के समय PicassoIA कैटलॉग में Stable Audio 2.5 है, Stable Audio 3 नहीं। बिना कुछ इंस्टॉल किए प्रॉम्प्ट स्टाइल आज़माने का यह अब भी सबसे तेज़ तरीका है, और इसकी आदतें आगे भी काम आती हैं।
चरण-दर-चरण
- PicassoIA पर Stable Audio 2.5 पेज खोलें।
- ऊपर दिए पाँच हिस्सों वाले फ़ॉर्मूले से बना प्रॉम्प्ट पेस्ट करें।
- अवधि सेकंड में सेट करें। डिफ़ॉल्ट 190 है, जो अधिकतम है।
- तेज़ पहले पास के लिए स्टेप्स 8 पर छोड़ दें।
- गाइडेंस स्केल (CFG) 1 पर छोड़ें, फिर अगर नतीजा आपके इंस्ट्रुमेंट्स को नज़रअंदाज़ करे तो उसे बढ़ाएँ।
- जनरेट दबाएँ और सुनें। ज़्यादातर 90 सेकंड के ट्रैक लगभग छह सेकंड में पूरे हो जाते हैं।
- जो सीड पसंद आए उसे कॉपी करें, प्रॉम्प्ट का एक शब्द बदलें और फिर जनरेट करें।
बदलने लायक सेटिंग्स
| सेटिंग | डिफ़ॉल्ट | क्या करता है |
|---|
| प्रॉम्प्ट | कोई नहीं | जेनर, इंस्ट्रुमेंट्स, मूड और टेम्पो का वर्णन करता है |
| अवधि | 190 | ट्रैक की लंबाई सेकंड में |
| स्टेप्स | 8 | ज़्यादा स्टेप्स गति की कीमत पर बारीक डिटेल देते हैं |
| गाइडेंस स्केल (CFG) | 1 | ज़्यादा मान प्रॉम्प्ट का ज़्यादा करीबी पालन करते हैं |
| सीड | रैंडम | नतीजा दोबारा पाने के लिए इसे फिर से इस्तेमाल करें |
पहले छोटी अवधि आज़माएँ। 30 सेकंड का लूप परखने में सबसे कम समय लेता है, और जीतने वाले प्रॉम्प्ट को बाद में पूरी लंबाई तक बढ़ाया जा सकता है।
वोकल्स, वॉयसओवर और ट्रांस्क्रिप्ट जोड़ें
चूँकि दोनों वर्ज़न नहीं गाते, इसलिए एक तैयार प्रोजेक्ट को आमतौर पर दो-तीन टूल्स की ज़रूरत होती है। PicassoIA इन्हें एक ही जगह पर रखता है।
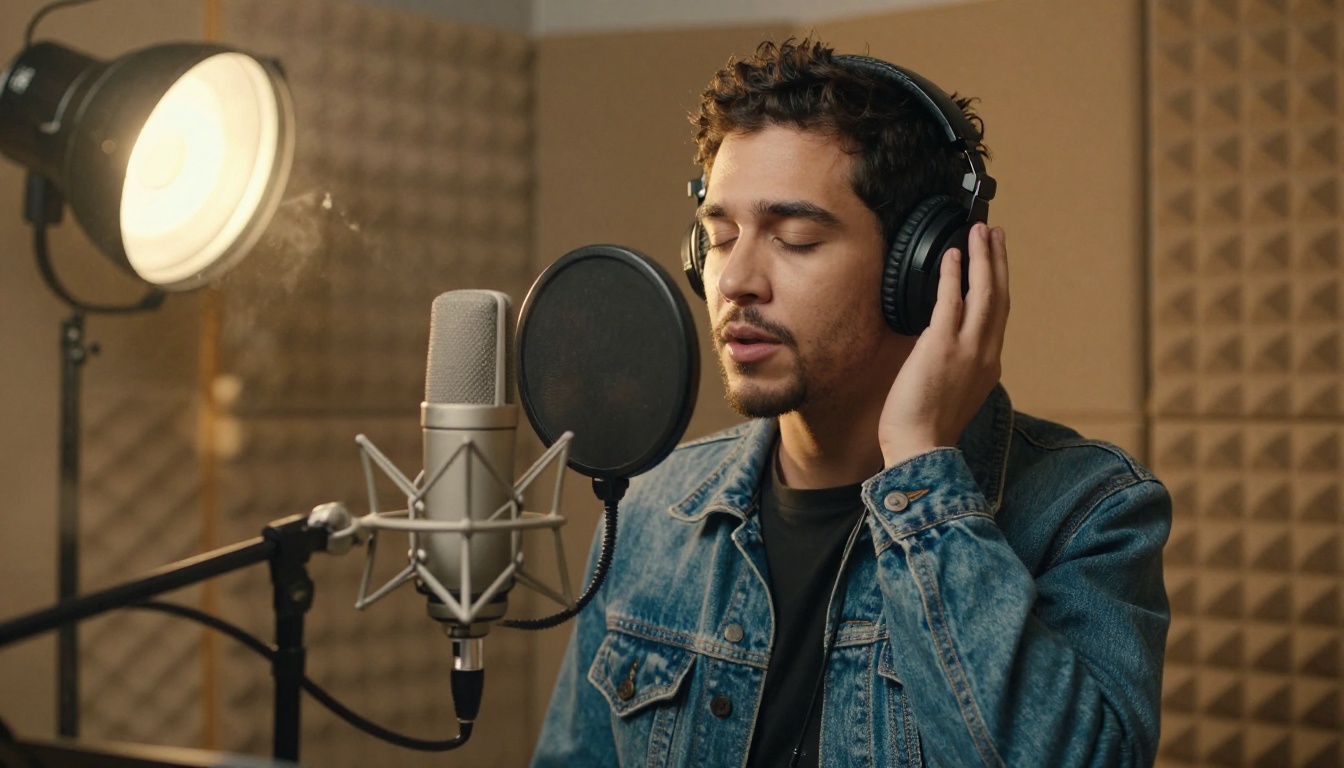
वोकल्स वाले गाने
जब ब्रीफ़ में बोल और गायक चाहिए हों, तो मॉडल बदलें। Music 2.5 वोकल्स वाले पूरे गाने जनरेट करता है। Lyria 3 Pro पूरी लंबाई के गाने बनाता है, और Music from ElevenLabs टेक्स्ट प्रॉम्प्ट से ट्रैक कंपोज़ करता है। एक आम वर्कफ़्लो: Stable Audio में इंस्ट्रुमेंटल बेड का ड्राफ़्ट बनाएँ, फिर वोकल मॉडल से उसकी तुलना करें कि कौन सा वीडियो में ठीक बैठता है।
वॉयसओवर और ट्रांस्क्रिप्ट
आपके इंस्ट्रुमेंटल पर नैरेशन के लिए, Speech 2.8 HD स्टूडियो-क्वालिटी वॉयसओवर देता है, Gemini 3.1 Flash TTS 70+ भाषाओं में 30 आवाज़ें देता है, और V3 from ElevenLabs लंबी रीडिंग के लिए प्राकृतिक लगने वाला विकल्प है।
रिकॉर्डिंग को वापस टेक्स्ट में बदलने के लिए, उन्हें GPT 4o Transcribe या Gemini 3 Pro से चलाएँ। ट्रांस्क्रिप्ट कैप्शन, शो नोट्स और यह जाँचने में मदद करते हैं कि संगीत के नीचे जाने से पहले वॉयसओवर वही कहता है जो स्क्रिप्ट में लिखा है।
आज अपना पहला ट्रैक बनाएँ
तो आपको कौन सा चुनना चाहिए? यह काम पर निर्भर करता है:
| काम | सबसे अच्छा विकल्प | क्यों |
|---|
| फ़ुटस्टेप्स, इम्पैक्ट्स और एम्बिएंस पैक | Stable Audio 3 Small SFX | मुफ़्त, ऑफ़लाइन, CPU पर चलता है |
| वीडियो या रील के लिए लूप | Stable Audio 3 Small या Stable Audio 2.5 | तेज़ और सस्ता, और 2.5 को कोई सेटअप नहीं चाहिए |
| छह मिनट का बैकग्राउंड बेड | Stable Audio 3 Medium | सबसे लंबा ओपन मॉडल, GPU चाहिए |
| प्रोडक्ट के अंदर माँग पर ऑडियो | Stable Audio 3 Large (API) | सबसे ऊपर का टियर, संभालने के लिए कोई सर्वर नहीं |
| प्रॉम्प्ट आइडिया का तेज़ टेस्ट | PicassoIA पर Stable Audio 2.5 | सेकंडों में नतीजे, कुछ इंस्टॉल नहीं करना |
प्रॉम्प्ट में फ़र्क सुनने का सबसे तेज़ तरीका उन्हें आज़माना है। PicassoIA पर Stable Audio 2.5 खोलें, ऊपर की टेबल से कोई एक प्रॉम्प्ट पेस्ट करें, और 30 सेकंड का लूप जनरेट करें। फिर टेम्पो बदलें, एक इंस्ट्रुमेंट बदलें, और दोबारा सुनें। दस मिनट के भीतर आपको अंदाज़ा हो जाएगा कि यह परिवार कैसे प्रतिक्रिया देता है, और जब आप आवाज़ों या ट्रांस्क्रिप्ट के लिए तैयार हों, तो स्पीच और ट्रांसक्रिप्शन मॉडल उसी प्लेटफ़ॉर्म पर एक क्लिक की दूरी पर हैं।


