यूनिफ़ाइड AI API गेटवे: एक API से सभी AI मॉडल तक पहुँच
एक यूनिफ़ाइड AI API गेटवे टेक्स्ट, इमेज और वीडियो मॉडल को एक एंडपॉइंट, एक टोकन और एक रिक्वेस्ट फ़ॉर्मैट के पीछे रखता है। जानें कि एक अच्छा गेटवे क्या सँभालता है, मुख्य विकल्पों की तुलना कैसी है, और काम करने वाले curl और Python कोड के साथ PicassoIA API पर पहली कॉल कैसे चलाएँ।
हर टीम जो AI फ़ीचर शिप करती है, तीसरे प्रोवाइडर के आसपास एक ही दिक्कत से जूझती है। एक मॉडल कॉपी लिखता है, दूसरा हीरो इमेज बनाता है, तीसरा प्रोडक्ट क्लिप रेंडर करता है, और हर एक अपने SDK, अपने क्रेडेंशियल, अपने इनवॉइस और एरर कैसा दिखता है, इसकी अपनी समझ के साथ आता है। एक यूनिफ़ाइड AI API गेटवे इस बिखराव को खत्म करता है: एक एंडपॉइंट, एक टोकन, एक रिक्वेस्ट पैटर्न, और उसके पीछे पूरा मॉडल कैटलॉग। यह लेख दिखाता है कि यह व्यवहार में कैसे काम करता है, एक अच्छे गेटवे को क्या सँभालना चाहिए, ट्रेड-ऑफ़ कहाँ छिपे होते हैं, और कुछ मिनटों में PicassoIA API पर असली कॉल कैसे चलाई जाती है।
यूनिफ़ाइड गेटवे क्या करता है
गेटवे आपके एप्लिकेशन और मॉडल प्रोवाइडरों के बीच बैठता है। आपका कोड एक फ़ॉर्मैट में एक रिक्वेस्ट भेजता है। गेटवे मॉडल चुनता है, रिक्वेस्ट को उस मॉडल की अपेक्षा के अनुसार बदलता है, नतीजे का इंतज़ार करता है, और उसे एक स्थिर शेप में वापस देता है। जब तक आप न चाहें, आपके एप्लिकेशन को यह जानने की ज़रूरत नहीं पड़ती कि दूसरी तरफ़ कौन-सा वेंडर है।
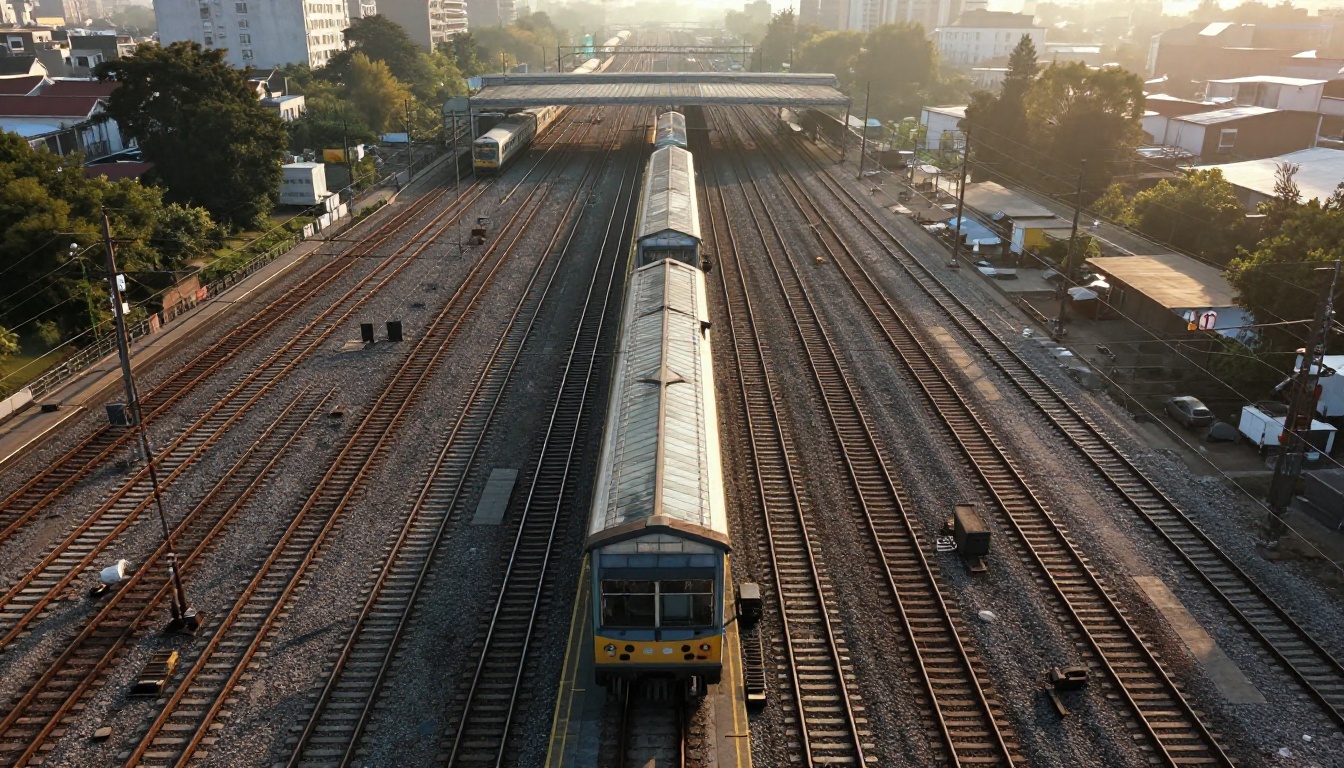
एक रेलवे जंक्शन की कल्पना करें। दर्जनों पटरियाँ अलग-अलग दिशाओं से आती हैं, फिर भी यात्री एक ही स्टेशन से काम लेते हैं। एक API से सभी AI मॉडल तक पहुँचने के पीछे यही वादा है: बहुत सारे स्रोत, टिकट खरीदने की एक ही जगह। यूनिफ़ाइड गेटवे के साथ मॉडल एक पैरामीटर बन जाता है, इंटीग्रेशन नहीं। इसलिए तेज़ और सस्ते मॉडल से ज़्यादा ताकतवर मॉडल पर जाना कॉन्फ़िग फ़ाइल में एक लाइन का बदलाव है, कोई स्प्रिंट नहीं।
एक मज़बूत गेटवे आम तौर पर ये चीज़ें देता है:
एक ही बेस URL हर रिक्वेस्ट के लिए, चाहे मीडिया का प्रकार कुछ भी हो
एक ऑथेंटिकेशन तरीका, आम तौर पर Authorization हेडर में Bearer टोकन
एक साझा रिक्वेस्ट शेप, ताकि prompt का मतलब हर मॉडल के लिए एक ही हो
एक अनुमानित रिस्पॉन्स ऑब्जेक्ट जिसमें status, output और error फ़ील्ड हों
एक ब्राउज़ेबल मॉडल कैटलॉग जिसमें आप नाम से स्विच कर सकें
प्रोवाइडर छोटी-छोटी बातों पर अलग होते हैं, और ये बातें जुड़कर बड़ा फ़र्क बनाती हैं। एक फ़ील्ड का नाम prompt रखता है, दूसरा input_text। एक जवाब तुरंत लौटाता है, दूसरा job id देता है जिसे आपको पोल करना पड़ता है। एक टोकन-आधारित बिलिंग करता है, दूसरा वीडियो के सेकंड के हिसाब से। गेटवे इन फ़र्कों को खुद सँभाल लेता है, ताकि आपके प्रोडक्ट का कोड सीधा-सादा रहे, और ठीक यही आप चाहते हैं।
टीमें प्रोवाइडरों को एक साथ सँभालना क्यों छोड़ देती हैं
कोई भी जानबूझकर इंटीग्रेशन का ढेर नहीं बनाता। यह एक-एक फ़ीचर करके होता है, और हर कदम उस वक़्त ठीक लगता है। दिक्कत बाद में तीन जगहों पर दिखती है।
SDK के जंजाल में असली समय जाता है
हर प्रोवाइडर SDK का अपना रिलीज़ शेड्यूल, अपने टाइप और अपनी एरर क्लास होती है। पाँच इंटीग्रेशन वाले प्रोडक्ट के पास पाँच अपग्रेड शेड्यूल, पाँच चेंजलॉग और ब्रेकिंग बदलावों के पाँच सेट होते हैं जो किसी शुक्रवार दोपहर अचानक आ सकते हैं। घंटे प्लंबिंग में चले जाते हैं, उस फ़ीचर में नहीं जो आपके ग्राहकों ने माँगा था।
बिलिंग और क्रेडेंशियल जमा होते जाते हैं
पाँच प्रोवाइडर मतलब पाँच इनवॉइस, आपकी CI सेटिंग्स में पाँच सीक्रेट और पाँच रोटेशन कैलेंडर। लीक हुआ एक क्रेडेंशियल हर वेंडर के लिए अलग इंसिडेंट बन जाता है। जब फ़ाइनेंस टीम पूछती है कि हर फ़ीचर पर AI की लागत कितनी है, तो स्प्रेडशीट और एक खाली दोपहर के बिना कोई जवाब नहीं दे पाता।
लेयर के बिना मॉडल बदलना तकलीफ़ देता है
नए मॉडल लगभग हर हफ़्ते आते हैं। जब कोडबेस में मॉडल के नाम हार्डकोड होते हैं, तो किसी नए मॉडल को आज़माने का मतलब है हर कॉल साइट बदलना, दोबारा टेस्ट करना और दोबारा डिप्लॉय करना। गेटवे की एक लेयर इसे कॉन्फ़िग बदलाव में बदल देती है, जिसे आप सेकंडों में वापस भी ले सकते हैं।
कॉन्सर्न
सीधे इंटीग्रेशन
यूनिफ़ाइड गेटवे के पीछे
क्रेडेंशियल
हर प्रोवाइडर के लिए एक
एक टोकन
रिक्वेस्ट फ़ॉर्मैट
हर प्रोवाइडर के लिए अलग
एक ही शेप
मॉडल बदलना
कोड बदलना और दोबारा डिप्लॉय करना
मॉडल का नाम बदलना
कॉस्ट विज़िबिलिटी
कई इनवॉइस
एक अकाउंट व्यू
रिट्राई और एरर लॉजिक
हर प्रोवाइडर के लिए अलग से लिखा
एक बार लिखा
अच्छा गेटवे क्या सँभालता है
गेटवे तभी काम का है जब वह सचमुच आपका काम हल्का करे। विकल्प तुलना करते समय पहले इन तीन क्षेत्रों को जाँचें।
राउटिंग और फ़ॉलबैक
राउटिंग तय करती है कि कौन-सा मॉडल किसी रिक्वेस्ट का जवाब देगा। सबसे सरल रूप एक नाम खोजना है। बेहतर राउटिंग में फ़ॉलबैक जुड़ते हैं: अगर पहला मॉडल टाइमआउट हो जाए, तो गेटवे उसी प्रॉम्प्ट के साथ दूसरे मॉडल को आज़माता है। टेक्स्ट के लिए यह यूज़र्स को दिखता ही नहीं। इमेज और वीडियो के लिए फ़ॉलबैक पर ज़्यादा सोचना पड़ता है, क्योंकि दो मॉडल शायद ही एक जैसा लुक देते हैं। इसलिए पहले तय करें कि अलग स्टाइल स्वीकार्य है या काम बस फ़ेल होकर दोबारा चलना चाहिए।
रेट लिमिट और क्यू
हर प्लेटफ़ॉर्म एक साथ चलने वाले काम की सीमा तय करता है। PicassoIA API हर अकाउंट के लिए 5 एक साथ चलने वाले प्रेडिक्शन की अनुमति देता है, जो उस अकाउंट के हर टोकन और हर MCP कनेक्शन में साझा होते हैं। इससे ज़्यादा रिक्वेस्ट को कहीं इंतज़ार करना पड़ेगा, इसलिए रिक्वेस्ट को अपने आप बेतरतीब तरीके से फ़ेल होने देने के बजाय अपनी क्यू बनाएँ। ज़्यादातर प्रोडक्ट्स के लिए 5 पर सेट सेमाफ़ोर वाला एक छोटा वर्कर पूल काफ़ी है।
लॉगिंग और कॉस्ट ट्रैकिंग
हर कॉल के लिए मॉडल का नाम, प्रेडिक्शन id, अवधि और नतीजा लॉग करें। ये चार फ़ील्ड ज़्यादातर सपोर्ट सवालों के जवाब दे देते हैं ("यह धीमा क्यों था?", "यह इमेज किस मॉडल ने बनाई?") और फ़ीचर के हिसाब से लागत को अंदाज़े के खेल के बजाय एक सीधी क्वेरी बना देते हैं।
💡 टिप: प्रेडिक्शन id को उस यूज़र एक्शन के साथ सेव करें जिसने उसे शुरू किया। जब कोई ग्राहक खराब नतीजे की शिकायत करे, तो आप सेकंडों में ठीक वही रिक्वेस्ट ढूँढ सकते हैं।
टेक्स्ट, इमेज और वीडियो एक साथ
ज़्यादातर गेटवे की शुरुआत सिर्फ़ टेक्स्ट से हुई थी। ज़्यादा काम के गेटवे हर मीडिया प्रकार को एक ही कॉल पैटर्न के पीछे रखते हैं। यह मायने रखता है, क्योंकि असली प्रोडक्ट्स इन्हें मिलाते हैं: एक ही कैंपेन के लिए एक स्क्रिप्ट, एक थंबनेल और एक छोटी क्लिप।
एक कॉल के पीछे लैंग्वेज मॉडल
कैटलॉग को लाइब्रेरी के कार्ड इंडेक्स की तरह समझें: आप नाम से वह चीज़ खोजते हैं जिसकी ज़रूरत है और सिस्टम उसे ले आता है। PicassoIA पर 75 लैंग्वेज मॉडल सूचीबद्ध हैं, जिनमें Claude Sonnet 5, GPT 5.6 Sol, Gemini 3.1 Pro, Kimi K2.6, DeepSeek V3.1 और Llama 4 Maverick शामिल हैं। रीज़निंग और कोड के लिए ज़्यादा ताकतवर मॉडल चुनें, छोटे जवाब और टैगिंग के लिए छोटा मॉडल, और इस चुनाव को लॉजिक में दबाने के बजाय एक वेरिएबल में रखें।
हर लुक के लिए इमेज मॉडल
इमेज का काम उसी विचार पर चलता है, बस आउटपुट अलग होता है। PicassoIA पर 212 इमेज मॉडल सूचीबद्ध हैं। Seedream 4.5 पॉलिश्ड कमर्शियल सीन के लिए ठीक है, Flux 2 Pro बारीक डिटेल से भरे प्रॉम्प्ट अच्छी तरह सँभालता है, GPT Image 2 तब आज़माने लायक है जब फ़्रेम में पढ़ने लायक टेक्स्ट चाहिए, और Nano Banana Pro फ़ोटो एडिट के लिए एक लोकप्रिय विकल्प है। आज API से दो इमेज मॉडल पहुँच में हैं: जेनरेशन के लिए PicassoIA Image और एडिटिंग व तस्वीरों को मिलाने के लिए PicassoIA Image Editor Pro।
वीडियो मॉडल और नेटिव ऑडियो
वीडियो सबसे भारी मीडिया प्रकार है: जॉब ज़्यादा देर चलते हैं, आउटपुट बड़े होते हैं, और कई नए मॉडल सिंक्रोनाइज़्ड ऑडियो भी बनाते हैं। PicassoIA पर 121 वीडियो मॉडल सूचीबद्ध हैं, जिनमें Veo 3.1, Kling v3 Video, Wan 3 और Seedance 2.5 शामिल हैं। API के ज़रिए आप टेक्स्ट या इमेज से वीडियो के लिए PicassoIA Video तक पहुँच सकते हैं, और Seedance 2.5 Lite तक भी, जो सिंक्रोनाइज़्ड ऑडियो जोड़ता है। चूँकि वीडियो में समय लगता है, एसिंक्रोनस पैटर्न (बनाना, पोल करना, लाना) कोई वैकल्पिक अतिरिक्त नहीं है। पूरा सिस्टम इसी तरह काम करता है।
एक ही कैंपेन से फ़ायदा साफ़ दिखता है। एक लैंग्वेज मॉडल स्क्रिप्ट का ड्राफ़्ट बनाता है, PicassoIA Image थंबनेल तैयार करता है, और PicassoIA Video शुरुआती शॉट को एनिमेट करता है। यह तीन कॉल हैं, एक टोकन, एक हेल्पर फ़ंक्शन और लॉग पढ़ने की एक ही जगह। अलग-अलग प्रोवाइडरों के साथ यही पाइपलाइन तीन SDK, तीन सीक्रेट और एरर हैंडलिंग के तीन सेट माँगती है।
💡 दायरे को लेकर साफ़-साफ़ बताएँ। ऊपर दिए कैटलॉग के आँकड़े वे हैं जो आप प्लेटफ़ॉर्म पर ब्राउज़ करके इस्तेमाल कर सकते हैं। सार्वजनिक API अभी चार मॉडल उपलब्ध कराता है। अपने ग्राहकों से किसी खास मॉडल का वादा करने से पहले PicassoIA API पेज जाँच लें।
API से PicassoIA Image कैसे इस्तेमाल करें
PicassoIA Image (picassoia/picassoia-image) के ज़रिए शून्य से एक तैयार तस्वीर तक का एक काम करने वाला रास्ता यहाँ है। यही कदम बाकी तीन API मॉडल पर भी लागू होते हैं। बदलते हैं सिर्फ़ मॉडल स्लग और इनपुट फ़ील्ड।
API टोकन बनाएँ
PicassoIA API पेज खोलें, एक टोकन बनाएँ और उसे तुरंत कॉपी कर लें। यह pia_sk_ से शुरू होता है और सिर्फ़ एक बार दिखाया जाता है। एक अकाउंट में एक समय में 2 टोकन हो सकते हैं, जो एक प्रोडक्शन एनवायरनमेंट और एक टेस्टिंग के लिए काफ़ी हैं। टोकन को एनवायरनमेंट वेरिएबल में या अपने सीक्रेट मैनेजर में रखें, कभी अपनी रिपॉज़िटरी में नहीं।
पहला प्रेडिक्शन भेजें
/v1/models/{owner}/{name}/predictions पर POST करें और अपने पैरामीटर एक input ऑब्जेक्ट में रखें:
curl -X POST https://api.picassoia.com/v1/models/picassoia/picassoia-image/predictions \
  -H "Authorization: Bearer $PICASSOIA_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"input": {"prompt": "a lighthouse at sunset, film photograph", "aspect_ratio": "16:9"}}'
रिस्पॉन्स एक प्रेडिक्शन ऑब्जेक्ट है। इसमें api_ से शुरू होने वाला id, एक status, सुझाए गए पोलिंग अंतराल वाला eta और जॉब को लाने व रद्द करने के लिए urls होते हैं।
पूरा होने तक पोल करें
प्रेडिक्शन एसिंक्रोनस होते हैं। स्टेटस starting से processing तक बदलता है और succeeded, failed या canceled पर खत्म होता है। यह छोटा Python हेल्पर सूची के किसी भी मॉडल के लिए काम करता है:
import os
import time
import requests

BASE = "https://api.picassoia.com/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['PICASSOIA_TOKEN']}"}

def run(model, payload, timeout=900):
    resp = requests.post(f"{BASE}/models/{model}/predictions",
                         headers=HEADERS, json={"input": payload})
    resp.raise_for_status()
    prediction = resp.json()
    deadline = time.time() + timeout
    while prediction["status"] in ("starting", "processing"):
        if time.time() > deadline:
            requests.post(f"{BASE}/predictions/{prediction['id']}/cancel",
                          headers=HEADERS)
            raise TimeoutError(prediction["id"])
        wait = (prediction.get("eta") or {}).get("next_poll_in_seconds", 3)
        time.sleep(wait)
        prediction = requests.get(f"{BASE}/predictions/{prediction['id']}",
                                  headers=HEADERS).json()
    if prediction["status"] != "succeeded":
        raise RuntimeError(prediction.get("error") or prediction["status"])
    return prediction["output"]

image = run("picassoia/picassoia-image",
            {"prompt": "a lighthouse at sunset, film photograph", "aspect_ratio": "16:9"})
clip = run("picassoia/picassoia-video",
           {"prompt": "slow dolly in on a lighthouse at dusk"})
चूँकि run मॉडल स्लग को एक आर्गुमेंट के रूप में लेता है, इमेज से वीडियो पर जाने का मतलब है एक अलग स्ट्रिंग और एक अलग पेलोड, बस इतना ही। यही यूनिफ़ाइड गेटवे का पूरा मकसद है, जो कॉलिंग कोड की कुछ लाइनों में दिखता है।
किसी जॉब को रोकने के लिए POST /v1/predictions/{id}/cancel भेजें। हाल के काम देखने के लिए GET /v1/predictions कॉल करें। जिन जॉब्स को यूज़र छोड़ चुका है, उन्हें टाइमआउट तक चलने देने के बजाय रद्द करें।
सीमा
मान
एक साथ चलने वाले प्रेडिक्शन
हर अकाउंट के लिए 5, सभी टोकन और MCP कनेक्शन में साझा
💡 शर्तें जाँच लें। API पेज बताता है कि प्रेडिक्शन में कोई क्रेडिट नहीं लगता और उन्हें बनाने के लिए Infinite प्लान चाहिए। प्लान बदलते रहते हैं, इसलिए किसी प्रोडक्ट को इस पर बनाने से पहले API पेज पर मौजूदा शब्दों की पुष्टि कर लें।
गेटवे के प्रकार की तुलना
हर गेटवे एक ही समस्या हल नहीं करता, और लेबल अक्सर धुंधले हो जाते हैं। उन्हें उनके काम के हिसाब से छाँटने से चुनाव आसान हो जाता है।
प्रकार
सबसे अच्छा किसके लिए
ट्रेड-ऑफ़
होस्टेड राउटर
कई टेक्स्ट मॉडल तक तेज़ पहुँच
ज़्यादातर टेक्स्ट, और आप एक ही वेंडर पर निर्भर रहते हैं
सेल्फ़-होस्टेड प्रॉक्सी
पूरा कंट्रोल और प्राइवेट नेटवर्क
इसे आप खुद चलाते, पैच करते और स्केल करते हैं
एज या क्लाउड गेटवे
मौजूदा कॉल के आगे कैशिंग, रेट लिमिट और लॉग
यह कंट्रोल जोड़ता है, नए मॉडल नहीं
अपने कैटलॉग वाला प्लेटफ़ॉर्म API
एक अकाउंट के तहत टेक्स्ट, इमेज और वीडियो
देखें कि API आज कौन-से मॉडल देता है
अगर आपका प्रोडक्ट सिर्फ़ टेक्स्ट का है और आपको पूरा कंट्रोल चाहिए, तो सेल्फ़-होस्टेड प्रॉक्सी एक सही विकल्प है। अगर आपका प्रोडक्ट तस्वीरों, क्लिप्स और टेक्स्ट को मिलाता है, तो बड़े कैटलॉग वाला प्लेटफ़ॉर्म API आपको तीन सिस्टम जोड़ने के झंझट से बचाता है। कई टीमें दो परतें इस्तेमाल करती हैं: जेनरेशन के लिए एक प्लेटफ़ॉर्म API, और अपने लॉगिंग व बजट जोड़ने वाला एक पतला इंटरनल रैपर।
किसी भी विकल्प पर प्रतिबद्ध होने से पहले पाँच सवाल पूछें:
यह आज कौन-से मीडिया प्रकार सपोर्ट करता है, और कौन-से सिर्फ़ रोडमैप पर हैं?
जब कोई मॉडल रिटायर होता है तो क्या होता है? एक अच्छा प्लेटफ़ॉर्म पहले से चेतावनी देता है और बदले के मॉडल की ओर इशारा करता है।
मेरे प्रॉम्प्ट और आउटपुट कहाँ रहते हैं, और कितने समय तक?
टोकन, टीम के साथियों और टूल्स के बीच लिमिट कैसे बँटती हैं?
क्या मैं छोड़ सकता हूँ? अगर आपका कोड सिर्फ़ एक पतले रैपर से बात करता है, तो किसी दूसरे गेटवे पर जाना एक वीकेंड का काम है, एक तिमाही का नहीं।
बचने वाली आम गलतियाँ
गेटवे बहुत सारी रुकावटें हटाता है, पर अच्छी आदतों की ज़रूरत फिर भी रहती है। ये तीन गलतियाँ बार-बार दिखती हैं।
हर जगह मॉडल के नाम हार्डकोड करना
अगर picassoia/picassoia-image बीस फ़ाइलों में दिखता है, तो आपने वही समस्या फिर से बना दी है जिसे हल करने के लिए गेटवे बना था। मॉडल स्लग को एक कॉन्फ़िग ऑब्जेक्ट में रखें, काम के हिसाब से समूहित करके: hero_image, product_clip, summary। फिर मॉडल अपग्रेड एक ही बदलाव होता है, और A/B टेस्ट के लिए बस एक और एंट्री जोड़नी होती है।
कंकरेंसी लिमिट को अनदेखा करना
पाँच एक साथ प्रेडिक्शन उदार लगते हैं, जब तक कोई बैच जॉब और एक लाइव यूज़र रिक्वेस्ट एक ही अकाउंट साझा न करें। इंटरैक्टिव ट्रैफ़िक के लिए क्षमता आरक्षित रखें, बल्क काम को कम सीमा वाली क्यू से चलाएँ, और किसी भी लिमिट एरर को तंग लूप में दोबारा कोशिश करने के बजाय रुकने का संकेत मानें।
टाइमआउट और रिट्राई छोड़ देना
लंबे जॉब आम वजहों से फ़ेल होते हैं: नेटवर्क की रुकावट, व्यस्त GPU, या कोई प्रॉम्प्ट जो सेफ़्टी फ़िल्टर को ट्रिगर कर दे। अपनी डेडलाइन प्लेटफ़ॉर्म के टाइमआउट से छोटी रखें, बैकऑफ़ के साथ एक बार रिट्राई करें, और दूसरी कोशिश फ़ेल होने पर यूज़र को साफ़ संदेश दिखाएँ। प्रेडिक्शन id को अपने लॉग में भी रखें, ताकि सपोर्ट किसी भी एक रिक्वेस्ट को शुरू से अंत तक ट्रेस कर सके।
आज ही अपनी पहली कॉल बनाएँ
किसी गेटवे को परखने का सबसे तेज़ तरीका है उससे एक असली रिक्वेस्ट चलाना। PicassoIA API पेज खोलें, एक टोकन बनाएँ, ऊपर दिया curl कमांड पेस्ट करें और देखें कि प्रेडिक्शन starting से succeeded तक कैसे बदलता है। फिर सिर्फ़ मॉडल स्लग बदलें और PicassoIA Video को एक वीडियो प्रॉम्प्ट भेजें। अगर दूसरी कॉल आपके प्लंबिंग को छुए बिना काम करती है, तो आपने यह विचार व्यवहार में देख लिया है।
कोड लिखने के लिए तैयार नहीं हैं? ब्राउज़र में Picasso IA खोलें, टेक्स्ट, इमेज या वीडियो कैटलॉग से कोई मॉडल चुनें और एक प्रॉम्प्ट लिखें। यही विचार Seedream 4.5 और Flux 2 Pro के साथ आज़माएँ, नतीजों को साथ-साथ तुलना करें, और देखें कि कौन-सा लुक आपके प्रोजेक्ट में फ़िट होता है। Picasso IA पर कुछ मिनट का प्रयोग किसी भी फ़ीचर लिस्ट से ज़्यादा बताएगा, तो आज ही जाएँ और अपनी तस्वीरें बनाएँ।