Os 6 melhores recursos que fazem o Seedance 2.0 se destacar na geração de vídeo com IA
O Seedance 2.0 da ByteDance não é apenas mais um modelo de vídeo com IA. Ele reúne síntese de áudio nativa, resolução 1080p, consistência temporal de quadros e alinhamento preciso entre texto e vídeo em uma única plataforma. Este artigo detalha os seis recursos que o diferenciam do restante do mercado.
O Seedance 2.0 chegou sem muito alarde, mas os resultados falam por si. A ByteDance lançou este modelo como um avanço significativo em relação às versões anteriores, e quem o testou a fundo notou as mesmas coisas: os quadros se mantêm coerentes, o movimento parece natural e a saída em 1080p é realmente utilizável. Este artigo detalha os seis recursos que realmente diferenciam o Seedance 2.0 de tudo o que está disponível hoje.
O que é o Seedance 2.0?
O Seedance 2.0 é o principal modelo de IA da ByteDance para texto para vídeo e imagem para vídeo. A atualização para a versão 2.0 não foi um simples ajuste. Ela reconstruiu elementos centrais da modelagem de movimento, da resolução de saída e da síntese de áudio, e o resultado parece qualitativamente diferente das versões anteriores.
Ele está em uma categoria competitiva, ao lado de modelos como o Kling v3, o Veo-3 e o Sora-2, mas o Seedance 2.0 adota uma abordagem diferente para vários problemas centrais. Ele não tenta vencer em todas as dimensões. Concentrou-se com força nas coisas que mais importam na produção de conteúdo de vídeo real: consistência, fidelidade de movimento, resolução, áudio e precisão do prompt. O resultado é um modelo que ganha seu lugar em qualquer fluxo de trabalho sério com vídeo por IA.
Recurso 1: consistência temporal que se mantém
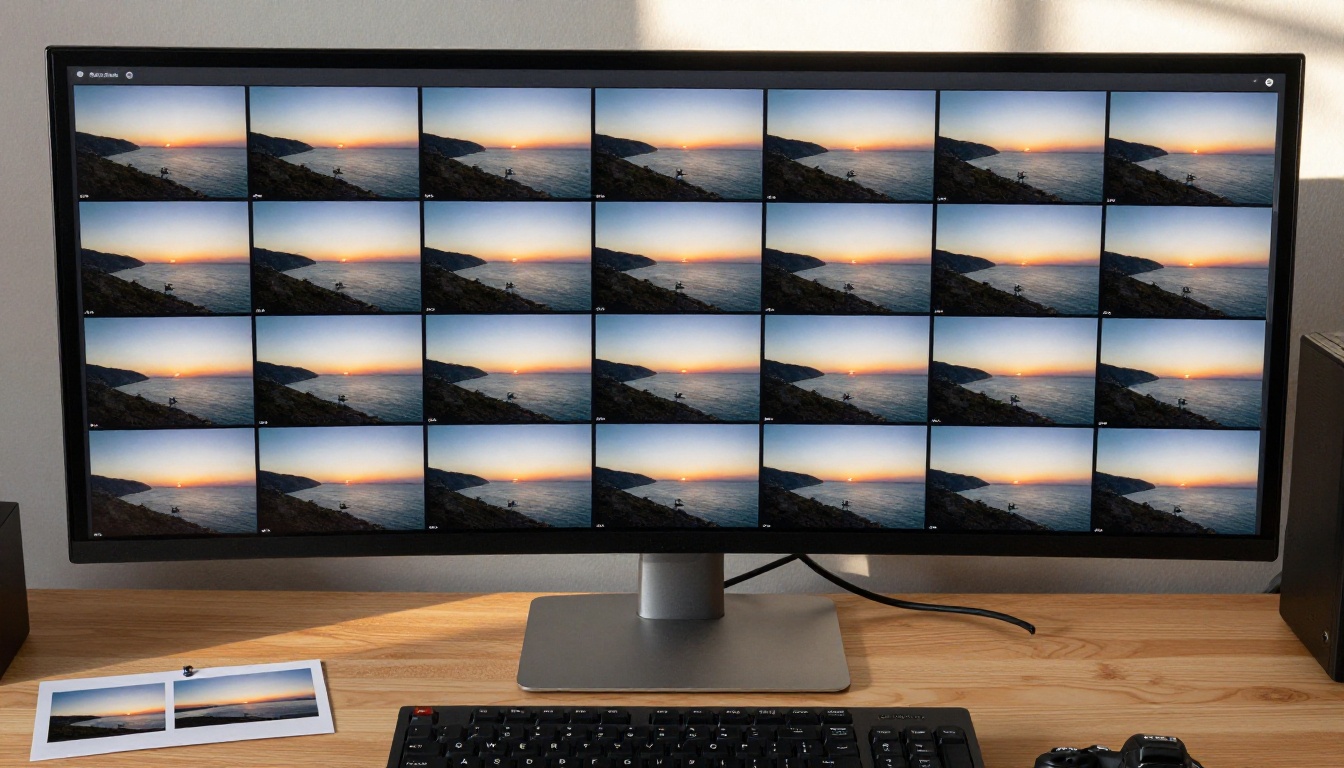
A maioria dos modelos de vídeo com IA enfrenta um problema fundamental: objetos, rostos e fundos mudam sutil ou drasticamente de quadro para quadro. A camiseta de um personagem muda de cor. Um rosto se deforma entre os cortes. Elementos do fundo tremulam. Esses artefatos quebram a imersão e tornam o material inutilizável para qualquer coisa profissional.
Por que a coerência entre quadros muda tudo
O Seedance 2.0 resolve isso no nível da arquitetura, e não apenas na camada de pós-processamento. O modelo acompanha a identidade dos objetos entre os quadros por meio de um mecanismo dedicado de atenção temporal. Quando um sujeito é estabelecido no primeiro quadro, o modelo mantém essa identidade durante toda a duração do clipe.
O resultado prático:
Os rostos permanecem consistentes em todos os quadros, sem artefatos de deformação
Os objetos mantêm cor, forma e textura durante as sequências de movimento
Os fundos não tremulam quando há um movimento sutil da câmera ou do sujeito
As condições de iluminação se mantêm sem mudanças artificiais entre quadros adjacentes
💡 A consistência temporal é o maior diferencial entre a saída amadora de vídeo com IA e um material de qualidade profissional. O Seedance 2.0 fecha essa lacuna de forma mais confiável do que a maioria dos modelos concorrentes nesta faixa.
Isso é especialmente perceptível em clipes mais longos. Enquanto outros modelos começam a se desviar depois da marca de três ou quatro segundos, o Seedance 2.0 mantém a integridade da identidade durante toda a duração disponível. Para criadores que trabalham com conteúdo para redes sociais, curtas-metragens ou material de marketing, essa confiabilidade por si só justifica o uso do modelo.
Recurso 2: qualidade de movimento em um novo nível
Existem dois modos de falha no movimento de vídeo com IA: rigidez e caos. O movimento rígido parece um slideshow com interpolação. O movimento caótico produz membros distorcidos, física impossível e objetos que se teletransportam em vez de se mover. Ambos destroem a qualidade percebida de qualquer saída.
Movimento natural sem erros de física
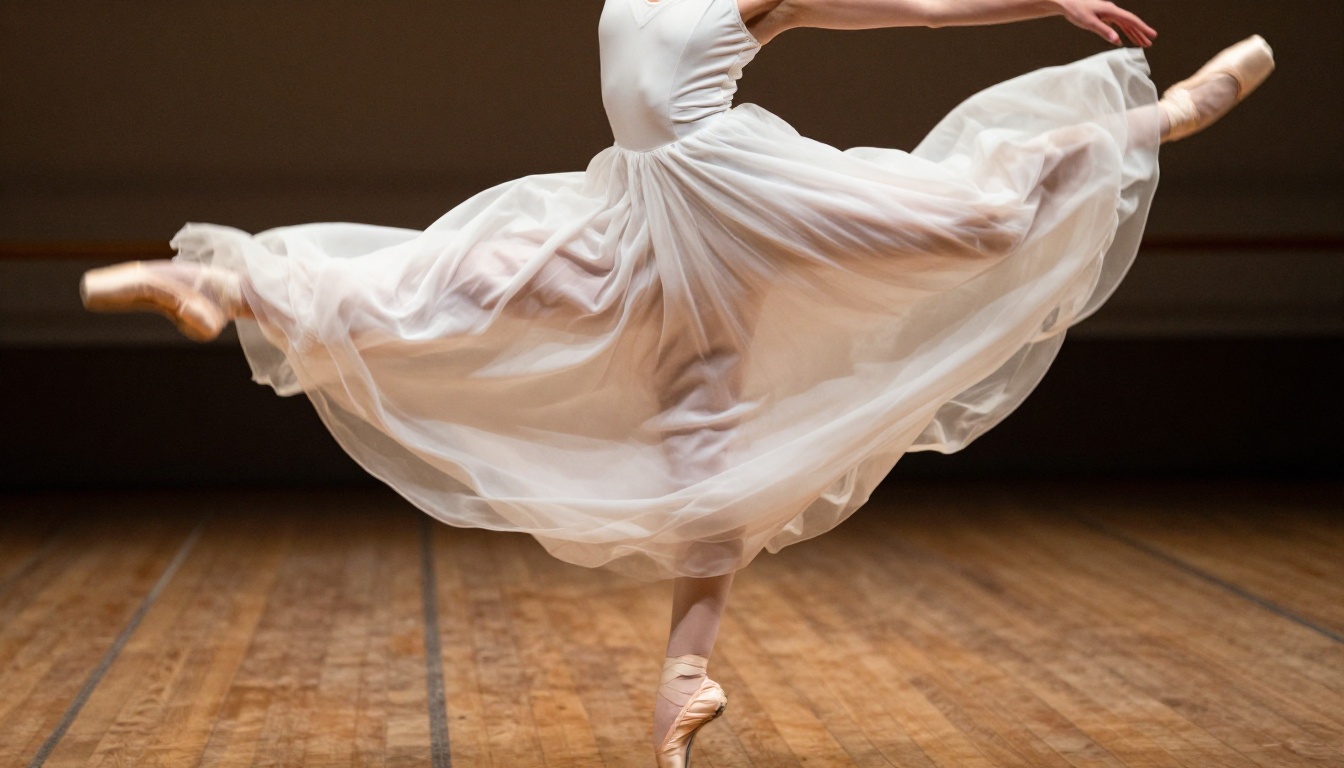
O Seedance 2.0 foi treinado com um volume de dados de movimento significativamente maior do que o de seu antecessor. O modelo entende como os corpos se movem, como o tecido cai e flui durante o movimento, como a água se comporta em diferentes condições e como o movimento da câmera interage com o paralaxe da cena.
As melhorias são mais visíveis em:
Tipo de movimento
Seedance 1.x
Seedance 2.0
Pessoa caminhando
Ocasionais artefatos nas pernas
Marcha fluida e natural
Cabelo e tecido
Estáticos ou rígidos
Dinâmicos, fisicamente plausíveis
Água e partículas
Em blocos, repetitivos
Padrões de fluxo orgânicos
Panorâmica da câmera
Leve distorção do fundo
Separação de paralaxe limpa
Movimento de mãos e dedos
Deformação comum
Articulação melhorada
Isso não significa que todo prompt gere uma saída perfeita. Interações complexas entre vários corpos ou close-ups extremos de mãos ainda apresentam alguma variação. Mas a qualidade de base para cenários de movimento padrão é significativamente superior ao que era possível com a série 1.x ou com muitos modelos concorrentes disponíveis atualmente.
Recurso 3: saída nativa em 1080p
A maioria dos modelos de vídeo com IA anteriores limitava a resolução nativa a 720p ou menos. Chegar a 1080p exigia uma etapa separada de upscaling com uma ferramenta de super-resolução, o que introduzia artefatos próprios e aumentava a latência do fluxo de trabalho.
1080p sem a sobrecarga do pós-processamento
O Seedance 2.0 gera nativamente em 1080p. Isso significa que textura, nitidez de bordas e detalhes finos são incorporados ao próprio processo de geração, e não interpolados depois. A diferença é visível:
Os detalhes faciais preservam a textura da pele, a separação dos cílios e a clareza das microexpressões
Os elementos do fundo permanecem nítidos mesmo em composições de grande angular
Textos e elementos gráficos na cena mantêm a legibilidade sem borrar
A fidelidade das bordas em objetos com formas complexas continua nítida durante todo o movimento
Isso importa para casos de uso práticos: conteúdo para redes sociais visto em telas modernas de alta densidade, material de marketing, vídeo educacional ou qualquer cenário em que a resolução degradada prejudique a credibilidade.
Usar o Seedance 2.0 nativamente significa pular a etapa de upscaling por completo. O arquivo de saída está pronto para publicação com qualidade próxima à de transmissão já na primeira geração, o que elimina uma etapa de produção significativa para quem trabalha em volume.
Recurso 4: alinhamento entre texto e vídeo que realmente funciona
A precisão do prompt é a variável mais frustrante em qualquer fluxo de trabalho de geração com IA. Você escreve um prompt detalhado e específico. O modelo produz algo que vagamente lembra suas palavras, mas deixa de lado a composição, a iluminação e os detalhes dos personagens que você especificou. Você itera. Você refaz o prompt. Você faz concessões.
Prompts que de fato são respeitados
O Seedance 2.0 demonstra um alinhamento semântico significativamente mais forte entre prompts escritos e a saída visual. A ByteDance alcançou isso por meio de:
Ancoragem semântica baseada em CLIP que liga os tokens do prompt a regiões visuais específicas
Atenção composicional que respeita as relações espaciais descritas no texto ("à esquerda de", "em primeiro plano", "atrás do sujeito")
Adesão a estilo e clima que preserva descritores de tom como "cinematográfico", "documental" ou "pouca luz"
Tratamento de múltiplos sujeitos que mantém sujeitos separados distintos quando vários personagens ou objetos são citados
💡 Uma dica prática: o Seedance 2.0 responde bem à linguagem de direção de câmera. Expressões como "aproximação lenta no sujeito", "tomada aérea de drone de cima" ou "troca de foco do primeiro plano para o fundo" produzem um comportamento de câmera perceptivelmente mais preciso do que descrições composicionais vagas.
Esse nível de aderência ao prompt reduz substancialmente os ciclos de iteração. Onde um fluxo de trabalho típico pode exigir de cinco a oito tentativas de geração para obter uma saída aceitável, o Seedance 2.0 frequentemente entrega resultados utilizáveis já na primeira ou na segunda tentativa. Para criadores que trabalham com prazos ou orçamentos apertados, essa eficiência é um ganho operacional real.
Recurso 5: modo duplo com variantes Standard e Fast
O tempo de processamento é um custo real. Quando se produz conteúdo em volume ou se itera rapidamente durante a exploração criativa, esperar minutos por geração quebra o ritmo. Ao mesmo tempo, alguns casos de uso exigem qualidade máxima, independentemente do tempo.
Standard ou Fast: quando usar cada um
O Seedance 2.0 é disponibilizado em duas variantes distintas: o Seedance 2.0 padrão e o Seedance 2.0 Fast. Essa é uma decisão de produto bem pensada, e não apenas um nível de desempenho:
Latência significativamente reduzida com perda mínima de qualidade
Melhor para ideação rápida, testes A/B de conceitos e storyboards
Preserva a maior parte das características de qualidade em uma fração do tempo de espera
Essa abordagem de dois níveis também é oferecida, de maneira própria, por modelos como o WAN 2.6 e o Hailuo 2.3, mas a retenção de qualidade na Seedance 2.0 Fast é particularmente forte. A variante Fast não parece uma versão enxuta feita às pressas. Parece o mesmo modelo rodando com um orçamento de recursos diferente, que é exatamente o que um sistema de dois modos deve entregar.
Recurso 6: geração de áudio nativa
Este é o recurso que realmente separa o Seedance 2.0 da maioria das alternativas. Historicamente, o áudio em vídeo com IA foi tratado como um detalhe deixado para depois: saída sem som, depois adicionar o áudio em pós-produção separadamente, ou depender de um modelo de áudio secundário para gerar sons ambientes. Nenhuma das abordagens produz um áudio que combine de fato com o conteúdo visual.
Som que combina com o que você vê
O Seedance 2.0 foi construído com síntese de áudio nativa integrada ao pipeline de geração. O modelo não trata o áudio como uma faixa separada a ser anexada. Ele gera um áudio que é sincronizado semanticamente e no tempo com o conteúdo visual.
Isso produz:
Paisagens sonoras ambientes que combinam com o ambiente (sons de floresta em imagens de floresta, ruído de multidão em cenas povoadas)
Áudio específico de objetos sincronizado com as ações na tela (passos no ritmo do caminhar, sons de água combinando com o comportamento visual da água)
Aproximação de voz e fala quando os personagens estão visivelmente falando, embora a fidelidade total de sincronização labial varie conforme a complexidade da cena
Resposta a música e ritmo quando o prompt especifica um contexto musical
💡 O áudio nativo é especialmente poderoso para conteúdo de redes sociais, onde a maioria dos espectadores assiste a vídeos com o som ligado. Ter um áudio que combine com a cena elimina uma camada inteira de produção do seu fluxo de trabalho e gera uma saída que parece completa já na primeira geração.
Nenhum outro recurso da atualização 2.0 tem um efeito tão dramático na utilidade da saída. Um vídeo com áudio ambiente sincronizado com precisão parece profissional. Um vídeo mudo, ou um com áudio de sobreposição genérica, parece improvisado. O Seedance 2.0 resolve isso sem exigir uma ferramenta separada.
Como usar o Seedance 2.0 no PicassoIA
O Seedance 2.0 está disponível diretamente no PicassoIA, sem nenhuma configuração necessária. Veja como obter a melhor saída do modelo:
Fluxo de trabalho passo a passo
Passo 1: escolha o modo de entrada.
O Seedance 2.0 oferece suporte a texto para vídeo e a imagem para vídeo. Se você tiver uma referência visual específica, use o modo imagem para vídeo. Seu quadro inicial ancorará a consistência temporal em todo o clipe, o que produz uma coerência ainda maior do que a geração apenas com texto.
Passo 2: escreva um prompt estruturado.
O modelo responde bem a este formato:
Exemplo: "Uma mulher de vestido branco caminha por um campo de lavanda na hora dourada, aproximação lenta por trás, som ambiente de vento suave, cinematográfico."
Passo 3: selecione Standard ou Fast.
Para explorar conceitos e iterar, use o Seedance 2.0 Fast. Para a saída final, use o Seedance 2.0 Standard. Não rode o Standard em todas as iterações. Reserve-o para quando você tiver um prompt em que confia.
Passo 4: especifique a intenção de áudio no seu prompt.
Como o áudio é nativo, incluir descritores de áudio influencia diretamente o que o modelo gera. Adicione expressões como "ruído ambiente de cidade", "atmosfera tranquila em ambiente interno" ou "ondas do mar quebrando" para orientar a camada de áudio independentemente da descrição visual.
Passo 5: revise e itere com precisão.
Se a primeira geração errar algo específico, identifique o elemento com problema e ajuste a parte correspondente do prompt. Edições cirúrgicas produzem ajustes mais previsíveis do que reescritas completas.
Dicas de parâmetros
Parâmetro
Recomendação
Duração
Comece com clipes de 5 segundos para validar o conceito
Resolução
Use 1080p para a saída final e 720p para iteração rápida
Seed
Defina uma seed fixa ao iterar para isolar mudanças de variáveis do prompt
Áudio
Sempre inclua descritores de contexto de áudio para melhores resultados
Como ele se compara aos concorrentes
O Seedance 2.0 não ocupa todos os cantos do mercado de vídeo com IA, mas cobre os mais importantes. Para criadores que precisam de consistência temporal confiável, forte fidelidade de movimento, 1080p nativo, aderência precisa ao prompt, flexibilidade de fluxo de trabalho pelos dois modos e áudio integrado, ele é uma das soluções mais completas em um único modelo disponíveis.
Comparando-o com o cenário atual:
Veo-3 se destaca na qualidade de produção cinematográfica, mas gera mais lentamente e sem uma variante rápida dedicada
Kling v3 oferece excelentes recursos de controle de movimento, mas o áudio não é gerado nativamente no pipeline
Sora-2 produz uma saída impressionante de uso geral, mas opera com outras estruturas de velocidade e custo
Hailuo 2.3 compete de perto na qualidade de movimento, mas a integração de áudio não é tão fortemente acoplada à geração visual
Para a maioria dos fluxos de trabalho práticos de conteúdo, o Seedance 2.0 oferece o melhor equilíbrio entre as seis dimensões abordadas neste artigo. Não é o único modelo que vale a pena usar. Mas é aquele que exige menos concessões quando você precisa que todas as seis capacidades funcionem bem ao mesmo tempo.
Comece a criar seus próprios vídeos
Os seis recursos acima não são capacidades teóricas. São características observáveis e repetíveis que aparecem em saídas reais. Consistência temporal, qualidade de movimento, saída nativa em 1080p, forte alinhamento entre texto e vídeo, um fluxo de dois níveis com as variantes Standard e Fast e síntese de áudio nativa, juntos, tornam o Seedance 2.0 um dos modelos de vídeo com IA mais completos atualmente acessíveis a criadores de qualquer nível.
A melhor forma de comprovar isso é testar. O PicassoIA dá acesso direto ao Seedance 2.0 e ao Seedance 2.0 Fast sem nenhuma configuração adicional. Comece com um prompt de texto simples descrevendo uma cena que você tem em mente, adicione um descritor de contexto de áudio e veja o que o modelo produz na primeira geração.
Seja você alguém que produz conteúdo para redes sociais, curtas-metragens, material de marketing ou que está experimentando vídeo com IA pela primeira vez, o Seedance 2.0 oferece um ponto de partida confiável e de alta qualidade, que reduz a distância entre sua intenção criativa e a saída final. Os ciclos de iteração são mais curtos. O piso de qualidade é mais alto. O áudio já está presente desde o início. Essa combinação é o que faz deste modelo algo que vale a pena usar.