كان توظيف متحدث يعني في السابق إجراء اختبارات أداء، وحجز استوديو، وتجهيز جهاز التلقين، وإعداد الإضاءة، وجولات متعددة من المونتاج قبل أن يصبح لديك شيء صالح للاستخدام. أما اليوم، فيمكنك تجاوز كل هذه الخطوات. مع أدوات مزامنة الشفاه الحديثة بالذكاء الاصطناعي، ترفع صورة، وتكتب نصك، وتحصل على مقدّم متحرك يتكلم بالكامل، مع حركات شفاه متزامنة، وحركة طبيعية للرأس، وصوت يبدو وكأنه مسجّل في جلسة تسجيل حقيقية.
هذه ليست خدعة. فالعلامات التجارية تستخدم المتحدثين بالذكاء الاصطناعي في عروض المنتجات، وفيديوهات التعريف بالموظفين الجدد، والحملات متعددة اللغات، والإعلانات الاجتماعية. ويبني صنّاع المحتوى المستقلون قنوات كاملة دون الظهور أمام الكاميرا. وتستبدل متاجر التجارة الإلكترونية صفحات المنتجات الثابتة بعروض فيديو تحقق مبيعات فعلية. تجاوزت التقنية منذ فترة عتبة "جيدة بما يكفي". وهي الآن تقف بثبات عند مستوى "مثير للإعجاب حقًا"، والفجوة بين المقدّمين بالذكاء الاصطناعي والمقدّمين البشر تضيق أسرع مما يتوقع معظم الناس.
ما هو المتحدث بالذكاء الاصطناعي فعليًا
إنه ليس صورة رمزية، بل مقدّم حقيقي
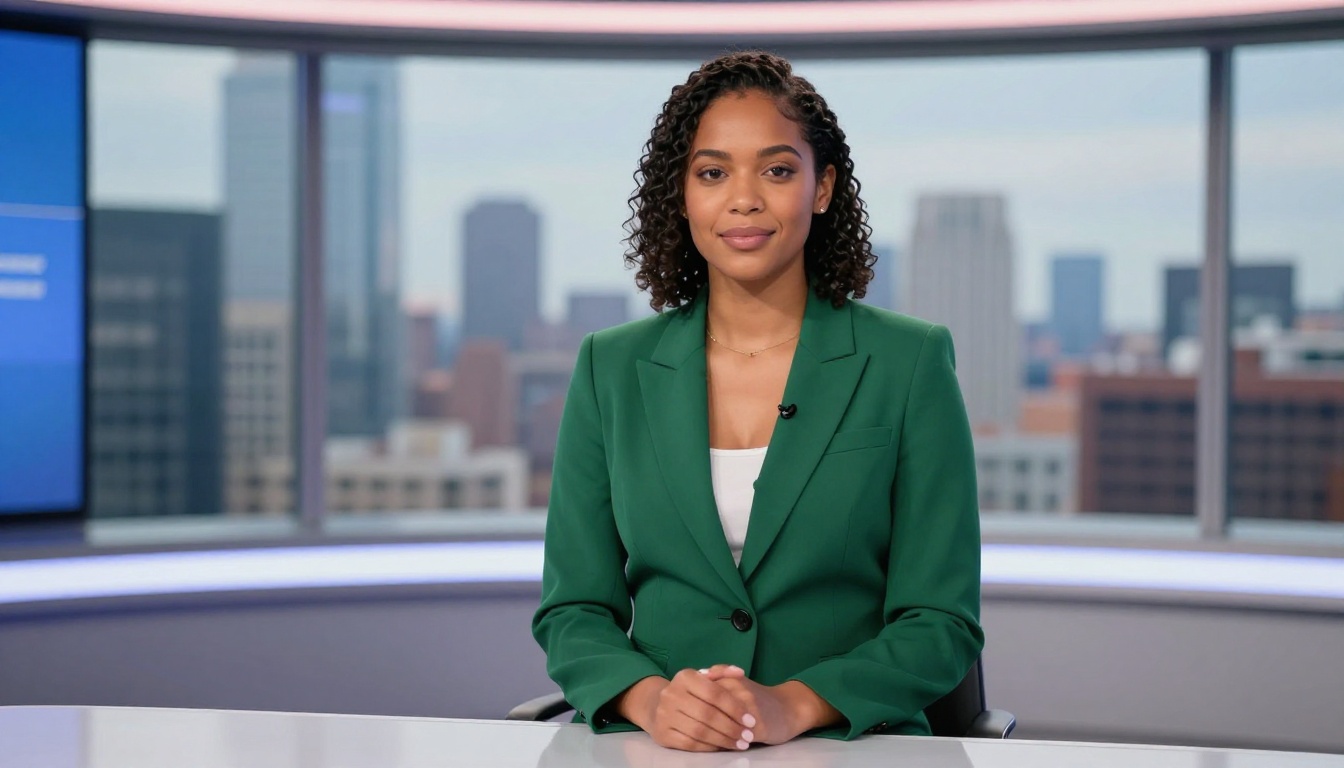
هناك فرق جوهري بين صورة كرتونية رمزية تومئ على إيقاع الصوت، والمتحدث الحقيقي بالذكاء الاصطناعي. يستخدم المتحدث الحقيقي بالذكاء الاصطناعي تقنية مزامنة الشفاه لتحريك وجه بشري، مأخوذ من صورة أو مقطع فيديو قصير، بحيث تتحرك الفم والفك والعضلات المحيطة بالوجه بدقة متزامنة مع نص منطوق. والنتيجة تبدو كشخص حقيقي يتحدث، لا كدمية تُحرَّك إطارًا بإطار.
تقوم التقنية الأساسية على نماذج تحريك الوجه المدفوعة بالصوت. يقرأ الذكاء الاصطناعي الموجة الصوتية على مستوى الفونيمات، ثم يولّد حركات دقيقة للوجه، وإن كانت خفيفة: أشكال الشفاه، وفتحات الفك، والتعابير الدقيقة، ورمشات العين، والانجراف الطبيعي للرأس، بما يطابق ما يُنتجه متحدث حقيقي. وتوسّع أكثر النماذج تقدمًا ذلك ليشمل حركة الجسم العلوي كاملة، بما في ذلك حركة الكتفين وإيقاع التنفس.
الأشياء الثلاثة التي تحتاجها فعليًا
لإنشاء متحدث افتراضي بالذكاء الاصطناعي، تحتاج إلى ثلاثة أشياء فقط:
- صورة وجه أو مقطع فيديو قصير: تعمل صورة شخصية واضحة بشكل مثالي
- نص أو ملف صوتي: اكتب نصًا وولّد صوتًا، أو ارفع تسجيلك الصوتي الخاص
- نموذج مزامنة شفاه بالذكاء الاصطناعي: المحرك الذي يتولى عملية التحريك
لا كاميرا. لا استوديو. لا معدات إضاءة. لا عقد مع موهوب. تم ضغط مجموعة أدوات الإنتاج بأكملها داخل نافذة متصفح.
لماذا يتفوق الذكاء الاصطناعي على توظيف مقدّم حقيقي
الأرقام يصعب الجدال فيها
| العامل | مقدّم بشري | متحدث بالذكاء الاصطناعي |
|---|
| وقت الإنتاج | من 3 إلى 7 أيام | من 5 إلى 15 دقيقة |
| التكلفة لكل فيديو | من 500 إلى 5,000 دولار فأكثر | قريبة من الصفر |
| المراجعات | تتطلب إعادة تصوير | إعادة توليد فورية |
| اللغات | تتطلب إعادة تسجيل لكل لغة | أي لغة، بالوجه نفسه |
| الاتساق بين الفيديوهات | يختلف حسب الجلسة | متسق 100% |
| الإنتاجات المتزامنة | واحدة في كل مرة | غير محدودة بالتوازي |
توفير التكلفة والوقت واضح بمجرد رؤيتهما جنبًا إلى جنب. لكن الميزة الأهم هي سرعة التكرار. يمكنك تجربة خمسة نصوص مختلفة، وعشرة أساليب صوتية، وثلاثة عروض بصرية مختلفة قبل الغداء، ثم تختار النسخة التي تنجح فعلًا قبل إنفاق أي دولار على التوزيع.
أين يُحدث الفرق الأكبر
تقدّم المتحدثات والمتحدثون بالذكاء الاصطناعي أوضح ميزاتهم في سيناريوهات إنتاج محددة:
- فيديوهات منتجات التجارة الإلكترونية: استبدل متحدثًا جديدًا في كل حملة موسمية دون إعادة تصوير
- الدورات والدروس الإلكترونية: سجّل مرة واحدة، وحدّث النص لاحقًا دون الحاجة إلى أي شخص أمام الكاميرا
- الحملات متعددة اللغات: وجه مقدّم واحد، مع دبلجة بأكثر من 40 لغة ومزامنة شفاه دقيقة على مستوى الإطار
- المحتوى الإعلاني لوسائل التواصل الاجتماعي: اختبر عشرات الصيغ النصية مع عبارات جذب مختلفة في الفترة نفسها من بعد الظهر
- التواصل الداخلي: إعلانات على مستوى الشركة تبدو شخصية دون الحاجة إلى وقت المسؤولين التنفيذيين
- عروض العقارات وبرمجيات SaaS: فيديوهات جولة لكل عقار أو ميزة دون فريق فيديو
💡 المجال الأمثل هو أي محتوى يجب أن يبدو إنسانيًا لكنه يتغير بشكل متكرر. يقلّص المتحدثون بالذكاء الاصطناعي تكلفة تلك الدورة ووقت إنتاجها إلى أدنى حد.
أفضل نماذج الذكاء الاصطناعي لهذه المهمة
مشهد يتحرك بسرعة
ليست كل أدوات مزامنة الشفاه تنتج النتائج نفسها. بعضها مُحسَّن للسرعة، وبعضها يعطي الأولوية للدقة على مستوى الإطار لأغراض البث. بعضها يتعامل مع الحركة الكاملة للجسم، وبعضها يتفوق تحديدًا في الصور الشخصية. فيما يلي ما صُممت له كل نموذج من أفضل النماذج فعليًا.
P Video Avatar من أكثر مولّدات الصور الرمزية المتحدثة تنوعًا المتاحة. تزوّده بصورة شخصية وملف صوتي، فيعيد فيديو بحركة رأس طبيعية، ورمشات عين واقعية، ومزامنة شفاه محكمة. جودة المخرجات قوية لمحتوى التسويق والإعلانات الاجتماعية وعروض المنتجات، ويتعامل بثبات مع مجموعة واسعة من أنماط الصور الشخصية.
Omni Human 1.5 من ByteDance يمثّل خطوة كبيرة إلى الأمام في واقعية المتحدث. فبالإضافة إلى تحريك الوجه، يولّد حركة كاملة للجسم العلوي متزامنة مع الصوت، بحيث يتحرك المقدّم بشكل طبيعي من الجذع إلى الأعلى. حركة الكتفين، وإيقاع التنفس، وإيماءات اليد الخفيفة: كل ذلك يسهم في حضور يبدو إنسانيًا حقًا. هذا هو النموذج المناسب للمحتوى التعليمي، والشروحات الطويلة، وأي سياق يشاهد فيه المتابع أكثر من 60 ثانية.
Omni Human (الإصدار من الجيل الأول) يبقى خيارًا قويًا وموثوقًا عندما تحتاج إلى نتائج سريعة مع دقة جيدة في الشفاه. مناسب للنماذج الأولية السريعة قبل الالتزام بالنموذج النهائي.
Fabric 1.0 من VEED متخصص في جعل الصور تتكلم بمظهر نظيف ومصقول. مُحسَّن لمخرجات جاهزة للتسويق، ويتعامل بشكل خاص جيدًا مع الصور الشخصية في الاستوديوهات الاحترافية. ويُعد اتساق الألوان ولون البشرة عبر الإطارات قويًا بشكل ملحوظ.
React 1 من Sync يركز على تطبيق مزامنة شفاه واقعية على لقطات فيديو موجودة. إذا كان لديك فيديو لشخص يتكلم وتحتاج إلى إعادة دبلجته بمسار صوتي جديد، يحافظ React 1 على تحريك الوجه مقنعًا، ويتجنب مشكلات التشوهات الشائعة في البدائل الأرخص.
Lipsync 2 Pro من Sync هو أداة الدقة في هذه الفئة. وهو أبطأ من معظم الخيارات، لكن حركة الشفاه التي ينتجها على مستوى الإطار هي المعيار لأعمال بجودة البث. بالنسبة للنصوص التي تحتوي على مفردات تقنية، أو كلام سريع، أو أنماط فونيمات غير معتادة، يتعامل الإصدار Pro مع الحالات الخاصة التي تفوّتها نماذج أخرى.
Lipsync 2 هو الإصدار القياسي، ويوفّر توازنًا قويًا بين الجودة وسرعة المعالجة. وهو الخيار الافتراضي المناسب عندما تحتاج إلى نتائج موثوقة دون الكلفة الإضافية لمستوى Pro.
Lipsync Speed من HeyGen مصمم للحجم الكبير. عندما تحتاج إلى توليد 30 أو 50 فيديو منتج في جلسة واحدة، يقدّم هذا النموذج نتائج سريعة دون مشكلات في الاتساق. إنه خيار خط الإنتاج.
Lipsync Precision من HeyGen يستغرق وقتًا أطول، لكنه يُنتج مزامنة أحكم بشكل ملحوظ على تسلسلات الفونيمات المعقدة. بالنسبة للمواضع عالية الظهور التي سيدقق فيها المشاهدون في جودة المزامنة، يستحق هذا الوقت الإضافي للمعالجة.
Kling Lip Sync من Kwai يعمل بشكل جيد بخاصة على المقاطع الأطول التي يكون فيها الاتساق عبر مدة الفيديو كاملة مهمًا. تفقد نماذج كثيرة دقتها قليلًا بعد علامة 60 ثانية. يحافظ Kling على التماسك بشكل جيد في المخرجات التي تصل إلى 2 إلى 3 دقائق.
Video Translate من HeyGen يستحق ذكرًا خاصًا. إذا كان سير عملك يتضمن أخذ فيديو إنجليزي موجود ونشره بالإسبانية أو الفرنسية أو البرتغالية، أو بأكثر من 140 لغة إضافية، مع متحدث تتطابق شفاهه تمامًا مع الصوت المدبلج، فهذه هي الأداة المصممة تحديدًا لهذه الحالة.
كيف تنشئ متحدثك على PicassoIA
شرح خطوة بخطوة
يستخدم سير العمل التالي P Video Avatar كأداة أساسية. وتنطبق المبادئ نفسها على أي نموذج لمزامنة الشفاه متاح على المنصة.
الخطوة 1: جهّز صورتك الشخصية
استخدم صورة شخصية واضحة من الأمام، بإضاءة متساوية وخلفية بسيطة. يجب أن يكون الوجه ظاهرًا بالكامل دون عوائق، ودون إكسسوارات تحجب الفم، ودون زوايا متطرفة. الخلفية البيضاء أو المحايدة تعطي أنظف النتائج، رغم أن الخلفيات المعقدة قابلة للتعامل معها في معظم النماذج. الحد الأدنى للدقة: 512x512 بكسل. صيغة JPEG أو PNG، وكلاهما مناسب.
الخطوة 2: اكتب نصًا مختصرًا وحواريًا
اجعل نسختك الأولى قصيرة، بين 30 و60 ثانية. هذا يتيح لك تقييم جودة المخرجات بسرعة قبل الالتزام بإنتاج أطول. اكتب بأسلوب حواري. جمل قصيرة. وقفات طبيعية مدمجة. يتولى الذكاء الاصطناعي الإيقاع والتنفس تلقائيًا، لكنه يتبع الإشارات الموجودة في الصوت، لذلك تُنتج النصوص الكثيفة أو المتصلة دون توقف نتائج أقل طبيعية.
الخطوة 3: ولّد صوتك أو سجّله
أمامك مساران. الخيار الأول: اكتب نصك، والصقه في أحد نماذج Text to Speech على PicassoIA، وجرّب عدة أساليب صوتية، ثم صدّر ملف الصوت الذي يناسب نبرة علامتك التجارية بأفضل شكل. الخيار الثاني: سجّل صوتك بنفسك في غرفة هادئة، وهذا غالبًا ما ينتج أكثر مزامنة شفاه طبيعية لأن توقيت الصوت بشري حقًا. كلا الخيارين يعمل جيدًا. ويتألق خيار الصوت المسجّل عادة في الإنتاجات الأطول.
الخطوة 4: ارفع واضبط الإعدادات على PicassoIA
انتقل إلى صفحة نموذج P Video Avatar. ارفع صورتك الشخصية وملف الصوت. اضبط إعدادات شدة التعبير إن كانت متوفرة. إعداد تعبير مرتفع قليلًا يمنع المظهر المسطح والفارغ الذي تنتجه بعض النماذج غير المعالجة بشكل كافٍ. ثم أرسل مهمة التوليد.
الخطوة 5: راجع وكرّر
حمّل المخرجات وشاهدها بسرعة التشغيل الكاملة، لا بالحركة البطيئة. تحقّق من دقة المزامنة تحديدًا عند الانتقال بين الكلمات، وعند تسلسلات الفونيمات الغنية بالحروف الساكنة مثل أصوات "p" و"b" و"m"، وهي الأصعب على النماذج. إذا بدا أي شيء غير سليم قليلًا، فجرّب قصّ صورة شخصية مختلفة، أو عالج الصوت لإزالة أي صمت في البداية. معظم المشكلات تُحل خلال تكرارين.
💡 للحصول على أفضل النتائج على أي نموذج، سجّل الصوت أو صدّره في بيئة هادئة خالية من ضوضاء الخلفية. يعمل النموذج بشكل أفضل عندما يكون توقيت الفونيمات نظيفًا وواضحًا.
الوصول إلى جودة البث
عندما تكون الجودة مهمة على أعلى مستوى، اجمع الأدوات بالتسلسل. استخدم Lipsync 2 Pro للحصول على مزامنة دقيقة على مستوى الإطار في التوليد الأولي، ثم مرّر المخرجات عبر أحد نماذج تحسين الفيديو بالذكاء الاصطناعي على PicassoIA لرفع دقة الفيديو النهائي إلى 4K. هذا المزيج ينتج نتيجة تصمد عند العرض بملء الشاشة على أي شاشة.
اختيار الصوت المناسب
الصوت نصف الأداء
حتى الحركة المثالية تقنيًا لمزامنة الشفاه تبدو باهتة مع الصوت الخاطئ. فالصوت يحدد كيف يُنظر إلى المتحدث: هل يبدو واثقًا أم متردّدًا، مرجعيًا أم قريبًا، رسميًا أم غير رسمي. خصص وقتًا حقيقيًا لهذا القرار قبل توليد الفيديو النهائي.
تمنحك نماذج Text to Speech على PicassoIA وصولًا إلى مجموعة واسعة من الأساليب الصوتية واللهجات والنبرات. جرّب ثلاثة إلى خمسة أصوات مختلفة على نصك الفعلي على الأقل قبل الاختيار. فالفروق الصغيرة في الإيقاع والتمبر وسرعة النطق تخلق انطباعات مختلفة جدًا لدى الجمهور.
اعتبارات اللهجات والنطق الإقليمي
إذا كنت تستهدف جمهورًا إقليميًا محددًا، فإن اللهجة تهم أكثر مما يعترف به معظم المسوّقين. فالجمهور الناطق بالإسبانية في المكسيك يستجيب بشكل مختلف للإسبانية القشتالية عنه للإسبانية المكسيكية. ينطبق المنطق نفسه على البرتغالية البرازيلية مقابل الأوروبية، أو الإنجليزية الكندية مقابل البريطانية. استخدم Video Translate عندما تحتاج إلى نشر وجه المتحدث نفسه عبر أسواق إقليمية متعددة دون إعادة تسجيل كل شيء من الصفر.
حالات استخدام واقعية تنجح
التجارة الإلكترونية على نطاق واسع
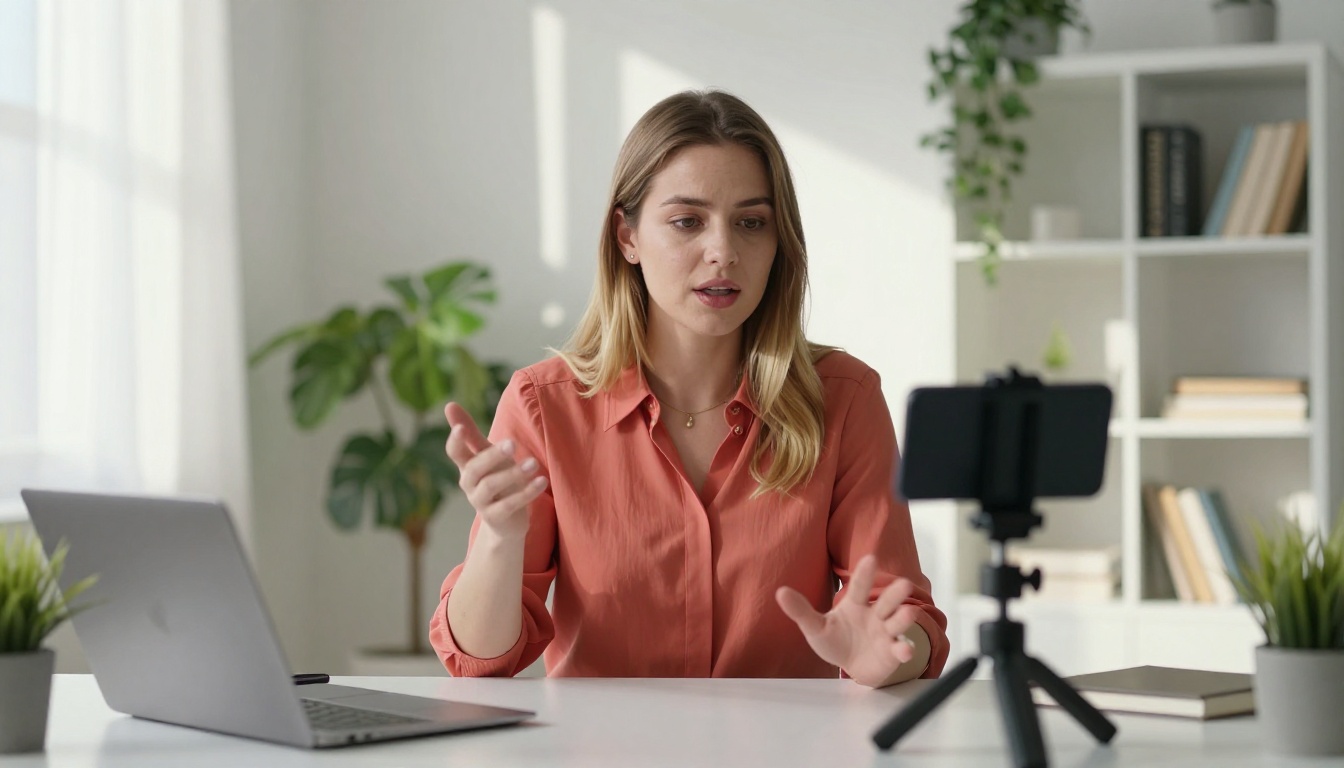
صورة منتج ثابتة مع قائمة نقاط تتنافس مع كل صورة منتج ثابتة أخرى على الصفحة. أما الفيديو الذي يشرح فيه شخص المنتج خلال 45 ثانية فلا يواجه مشكلة المنافسة نفسها. فرق معدل التحويل بين فيديو يقدّمه شخص والنص مع الصورة موثّق جيدًا. يجعل المتحدثون بالذكاء الاصطناعي هذا الشكل في متناول كل منتج في الكتالوج، لا المنتج الرئيسي فقط.
الدورات التعليمية الإلكترونية ومحتوى التدريب
يفضّل بعض المدرّبين عدم الظهور أمام الكاميرا، أو يريدون الحفاظ على هوية بصرية متسقة عبر جميع وحدات الدورة بغض النظر عن وقت تسجيلها، فيستخدمون متحدثين بالذكاء الاصطناعي لتقديم كل درس. يسجّل المدرّب صوته الخاص، ويحرّك الذكاء الاصطناعي الوجه المختار، وتبدو الدورة النهائية متماسكة واحترافية دون عناء الإنتاج أمام الكاميرا. وتحديث الوحدة لا يتطلب سوى ملف صوتي جديد.
التواصل المؤسسي
تستخدم فرق الموارد البشرية المتحدثين بالذكاء الاصطناعي في فيديوهات التعريف بالموظفين الجدد، وتدريبات الامتثال، وإحاطات السلامة، وإعلانات تحديث السياسات. يبقى المتحدث متسقًا بصريًا عبر كل فيديو، وعرض العلامة التجارية مضبوط، والتحديثات لا تتطلب سوى تغيير في النص وإعادة توليد. لا تنسيق مع المسؤولين التنفيذيين، ولا حجز استوديوهات، ولا طابور مونتاج.
الحملات متعددة اللغات
سير العمل بسيط: أنتج فيديو واحدًا بلغتك الأساسية، وترجم النص، وولّد صوتًا مدبلجًا لكل لغة مستهدفة، ثم استخدم Video Translate أو Lipsync Precision لمزامنة الشفاه في كل نسخة. أصل إبداعي واحد يتحول إلى عشرة إصدارات إقليمية بجهد إضافي ضئيل.
أخطاء شائعة تُفسد الواقعية
ما الذي يسوء في أغلب الأحيان
تشترك معظم فيديوهات المتحدثين بالذكاء الاصطناعي الفاشلة في عدد قليل من المشكلات نفسها:
- صورة مصدر منخفضة الجودة: الصور الشخصية الضبابية، أو الزوايا الجانبية، أو الصور المُعدّلة بكثافة تنتج تحريكًا ضعيفًا للشفاه. استخدم صورة حادة من الأمام بإضاءة طبيعية متساوية.
- صوت مشوّش أو غير متسق: الهسهسة الخلفية، أو صدى الغرفة، أو ارتفاعات مفاجئة في الصوت تسبب أخطاء مزامنة على مستوى الإطار. الصوت النظيف هو المتغير الأكثر تأثيرًا في الجودة.
- نص يبدو كأنه مكتوب: النصوص المكتوبة بلغة رسمية تنتج نتائج جامدة وغير طبيعية. اكتب بالطريقة التي يتحدث بها الشخص الواثق فعليًا، بإيقاع طبيعي وجمل قصيرة.
- تخطي الاختبار القصير: ولّد نسخة مدتها 30 ثانية قبل الالتزام بإنتاج مدته 5 دقائق. اكتشف المشكلات مبكرًا.
- إعدادات تعبير مسطحة: نماذج مثل Omni Human 1.5 وP Video Avatar تملك أدوات التحكم في شدة التعبير. الإعداد المحايد ينتج مظهرًا فارغًا وغير مهتم. ارفعه قليلًا للحصول على تفاعل عاطفي طبيعي.
تجنّب وادي الغرابة
وادي الغرابة (Uncanny Valley) مصدر قلق حقيقي، لكنه ينتج في الغالب عن أعطال تقنية محددة لا عن التقنية نفسها: اختلاف لون البشرة بين الوجه والرقبة في المخرجات، أو أسنان تبدو مسطحة أو ثابتة، أو عيون تحدّق بثبات دون رمشات طبيعية. تتعامل معظم نماذج مزامنة الشفاه الحديثة مع الرمش والتعابير الدقيقة تلقائيًا. وإذا بدا الناتج لا يزال غريبًا، فإن التحول إلى نموذج يملك حركة كاملة للجسم العلوي، مثل Omni Human 1.5، يحل الانفصال في معظم الحالات. فحركة الجسم الكاملة تمنح السياق البصري الذي يحتاجه الدماغ لقراءة الصورة على أنها إنسان.
أنشئ أول فيديو لك اليوم
لم يعد عائق الإنتاج لفيديو متحدث احترافي موجودًا. صورة شخصية واضحة، ونص مدته 60 ثانية، ووصول إلى PicassoIA هي كل ما تحتاجه لإنهاء فيديو جاهز اليوم، دون استوديو أو كاميرا أو ميزانية أجور المؤدّين.
ابدأ بـ P Video Avatar للحصول على نتيجة أولى سريعة. انتقل إلى Omni Human 1.5 عندما تريد واقعية كاملة للجسم العلوي في المحتوى الأطول. استخدم Lipsync 2 Pro عندما تكون الدقة مهمة للبث أو للمواضع عالية الظهور. ادمج كل ذلك مع صوت مختار بعناية من نماذج Text to Speech، واستخدم Video Translate عندما تكون مستعدًا لتوسيع الأصل نفسه عبر اللغات.
المتحدث الذي تحتاجه علامتك التجارية موجود بالفعل. كل ما تحتاجه هو تقديم النص.
ابدأ الإنشاء على PicassoIA


