स्पोक्सपर्सन रखने का मतलब पहले कास्टिंग कॉल, स्टूडियो बुकिंग, टेलीप्रॉम्प्टर सेटअप, लाइटिंग रिग और कई बार की एडिटिंग होता था, तब जाकर कुछ इस्तेमाल लायक मिलता था। आज आप इनमें से हर कदम छोड़ सकते हैं। आधुनिक AI लिप सिंक टूल्स के साथ आप एक फ़ोटो अपलोड करते हैं, अपनी स्क्रिप्ट टाइप करते हैं, और एक पूरी तरह एनिमेटेड बोलता हुआ प्रेज़ेंटर मिलता है, जिसमें होंठों की सिंक्रनाइज़्ड हरकत, प्राकृतिक सिर की गति और ऐसी आवाज़ होती है जो किसी असली रिकॉर्डिंग सेशन से आई लगती है।
यह कोई गिमिक नहीं है। ब्रैंड प्रोडक्ट डेमो, ऑनबोर्डिंग वीडियो, मल्टीलिंगुअल कैंपेन और सोशल एड्स के लिए AI स्पोक्सपर्सन इस्तेमाल कर रहे हैं। अकेले क्रिएटर पूरे फ़ेसलेस चैनल बना रहे हैं। ई-कॉमर्स स्टोर स्टैटिक प्रोडक्ट पेजों की जगह ऐसे वीडियो प्रेज़ेंटेशन लगा रहे हैं जो असल में बिक्री बढ़ाते हैं। यह तकनीक कुछ समय पहले ही "काफ़ी अच्छी" की सीमा पार कर चुकी है। अब यह साफ़ तौर पर "सचमुच प्रभावशाली" है, और AI और इंसानी प्रेज़ेंटर के बीच का फ़ासला ज़्यादातर लोगों की उम्मीद से कहीं ज़्यादा तेज़ी से घट रहा है।
AI स्पोक्सपर्सन असल में होता क्या है
यह अवतार नहीं, एक प्रेज़ेंटर है
ऑडियो पर सिर हिलाने वाले कार्टून अवतार और असली AI स्पोक्सपर्सन में बड़ा फ़र्क है। असली AI स्पोक्सपर्सन एक फ़ोटो या छोटी वीडियो क्लिप से लिए गए इंसानी चेहरे को लिप सिंक टेक्नोलॉजी से एनिमेट करता है, ताकि मुँह, जबड़ा और आसपास की चेहरे की मांसपेशियाँ बोली जा रही स्क्रिप्ट के साथ सटीक तालमेल में चलें। नतीजा एक असली इंसान के बोलने जैसा दिखता है, फ़्रेम-दर-फ़्रेम हिलाई जा रही कठपुतली जैसा नहीं।
इसकी मूल तकनीक ऑडियो-संचालित फ़ेशियल एनिमेशन मॉडल पर आधारित है। AI ऑडियो वेवफ़ॉर्म को फ़ोनीम स्तर पर पढ़ता है, फिर सूक्ष्म लेकिन सटीक चेहरे की हरकतें बनाता है: होंठों के आकार, जबड़े का खुलना, माइक्रो-एक्सप्रेशन, पलकें झपकना और प्राकृतिक सिर की हल्की गति, जो एक असली वक्ता जैसी ही हों। सबसे उन्नत मॉडल इसे पूरे ऊपरी शरीर की गति तक ले जाते हैं, जिसमें कंधों की हलचल और साँस का लय शामिल है।
असल में चाहिए बस तीन चीज़ें
AI से वर्चुअल स्पोक्सपर्सन बनाने के लिए ठीक तीन चीज़ें चाहिए:
- एक चेहरे की इमेज या छोटी वीडियो क्लिप: साफ़ पोर्ट्रेट फ़ोटो सबसे अच्छा काम करती है
- एक स्क्रिप्ट या ऑडियो फ़ाइल: टेक्स्ट लिखें और आवाज़ बनवाएँ, या अपनी रिकॉर्ड की हुई ऑडियो अपलोड करें
- एक AI लिप सिंक मॉडल: वह इंजन जो एनिमेशन करता है
न कैमरा चाहिए, न स्टूडियो, न लाइटिंग किट, न टैलेंट कॉन्ट्रैक्ट। पूरा प्रोडक्शन, यानी टूल्स का सेट, अब एक ब्राउज़र विंडो में सिमट गया है।
AI क्यों असली प्रेज़ेंटर को रखने से बेहतर है
आँकड़ों से बहस मुश्किल है
| पहलू | इंसानी प्रेज़ेंटर | AI स्पोक्सपर्सन |
|---|
| बनाने में लगने वाला समय | 3 से 7 दिन | 5 से 15 मिनट |
| हर वीडियो की लागत | $500 से $5,000+ | लगभग शून्य |
| रिवीज़न | दोबारा शूट करना पड़ता है | तुरंत दोबारा जनरेट करें |
| भाषाएँ | हर भाषा के लिए दोबारा रिकॉर्डिंग | कोई भी भाषा, वही चेहरा |
| वीडियो के बीच एकरूपता | सेशन के अनुसार बदलती है | 100% एकरूप |
| एक साथ प्रोडक्शन | एक बार में एक | समानांतर में असीमित |
लागत और समय की बचत साथ रखकर देखने पर साफ़ दिख जाती है। लेकिन इससे भी बड़ा फ़ायदा है इटरेशन की रफ़्तार। आप दोपहर से पहले पाँच अलग स्क्रिप्ट, दस अलग वॉइस स्टाइल और तीन अलग विज़ुअल प्रेज़ेंटेशन आज़मा सकते हैं, और फिर डिस्ट्रीब्यूशन पर एक पैसा खर्च करने से पहले वह वर्ज़न चुन सकते हैं जो सचमुच काम करता है।
सबसे ज़्यादा फ़र्क कहाँ पड़ता है
AI स्पोक्सपर्सन कुछ खास प्रोडक्शन परिस्थितियों में अपना सबसे साफ़ फ़ायदा देते हैं:
- ई-कॉमर्स प्रोडक्ट वीडियो: हर मौसमी कैंपेन के लिए दोबारा शूट किए बिना नया स्पोक्सपर्सन लगाएँ
- ऑनलाइन कोर्स और ट्यूटोरियल: एक बार रिकॉर्ड करें, बाद में बिना कैमरे पर किसी को बुलाए स्क्रिप्ट अपडेट करें
- मल्टीलिंगुअल कैंपेन: एक ही प्रेज़ेंटर चेहरा, 40+ भाषाओं में डब किया गया, फ़्रेम-सटीक लिप सिंक के साथ
- सोशल मीडिया ऐड क्रिएटिव: एक ही दोपहर में अलग-अलग हुक वाली दर्जनों स्क्रिप्ट वेरिएशन आज़माएँ
- इंटर्नल कम्युनिकेशन: कंपनी-भर की घोषणाएँ जो एग्ज़ीक्यूटिव का समय लिए बिना निजी लगें
- रियल एस्टेट और SaaS डेमो: हर लिस्टिंग या फ़ीचर के लिए वॉकथ्रू वीडियो, बिना वीडियो टीम के
💡 सबसे उपयुक्त स्थिति वह कंटेंट है जिसे इंसानी लगना चाहिए लेकिन जो बार-बार बदलता है। AI स्पोक्सपर्सन उस चक्र की लागत और प्रोडक्शन समय को लगभग शून्य तक ले आते हैं।
इस काम के लिए सबसे अच्छे AI मॉडल
तेज़ी से बदलता परिदृश्य
सभी लिप सिंक टूल एक जैसे नतीजे नहीं देते। कुछ रफ़्तार के लिए बने हैं। कुछ ब्रॉडकास्ट इस्तेमाल के लिए फ़्रेम-सटीक सटीकता को प्राथमिकता देते हैं। कुछ फ़ुल-बॉडी एनिमेशन संभालते हैं। कुछ खास तौर पर पोर्ट्रेट फ़ोटो में अच्छे हैं। हर शीर्ष मॉडल असल में किस काम के लिए बना है, यह यहाँ है।
P Video Avatar सबसे बहुमुखी टॉकिंग अवतार जेनरेटर में से एक है। आप एक पोर्ट्रेट और एक ऑडियो फ़ाइल देते हैं, और यह प्राकृतिक सिर की गति, असली जैसी पलकें झपकना और कसा हुआ लिप सिंक वाला वीडियो लौटाता है। मार्केटिंग कंटेंट, सोशल एड्स और प्रोडक्ट डेमो के लिए आउटपुट क्वालिटी मज़बूत है, और यह कई तरह की पोर्ट्रेट शैलियों को भरोसेमंद ढंग से संभालता है।
ByteDance का Omni Human 1.5 स्पोक्सपर्सन की रियलिज़्म में एक बड़ा कदम है। चेहरे के एनिमेशन के अलावा, यह ऑडियो के साथ सिंक्रनाइज़्ड पूरे ऊपरी शरीर की गति बनाता है, ताकि प्रेज़ेंटर धड़ से ऊपर तक स्वाभाविक ढंग से चले। कंधों की हलचल, साँस की लय, हाथों के हल्के इशारे: यह सब मिलकर ऐसी मौजूदगी बनाते हैं जो सचमुच इंसानी लगती है। एजुकेशनल कंटेंट, लंबे एक्सप्लेनर वीडियो और ऐसे किसी भी संदर्भ के लिए यह सही मॉडल है जहाँ दर्शक 60 सेकंड से ज़्यादा देखते हैं।
Omni Human (पहली पीढ़ी का वर्ज़न) तब भी एक मज़बूत और भरोसेमंद विकल्प है, जब आपको ठोस लिप एक्यूरेसी के साथ तेज़ नतीजे चाहिए। अंतिम मॉडल चुनने से पहले रैपिड प्रोटोटाइपिंग के लिए अच्छा है।
VEED का Fabric 1.0 फ़ोटो को साफ़ और पॉलिश्ड अंदाज़ में बोलना सिखाता है। यह मार्केटिंग-रेडी आउटपुट के लिए ऑप्टिमाइज़्ड है और प्रोफ़ेशनल स्टूडियो पोर्ट्रेट को खास तौर पर अच्छी तरह संभालता है। फ़्रेम-दर-फ़्रेम रंग और त्वचा के टोन की एकरूपता उल्लेखनीय रूप से मज़बूत है।
Sync का React 1 मौजूदा वीडियो फ़ुटेज पर रियलिस्टिक लिप सिंक लगाने पर केंद्रित है। अगर आपके पास पहले से किसी के बोलने का वीडियो है और उसे नए ऑडियो ट्रैक के साथ दोबारा डब करना है, तो React 1 चेहरे के एनिमेशन को विश्वसनीय रखता है और सस्ते विकल्पों में आम आर्टिफ़ैक्ट समस्याओं से बचता है।
Sync का Lipsync 2 Pro इस श्रेणी का प्रिसिज़न टूल है। यह ज़्यादातर विकल्पों से धीमा है, लेकिन यह जो फ़्रेम-सटीक मुँह की हरकत बनाता है वह ब्रॉडकास्ट-क्वालिटी काम का मानक है। तकनीकी शब्दावली, तेज़ बोली या असामान्य फ़ोनीम पैटर्न वाली स्क्रिप्ट के लिए Pro वर्ज़न उन खास स्थितियों को संभालता है जिन्हें दूसरे मॉडल छोड़ देते हैं।
Lipsync 2 स्टैंडर्ड वर्ज़न है, जो क्वालिटी और प्रोसेसिंग स्पीड के बीच अच्छा संतुलन देता है। जब आपको Pro टियर के भारीपन के बिना भरोसेमंद नतीजे चाहिए, तो यह सही डिफ़ॉल्ट है।
HeyGen का Lipsync Speed बड़ी मात्रा के लिए बना है। जब आपको एक सेशन में 30 या 50 प्रोडक्ट वीडियो बनाने हों, तो यह मॉडल बिना सुसंगति की समस्या के तेज़ नतीजे देता है। यह प्रोडक्शन पाइपलाइन का चुनाव है।
HeyGen का Lipsync Precision ज़्यादा समय लेता है, लेकिन जटिल फ़ोनीम क्रम पर साफ़ तौर पर कसा हुआ सिंक देता है। हाई-विज़िबिलिटी प्लेसमेंट के लिए, जहाँ दर्शक सिंक की क्वालिटी को बारीकी से परखेंगे, यह अतिरिक्त प्रोसेसिंग समय के लायक है।
Kwai का Kling Lip Sync लंबे क्लिप पर खास तौर पर अच्छा काम करता है, जहाँ पूरी वीडियो अवधि में सुसंगति मायने रखती है। कई मॉडल 60 सेकंड के निशान के बाद सटीकता में थोड़ा बहकने लगते हैं। Kling 2 से 3 मिनट के आउटपुट तक अच्छी सुसंगति बनाए रखता है।
HeyGen का Video Translate अलग से ज़िक्र के लायक है। अगर आपके वर्कफ़्लो में कोई मौजूदा अंग्रेज़ी वीडियो लेकर उसे स्पेनिश, फ़्रेंच, पुर्तगाली या 140+ अतिरिक्त भाषाओं में चलाना है, और प्रेज़ेंटर के होंठ डब किए गए ऑडियो से बिल्कुल मेल खाएँ, तो यही वह टूल है जो ठीक इसी उपयोग के लिए बना है।
PicassoIA पर अपना स्पोक्सपर्सन कैसे बनाएँ
चरण-दर-चरण तरीका
निम्नलिखित वर्कफ़्लो P Video Avatar को मुख्य टूल के रूप में इस्तेमाल करता है। यही सिद्धांत प्लेटफ़ॉर्म पर किसी भी लिप सिंक मॉडल पर लागू होते हैं।
चरण 1: अपनी पोर्ट्रेट फ़ोटो तैयार करें
साफ़, सामने से ली गई पोर्ट्रेट फ़ोटो लें, जिसमें समान रोशनी और सादा बैकग्राउंड हो। चेहरा पूरी तरह दिखना चाहिए, कोई रुकावट न हो, मुँह को ढकने वाला कोई एक्सेसरी न हो और कोई अत्यधिक कोण न हो। सफ़ेद या तटस्थ बैकग्राउंड सबसे साफ़ नतीजे देता है, हालाँकि ज़्यादातर मॉडल के साथ जटिल बैकग्राउंड भी संभल जाते हैं। न्यूनतम रिज़ॉल्यूशन: 512x512 पिक्सल। JPEG या PNG, दोनों चलेंगे।
चरण 2: छोटी, बोलचाल वाली स्क्रिप्ट लिखें
अपने पहले वर्ज़न को छोटा रखें, 30 से 60 सेकंड के बीच। इससे लंबे प्रोडक्शन पर पैसा लगाने से पहले आप आउटपुट क्वालिटी जल्दी परख सकते हैं। बोलचाल की भाषा में लिखें। छोटे वाक्य। प्राकृतिक ठहराव बनाकर रखें। AI गति और साँस की लय अपने आप संभालता है, लेकिन वह ऑडियो के संकेतों का पालन करता है, इसलिए बहुत घनी या बिना रुके चलने वाले वाक्यों वाली स्क्रिप्ट कम प्राकृतिक नतीजे देती है।
चरण 3: अपना ऑडियो बनाएँ या रिकॉर्ड करें
आपके पास दो रास्ते हैं। पहला: अपनी स्क्रिप्ट लिखें, उसे PicassoIA के Text to Speech मॉडल में से किसी एक में चिपकाएँ, कई वॉइस स्टाइल आज़माएँ, और वह ऑडियो फ़ाइल एक्सपोर्ट करें जो आपके ब्रैंड के टोन पर सबसे फ़िट बैठे। दूसरा: शांत कमरे में अपनी आवाज़ रिकॉर्ड करें, जो अक्सर सबसे प्राकृतिक लिप सिंक देती है, क्योंकि ऑडियो की टाइमिंग सचमुच इंसानी होती है। दोनों तरीके अच्छे काम करते हैं। रिकॉर्ड की हुई आवाज़ का विकल्प लंबे प्रोडक्शन में ज़्यादा चमकता है।
चरण 4: PicassoIA पर अपलोड करें और कॉन्फ़िगर करें
P Video Avatar मॉडल पेज पर जाएँ। अपनी पोर्ट्रेट इमेज और ऑडियो फ़ाइल अपलोड करें। अगर उपलब्ध हो तो एक्सप्रेशन इंटेंसिटी सेटिंग एडजस्ट करें। थोड़ी ऊँची एक्सप्रेशन सेटिंग उस सपाट, खाली लुक को रोकती है जो कम प्रोसेस किए गए मॉडल कभी-कभी देते हैं। जनरेशन जॉब सबमिट करें।
चरण 5: समीक्षा करें और दोहराएँ
आउटपुट डाउनलोड करें और उसे स्लो मोशन में नहीं, पूरी प्लेबैक स्पीड पर देखें। शब्दों के बीच के संक्रमण पर और "p", "b" और "m" जैसी ध्वनियों वाले व्यंजन-भारी फ़ोनीम क्रम पर सिंक की सटीकता जाँचें, क्योंकि यही मॉडल के लिए सबसे कठिन होते हैं। अगर कुछ थोड़ा भी गलत लगे, तो अलग पोर्ट्रेट क्रॉप आज़माएँ या ऑडियो से शुरुआती सन्नाटा हटा दें। ज़्यादातर समस्याएँ दो दौर में सुलझ जाती हैं।
💡 किसी भी मॉडल पर सबसे साफ़ नतीजों के लिए शांत माहौल में, बिना बैकग्राउंड शोर के ऑडियो रिकॉर्ड या एक्सपोर्ट करें। जब फ़ोनीम टाइमिंग साफ़ और स्पष्ट हो, तो मॉडल बेहतर काम करता है।
ब्रॉडकास्ट क्वालिटी तक ले जाना
जब क्वालिटी सबसे ऊँचे स्तर पर मायने रखती है, तो टूल्स को क्रम में जोड़ें। अपने शुरुआती जनरेशन पर फ़्रेम-सटीक सिंक के लिए Lipsync 2 Pro इस्तेमाल करें, फिर आउटपुट को PicassoIA के किसी AI वीडियो एन्हांसमेंट मॉडल से चलाकर अंतिम वीडियो को 4K तक अपस्केल करें। यह संयोजन ऐसा नतीजा देता है जो किसी भी डिस्प्ले पर फ़ुल स्क्रीन में टिका रहता है।
सही वॉइस चुनना
वॉइस आधा परफ़ॉर्मेंस है
तकनीकी रूप से परफ़ेक्ट लिप सिंक एनिमेशन भी गलत आवाज़ के साथ फीका लगता है। आवाज़ तय करती है कि स्पोक्सपर्सन को कैसे देखा जाता है, वह आत्मविश्वासी लगता है या झिझकता हुआ, आधिकारिक लगता है या अपनापन लिए हुए, औपचारिक लगता है या अनौपचारिक। अंतिम वीडियो जनरेट करने से पहले इस फ़ैसले पर सचमुच समय लगाएँ।
PicassoIA के Text to Speech मॉडल आपको वॉइस स्टाइल, लहज़ों और टोन की विस्तृत रेंज देते हैं। फ़ैसला करने से पहले अपनी असली स्क्रिप्ट पर कम से कम तीन से पाँच अलग आवाज़ें आज़माएँ। पेसिंग, टिम्बर और उच्चारण की गति में छोटे फ़र्क भी दर्शकों पर बहुत अलग प्रभाव डालते हैं।
क्षेत्रीय लहज़ा और भाषा का ध्यान
अगर आप किसी खास क्षेत्रीय दर्शक को निशाना बना रहे हैं, तो लहज़ा उससे कहीं ज़्यादा मायने रखता है, जितना ज़्यादातर मार्केटर्स मानते हैं। मेक्सिको के स्पेनिश-भाषी दर्शक कैस्टिलियन स्पेनिश पर उस तरह प्रतिक्रिया नहीं देते जैसे मेक्सिकन स्पेनिश पर देते हैं। यही तर्क ब्राज़ीलियाई बनाम यूरोपीय पुर्तगाली, या कनाडाई बनाम ब्रिटिश अंग्रेज़ी पर लागू होता है। जब आपको हर चीज़ नए सिरे से रिकॉर्ड किए बिना एक ही स्पोक्सपर्सन चेहरा कई क्षेत्रीय बाज़ारों में चलाना हो, तब Video Translate इस्तेमाल करें।
असली काम करने वाले उपयोग
बड़े पैमाने पर ई-कॉमर्स
एक स्टैटिक प्रोडक्ट इमेज के साथ बुलेट पॉइंट्स की सूची पेज पर मौजूद बाकी हर स्टैटिक प्रोडक्ट इमेज से प्रतिस्पर्धा करती है। 45 सेकंड में प्रोडक्ट समझाते किसी इंसान वाला वीडियो उस प्रतिस्पर्धा की समस्या में नहीं फँसता। प्रेज़ेंटेड वीडियो और टेक्स्ट-प्लस-इमेज के बीच कन्वर्ज़न दर का फ़र्क अच्छी तरह दर्ज है। AI स्पोक्सपर्सन इस फ़ॉर्मेट को सिर्फ़ फ़्लैगशिप प्रोडक्ट के लिए नहीं, पूरी कैटलॉग के हर प्रोडक्ट के लिए किफ़ायती बनाते हैं।
ऑनलाइन कोर्स और ट्रेनिंग कंटेंट
ऐसे इंस्ट्रक्टर जो कैमरे पर नहीं आना चाहते, या जो सभी कोर्स मॉड्यूल में एक जैसी विज़ुअल पहचान बनाए रखना चाहते हैं, चाहे वे कब भी रिकॉर्ड हुए हों, हर लेसन के आगे AI स्पोक्सपर्सन रखते हैं। इंस्ट्रक्टर अपनी आवाज़ रिकॉर्ड करता है, AI एक चुना हुआ चेहरा एनिमेट करता है, और अंतिम कोर्स ऑन-कैमरा प्रोडक्शन की परेशानी के बिना एकसूत्र और प्रोफ़ेशनल लगता है। किसी मॉड्यूल में बदलाव के लिए बस एक नई ऑडियो फ़ाइल चाहिए।
कॉर्पोरेट कम्युनिकेशन
HR टीमें ऑनबोर्डिंग वीडियो, कंप्लायंस ट्रेनिंग, सुरक्षा ब्रीफ़िंग और पॉलिसी अपडेट की घोषणाओं के लिए AI स्पोक्सपर्सन इस्तेमाल करती हैं। स्पोक्सपर्सन हर वीडियो में विज़ुअली एकरूप रहता है, ब्रैंड प्रेज़ेंटेशन नियंत्रित रहती है, और अपडेट के लिए सिर्फ़ स्क्रिप्ट बदलनी और दोबारा जनरेट करनी होती है। न एग्ज़ीक्यूटिव्स से तालमेल, न स्टूडियो बुकिंग, न एडिट की कतार।
मल्टीलिंगुअल कैंपेन
प्रक्रिया सीधी है: अपनी प्राथमिक भाषा में एक वीडियो बनाएँ, स्क्रिप्ट का अनुवाद करें, हर लक्षित भाषा के लिए डब किया हुआ ऑडियो जनरेट करें, फिर हर संस्करण में होंठों को सिंक करने के लिए Video Translate या Lipsync Precision इस्तेमाल करें। एक क्रिएटिव एसेट न्यूनतम अतिरिक्त काम के साथ दस क्षेत्रीय वेरिएंट बन जाता है।
आम गलतियाँ जो रियलिज़्म को खत्म कर देती हैं
सबसे ज़्यादा क्या बिगड़ता है
ज़्यादातर असफल AI स्पोक्सपर्सन वीडियो में एक ही तरह की कुछ समस्याएँ होती हैं:
- कम क्वालिटी का सोर्स फ़ोटो: धुंधले पोर्ट्रेट, साइड एंगल या भारी रीटच की गई फ़ोटो खराब होंठ-एनिमेशन देती हैं। तेज़, सामने से ली गई और समान, प्राकृतिक रोशनी वाली इमेज इस्तेमाल करें।
- शोर वाला या असंगत ऑडियो: बैकग्राउंड की सनसनाहट, कमरे की गूँज या वॉल्यूम के उछाल फ़्रेम-स्तर पर सिंक की गड़बड़ी लाते हैं। साफ़ ऑडियो सबसे असरदार क्वालिटी वेरिएबल है।
- ऐसी स्क्रिप्ट जो लिखी हुई लगती है: औपचारिक लिखा टेक्स्ट कठोर, अप्राकृतिक नतीजे देता है। वैसे लिखें जैसे एक आत्मविश्वासी इंसान सचमुच बोलता है, प्राकृतिक लय और छोटे वाक्यों के साथ।
- छोटा टेस्ट छोड़ देना: 5 मिनट के प्रोडक्शन पर पैसा लगाने से पहले 30 सेकंड का वर्ज़न बनाएँ। समस्याएँ जल्दी पकड़ में आती हैं।
- सपाट एक्सप्रेशन सेटिंग: Omni Human 1.5 और P Video Avatar जैसे मॉडल में एक्सप्रेशन इंटेंसिटी कंट्रोल होते हैं। तटस्थ सेटिंग एक खाली, बेरुखी वाला लुक देती है। प्राकृतिक भावनात्मक जुड़ाव के लिए इसे थोड़ा बढ़ाएँ।
अनकैनी वैली से बचाव
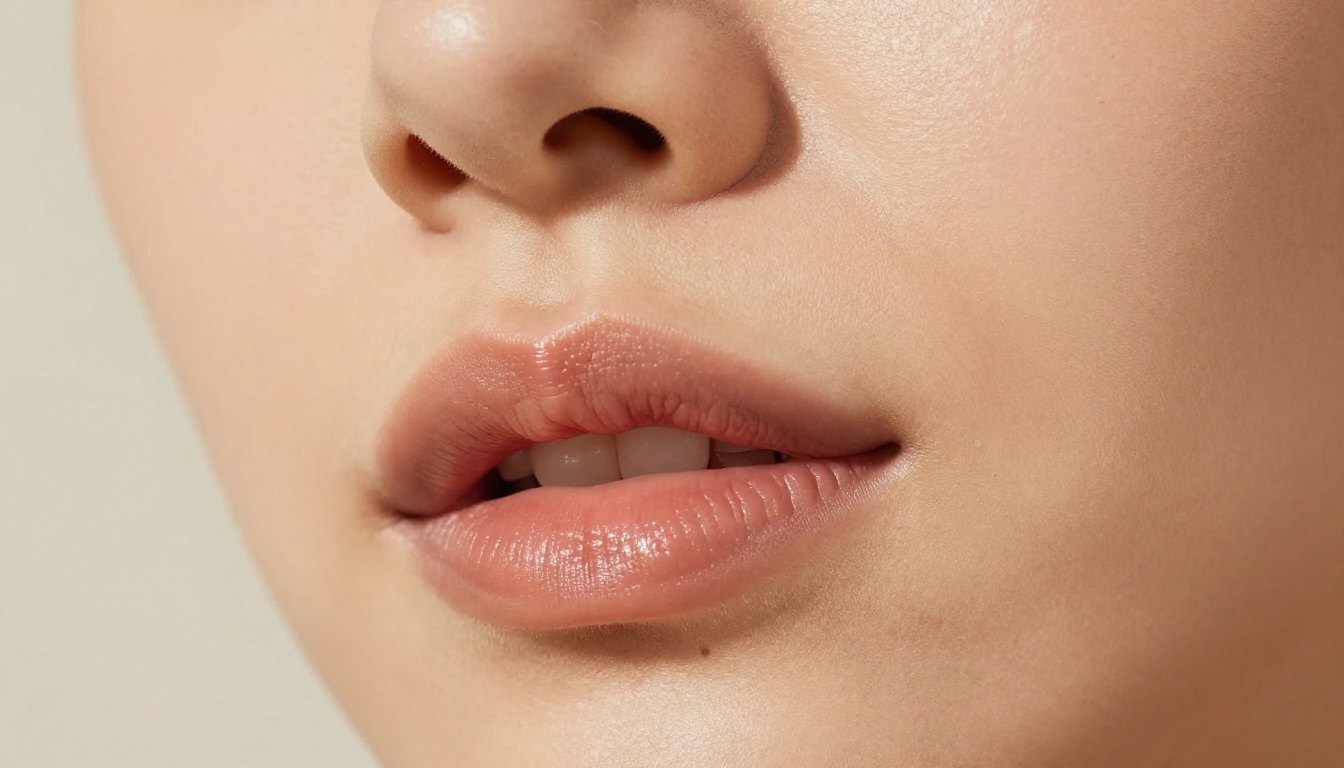
अनकैनी वैली एक असली चिंता है, लेकिन यह लगभग पूरी तरह खास तकनीकी विफलताओं से पैदा होती है, न कि तकनीक से खुद: आउटपुट में चेहरे और गर्दन के बीच बेमेल त्वचा का टोन, सपाट या स्थिर दिखने वाले दाँत, या ऐसी आँखें जो बिना प्राकृतिक पलक झपकाए एक ही टकटकी बाँधे रखें। ज़्यादातर आधुनिक लिप सिंक मॉडल पलकें झपकाना और माइक्रो-एक्सप्रेशन अपने आप संभालते हैं। अगर आउटपुट फिर भी अजीब लगे, तो Omni Human 1.5 जैसे पूरे ऊपरी शरीर की गति वाले मॉडल पर जाने से ज़्यादातर समय यह दूरी मिट जाती है। पूरी बॉडी की गति वह विज़ुअल संदर्भ देती है जिससे दिमाग इमेज को इंसान के रूप में पढ़ पाता है।
आज ही अपना पहला वीडियो बनाएँ
एक प्रोफ़ेशनल स्पोक्सपर्सन वीडियो के लिए प्रोडक्शन की बाधा खत्म हो चुकी है। एक साफ़ पोर्ट्रेट, 60 सेकंड की स्क्रिप्ट और PicassoIA का एक्सेस, बस इतना ही चाहिए आज ही एक तैयार वीडियो भेजने के लिए, बिना स्टूडियो, कैमरे या टैलेंट बजट के।
तेज़ पहले नतीजे के लिए P Video Avatar से शुरू करें। जब लंबे फ़ॉर्मेट के कंटेंट में पूरे ऊपरी शरीर की रियलिज़्म चाहिए, तब Omni Human 1.5 पर जाएँ। जब ब्रॉडकास्ट या हाई-विज़िबिलिटी प्लेसमेंट के लिए सटीकता मायने रखती है, तब Lipsync 2 Pro इस्तेमाल करें। हर चीज़ के साथ Text to Speech मॉडल से सावधानी से चुनी गई आवाज़ जोड़ें, और जब एक ही एसेट को कई भाषाओं में बढ़ाने के लिए तैयार हों, तब Video Translate इस्तेमाल करें।
जिस स्पोक्सपर्सन की आपके ब्रैंड को ज़रूरत है, वह पहले से मौजूद है। आपको बस स्क्रिप्ट लेकर आना है।
PicassoIA पर बनाना शुरू करें


