تسجّل نفسك مرة واحدة، ثم تبقى نسخة رقمية منك تتحدث لشهور: عروض منتجات، وشروحات تعليمية، وإعلانات، وتحيات بخمس لغات. هذا هو الوعد الذي يقدّمه custom AI actor، وبحلول 2027 لم يعد حكرًا على الاستوديوهات. المشكلة أن السوق مزدحم. بعض الأدوات مجانية لكنها تضع علامة مائية على كل شيء. وأدوات أخرى تخفي استنساخ الصوت خلف خطة مدفوعة. وقليل منها يبدو رائعًا في العرض التجريبي، ثم ينهار عندما تلتقي الشفاه بالصوت الحقيقي.
يحسم هذا المقال الأمر. ستتعرّف إلى ما يتكوّن منه الممثل الذكي المخصّص فعليًا، وأي الخيارات المجانية تستحق وقتك، وكيف تبدو الفيديوهات النهائية، وكيف تتعامل مع الصوت، وكيف تبدو الفاتورة في كل مرحلة.
💡 الإجابة السريعة: الممثل الذكي المخصّص ثلاث طبقات مرتبة فوق بعضها: وجه (صورة أو مقطع قصير)، وصوت (مستنسخ أو مصمّم)، وخطوة مزامنة الشفاه التي تجعل الفم يطابق الصوت. يمكنك تجربة كل طبقة مجانًا، لكن النتيجة المصقولة تحتاج عادةً إلى خطوة مدفوعة في مكان ما.
ما هو الممثل الذكي المخصّص فعليًا
يُستخدم هذا المصطلح بشكل فضفاض، لذا دعنا نحدّده. الممثل الذكي المخصّص أداء متكرر على الشاشة مبني من موادك الخاصة أو من شخصية تبتكرها. وبمجرد أن يصبح موجودًا، تعطيه نصًا فيقدّم الأسطر أمام الكاميرا. لا إضاءة، ولا إعادة تصوير، ولا حجز استوديو.
الطبقات الثلاث
كل ممثل، مهما كان اسم العلامة على الأداة، مبني من الأجزاء الثلاثة نفسها:
| الطبقة | وظيفتها | المدخل المعتاد |
|---|
| الوجه والجسم | تحدد شكل الممثل وحركته | صورة واحدة، أو من 1 إلى 2 دقيقة من المقاطع المصورة |
| الصوت | يحدد صوت الممثل | عينة مدتها من 10 إلى 60 ثانية، أو وصف نصي |
| مزامنة الشفاه | تطابق حركة الفم مع الصوت | الوجه مع ملف صوتي |
تجمع بعض المنصات الطبقات الثلاث وتفرض اشتراكًا واحدًا. وتتيح منصات أخرى اختيار كل طبقة على حدة، وهذا أرخص وأكثر مرونة، لكنه يتطلب بعض النقرات الإضافية.
الأفاتار أم التوأم الرقمي أم الممثل؟
الأفاتار عادةً مقدّم جاهز تختاره من قائمة. التوأم الرقمي نسخة من شخص حقيقي. ويمكن أن يكون الممثل الذكي المخصّص أيًّا منهما، أو شخصية مبتكرة. وكلمة "مخصّص" هي الأهم: أنت تتحكم في الهوية والملابس والمكان والصوت، بدلًا من استئجار وجه تستخدمه آلاف العلامات الأخرى أيضًا.
من يبني هذه الممثلين الآن
تقود ثلاث فئات التبنّي. صنّاع المحتوى الفرديون الذين يريدون النشر يوميًا دون التصوير يوميًا. والشركات الصغيرة التي تحتاج إلى فيديوهات منتجات ولا يتوفر لديها طاقم تصوير. وفرق التدريب والتسويق التي تحتاج إلى الرسالة نفسها بلغات كثيرة. إن كنت تنتمي إلى إحداها، فمن المرجح أن الحسابات أدناه ستكون منطقية بالنسبة إليك.
خيارات مجانية تعمل فعلًا
تأتي كلمة "مجاني" بثلاثة أشكال، والخلط بينها يقود إلى خيبة أمل.
خطط مجانية بحدود
تقدّم عدة منصات أفاتار معروفة، بينها HeyGen و Vidnoz و Hedra، مستوى مجانيًا يمكن فتحه دون بطاقة ائتمان. عمليًا يعني ذلك رصيدًا صغيرًا من النقاط، ومقاطع أقصر، ودقة أقل، وعلامة مائية. هذه الخطط مصممة لاختبار سير العمل، لا لنشر أعمال نهائية. وتميل ميزة استنساخ الصوت تحديدًا إلى أن تكون ضمن مستوى مدفوع، لذا عادةً لا تمنحك الخطة المجانية سوى أصوات جاهزة.
توليد مجاني داخل مكتبة نماذج
مسار مختلف هو استخدام نماذج فردية والدفع فقط للأجزاء التي تحتاجها. على PicassoIA يمكنك بناء الوجه والصوت ومزامنة الشفاه بنماذج منفصلة، فلا تكون مقيّدًا بصفحة أسعار مورد واحد. تنشئ نماذج الصور مثل Nano Banana Pro أو Seedream 4.5 صورة الوجه الأساسية، ويحييها نموذج مزامنة الشفاه.
نسخ تجريبية مجانية للأدوات المدفوعة
تقدّم Synthesia وأدوات مماثلة للاستوديوهات أحيانًا عروضًا تجريبية قصيرة مجانية. وهي جيدة للحكم على الجودة، لكن أفاتار العرض التجريبي نادرًا ما يكون هو المخصّص الذي ستدفع ثمنه لاحقًا. اسأل دائمًا ما إذا كانت التجربة تتضمن وجهك وصوتك، لأن هذا هو الجزء الذي يكلّف المال.
💡 قاعدة عامة: إذا سمح لك المستوى المجاني برفع صورتك وصوتك الخاصين، فهذا اختبار حقيقي. وإذا لم يقدّم سوى مقدّمين جاهزين، فأنت تختبر الواجهة لا النتيجة.
ما يغيب عن المجاني تقريبًا دائمًا
- استنساخ الصوت من تسجيلك الخاص
- إخراج بلا علامة مائية
- حقوق الاستخدام التجاري
- مقاطع طويلة تمتد لعدة دقائق
احتفظ بهذه القائمة بجانبك عند مقارنة الخطط. فهي تفسّر معظم فروق الأسعار التي سترى.
أمثلة فيديو يمكنك بناؤها اليوم
رؤية حالات الاستخدام تفيد أكثر من أي جدول مزايا. هذه هي السيناريوهات التي يسدد فيها الممثل الذكي المخصّص تكلفته بالفعل.
صانع المحتوى الفردي
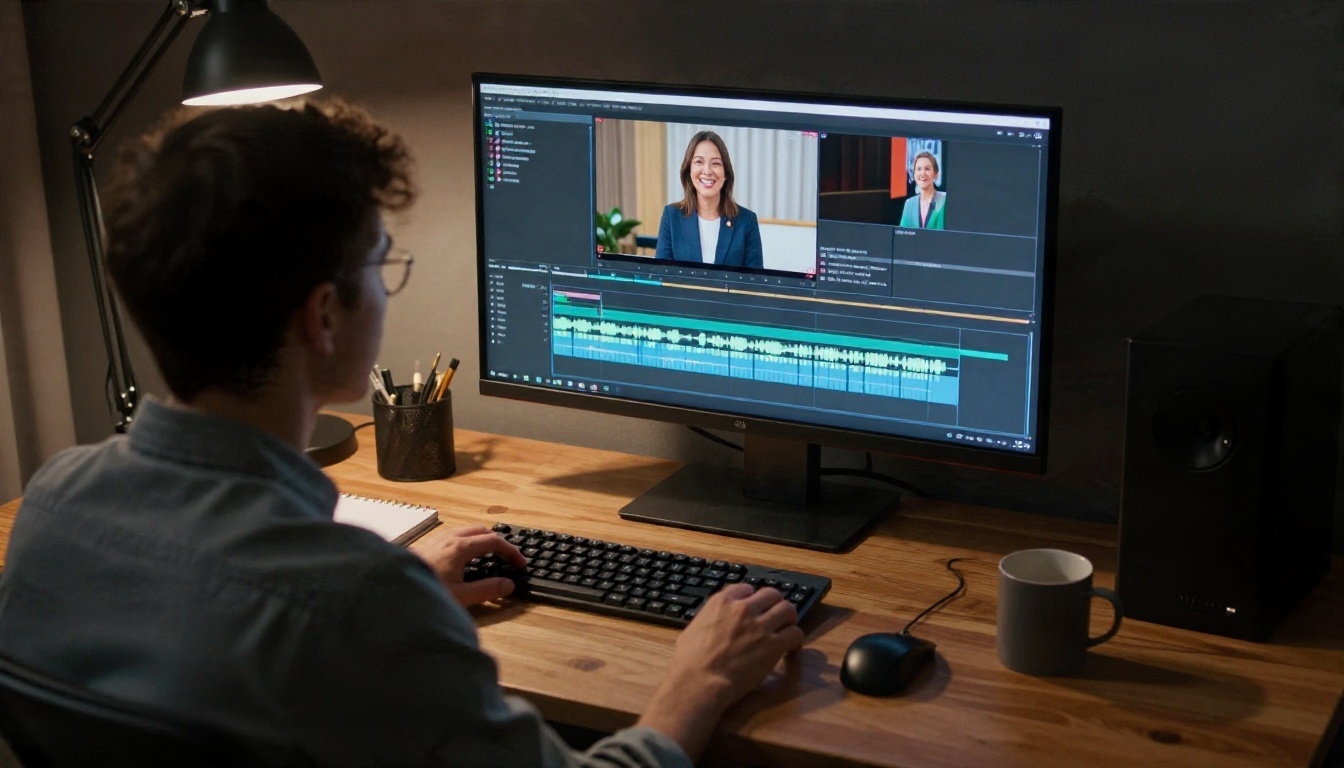
صوّر نفسك مرة واحدة، في ضوء جيد، وأنت تتحدث بشكل طبيعي إلى العدسة. تصبح هذه الجلسة الواحدة مرجعك. ومن بعدها تتحول النصوص الجديدة إلى مقاطع جديدة: تحديثات أسبوعية، وشروحات قصيرة، ومقدمات للقناة. ويُعدّ الخط الزمني للمونتاج في الصورة أعلاه عنق الزجاجة الحقيقي لمعظم صناع المحتوى، والممثل الذكي يلغي نصف هذا العبء المتعلق بالتصوير.
نموذج مثل Omni Human 1.5 مصمم لهذا الغرض. تعطيه صورة شخصية واحدة مع مسار صوتي، فيعيد فيديو متحدثًا بحركة رأس وإيماءات طبيعية، لا مجرد فك يتحرك.
المقدّم في الشركات
فيديوهات التعريف بالموظفين الجدد، وتحديثات الامتثال، والإعلانات الداخلية تتغير باستمرار. إعادة تصوير المدير في كل مرة مكلفة ومحرجة. مع التوأم الرقمي، تحدّث النص وتعيد التوليد. ولأن الوجه يبقى ثابتًا، يرى المشاهدون مقدّمًا مألوفًا بدلًا من طاقم متغير من الأفاتارات الجاهزة.
للحصول على نتائج نظيفة هنا، يعمل Lipsync 2 Pro جيدًا عندما يكون لديك بالفعل لقطات للمقدّم وتحتاج فقط إلى كلمات جديدة تناسب الفم.
صاحب المشروع الصغير
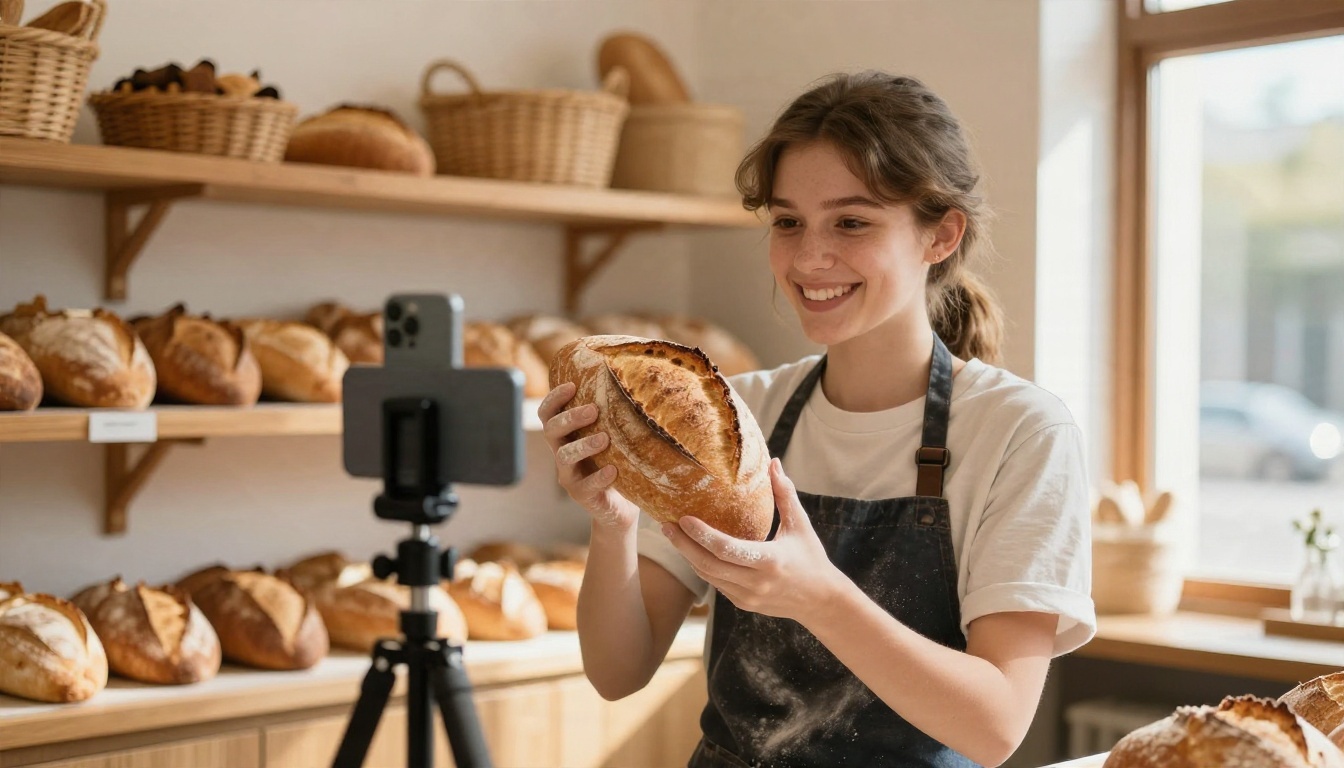
لدى صاحب المحل مئة منتج ولا وقت لديه. تحية مصوّرة واحدة، يوسّعها ممثل ذكي، يمكن أن تقدّم كل صنف بوجه صاحب المحل نفسه. النتيجة تبدو شخصية، وهذا أهم للعلامات المحلية من الكمال. Fabric 1.0 خيار مناسب عندما تكون نقطة بدايتك صورة واحدة فقط.
الشخصية المتحركة
ليس كل ممثل يجب أن يكون بشريًا. إذا ابتكرت شخصية بنموذج صور ثم غذّيتها إلى P Video Avatar، تحصل على ماسكوت يستطيع أن ينطق بأي نص. أما للمشاهد التي يتحرك فيها الممثل عبر مساحة بدلًا من الجلوس والتحدث، فيمكن أن يولّد Kling v3 Video و Veo 3.1 اللقطات المحيطة، ويتيح Kling v3 Motion Control للشخصية نسخ الحركة من مقطع مرجعي.
الصوت: استنسخه أو صمّمه
وجه رائع بصوت مسطّح يكسر الوهم في ثوانٍ. الصوت يستحق اهتمامًا بقدر الصورة.
استنساخ صوتك الخاص
يحتاج استنساخ الصوت إلى عيّنة نظيفة. سجّل في غرفة هادئة، وتحدث بوتيرة طبيعية، وتجنّب الموسيقى الخلفية. غالبًا ما تكفي من 10 إلى 60 ثانية لاستنساخ قابل للاستخدام، رغم أن تنوع النبرة يمنح نتيجة أكثر حيوية. يستطيع Qwen3 TTS استنساخ صوت من عيّنة قصيرة، أو تصميم صوت جديد من وصف مكتوب، ما يجعله نقطة بداية مرنة.
اختيار صوت جاهز
إذا كنت لا تريد صوتك الخاص في الفيديو، فالأصوات الجاهزة سريعة ورخيصة. من الخيارات الجيدة ElevenLabs V3 للأداء المعبّر، و Speech 2.8 HD للتعليق الصوتي بجودة الاستوديو، و Gemini 3.1 Flash TTS عندما تحتاج إلى أصوات كثيرة بأكثر من 70 لغة.
التحدث بلغات أخرى
هنا يتفوّق الممثلون الذكيون على التصوير التقليدي. يمكن لتسجيل واحد أن يصبح نسخة بالإسبانية والفرنسية واليابانية دون إعادة تصوير واحدة. تدبلج Video Translate اللقطات الموجودة إلى أكثر من 150 لغة، ويُعاد ضبط توقيت الشفاه على اللغة الجديدة كي لا تبدو النتيجة مدبلجة بشكل سيء.
💡 نصيحة: اكتب النصوص بجمل قصيرة. تتعامل نماذج مزامنة الشفاه مع الأسطر من 8 إلى 15 كلمة أفضل بكثير من الأسطر الطويلة المتشابكة، وتبقى الترجمات أسهل في ضبط التوقيت.
مقارنة الأصوات في لمحة
التسعير الحقيقي، بند بند
تتغير الأسعار بسرعة، وكثير من مقالات المقارنة تكتبها الشركات البائعة نفسها، لذا تعامل مع كل رقم أدناه كنطاق يجب التحقق منه في صفحة الأسعار الرسمية قبل الشراء. إليك الصورة العامة.
تكلفة الاشتراكات
تتبع معظم منصات الأفاتار الشاملة سلّمًا متشابهًا:
| المستوى | السعر الشهري المعتاد | ما تحصل عليه عادةً |
|---|
| Free | $0 | نقاط قليلة، علامة مائية، أصوات جاهزة، دقة منخفضة |
| مدفوع للمبتدئين | من نحو $7 إلى $30 | دقائق أكثر، بدون علامة مائية، وأحيانًا استنساخ صوت أساسي |
| متوسط | من نحو $30 إلى $100 | أفاتار مخصّص، استنساخ صوت، فيديوهات أطول، حقوق استخدام تجاري |
| الاستوديوهات والمؤسسات | أسعار تُحدَّد حسب الطلب | مقاعد كثيرة، API، أدوات تحكم بالعلامة التجارية، مراجعات أمنية |
تعرض بعض الأدوات أفاتارًا مخصّصًا واستنساخ صوت بدءًا من نحو $15 شهريًا، بينما تقع استوديوهات المؤسسات مثل Synthesia أعلى من ذلك بكثير عند احتساب النقاط والمقاعد. وأُفيد أن Vidnoz، على سبيل المثال، يحجز استنساخ الصوت لمستويات الأعمال الأعلى لديه.
لماذا قد تكون تكلفة الاستخدام الفردي أقل
يفرض عليك الاشتراك رسومه سواء نشرت أم لم تنشر. مع مكتبة نماذج، تدفع مقابل ما تولّده. إذا أنتجت أربعة مقاطع شهريًا، فقد يكون ذلك أقل بكثير من خطة شهرية. وإذا أنتجت أربعمئة، فقد يتفوق الاشتراك. احسب الأرقام قبل الاختيار.
التكاليف الخفية
- إعادة التصيير: تكلّف جولة مزامنة شفاه سيئة بقدر جولة جيدة، لذا اختبر أولًا بمقطع مدته 5 ثوانٍ.
- ترقية الدقة: غالبًا ما يقع إخراج 1080p أو 4K ضمن مستوى أعلى.
- الحقوق التجارية: بعض المستويات المجانية والمنخفضة تمنع استخدام الإعلانات.
- فتحات الأصوات: تحدّ كثير من الخطط عدد الأصوات المستنسخة التي يمكنك الاحتفاظ بها.
ميزانية نموذجية
لمنشئ محتوى ينتج نحو 20 مقطعًا قصيرًا شهريًا، تتمثل الخطة المعقولة في أداة صوت مدفوعة واحدة، ونموذج مزامنة شفاه واحد، ونموذج صور للصورة الأساسية. هذا يبقي التكلفة الشهرية منخفضة ويتيح لك استبدال أي جزء واحد عندما يظهر ما هو أفضل.
سير عمل يستغرق بعد ظهر واحدًا
إليك تسلسلًا عمليًا يعمل مع مكتبة من النماذج المنفصلة على PicassoIA.
الخطوة 1: التقط صورة شخصية نظيفة
التقط صورة أمامية في ضوء نافذة ناعم، وخلفية محايدة، ووجه مسترخٍ، وفم مغلق أو مفتوح قليلًا. تجنّب النظارات الشمسية والظلال الكثيفة والزوايا المتطرفة. وإن كنت تفضّل ممثلًا مبتكرًا، فولّد الصورة الشخصية باستخدام Nano Banana Pro واطلب ملمس بشرة طبيعيًا وخلفية بسيطة.
الخطوة 2: جهّز الصوت
سجّل عيّنتك، أو اكتب وصفًا للصوت. مرّر نصك عبر نموذج TTS مثل Qwen3 TTS أو ElevenLabs V3 وصدّر الملف الصوتي. استمع إليه وعيناك مغمضتان. إذا بدا جامدًا، فغيّر علامات الترقيم، لأن الفواصل والنقاط تتحكم في الإيقاع.
الخطوة 3: حرّك الوجه
افتح نموذج مزامنة شفاه، وارفع الصورة الشخصية والصوت، وولّد اختبارًا قصيرًا. يتعامل Omni Human 1.5 مع الإيماءات وحركة الجزء العلوي من الجسد، بينما يفيد Kling Lip Sync عندما يكون لديك فيديو بالفعل وتحتاج فقط إلى استبدال الفم.
الخطوة 4: راجع وانشر
شاهد المقطع بملء الشاشة. تحقق من الأسنان، ورمش العين، ولحظة إغلاق الفم في نهاية الجملة. هذه المواضع الثلاثة تكشف معظم العيوب. أصلح الصوت أولًا، لأن مشكلات الصوت أرخص في التصحيح من مشكلات الفيديو.
💡 نصيحة المعلمات: أبقِ الاختبار الأول دون عشر ثوانٍ. إذا صمد الوجه هناك، فمدّد النص. وإذا انحرف، فغيّر الصورة الشخصية المصدر لا الإعدادات.
أخطاء تفسد النتيجة
معظم الممثلين الذكيين الفاشلين يتشاركون عددًا محدودًا من الأخطاء نفسها.
استخدام صورة مصدر ضعيفة
الصورة منخفضة الدقة أو المائلة أو كثيرة الفلاتر لا تمنح النموذج ما يعمل به. ابدأ بأوضح صورة لديك وأكثرها توزيعًا للإضاءة.
إهمال جودة الصوت
صدى الغرفة وميكروفونات الحاسوب المحمول وضجيج الخلفية تُنسخ إلى الصوت المستنسخ. خصّص عشر دقائق لتجهيز غرفة هادئة وميكروفون لائق.
الكتابة للصفحة لا للأذن
الجمل الرسمية تبدو آلية عند نطقها. اقرأ نصك بصوت عالٍ أولًا. إذا تعثّرت، فسيتعثر الممثل أيضًا.
تخطّي الموافقة والإفصاح
لا تستنسخ إلا الأصوات والوجوه التي لديك إذن باستخدامها، وضع وسمًا على المحتوى المصطنع حيثما تطلب المنصات أو القواعد المحلية ذلك. هذا يحميك وجمهورك معًا، وهو أمر مطلوب بشكل متزايد.
توقع أن تفعل أداة واحدة كل شيء
غالبًا ما تأتي أفضل النتائج من ربط متخصصين: نموذج صور للوجه، ونموذج TTS للصوت، ونموذج مزامنة شفاه للفم. يمكن استبدال كل جزء دون البدء من جديد.
ابنِ ممثلك الخاص اليوم
لديك الآن الصورة الكاملة: وجه، وصوت، وجولة مزامنة شفاه، وميزانية تناسب عدد مرات نشرك. أسرع طريقة لمعرفة ما يناسبك هي تشغيل اختبار قصير، لا قراءة مقارنة أخرى.
افتح Picasso IA وجرّب السلسلة بنفسك. ولّد صورة شخصية، وأعطها صوتًا، ودع نموذج مزامنة شفاه مثل Omni Human 1.5 أو Fabric 1.0 يجعلها تتحدث. بدّل نموذجًا واحدًا في كل مرة، وقارن النتائج، واحتفظ بالتركيبة التي تبدو وتتكلم مثلك. قد يكون أول مقطع تتحدث فيه جاهزًا قبل أن يبرد قهوتك.


