आप एक बार खुद को रिकॉर्ड करते हैं, और फिर आपका एक डिजिटल वर्ज़न महीनों तक बोलता रहता है: प्रोडक्ट डेमो, ट्यूटोरियल, विज्ञापन, पाँच भाषाओं में अभिवादन। कस्टम AI एक्टर का वादा यही है, और 2027 में यह सिर्फ़ स्टूडियो की चीज़ नहीं रही। दिक्कत यह है कि बाज़ार शोर से भरा है। कुछ टूल फ़्री हैं, पर हर चीज़ पर वॉटरमार्क लगा देते हैं। कुछ वॉइस क्लोनिंग को पेड टियर के पीछे छिपा देते हैं। और कुछ डेमो में बेहतरीन दिखते हैं, लेकिन असली ऑडियो के साथ होंठों का मिलान होते ही बिखर जाते हैं।
यह लेख इन सबको साफ़ करता है। आप देखेंगे कि कस्टम AI एक्टर असल में किन चीज़ों से मिलकर बनता है, कौन से फ़्री विकल्प समय देने लायक हैं, तैयार वीडियो कैसे दिखते हैं, वॉइस को कैसे संभालें, और हर चरण पर बिल कैसा बनता है।
💡 त्वरित जवाब: कस्टम AI एक्टर तीन परतों को एक साथ जोड़कर बनता है: एक चेहरा (एक फ़ोटो या छोटी क्लिप), एक आवाज़ (क्लोन की गई या डिज़ाइन की गई), और एक लिप सिंक चरण, जो होंठों की हरकत को ऑडियो से मिलाता है। आप हर परत को फ़्री में आज़मा सकते हैं, लेकिन बढ़िया नतीजे के लिए आमतौर पर कहीं न कहीं एक पेड चरण लगता है।
कस्टम AI एक्टर असल में क्या है
यह शब्द ढीले-ढाले ढंग से इस्तेमाल होता है, तो इसे साफ़ कर लेते हैं। कस्टम AI एक्टर एक ऐसा दोहराया जा सकने वाला स्क्रीन पर आने वाला परफ़ॉर्मर है, जो आपकी अपनी सामग्री से या किसी काल्पनिक किरदार से बनता है। एक बार यह बन जाए, तो आप उसे स्क्रिप्ट देते हैं और वह कैमरे पर संवाद बोल देता है। न लाइट चाहिए, न रीटेक, न स्टूडियो बुक करना।
तीन परतें
हर एक्टर, चाहे टूल पर उसका ब्रांड नाम कुछ भी हो, एक ही तीन हिस्सों से बनता है:
| परत | यह क्या करती है | आम इनपुट |
|---|
| चेहरा और शरीर | एक्टर कैसा दिखता है और कैसे हिलता है, यह तय करती है | एक फ़ोटो, या 1 से 2 मिनट का फ़ुटेज |
| आवाज़ | एक्टर कैसा सुनाई देता है, यह तय करती है | 10 से 60 सेकंड का सैंपल, या टेक्स्ट में विवरण |
| लिप सिंक | होंठों की हरकत को ऑडियो से मिलाती है | चेहरा और एक ऑडियो फ़ाइल |
कुछ प्लेटफ़ॉर्म तीनों को एक साथ देते हैं और एक ही सब्सक्रिप्शन लेते हैं। दूसरे आपको हर परत अलग से चुनने देते हैं, जो सस्ता और ज़्यादा लचीला है, पर इसमें कुछ और क्लिक लगते हैं।
अवतार, डिजिटल ट्विन या एक्टर?
अवतार आमतौर पर एक स्टॉक प्रेज़ेंटर होता है, जिसे आप मेन्यू से चुनते हैं। डिजिटल ट्विन किसी असली इंसान की कॉपी होता है। कस्टम AI एक्टर इनमें से कुछ भी हो सकता है, ट्विन भी या कोई काल्पनिक किरदार भी, और असली बात "कस्टम" शब्द में है: पहचान, पोशाक, सेटिंग और आवाज़ पर नियंत्रण आपके हाथ में रहता है, बजाय इसके कि ऐसा चेहरा किराए पर लें जो हज़ारों दूसरे ब्रांड भी इस्तेमाल कर रहे हैं।
अभी इन्हें कौन बना रहा है
तीन समूह इसे सबसे ज़्यादा अपना रहे हैं। अकेले कंटेंट क्रिएटर, जो रोज़ पब्लिश करना चाहते हैं, बिना रोज़ शूट किए। छोटे कारोबार, जिन्हें प्रोडक्ट वीडियो चाहिए पर कोई क्रू नहीं है। और ट्रेनिंग या मार्केटिंग टीमें, जिन्हें एक ही संदेश कई भाषाओं में चाहिए। अगर आप इनमें से किसी में आते हैं, तो नीचे का आर्थिक हिसाब शायद आपके लिए सही बैठेगा।
फ़्री विकल्प जो सच में काम करते हैं
"फ़्री" तीन तरह का होता है, और इन्हें आपस में मिला देने से निराशा होती है।
सीमाओं वाले फ़्री प्लान
HeyGen, Vidnoz और Hedra समेत कई जाने-माने अवतार प्लेटफ़ॉर्म एक फ़्री टियर देते हैं, जिसे आप बिना क्रेडिट कार्ड के खोल सकते हैं। असल में इसका मतलब है थोड़े क्रेडिट, छोटी क्लिप, कम रिज़ॉल्यूशन और एक वॉटरमार्क। ये प्लान वर्कफ़्लो आज़माने के लिए होते हैं, तैयार काम पब्लिश करने के लिए नहीं। खासकर वॉइस क्लोनिंग आमतौर पर पेड टियर में होती है, इसलिए फ़्री प्लान में अक्सर सिर्फ़ स्टॉक आवाज़ें मिलती हैं।
मॉडल लाइब्रेरी के अंदर फ़्री जनरेशन
एक अलग रास्ता यह है कि अलग-अलग मॉडल इस्तेमाल करें और सिर्फ़ उन हिस्सों का भुगतान करें जिनकी आपको ज़रूरत है। PicassoIA पर आप चेहरा, आवाज़ और लिप सिंक अलग-अलग मॉडल से बना सकते हैं, इसलिए आप किसी एक वेंडर की प्राइसिंग से बंधे नहीं रहते। Nano Banana Pro या Seedream 4.5 जैसे इमेज मॉडल बेस पोर्ट्रेट बनाते हैं, और एक लिपसिंक मॉडल उसमें जान डाल देता है।
पेड टूल्स के फ़्री ट्रायल
Synthesia और इसी स्तर के दूसरे स्टूडियो-ग्रेड प्रोडक्ट कभी-कभी छोटे फ़्री डेमो चलाते हैं। ये क्वालिटी परखने के लिए अच्छे हैं, पर डेमो वाला अवतार अक्सर वह कस्टम वर्ज़न नहीं होता जिसके लिए आप बाद में भुगतान करेंगे। हमेशा पूछें कि ट्रायल में आपका अपना चेहरा और अपनी आवाज़ शामिल है या नहीं, क्योंकि यही वह हिस्सा है जिस पर पैसा खर्च होता है।
💡 नियम: अगर कोई फ़्री टियर आपको अपनी फ़ोटो और अपना ऑडियो अपलोड करने देता है, तो वह असली टेस्ट है। अगर वह सिर्फ़ स्टॉक प्रेज़ेंटर देता है, तो आप इंटरफ़ेस को परख रहे हैं, नतीजे को नहीं।
फ़्री में लगभग कभी क्या शामिल नहीं होता
- अपनी रिकॉर्डिंग से वॉइस क्लोनिंग
- बिना वॉटरमार्क का आउटपुट
- कमर्शियल उपयोग के अधिकार
- कई मिनट की लंबी क्लिप
प्लान की तुलना करते समय यह सूची अपने पास रखें। ज़्यादातर कीमतों का फ़र्क इसी से समझ आता है।
वीडियो उदाहरण जो आप आज बना सकते हैं
उपयोग के मामले देखना किसी भी फ़ीचर टेबल से ज़्यादा मदद करता है। ये वे स्थितियाँ हैं जहाँ कस्टम AI एक्टर पहले से अपनी लागत निकाल देता है।
अकेला कंटेंट क्रिएटर
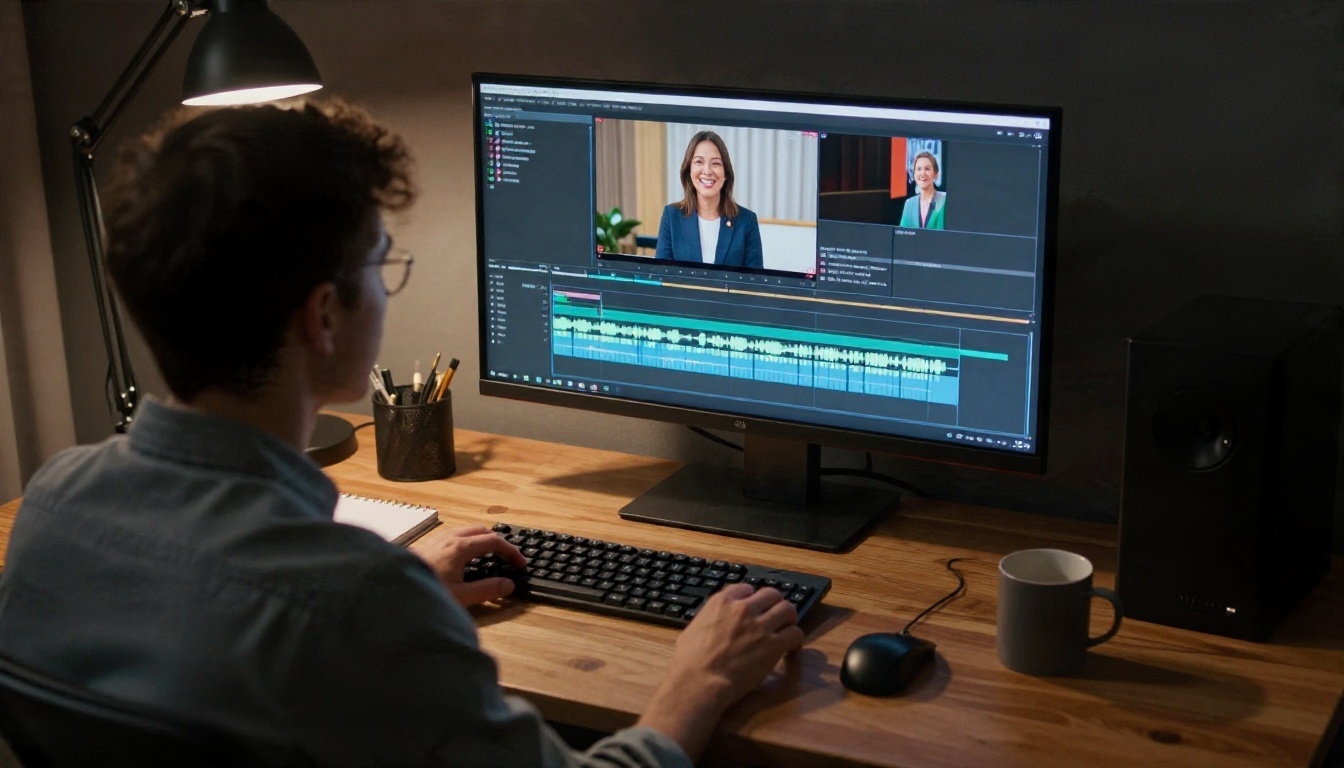
एक बार अच्छी रोशनी में, सहज ढंग से लेंस से बात करते हुए खुद को शूट करें। वही सेशन आपका रेफ़रेंस बन जाता है। उसके बाद नई स्क्रिप्ट नई क्लिप बन जाती हैं: साप्ताहिक अपडेट, छोटे एक्सप्लेनर, चैनल इंट्रो। ऊपर दिखी एडिटिंग टाइमलाइन ज़्यादातर क्रिएटर्स के लिए असली बाधा है, और AI एक्टर उस काम का शूटिंग वाला हिस्सा हटा देता है।
Omni Human 1.5 जैसा मॉडल इसी के लिए बना है। आप एक सिंगल पोर्ट्रेट और एक ऑडियो ट्रैक देते हैं, और वह प्राकृतिक सिर की हरकत और इशारों वाला टॉकिंग वीडियो लौटाता है, सिर्फ़ हिलता हुआ जबड़ा नहीं।
कॉर्पोरेट प्रेज़ेंटर
ऑनबोर्डिंग वीडियो, कंप्लायंस अपडेट और आंतरिक घोषणाएँ लगातार बदलती रहती हैं। हर बार किसी मैनेजर को दोबारा शूट करना महंगा और अटपटा होता है। डिजिटल ट्विन के साथ आप स्क्रिप्ट बदलते हैं और फिर से जनरेट कर लेते हैं। चेहरा एक-सा रहता है, इसलिए दर्शकों को एक जाना-पहचाना प्रेज़ेंटर मिलता है, न कि स्टॉक अवतारों की बदलती भीड़।
साफ़ नतीजों के लिए Lipsync 2 Pro अच्छा काम करता है, जब आपके पास प्रेज़ेंटर का फ़ुटेज पहले से हो और बस नए शब्दों को होंठों में फ़िट करना हो।
छोटे कारोबार के मालिक
एक दुकान मालिक के पास सौ प्रोडक्ट होते हैं और समय शून्य। एक शूट किया गया अभिवादन, जिसे AI एक्टर आगे बढ़ा दे, हर आइटम को मालिक के अपने चेहरे के साथ पेश कर सकता है। नतीजा निजी लगता है, और स्थानीय ब्रांड्स के लिए निजीपन परफ़ेक्शन से ज़्यादा मायने रखता है। जब आपकी शुरुआत सिर्फ़ एक फ़ोटो से हो, तब Fabric 1.0 एक काम का विकल्प है।
एनिमेटेड किरदार
हर एक्टर का इंसान होना ज़रूरी नहीं। अगर आप इमेज मॉडल से कोई किरदार गढ़ते हैं और उसे P Video Avatar को देते हैं, तो आपको एक मैस्कॉट मिलता है जो कोई भी स्क्रिप्ट बोल सकता है। उन दृश्यों के लिए जहाँ एक्टर बैठकर बात करने के बजाय किसी जगह में घूमता है, Kling v3 Video और Veo 3.1 आसपास का फ़ुटेज जनरेट कर सकते हैं, और Kling v3 Motion Control किसी रेफ़रेंस क्लिप की हरकत को किरदार पर कॉपी करने देता है।
वॉइस: उसे क्लोन करें या डिज़ाइन करें
एक शानदार चेहरे के साथ सपाट आवाज़ कुछ ही सेकंड में भ्रम तोड़ देती है। ऑडियो को उतना ही ध्यान चाहिए जितना तस्वीर को।
अपनी आवाज़ क्लोन करना
वॉइस क्लोनिंग के लिए एक साफ़ सैंपल चाहिए। शांत कमरे में रिकॉर्ड करें, स्वाभाविक गति से बोलें और बैकग्राउंड म्यूज़िक से बचें। काम लायक क्लोन के लिए अक्सर दस से साठ सेकंड काफ़ी होते हैं, हालाँकि लहजे में ज़्यादा विविधता से नतीजा ज़्यादा जीवंत बनता है। Qwen3 TTS छोटे सैंपल से आवाज़ क्लोन कर सकता है या लिखे हुए विवरण से नई आवाज़ डिज़ाइन कर सकता है, जिससे यह एक लचीला शुरुआती बिंदु बन जाता है।
स्टॉक आवाज़ चुनना
अगर वीडियो पर आपकी अपनी आवाज़ नहीं चाहिए, तो स्टॉक आवाज़ें तेज़ और सस्ती होती हैं। अच्छे विकल्पों में ElevenLabs V3 भावपूर्ण डिलीवरी के लिए, Speech 2.8 HD स्टूडियो-क्वालिटी नैरेशन के लिए, और Gemini 3.1 Flash TTS जब 70+ भाषाओं में कई आवाज़ें चाहिए, शामिल हैं।
दूसरी भाषाएँ बोलना
यहीं AI एक्टर पारंपरिक शूट से आगे निकल जाते हैं। एक रिकॉर्डिंग से स्पैनिश, फ़्रेंच और जापानी वर्ज़न बन सकते हैं, बिना एक भी रीशूट के। Video Translate मौजूदा फ़ुटेज को 150+ भाषाओं में डब करता है, और होंठों को नई भाषा के हिसाब से दोबारा टाइम किया जाता है, ताकि नतीजा खराब डब जैसा न लगे।
💡 टिप: स्क्रिप्ट छोटे वाक्यों में लिखें। लिप सिंक मॉडल 8 से 15 शब्दों की लाइनों को लंबी, उलझी लाइनों से कहीं बेहतर संभालते हैं, और अनुवाद का टाइमिंग भी आसान रहता है।
वॉइस की एक नज़र में तुलना
असली प्राइसिंग, पंक्ति दर पंक्ति
कीमतें तेज़ी से बदलती हैं, और कई तुलना लेख वेंडर खुद लिखते हैं, इसलिए नीचे की हर संख्या को एक रेंज मानें और खरीदने से पहले आधिकारिक प्राइसिंग पेज पर जाँच लें। यहाँ सामान्य तस्वीर है।
सब्सक्रिप्शन की लागत
ज़्यादातर ऑल-इन-वन अवतार प्लेटफ़ॉर्म एक जैसी सीढ़ी पर चलते हैं:
| टियर | आम तौर पर मासिक कीमत | आमतौर पर आपको क्या मिलता है |
|---|
| Free | $0 | कुछ क्रेडिट, वॉटरमार्क, स्टॉक वॉइस, कम रिज़ॉल्यूशन |
| एंट्री-लेवल पेड | लगभग $7 से $30 | ज़्यादा मिनट, बिना वॉटरमार्क, कभी-कभी बेसिक वॉइस क्लोनिंग |
| मिड-रेंज | लगभग $30 से $100 | कस्टम अवतार, वॉइस क्लोनिंग, लंबे वीडियो, कमर्शियल अधिकार |
| स्टूडियो और एंटरप्राइज़ | कस्टम कोटेशन | कई सीटें, API, ब्रांड कंट्रोल, सिक्योरिटी रिव्यू |
कुछ टूल कस्टम अवतार और वॉइस क्लोनिंग प्रति माह लगभग $15 से दिखाते हैं, जबकि Synthesia जैसे एंटरप्राइज़-ग्रेड स्टूडियो क्रेडिट और सीटें गिनने पर इससे कहीं ऊपर पहुँच जाते हैं। उदाहरण के लिए, Vidnoz के बारे में बताया गया है कि वह वॉइस क्लोनिंग को अपने ऊँचे बिज़नेस टियर के लिए रखता है।
प्रति-उपयोग लागत कम क्यों हो सकती है
सब्सक्रिप्शन चाहे आप पब्लिश करें या नहीं, आपसे शुल्क लेता है। मॉडल लाइब्रेरी में आप वही भुगतान करते हैं जो आप जनरेट करते हैं। अगर आप महीने में चार क्लिप बनाते हैं, तो यह मासिक प्लान से काफ़ी सस्ता पड़ सकता है। अगर आप चार सौ बनाते हैं, तो सब्सक्रिप्शन जीत सकता है। चुनने से पहले हिसाब लगा लें।
छिपी हुई लागतें
- रीरेंडर: खराब लिप सिंक पास की लागत भी उतनी ही होती है जितनी अच्छे की, इसलिए पहले 5 सेकंड की क्लिप से टेस्ट करें।
- रिज़ॉल्यूशन अपग्रेड: 1080p या 4K आउटपुट अक्सर ऊँचे टियर में आता है।
- कमर्शियल अधिकार: कुछ फ़्री और निचले टियर विज्ञापन उपयोग पर रोक लगाते हैं।
- वॉइस स्लॉट: कई प्लान यह सीमित करते हैं कि आप कितनी क्लोन की गई आवाज़ें रख सकते हैं।
एक नमूना बजट
जो क्रिएटर महीने में लगभग 20 छोटी क्लिप बनाता है, उसके लिए एक समझदार योजना है: एक पेड वॉइस टूल, एक लिपसिंक मॉडल और बेस पोर्ट्रेट के लिए एक इमेज मॉडल। इससे मासिक खर्च कम रहता है, और जब कोई बेहतर विकल्प आए तो आप कोई एक हिस्सा बदल सकते हैं।
एक दोपहर में पूरा होने वाला वर्कफ़्लो
यह एक व्यावहारिक क्रम है जो PicassoIA पर अलग-अलग मॉडल की लाइब्रेरी के साथ काम करता है।
चरण 1: साफ़ पोर्ट्रेट लें
नरम खिड़की की रोशनी में, सादी पृष्ठभूमि के सामने, सामने से एक फ़ोटो खींचें। चेहरा सहज हो, होंठ बंद या हल्के खुले हों। धूप के चश्मे, गहरी छाया और तिरछे कोणों से बचें। अगर आप काल्पनिक एक्टर चाहते हैं, तो Nano Banana Pro से पोर्ट्रेट बनाएँ और प्राकृतिक त्वचा की बनावट और सादे बैकड्रॉप का प्रॉम्प्ट दें।
चरण 2: आवाज़ तैयार करें
अपना सैंपल रिकॉर्ड करें, या आवाज़ का विवरण लिखें। अपनी स्क्रिप्ट को Qwen3 TTS या ElevenLabs V3 जैसे TTS मॉडल से चलाएँ और ऑडियो एक्सपोर्ट करें। उसे आँखें बंद करके सुनें। अगर वह अकड़ा हुआ लगे, तो विराम चिह्न बदलें, क्योंकि अल्पविराम और पूर्णविराम ही गति तय करते हैं।
चरण 3: चेहरे में जान डालें
एक लिपसिंक मॉडल खोलें, पोर्ट्रेट और ऑडियो अपलोड करें, और एक छोटा टेस्ट जनरेट करें। Omni Human 1.5 इशारों और ऊपरी शरीर की हरकत को संभालता है, जबकि Kling Lip Sync तब काम का है जब आपके पास पहले से वीडियो हो और बस होंठों को बदलना हो।
चरण 4: समीक्षा करें और पब्लिश करें
क्लिप को फ़ुल स्क्रीन पर देखें। दाँत, पलकें झपकना, और वाक्य के अंत में होंठों का बंद होने का क्षण जाँचें। ज़्यादातर खामियाँ इन्हीं तीन जगहों पर दिखती हैं। पहले ऑडियो ठीक करें, क्योंकि ऑडियो की समस्या वीडियो की समस्या से सस्ती सुधरती है।
💡 पैरामीटर टिप: पहला टेस्ट दस सेकंड से छोटा रखें। अगर चेहरा वहाँ ठीक रहता है, तो स्क्रिप्ट आगे बढ़ाएँ। अगर वह बिखरने लगे, तो सेटिंग्स नहीं, सोर्स फ़ोटो बदलें।
वे गलतियाँ जो नतीजा बिगाड़ती हैं
ज़्यादातर असफल AI एक्टरों में बस गिनी-चुनी गलतियाँ ही होती हैं।
कमज़ोर सोर्स फ़ोटो इस्तेमाल करना
कम रिज़ॉल्यूशन, तिरछी या भारी फ़िल्टर वाली इमेज मॉडल को काम करने के लिए कुछ नहीं देती। अपनी सबसे साफ़, सबसे समान रोशनी वाली इमेज से शुरुआत करें।
ऑडियो क्वालिटी को नज़रअंदाज़ करना
कमरे की गूंज, लैपटॉप के माइक्रोफ़ोन और बैकग्राउंड की गुंजन क्लोन की गई आवाज़ में कॉपी हो जाते हैं। एक शांत कमरे और ठीक-ठाक माइक्रोफ़ोन पर दस मिनट लगाएँ।
कान के लिए नहीं, पन्ने के लिए लिखना
औपचारिक वाक्य बोले जाने पर रोबोटिक लगते हैं। पहले स्क्रिप्ट ज़ोर से पढ़ें। अगर आप अटकते हैं, तो एक्टर भी अटकेगा।
सहमति और खुलासे को नज़रअंदाज़ करना
सिर्फ़ उन्हीं आवाज़ों और चेहरों को क्लोन करें जिनके इस्तेमाल की आपको अनुमति है, और जहाँ प्लेटफ़ॉर्म या स्थानीय नियम माँगें, वहाँ सिंथेटिक कंटेंट पर लेबल लगाएँ। इससे आप और आपके दर्शक, दोनों सुरक्षित रहते हैं, और अब यह तेज़ी से ज़रूरी भी हो रहा है।
एक टूल से सब कुछ की उम्मीद करना
सबसे अच्छे नतीजे अक्सर विशेषज्ञ मॉडलों को जोड़ने से आते हैं: चेहरे के लिए इमेज मॉडल, आवाज़ के लिए TTS मॉडल, मुँह के लिए लिपसिंक मॉडल। पूरा काम दोबारा शुरू किए बिना हर हिस्सा बदला जा सकता है।
आज ही अपना एक्टर बनाएँ
अब आपके पास पूरी तस्वीर है: एक चेहरा, एक आवाज़, एक लिप सिंक पास, और ऐसा बजट जो आपके पब्लिश करने की आवृत्ति के हिसाब से फ़िट बैठे। यह जानने का सबसे तेज़ तरीका किसी और तुलना को पढ़ना नहीं, बल्कि एक छोटा टेस्ट चलाना है।
Picasso IA खोलें और इस चेन को खुद आज़माएँ। एक पोर्ट्रेट बनाएँ, उसे आवाज़ दें, और Omni Human 1.5 या Fabric 1.0 जैसे लिपसिंक मॉडल से उसे बुलवाएँ। एक बार में एक मॉडल बदलें, नतीजों की तुलना करें, और वही संयोजन रखें जो आपकी तरह दिखे और आपकी तरह सुनाई दे। आपकी पहली बोलती क्लिप आपकी चाय ठंडी होने से पहले तैयार हो सकती है।


