عندما تكتب أمرًا نصيًا في أداة لتوليد الصور بالذكاء الاصطناعي، فيظهر لك خلال ثوانٍ مشهد واقعي كالصور الفوتوغرافية، يسهل أن تنسى أن النموذج الذي يقوم بهذا العمل لم يكن بهذه القدرة في البداية. فقد بدأ كصفحة بيضاء، مليارات الأرقام العشوائية، ثم تشكّل تدريجيًا ليصبح أداة مفيدة عبر عملية استغرقت شهورًا، واستخدمت آلاف وحدات GPU، وبيانات بحجم البيتابايت. تُسمّى هذه العملية التدريب، وهي بالنسبة إلى نماذج الذكاء الاصطناعي مفتوحة المصدر عملية يمكن، من حيث المبدأ، لأي شخص أن يعيد إنتاجها أو يفحصها أو يطوّرها.
يشرح هذا المقال بالتفصيل كيف تُدرَّب نماذج الذكاء الاصطناعي مفتوحة المصدر، بدءًا من جمع البيانات الخام وصولًا إلى تشغيل الأوزان النهائية بمساهمة أعضاء المجتمع.
ماذا يعني "التدريب" فعلًا
النموذج يبدأ من الصفر
قبل أن يبدأ التدريب، لا تكون الشبكة العصبية سوى مجموعة كبيرة من المعاملات العددية تُسمّى الأوزان. وعند التهيئة تكون هذه الأوزان عادةً عشوائية. فالشبكة لا تعرف شكل القط، ولا معنى القواعد النحوية، ولا كيف تتنبأ بالبكسل التالي في الصورة. كل ذلك يأتي من التعرّض للبيانات.
التدريب هو عملية تعديل هذه الأوزان عبر ملايين التكرارات حتى يُنتج النموذج مخرجات مفيدة بشكل موثوق. فكّر في الأمر كتعلّم بالتكرار، مع فارق أن "المتعلّم" هنا ليس دماغًا بشريًا، بل دالة رياضية تملك مليارات المقابض القابلة للضبط.
البيانات هي كل شيء
أهم عنصر في التدريب ليس البنية ولا العتاد، بل البيانات. النموذج لا يكون جيدًا إلا بقدر ما عُرض عليه. فإذا كانت مجموعة البيانات متحيزة أو ناقصة أو منخفضة الجودة، فإن هذه العيوب تترسخ مباشرةً في سلوك النموذج.
بالنسبة إلى نماذج توليد الصور مثل Flux Dev أو Stable Diffusion، تتكون بيانات التدريب من مئات الملايين من أزواج الصورة والنص: صورة لغروب شمس مقترنة بالتعليق "الساعة الذهبية فوق المحيط"، وهكذا. يتعلم النموذج ربط المحتوى البصري باللغة من خلال رؤية عدد كافٍ من هذه الأزواج.
من أين تأتي البيانات
زحف الويب ومجموعات البيانات المرخّصة
يأتي معظم بيانات التدريب للنماذج الكبيرة المفتوحة المصدر من زحف الويب. تقوم مشاريع مثل Common Crawl بجمع مليارات صفحات الويب وإتاحة هذه البيانات للاستخدام البحثي والتجاري. وبالنسبة إلى نماذج الصور تحديدًا، جمعت مجموعات بيانات مثل LAION-5B أزواج الصور والنصوص من مختلف أنحاء الإنترنت، لتوفر المادة الخام لتدريب النماذج على نطاق واسع.
إلى جانب زحف الويب العام، تستخدم المؤسسات بشكل متزايد مجموعات بيانات مرخّصة من مكتبات الصور المدفوعة، والمنشورات العلمية، والمستودعات المنتقاة. ويكتسب هذا أهمية أكبر من أي وقت مضى مع استمرار تغيّر المشهد القانوني المحيط ببيانات التدريب.
ملاحظة: ليست كل البيانات الموجودة على الإنترنت متاحة قانونيًا للتدريب. تختلف نماذج الذكاء الاصطناعي مفتوحة المصدر اختلافًا كبيرًا في مدى شفافيتها بشأن مصدر بياناتها، وتتسع فجوة هذه الشفافية مع تزايد التحديات القانونية.
الجودة تتفوق على الحجم
لا تنتج مجموعات البيانات الأكبر حجمًا نماذج أفضل تلقائيًا. فقد وجد باحثون في Stability AI و Black Forest Labs (الفريق الذي يقف وراء Flux Schnell وFlux Pro) باستمرار أن تصفية الصور منخفضة الجودة، وإزالة النسخ المكررة، وموازنة التمثيل عبر الموضوعات، تنتج مخرجات أفضل بشكل ملحوظ من مجرد إضافة المزيد من البيانات.
تنسيق البيانات تخصص قائم بذاته. فالفرق التي تضم مُصنِّفين وخطوط تصفية آلية تبذل جهدًا كبيرًا لضمان أن ما يدخل حلقة التدريب يستحق فعلًا أن يُتدرَّب عليه.
حلقة التدريب خطوةً بخطوة
التمرير الأمامي والتنبؤات والخسارة
بمجرد أن تصبح البيانات جاهزة، تعمل عملية التدريب في حلقة متواصلة. في كل تكرار، يتلقى النموذج دفعة من أمثلة التدريب ويُنتج تنبؤات. بالنسبة إلى نموذج توليد الصور، قد يعني هذا: بالنظر إلى نسخة مشوّشة من صورة وأمر نصي، تنبأ بشكل الصورة الأصلية النظيفة.
تُقاس الفجوة بين تنبؤ النموذج والإجابة الصحيحة بواسطة دالة الخسارة. والخسارة رقم واحد: كلما انخفض كان النموذج أداؤه أفضل، وكلما ارتفع كان أداؤه أسوأ. في بداية التدريب تكون الخسارة مرتفعة لأن الأوزان ما زالت عشوائية في جوهرها. والهدف الكامل من التدريب هو خفض هذا الرقم باستمرار عبر ملايين التكرارات.
الانتشار الخلفي بلغة مبسّطة
بعد حساب الخسارة، يحتاج النموذج إلى معرفة أي الأوزان ساهم في الخطأ، وبأي مقدار. ويتم ذلك عبر الانتشار الخلفي، وهو خوارزمية تعمل عكسيًا عبر طبقات الشبكة، وتحسب تدرّج الخسارة بالنسبة إلى كل وزن.
التدرّج له اتجاه ومقدار: فهو يخبرك ما إذا كانت زيادة وزن معيّن أو خفضه سيرفع الخسارة أو يخفضها. ومع مئات المليارات من الأوزان في النموذج الحديث، يتطلب حساب كل هذه التدرجات في وقت واحد أدوات رياضية ضخمة، لكن المنطق الأساسي بسيط.
كيف يعمل الانحدار التدرّجي
بعد أن يحسب الانتشار الخلفي التدرجات، يستخدم الانحدار التدرّجي هذه التدرجات لتحديث الأوزان. والفكرة مباشرة: تحريك كل وزن قليلًا في الاتجاه الذي يقلل الخسارة.
يتحكم معدل التعلّم في حجم كل خطوة. فإذا كان كبيرًا جدًا يتجاوز النموذج الهدف ويرتد دون أن يستقر. وإذا كان صغيرًا جدًا يستغرق التدريب وقتًا طويلًا جدًا.
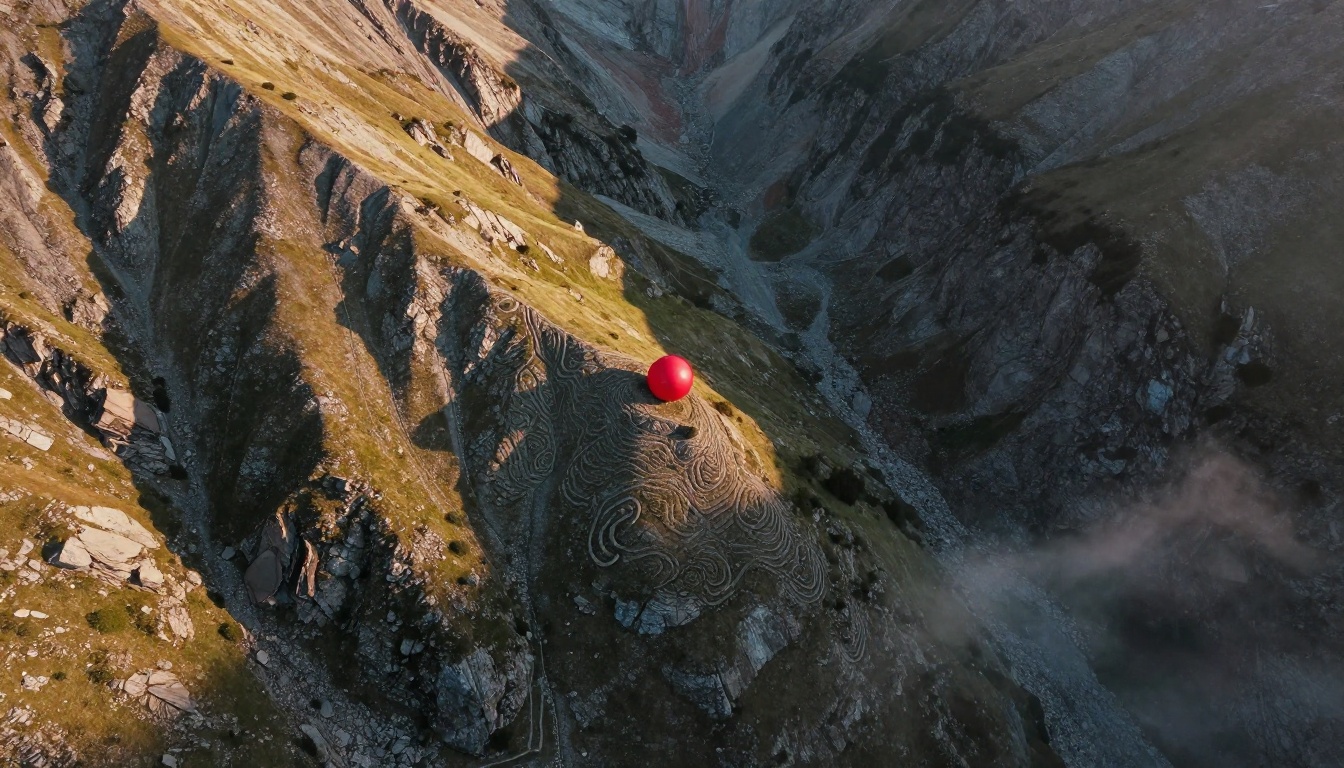
تشبيه مفيد: تخيّل الخسارة كمشهد طبيعي حقيقي فيه جبال ووديان. تضع الأوزان الحالية النموذج عند نقطة معيّنة على هذه التضاريس. والانحدار التدرّجي هو عملية أخذ خطوات صغيرة متكررة نحو الأسفل، باتجاه أدنى وادٍ.
تتكرر هذه الحلقة، أي التمرير الأمامي وحساب الخسارة والانتشار الخلفي للتدرجات وتحديث الأوزان، مليارات المرات خلال عملية التدريب. ويُسمّى كل مرور على دفعة من البيانات خطوة، أما المرور الكامل على مجموعة البيانات بأكملها فيُسمّى حقبة.
| المصطلح | معناه |
|---|
| دالة الخسارة | تقيس الخطأ بين التنبؤ والواقع |
| الانتشار الخلفي | يحسب الأوزان التي تسببت في الخطأ |
| الانحدار التدرّجي | يحدّث الأوزان لتقليل الخطأ |
| معدل التعلّم | يتحكم في حجم كل تحديث للأوزان |
| الحقبة | مرور كامل واحد على مجموعة بيانات التدريب |
ما الذي يجعل النموذج "مفتوح المصدر"
الأوزان المفتوحة مقابل المفتوح المصدر بالكامل
هذا التمييز أهم مما يدركه معظم الناس. فالنموذج ذو الأوزان المفتوحة يجعل معاملاته المدرّبة متاحة للتنزيل العام. يمكنك تشغيله محليًا، وضبطه بدقة، وبناء تطبيقات فوقه. تنتمي نماذج مثل SDXL وStable Diffusion 3.5 Large إلى هذه الفئة.
أما النموذج المفتوح المصدر بالكامل فيُطلق أيضًا كود التدريب، ومجموعة البيانات، والوثائق التي تغطي خط العمل بأكمله. وعدد النماذج التي تبلغ هذا المستوى الأعلى أقل بكثير.
تستحق المعرفة: "المصدر المفتوح" في الذكاء الاصطناعي ليس دائمًا هو نفسه المصدر المفتوح في البرمجيات. فكثير من نماذج الذكاء الاصطناعي الشائعة التي يسميها الناس مفتوحة المصدر تشارك الأوزان فقط، لا الوصفة الكاملة المستخدمة في إنشائها.
لماذا يهم ذلك المبدعين
تهم الأوزان المفتوحة الممارسين كثيرًا. فهي تتيح تشغيل النموذج دون تكاليف API، وتشغيله على عتادك الخاص، وتعديل الأوزان لحالات استخدام محددة. كما تتيح للمجتمع تدقيق النموذج بحثًا عن التحيزات، وبناء أدوات للسلامة، وإصدار نسخ محسّنة منه.
تمثل نماذج مثل Flux 1.1 Pro Ultra وImagen 4 فلسفات مختلفة على هذا الطيف، إذ يعطي بعضها الأولوية لإتاحة الوصول عبر الأوزان المفتوحة، بينما تبقى أخرى مغلقة لأسباب تتعلق بالجودة أو السلامة.
الضبط الدقيق بعد التدريب المسبق
LoRA والمحوّلات
ينتج التدريب المسبق نموذجًا عامًا الغرض، لكنه نادرًا ما يكون الخطوة الأخيرة. الضبط الدقيق يكيّف نموذجًا مدرّبًا مسبقًا ليؤدي بشكل أفضل في مجال أو أسلوب محدد. والمشكلة أن الضبط الدقيق الكامل لنموذج يضم مليار معامل مكلف وبطيء.
تحل LoRA (التكيّف منخفض الرتبة) هذه المشكلة بتجميد أوزان النموذج الأصلية وإدراج مصفوفات صغيرة قابلة للتدريب في طبقات محددة. فبدلًا من إعادة تدريب كل شيء، تدرّب فقط أوزان محوّل LoRA، وهي جزء ضئيل من إجمالي عدد المعاملات. والنتيجة نموذج يتصرف بشكل مختلف في جوانب مستهدفة، مع احتفاظه بكل معرفته الأساسية.
هذه هي الطريقة التي يعمل بها Flux Dev LoRA تحديدًا على PicassoIA. يبقى نموذج Flux Dev الأساسي ثابتًا، بينما تُوجّه مجموعة صغيرة من الأوزان المتعلَّمة المخرجات نحو أساليب بصرية أو شخصيات أو موضوعات محددة. ويستطيع أي شخص يملك عتادًا متواضعًا تدريب LoRA على بضع مئات من الصور، وإنتاج نموذج يولّد جمالية معينة بشكل موثوق.
RLHF والمواءمة
بالنسبة إلى النماذج اللغوية، وبشكل متزايد لمولّدات الصور، يُستخدم التعلّم المعزّز من تغذية راجعة بشرية (RLHF) بعد التدريب المسبق لجعل المخرجات أكثر توافقًا مع ما يريده الناس فعلًا. تتضمن العملية قيام مُقيِّمين بشريين بتقييم مخرجات النموذج، وتدريب نموذج مكافأة منفصل على هذه التقييمات، ثم استخدام التعلّم المعزّز لدفع النموذج الرئيسي نحو السلوك الأعلى تقييمًا.
الفرق بين نموذج مدرّب مسبقًا خام قادر على إنتاج أي شيء، ونموذج يُنتج بشكل موثوق مخرجات مفيدة وآمنة وعالية الجودة، هو ما يصنعه RLHF. وهو مكلف حسابيًا ويتطلب تصميمًا دقيقًا، لكن تأثيره على جودة المخرجات كما يدركها المستخدم كبير.
العتاد المطلوب
مجموعات GPU على نطاق واسع
يتطلب تدريب نموذج ذكاء اصطناعي كبير مجموعة منسّقة تضم مئات أو آلاف وحدات GPU تعمل بالتوازي لأسابيع أو شهورًا. وتستخدم عمليات التدريب الحديثة للنماذج المتقدمة مجموعات NVIDIA H100 مترابطة عبر NVLink وشبكات InfiniBand عالية النطاق، لتوزيع الحسابات على آلاف الشرائح في وقت واحد.
ضرورة التوازي واضحة: فتمرير أمامي وخلفي واحد عبر نموذج كبير ينتج عمليات فاصلة عائمة أكثر مما تستطيع أي وحدة GPU منفردة إنجازه في وقت معقول. وتوزيع العمل على وحدات كثيرة، تعالج كل منها شريحة من البيانات أو جزءًا من النموذج، هو الطريقة العملية الوحيدة على نطاق واسع.
لماذا تكلّف عمليات التدريب الملايين
تكلّف وحدة NVIDIA H100 الواحدة أكثر من 25,000 دولار، وقد تستخدم عملية تدريب تنافسية آلاف منها لشهور. وإلى جانب تكاليف العتاد، هناك الكهرباء (تستهلك عمليات التدريب الكبيرة ميغاواط)، والبنية التحتية للتبريد، ورسوم الحوسبة السحابية، وعمل فرق البحث.
لهذا السبب لا تستطيع سوى حفنة من المؤسسات تدريب نماذج أساسية كبيرة حقًا من الصفر. ويبني مجتمع المصدر المفتوح عادةً فوق هذه النماذج الأساسية عبر الضبط الدقيق والتكييف، وهو أرخص بمراتب من حيث الحجم، ومع ذلك يحقق نتائج لافتة.
| نهج التدريب | التكلفة التقريبية | من يقوم به |
|---|
| التدريب المسبق من الصفر | من 1 مليون دولار إلى أكثر من 100 مليون دولار | مختبرات بحثية كبيرة، وشركات ناشئة ممولة جيدًا |
| الضبط الدقيق الكامل | من 10 آلاف دولار إلى 500 ألف دولار | فرق بحثية متوسطة الحجم |
| ضبط LoRA الدقيق | من 50 دولارًا إلى 5,000 دولار | باحثون أفراد، وفرق صغيرة |
| تشغيل النموذج | سنتات لكل طلب | أي شخص |
نماذج مفتوحة تشغّل فن الذكاء الاصطناعي اليوم
Flux وStable Diffusion وغيرها
تنحدر تقريبًا كل النماذج التي تشغّل توليد الصور بالذكاء الاصطناعي الحديث من تقليد المصدر المفتوح. فقد أثبت Stable Diffusion في عام 2022 أنه يمكن تدريب نموذج توليد صور عالي الجودة وإطلاقه بشكل مفتوح، ما أدى إلى انفجار في الابتكار المجتمعي. وتلا ذلك خلال شهور آلاف عمليات الضبط الدقيق ومحوّلات LoRA والنماذج المشتقة.
يمثل Flux Dev وFlux Pro من Black Forest Labs الخطوة التالية: بنية قائمة على المحوّلات (transformer) مدرّبة على نطاق أكبر، مع فهم أفضل بكثير للنصوص وواقعية أعلى. ويستند نهج التدريب إلى المبادئ نفسها الموصوفة في هذا المقال، لكن بمزيد من البيانات والحوسبة، وتحسينات معمارية حسّنت التماسك والالتزام بالأمر النصي.
وسّع SDXL نموذج Stable Diffusion الأصلي عبر توسيع كل من النموذج ومجموعة بيانات التدريب، فأنتج مخرجات بدقة أعلى وتفاصيل أكثر وضوحًا. أما Stable Diffusion 3.5 Large فذهب أبعد من ذلك، إذ اعتمد بنية محوّل انتشار متعدد الوسائط تنتج تكوينات أوضح وتوافقًا دلاليًا أفضل.
مرّ كل من هذه النماذج بالعملية الأساسية نفسها: تنسيق مجموعة البيانات، والتدريب المسبق مع تقليل الخسارة عبر الانحدار التدرّجي، ثم الضبط الدقيق لمواءمة المخرجات مع تفضيلات البشر.
جرّبها على PicassoIA الآن
جميع النماذج التي تناولناها هنا متاحة للتشغيل مباشرةً على PicassoIA. لا حاجة إلى إعداد محلي، ولا إلى متطلبات عتاد، ولا إلى إدارة ملفات الأوزان أو بيئات Python. يمكنك تجربة:
- Flux Dev: النموذج الرائد ذو الأوزان المفتوحة من Black Forest Labs، وهو مثالي للتوليد الواقعي المفصّل.
- Flux Schnell: النسخة المقطّرة والأسرع المصممة للتكرار السريع والنماذج الأولية.
- Flux Dev LoRA: نموذج Flux Dev مع محوّلات LoRA مخصصة لتوليد بأسلوب محدد.
- SDXL: ما زال من أكثر نماذج الصور مفتوحة المصدر تنوعًا المتاحة.
- Stable Diffusion 3.5 Large: أحدث بنية من Stability AI مع تحسينات المحوّل متعدد الوسائط.
- Flux 1.1 Pro: مخرجات بجودة تجارية من عائلة Flux مع واقعية محسّنة.
- Imagen 4: أحدث نموذج لتحويل النص إلى صورة من Google، بتفاصيل استثنائية وتصيير ألوان متميز.
استخدام النماذج المدرّبة الآن
الفجوة بين "كيف يعمل التدريب" و"ما الذي يمكنك إنشاؤه فعلًا" أصغر مما تبدو. فعندما تكتب أمرًا نصيًا في واجهة تحويل النص إلى صورة، فإن الأوزان التي يُستعلم منها هي النتاج المباشر لكل ما وُصف أعلاه: أشهر من تنسيق البيانات، ومليارات تحديثات التدرج، وعمل دقيق في المواءمة. والجودة التي تراها في المخرجات تعكس قرارات اتُخذت في كل مرحلة من هذا المسار.
بالنسبة إلى معظم المبدعين، فإن الفكرة المهمة ليست كيفية تدريب نموذج من الصفر، بل كيفية العمل مع طبقات التكييف الموضوعة فوق الأوزان المدرّبة مسبقًا. تتيح لك تعديلات LoRA توجيه نموذج أساسي قوي نحو وجه محدد أو أسلوب فني أو مفهوم بصري معين، باستخدام بضع مئات من صور التدريب وعتاد متواضع. وهذا هو الجزء من تدريب الذكاء الاصطناعي مفتوح المصدر الذي يمكن للأفراد الوصول إليه فعلًا اليوم، الآن، دون ميزانية بحثية.
تستحق التجربة: إذا أردت أن ترى كيف تؤثر مناهج التدريب المختلفة في جودة المخرجات، فأرسل الأمر النصي نفسه عبر Flux Schnell وFlux Dev وSDXL جنبًا إلى جنب على PicassoIA. تعكس الاختلافات في الواقعية والالتزام بالأمر النصي والتكوين الخيارات التدريبية التي اتُخذت لكل نموذج.
في كل مرة تولّد فيها صورة، أنت الحلقة الأخيرة في مسار بدأ ببيانات بحجم البيتابايت، ومليارات تحديثات المعاملات، وجهد تعاوني من باحثين اختاروا مشاركة أعمالهم بشكل مفتوح. النماذج على PicassoIA هي ناتج هذا العمل، جاهزة للاستخدام دون لمس سطر واحد من كود التدريب.
ابدأ مع Flux Dev أو Stable Diffusion 3.5 Large وشاهد ما يمكن أن تنتجه ملايين تكرارات التدريب من جملة واحدة.


