Na primeira vez que você digita um prompt em um gerador de imagens com IA e algo fotorrealista aparece em segundos, é fácil esquecer que o modelo que faz o trabalho nem sempre foi tão capaz. Ele começou como uma folha em branco, bilhões de números aleatórios, e foi moldado até virar algo útil por um processo que levou meses, milhares de GPUs e petabytes de dados. Esse processo se chama treinamento e, no caso dos modelos de IA de código aberto, é um processo que qualquer pessoa pode, em princípio, replicar, inspecionar ou estender.
Este artigo detalha exatamente como os modelos de IA de código aberto são treinados, desde a coleta de dados brutos até a passagem dos pesos finais pelas mãos da comunidade.
O que "treinamento" realmente significa
O modelo começa do zero
Antes de o treinamento começar, uma rede neural não é nada além de uma grande coleção de parâmetros numéricos chamados pesos. Na inicialização, esses pesos normalmente são aleatórios. A rede não tem nenhum conhecimento sobre como é um gato, o que é gramática ou como prever o próximo pixel de uma imagem. Tudo isso vem da exposição aos dados.
Treinar é o processo de ajustar esses pesos ao longo de milhões de iterações até que o modelo produza resultados úteis de forma confiável. Pense nisso como aprender por repetição, só que, em vez de um cérebro humano, o "aprendiz" é uma função matemática com bilhões de botões ajustáveis.
Os dados são tudo
O ingrediente mais importante do treinamento não é a arquitetura nem o hardware. São os dados. Um modelo só é tão bom quanto aquilo que lhe foi mostrado. Se o conjunto de dados for enviesado, incompleto ou de baixa qualidade, essas falhas ficam incorporadas diretamente ao comportamento do modelo.
Para modelos de geração de imagens como o Flux Dev ou o Stable Diffusion, os dados de treinamento são formados por centenas de milhões de pares imagem-texto: a foto de um pôr do sol associada à legenda "hora dourada sobre o oceano", e assim por diante. O modelo aprende a associar conteúdo visual a linguagem ao ver pares suficientes.
De onde vêm os dados
Rastreamentos da web e conjuntos de dados licenciados
A maior parte dos dados de treinamento de grandes modelos de IA de código aberto vem de rastreamentos da web. Projetos como o Common Crawl coletam bilhões de páginas da web e disponibilizam esses dados para uso em pesquisa e comercial. Para modelos de imagem especificamente, conjuntos de dados como o LAION-5B reuniram pares imagem-texto de toda a internet, fornecendo a matéria-prima para treinar modelos em escala.
Além dos rastreamentos públicos da web, as organizações usam cada vez mais conjuntos de dados licenciados, provenientes de bancos de imagens de estoque, publicações científicas e repositórios curados. Isso importa mais do que nunca, à medida que o cenário jurídico em torno dos dados de treinamento continua mudando.
Nota: Nem todos os dados encontrados na internet estão legalmente disponíveis para treinamento. Os modelos de código aberto variam bastante em transparência sobre a procedência dos dados, e essa lacuna de transparência cresce à medida que os desafios jurídicos se acumulam.
Qualidade vence volume
Conjuntos de dados maiores não produzem automaticamente modelos melhores. Pesquisadores da Stability AI e da Black Forest Labs (a equipe por trás do Flux Schnell e do Flux Pro) constataram de forma consistente que filtrar imagens de baixa qualidade, remover duplicatas e equilibrar a representação entre os temas produz resultados muito melhores do que simplesmente adicionar mais dados.
A curadoria de dados é uma disciplina própria. Equipes de anotadores e pipelines de filtragem automatizados investem um esforço considerável para garantir que o que entra no ciclo de treinamento realmente valha a pena ser treinado.
O ciclo de treinamento, passo a passo
Passagem para frente, previsões e perda
Quando os dados estão prontos, o treinamento roda em um ciclo contínuo. Em cada iteração, o modelo recebe um lote de exemplos de treinamento e produz previsões. Para um modelo de geração de imagens, isso pode significar: dada uma versão com ruído de uma imagem e um prompt de texto, prever como era a imagem original, limpa.
A diferença entre a previsão do modelo e a resposta correta é medida por uma função de perda. A perda é um único número: quanto menor, melhor o desempenho do modelo; quanto maior, pior. No início do treinamento, a perda é alta porque os pesos ainda são essencialmente aleatórios. Todo o objetivo do treinamento é fazer esse número cair, de forma consistente, ao longo de milhões de iterações.
Retropropagação em linguagem simples
Depois que a perda é calculada, o modelo precisa descobrir quais pesos contribuíram para o erro e em que medida. Isso é feito pela retropropagação, um algoritmo que percorre as camadas da rede de trás para a frente, calculando o gradiente da perda em relação a cada peso.
Um gradiente é uma direção e uma magnitude: ele indica se aumentar ou diminuir um determinado peso vai elevar ou reduzir a perda. Com centenas de bilhões de pesos em um modelo moderno, calcular todos esses gradientes ao mesmo tempo exige uma maquinaria matemática considerável, mas a lógica por trás é direta.
Como funciona a descida do gradiente
Depois que a retropropagação calcula os gradientes, a descida do gradiente os usa para atualizar os pesos. O conceito é direto: mover cada peso ligeiramente na direção que reduz a perda.
O tamanho de cada passo é controlado por uma taxa de aprendizado. Se for grande demais, o modelo ultrapassa o ponto ideal e fica oscilando sem nunca se estabilizar. Se for pequena demais, o treinamento leva uma eternidade.
Uma analogia útil: imagine a perda como uma paisagem física com montanhas e vales. Os pesos atuais do modelo o colocam em algum ponto desse terreno. A descida do gradiente é o processo de dar repetidamente pequenos passos morro abaixo, em direção ao vale mais baixo.
Esse ciclo, passagem para frente, cálculo da perda, retropropagação dos gradientes e atualização dos pesos, se repete bilhões de vezes ao longo de um treinamento. Cada passagem por um lote de dados é chamada de passo; uma passagem completa por todo o conjunto de dados é uma época.
| Termo | O que significa |
|---|
| Função de perda | Mede o erro entre a previsão e a realidade |
| Retropropagação | Calcula quais pesos causaram o erro |
| Descida do gradiente | Atualiza os pesos para reduzir o erro |
| Taxa de aprendizado | Controla o tamanho de cada atualização dos pesos |
| Época | Uma passagem completa pelo conjunto de dados de treinamento |
O que torna um modelo "de código aberto"
Pesos abertos versus código aberto completo
Essa distinção importa mais do que a maioria das pessoas percebe. Um modelo com pesos abertos disponibiliza seus parâmetros treinados para download público. Você pode executá-lo localmente, fazer fine-tuning e criar aplicações sobre ele. Modelos como o SDXL e o Stable Diffusion 3.5 Large se enquadram nessa categoria.
Um modelo de código aberto completo também libera o código de treinamento, o conjunto de dados e a documentação que cobre todo o pipeline. Bem menos modelos atingem esse patamar mais alto.
Vale saber: "Código aberto" em IA nem sempre significa a mesma coisa que código aberto em software. Muitos modelos populares de IA que as pessoas chamam de código aberto compartilham apenas os pesos, e não a receita completa usada para criá-los.
Por que isso importa para criadores
Os pesos abertos são extremamente importantes para quem usa IA na prática. Eles permitem executar a inferência sem custos de API, operar o modelo no seu próprio hardware e modificar os pesos para casos de uso específicos. Também permitem que a comunidade audite o modelo em busca de vieses, crie ferramentas de segurança e lance versões aprimoradas.
Modelos como o Flux 1.1 Pro Ultra e o Imagen 4 representam filosofias diferentes nesse espectro: alguns priorizam o acesso por meio de pesos abertos, enquanto outros permanecem proprietários por motivos de qualidade ou segurança.
Fine-tuning após o pré-treinamento
LoRA e adaptadores
O pré-treinamento produz um modelo de uso geral, mas raramente é o passo final. O fine-tuning adapta um modelo pré-treinado para ter um desempenho melhor em um domínio ou estilo específico. O problema é que fazer o fine-tuning completo de um modelo com bilhões de parâmetros é caro e lento.
O LoRA (Low-Rank Adaptation) resolve isso congelando os pesos originais do modelo e inserindo pequenas matrizes treináveis em camadas específicas. Em vez de retreinar tudo, você treina apenas os pesos do adaptador LoRA, que representam uma fração minúscula do total de parâmetros. O resultado é um modelo que se comporta de maneiras diferentes e direcionadas, mantendo todo o seu conhecimento base.
É exatamente assim que funciona o Flux Dev LoRA no PicassoIA. O modelo base Flux Dev permanece fixo, enquanto um pequeno conjunto de pesos aprendidos direciona a saída para estilos visuais, personagens ou temas específicos. Qualquer pessoa com um hardware modesto pode treinar um LoRA com algumas centenas de imagens e obter um modelo que gera de forma confiável uma estética específica.
RLHF e alinhamento
Para modelos de linguagem e, cada vez mais, para geradores de imagens, o Aprendizado por Reforço a partir de Feedback Humano (RLHF) é usado após o pré-treinamento para tornar as saídas mais alinhadas ao que as pessoas realmente querem. O processo envolve avaliadores humanos que dão notas às saídas do modelo, o treinamento de um modelo de recompensa separado com base nessas notas e, então, o uso de aprendizado por reforço para empurrar o modelo principal em direção a comportamentos mais bem avaliados.
O RLHF é o que separa um modelo pré-treinado bruto, capaz de produzir qualquer coisa, de um que produz de forma confiável resultados úteis, seguros e de alta qualidade. Ele é computacionalmente caro e exige um desenho cuidadoso, mas seu efeito sobre a qualidade percebida da saída é considerável.
O hardware necessário
Clusters de GPUs em escala
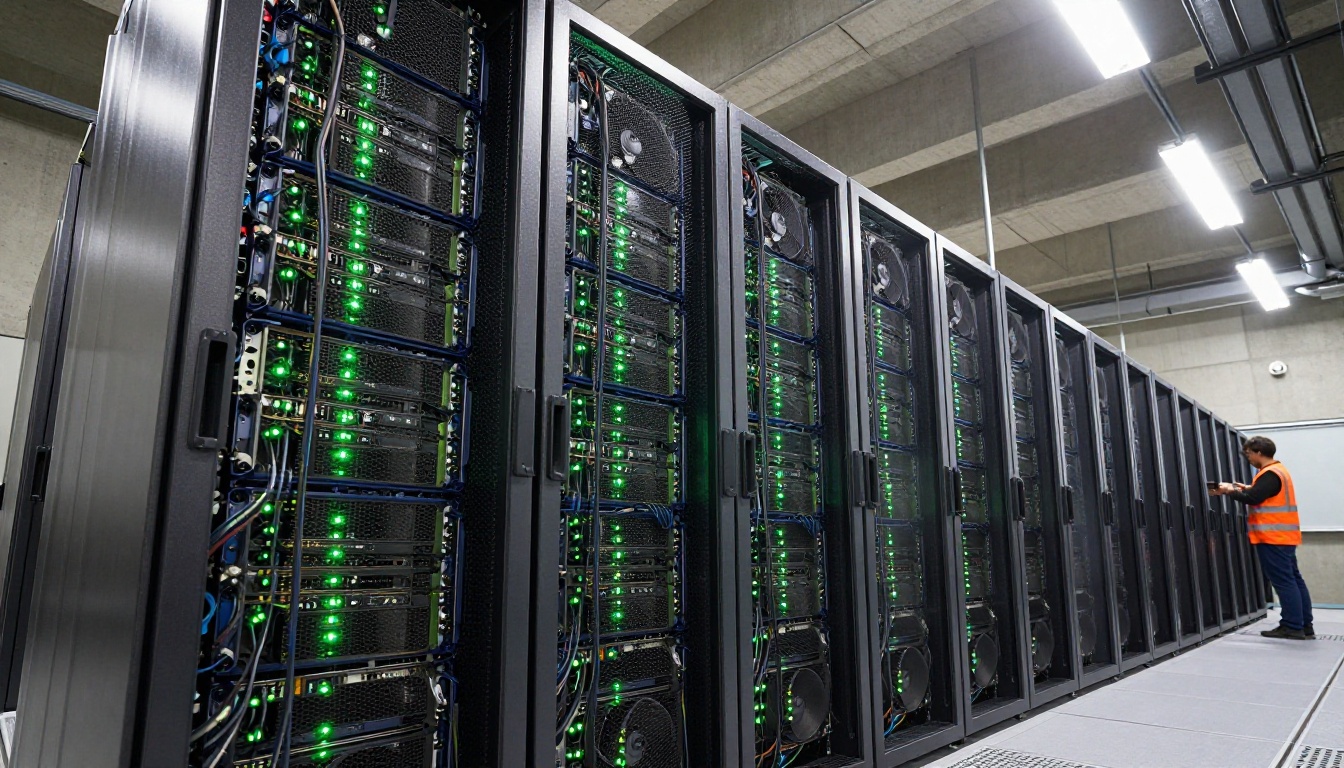
Treinar um grande modelo de IA exige um cluster coordenado de centenas ou milhares de GPUs rodando em paralelo por semanas ou meses. Os treinamentos modernos de modelos de fronteira usam clusters de NVIDIA H100 interligados por NVLink de alta largura de banda e rede InfiniBand para distribuir o cálculo entre milhares de chips simultaneamente.
A razão para o paralelismo ser necessário é direta: uma única passagem para frente e para trás por um modelo grande produz mais operações de ponto flutuante do que qualquer GPU isolada consegue concluir em um tempo razoável. Distribuir o trabalho entre muitas GPUs, cada uma processando uma fatia dos dados ou um segmento do modelo, é a única abordagem prática em escala.
Por que o treinamento custa milhões
Uma única GPU NVIDIA H100 custa mais de US$ 25.000, e um treinamento competitivo pode usar milhares delas por meses. Além dos custos de hardware, há a eletricidade (grandes treinamentos consomem megawatts), a infraestrutura de resfriamento, as taxas de computação em nuvem e o trabalho das equipes de pesquisa.
Por isso, apenas um punhado de organizações consegue treinar grandes modelos de fundação do zero. A comunidade de código aberto normalmente constrói sobre esses modelos de fundação por meio de fine-tuning e adaptação, o que é ordens de grandeza mais barato e ainda produz resultados notáveis.
| Abordagem de treinamento | Custo aproximado | Quem faz |
|---|
| Pré-treinamento do zero | US$ 1 milhão a US$ 100 milhões+ | Grandes laboratórios de pesquisa, startups bem financiadas |
| Fine-tuning completo | US$ 10 mil a US$ 500 mil | Equipes de pesquisa de médio porte |
| Fine-tuning com LoRA | US$ 50 a US$ 5.000 | Pesquisadores individuais, equipes pequenas |
| Executar a inferência | Centavos por solicitação | Qualquer pessoa |
Flux, Stable Diffusion e mais
Os modelos que alimentam a geração de imagens com IA moderna quase todos descendem da tradição de código aberto. O Stable Diffusion demonstrou em 2022 que um modelo de geração de imagens de alta qualidade podia ser treinado e lançado de forma aberta, desencadeando uma explosão de inovação da comunidade. Milhares de fine-tunings, LoRAs e modelos derivados surgiram em poucos meses.
O Flux Dev e o Flux Pro, da Black Forest Labs, representam o próximo passo: uma arquitetura baseada em transformers, treinada em escala maior, com compreensão de texto e fotorrealismo significativamente aprimorados. A abordagem de treinamento segue os mesmos princípios descritos ao longo deste artigo, aplicados com mais dados, mais capacidade computacional e refinamentos de arquitetura que melhoraram a coerência e a aderência ao prompt.
O SDXL expandiu o Stable Diffusion original ao aumentar tanto o modelo quanto o conjunto de dados de treinamento, produzindo saídas com resolução visivelmente maior e mais detalhadas. O Stable Diffusion 3.5 Large foi ainda mais longe, adotando uma arquitetura de transformer de difusão multimodal que produz composições mais nítidas e um alinhamento semântico melhor.
Cada um desses modelos passou pelo mesmo processo fundamental: curadoria de dados, pré-treinamento com minimização da perda via descida do gradiente e, em seguida, fine-tuning para alinhar as saídas às preferências humanas.
Experimente no PicassoIA agora mesmo
Todos os modelos discutidos aqui estão disponíveis para uso diretamente no PicassoIA. Sem configuração local, sem requisitos de hardware, sem necessidade de gerenciar arquivos de pesos ou ambientes Python. Você pode experimentar:
- Flux Dev: O carro-chefe de pesos abertos da Black Forest Labs, ideal para geração fotorrealista detalhada.
- Flux Schnell: A versão destilada e mais rápida, criada para iteração e prototipagem rápidas.
- Flux Dev LoRA: Flux Dev com adaptadores LoRA personalizados para geração com estilo específico.
- SDXL: Ainda um dos modelos de imagem de código aberto mais versáteis disponíveis.
- Stable Diffusion 3.5 Large: A arquitetura mais recente da Stability AI, com melhorias de transformer multimodal.
- Flux 1.1 Pro: Saída de nível comercial da família Flux, com fotorrealismo refinado.
- Imagen 4: O modelo de texto para imagem mais recente do Google, com detalhe e renderização de cor excepcionais.
Usando modelos treinados agora mesmo
A distância entre "como o treinamento funciona" e "o que você pode realmente criar" é menor do que parece. Quando você escreve um prompt em uma interface de texto para imagem, os pesos consultados são o produto direto de tudo o que foi descrito acima: meses de curadoria de dados, bilhões de atualizações de gradiente e um trabalho cuidadoso de alinhamento. A qualidade que você vê na saída reflete as decisões tomadas em cada etapa desse pipeline.
Para a maioria dos criadores, o insight relevante não é como treinar um modelo do zero, mas como trabalhar com as camadas de adaptação que ficam sobre os pesos pré-treinados. Os fine-tunings com LoRA permitem direcionar um modelo base poderoso para um rosto, estilo artístico ou conceito visual específico, usando algumas centenas de imagens de treinamento e um hardware modesto. Essa é a parte do treinamento de IA de código aberto que é genuinamente acessível a indivíduos hoje, agora, sem um orçamento de pesquisa.
Vale experimentar: Se você quer ver como diferentes abordagens de treinamento afetam a qualidade da saída, passe o mesmo prompt pelo Flux Schnell, pelo Flux Dev e pelo SDXL, lado a lado, no PicassoIA. As diferenças em fotorrealismo, aderência ao prompt e composição refletem diretamente as escolhas de treinamento feitas para cada modelo.
Toda vez que você gera uma imagem, você é o nó final de um pipeline que começou com petabytes de dados, bilhões de atualizações de parâmetros e o esforço colaborativo de pesquisadores que escolheram compartilhar seu trabalho de forma aberta. Os modelos no PicassoIA são o resultado desse trabalho, prontos para uso sem tocar em uma única linha de código de treinamento.
Comece com o Flux Dev ou o Stable Diffusion 3.5 Large e veja o que milhões de iterações de treinamento podem produzir a partir de uma única frase.


