كان الحصول على ترجمات من فيديو يعني أحد أمرين: قضاء ساعات في كتابة كل كلمة منطوقة بيدك، أو دفع مبلغ لخدمة تفريغ نصي والانتظار أيامًا للحصول على النتيجة. ولا أيٌّ من الخيارين مناسب حين يكون لديك عشرة فيديوهات للنشر هذا الأسبوع. لقد غيّر الذكاء الاصطناعي المعادلة تمامًا، وفي عام 2027 بلغت الجودة مستوى يجعل التفريغ اليدوي شبه غير ضروري.
لماذا لم تعد الترجمات النصية اختيارية؟
لم تعد الترجمات النصية مجرد ميزة لإمكانية الوصول. إنها مضاعِف للوصول إلى الجمهور. تُظهر الأبحاث باستمرار أن 85% من فيديوهات وسائل التواصل الاجتماعي تُشاهد دون صوت، وهذا يعني أن المشاهدين الذين لا يشغّلون الصوت يقرؤون الترجمات أو يتجاوزون الفيديو. وهذا جمهور صامت ضخم إما أن تستقطبه أو تخسره.
ما الذي تكسبه من ترجمات دقيقة
- إمكانية الوصول: يستطيع المشاهدون الصم وضعاف السمع متابعة محتواك بالكامل.
- قيمة تحسين محركات البحث: لا تستطيع محركات البحث مشاهدة الفيديو، لكنها تستطيع قراءة النص المفرّغ. تضمين نص الترجمة في صفحتك يمنح زاحفي المحركات ما يفهرسونه.
- التفاعل: يزداد متوسط مدة المشاهدة عند تفعيل الترجمات. يبقى المشاهدون لفترة أطول لأنهم يستطيعون المتابعة حتى في البيئات الصاخبة.
- أساس للترجمة: ملف الترجمة القوي هو نقطة البداية لنسخ متعددة اللغات. تترجم مرة واحدة من النص، لا من الصوت.
مشكلة المشاهد الصامت
فكّر في الأماكن التي يشاهد فيها الناس المحتوى: في الحافلة، في غرفة الانتظار، على مكتب بجانب زميل. غالبًا ما يكون الصوت مغلقًا أو غير عملي. فيديوك المنافس دون ترجمات يشبه لوحة إعلانية ينقصها بعض الحروف. الرسالة موجودة إلى حد ما، لكن الفجوات تكلّفك المشاهد.
كيف يعمل التعرّف على الكلام بالذكاء الاصطناعي فعليًا؟
يعتمد التفريغ النصي الحديث بالذكاء الاصطناعي على نماذج تعلّم عميق دُرّبت على آلاف الساعات من الصوت المنطوق. هذه النماذج لا تكتفي بمطابقة الأصوات بالفونيمات واحدًا تلو الآخر. بل تتوقع الكلمات المرجّحة في ضوء السياق الأوسع للجملة، ولهذا تتعامل مع اللهجات والكلام السريع والضوضاء الخلفية بشكل أفضل من الأنظمة القديمة القائمة على القواعد.
النماذج الصوتية مقابل النماذج اللغوية
هناك مكوّنان يعملان معًا:
- النموذج الصوتي: يحوّل أشكال موجات الصوت الخام إلى احتمالات للفونيمات.
- النموذج اللغوي: يأخذ تلك الاحتمالات ويحسم الغموض باستخدام السياق. يعرف أن "I need to read the book" (أحتاج إلى قراءة الكتاب) و"I read the book yesterday" (قرأتُ الكتاب أمس) مختلفتان رغم أن "read" تُنطق بالطريقة نفسها.
التفاعل بين هاتين الطبقتين هو ما يمنح التفريغ النصي الحديث بالذكاء الاصطناعي دقته العالية. يوفّر النموذج الصوتي الإشارة الخام، ويمنحها النموذج اللغوي المعنى.
معدل خطأ الكلمات في 2025
المقياس المعتمد لدقة التفريغ هو معدل خطأ الكلمات (WER). يعني معدل 5% أن 5 من كل 100 كلمة تحتوي على خطأ. للتوضيح:
| WER | مستوى الجودة | حالة الاستخدام المعتادة |
|---|
| أقل من 5% | ممتاز | البث والنشر |
| من 5 إلى 10% | جيد | وسائل التواصل الاجتماعي، YouTube |
| من 10 إلى 20% | مقبول | الملاحظات الداخلية، المسودات الأولية |
| أكثر من 20% | ضعيف | يحتاج إلى مراجعة شاملة |
تحقق أفضل نماذج الذكاء الاصطناعي في 2025 بانتظام معدلًا أقل من 5% على الصوت الواضح. وقد ترفع التسجيلات الصاخبة أو اللهجات الثقيلة المعدل إلى ما بين 10 و15%، لكن ذلك لا يزال أسرع بكثير من الكتابة اليدوية.
أفضل نماذج الذكاء الاصطناعي لتفريغ الفيديو
يعتمد اختيار النموذج المناسب على أولوياتك: الدقة المطلقة، ودعم اللغات، والسرعة، أو التكلفة. إليك تفصيل لأفضل الخيارات المتاحة حاليًا.
GPT-4o Transcribe
GPT-4o Transcribe من OpenAI هو المعيار الذهبي الحالي لدقة التفريغ بالإنجليزية. يتعامل مع اللهجات الثقيلة والمتحدثين المتداخلين والصوت منخفض الجودة بشكل أفضل من أي نموذج منافس تقريبًا. النتيجة نص نظيف مكتوب بعلامات ترقيم صحيحة مع حفاظ قوي على بنية الجمل.
بالنسبة إلى صنّاع المحتوى الذين ينتجون محتوى بالإنجليزية في الغالب ويحتاجون إلى أعلى دقة ممكنة مع حد أدنى من التعديل اللاحق، فهذا هو النموذج الذي ينبغي البدء به.
GPT-4o Mini Transcribe
يقدّم GPT-4o Mini Transcribe دقة قريبة من أخيه الأكبر بجزء صغير من التكلفة ووقت المعالجة. إذا كنت تفرّغ كميات كبيرة من المحتوى، أو تسجيلات منتظمة بصوت نظيف، أو تحتاج إلى سرعة إنجاز في ملفات متعددة، فإن Mini هو الخيار العملي. الفرق في الجودة ضئيل في التسجيلات بجودة الاستوديو.
Gemini 3 Pro
يقدّم Gemini 3 Pro من Google ميزتين خاصتين. أولاً، يؤدي أداءً ممتازًا مع المحتوى متعدد اللغات، بما في ذلك الصوت المختلط بلغات متعددة حين ينتقل المتحدثون بين اللغات في منتصف الحديث. ثانيًا، فهمه للمفردات التقنية والمصطلحات الاختصاصية واللغة الخاصة بمجال معيّن قوي بشكل ملحوظ. بالنسبة إلى البودكاست والمقابلات التقنية والمحتوى التعليمي، يتعامل Gemini 3 Pro مع المصطلحات المتخصصة بأخطاء أقل.
نماذج IBM Granite Speech
تقدم IBM نموذجين من Granite Speech يستحقان الاطلاع:
- Granite Speech 4.1 2B: نموذج مدمج يدعم التفريغ في 6 لغات. سريع وخفيف الوزن، ومناسب للمعالجة الفورية أو المعالجة على دفعات حين تكون كفاءة الحوسبة مهمة.
- Granite Speech 3.3 8B: النسخة الأكبر، وتتميز بفهم أوسع للغات ومعالجة أفضل للصوت المعقّد. خيار قوي لسير العمل المؤسسي الذي يحتاج إلى إنتاجية موثوقة.
مقارنة سريعة
| النموذج | أفضل استخدام | دعم اللغات | السرعة |
|---|
| GPT-4o Transcribe | أقصى دقة | الإنجليزية أساسًا | متوسطة |
| GPT-4o Mini Transcribe | التفريغ بكميات كبيرة | الإنجليزية أساسًا | سريعة |
| Gemini 3 Pro | متعدد اللغات، والمحتوى التقني | واسع | متوسطة |
| Granite Speech 4.1 2B | الكفاءة والسرعة | 6 لغات | سريع جدًا |
| Granite Speech 3.3 8B | دقة المؤسسات | متعدد | سريعة |
كيف تحصل على ترجمات في PicassoIA: خطوة بخطوة
تتيح لك PicassoIA الوصول المباشر إلى جميع النماذج المذكورة أعلاه دون أي إعداد أو مفاتيح API أو تثبيت محلي. إليك كيف يسير سير العمل بالضبط.
الخطوة 1: افتح قسم تحويل الكلام إلى نص
انتقل إلى فئة Speech to Text في PicassoIA واختر نموذجك. إذا لم تكن متأكدًا من البداية، فإن GPT-4o Transcribe خيار أول آمن لمعظم أنواع المحتوى.
الخطوة 2: ارفع ملف الصوت أو الفيديو
يمكنك رفع الصيغ الشائعة مثل MP4 وMOV وMP3 وWAV وM4A. وإذا كان المصدر ملف فيديو، يستخرج النموذج مسار الصوت تلقائيًا قبل المعالجة. لا حاجة إلى تحويل الملفات مسبقًا.
💡 نصيحة: إذا كان فيديوك يحتوي على موسيقى خلفية واضحة أو ضوضاء محيطة، فإن استخراج مسار الحوار وحده باستخدام محرر صوت أولاً سيحسّن الدقة بشكل ملحوظ.
الخطوة 3: اضبط اللغة وإعدادات الإخراج
حدّد اللغة المنطوقة في الفيديو. بالنسبة إلى المحتوى متعدد اللغات، يتعامل Gemini 3 Pro أو Granite Speech 4.1 2B مع الصوت المختلط بلغات متعددة بشكل أفضل من النماذج أحادية اللغة. اختر صيغة الإخراج: نص عادي، أو SRT (صيغة الترجمة القياسية)، أو نص مرفق بالتوقيتات.
الخطوة 4: راجع وصدّر
يعيد النموذج النص المفرّغ خلال ثوانٍ إلى بضع دقائق حسب طول الملف. تحصل على:
- نص عادي: نص كامل دون علامات توقيت. مفيد لمقالات المدونة، أو ملاحظات العرض، أو محتوى تحسين محركات البحث.
- ملف SRT: صيغة ترجمة قياسية مع توقيتات دقيقة لكل كتلة ترجمة. جاهز للرفع إلى YouTube أو Vimeo أو للتضمين في محرر الفيديو.
- نص مرفق بالتوقيتات: النص الكامل مع رموز زمنية على فترات منتظمة. مفيد كمرجع للتحرير.
💡 نصيحة: راجع النص المفرّغ دائمًا بسرعة. قد تسيء نماذج الذكاء الاصطناعي سماع الأسماء الخاصة وأسماء العلامات التجارية والمصطلحات التقنية غير الشائعة أحيانًا. مراجعة لمدة 5 دقائق تمنعك من نشر ترجمات محرجة.
تحقيق نتائج أفضل: جودة الصوت أولاً
العامل الأكبر تأثيرًا في دقة التفريغ ليس النموذج الذي تستخدمه. بل جودة الصوت الذي تُدخله إليه. النموذج الممتاز مع صوت رديء سيخسر دائمًا أمام نموذج جيد مع صوت نظيف.
كيف يبدو الصوت النظيف
- التسجيل في غرفة هادئة: ضوضاء الخلفية هي العدو الأول للتعرّف على الكلام. طنين المكيف وأصوات الشارع وطقطقة لوحة المفاتيح في التسجيل كلها تنافس إشارة الكلام.
- لا صدى في الغرفة: الغرف ذات الجدران الصلبة تُحدث صدى يطمس حدود الفونيمات. حتى تعليق بطانية خلفك يُحدث فرقًا ملحوظًا.
- مسافة ثابتة من الميكروفون: اقتراب المتحدث من الميكروفون وابتعاده عنه يخلق تقلبات في الصوت تربك النماذج الصوتية.
- لا تشويه في الصوت: الصوت الذي يبلغ ذروته ويتشوه هو عمليًا بيانات تالفة في تلك اللحظات.
الميكروفون المناسب مهم
لا تحتاج إلى إعداد استوديو احترافي. ميكروفون مكثّف USB موضوع على بعد 15 إلى 20 سم من فم المتحدث في غرفة هادئة بشكل معقول سينتج صوتًا يحقق معدل خطأ أقل من 5% مع أي من أفضل النماذج. أما ميكروفونات الحواسيب المحمولة المدمجة في الغرف ذات الصدى فهي المصدر الرئيسي لنتائج التفريغ الضعيفة.
إصلاح مشكلات التفريغ الشائعة
حتى مع صوت ممتاز ونموذج من الطراز الأول، ستواجه أحيانًا مشكلات. إليك كيفية التعامل مع أكثرها شيوعًا.
الأسماء الخاصة وأسماء العلامات التجارية التي أسيء سماعها
تُدرَّب نماذج الذكاء الاصطناعي على مجموعات بيانات واسعة، لذلك قد تظهر الأسماء غير الشائعة وأسماء العلامات التجارية والمصطلحات التقنية المتخصصة بشكل خاطئ أحيانًا. الحل بسيط: احتفظ بقائمة بحث واستبدال لأكثر أسماء العلم استخدامًا لديك، ونفّذ تمريرة سريعة للبحث والاستبدال بعد كل تفريغ. لا تستغرق سوى 2 دقيقة، وتلغي الأخطاء المتكررة نهائيًا.
مشكلات مزامنة التوقيت
إذا لم تتطابق توقيتات الترجمة مع الكلمات المنطوقة، فإن السبب الأكثر شيوعًا هو صمت تمهيدي أو فجوة في بداية ملف الصوت. تتيح لك معظم محررات الفيديو وأدوات الترجمة المتخصصة إزاحة كل التوقيتات بمقدار ثابت. انقل ملف الترجمة بالكامل بمقدار الإزاحة وتُحل المزامنة فورًا.
بالنسبة إلى الفيديوهات التي تبدأ بمقدمات موسيقية أو صمت ممتد قبل الكلام، فإن قص ملف الصوت ليبدأ بأول كلمة منطوقة قبل التفريغ سينتج توقيتًا أنظف في ملف SRT الناتج.
تداخل المتحدثين والكلام المتزامن
حين يتحدث شخصان في الوقت نفسه، تحاول نماذج الذكاء الاصطناعي تفريغ الصوت المهيمن، وقد تلتقط جزئيًا صوت المتحدث الثانوي أو تُسقطه. بالنسبة إلى المحتوى الحواري الذي يتضمن تداخلًا متكررًا، فكّر في فصل المتحدثين إلى مسارات صوتية منفصلة قبل التفريغ، ثم دمج ملفات SRT الناتجة لاحقًا.
ماذا تفعل بترجماتك؟
الحصول على ملف SRT هو البداية وليس النهاية. إليك أين يذهب هذا الملف بعد ذلك.
التضمين في محرر الفيديو
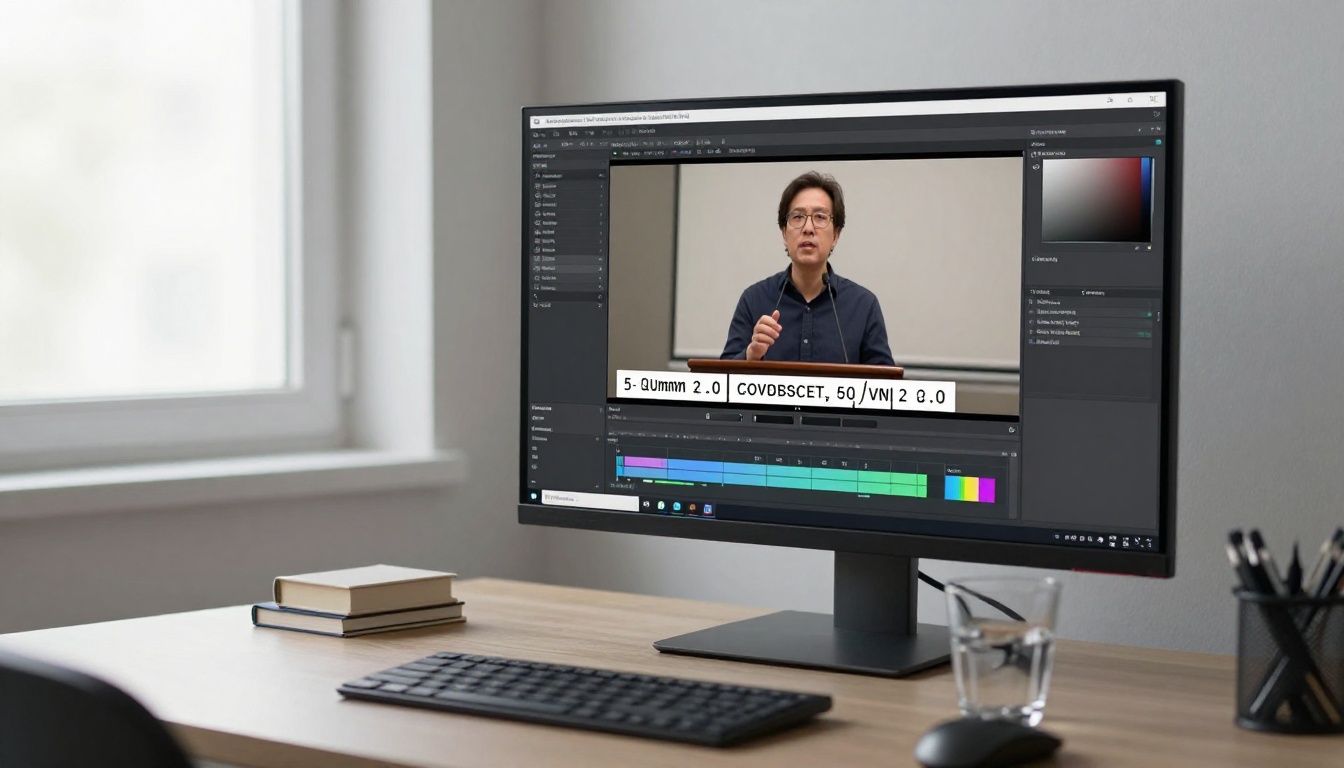
تقبل معظم محررات الفيديو الاحترافية ملفات SRT مباشرة كمسار ترجمة. في Premiere Pro، استورد ملف SRT وسيُوضع مباشرة على مسار نصي متزامن مع خط زمن الفيديو. وفي DaVinci Resolve، استخدم لوحة Subtitles لاستيراد الملف. ومن هناك يمكنك إعادة تنسيق الترجمات، أو دمجها نهائيًا في الفيديو، أو الإبقاء عليها كمسار ترجمة قابل للتشغيل والإيقاف.
بالنسبة إلى تصديرات وسائل التواصل الاجتماعي، يحقق دمج الترجمات في الفيديو (ترميزها داخله بشكل دائم) أداءً أفضل، لأن أنظمة الترجمة التلقائية في المنصات أقل دقة من نماذج الذكاء الاصطناعي التي استخدمتها لإنشاء ملف SRT.
الترجمة إلى لغات أخرى
ملف SRT نظيف هو أسرع طريق إلى محتوى متعدد اللغات. مرّر النص المفرّغ إلى نموذج لغوي كبير للترجمة، وراجع الصياغة لتبدو طبيعية، وستحصل على ملف ترجمة موطّن بأي لغة في دقائق. تتضمن فئة النماذج اللغوية الكبيرة في PicassoIA نماذج مصممة لتوليد النصوص عالية الجودة ومهام الترجمة.
أنشئ مقالة مدونة أو ملاحظات عرض
يتحول النص المفرّغ من فيديو طويل أو بودكاست إلى مقالة مدونة بتعديل بسيط بشكل مدهش. أزل كلمات الحشو، وقسّمه إلى فقرات حسب الموضوع، وستحصل على محتوى مكتوب يظهر في نتائج البحث للكلمات المفتاحية نفسها التي يستهدفها فيديوك. تسجيل واحد، وأصلان قابلان للفهرسة.
الرفع إلى YouTube وVimeo
تقبل المنصتان رفع ملفات SRT مباشرة. وقد تحسّنت ميزة الترجمة التلقائية في YouTube، لكن رفع ملف SRT دقيق من إنتاجك الخاص أفضل دائمًا من ترك الأمر للكشف التلقائي للمنصة. الفجوة في الدقة بين نموذج تحويل الكلام إلى نص المصمم خصيصًا والترجمات التلقائية في YouTube كبيرة، خاصة في المحتوى التقني واللهجات والمتحدثين السريعين.
💡 نصيحة: يستخدم YouTube الترجمات المرفوعة أيضًا لفهرسة البحث. الترجمات الدقيقة تحسّن قابلية اكتشاف فيديوك للكلمات المفتاحية المنطوقة التي لم يذكرها عنوانك ووصفك صراحةً.
ترجمات للمحتوى القصير
ينطبق سير العمل أعلاه بالتساوي على المحتوى القصير. بالنسبة إلى فيديو مدته 60 ثانية، يعيد GPT-4o Mini Transcribe ملف SRT كاملًا في أقل من 15 ثانية. بهذه السرعة، تصبح إضافة الترجمات إلى كل قطعة من المحتوى القصير جزءًا من قائمة التصدير المعتادة، لا مهمة إضافية.
بالنسبة إلى Reels وTikToks وYouTube Shorts، تكون الترجمات ذات تأثير كبير بشكل خاص، لأن هذه الصيغ تُشاهد تقريبًا دائمًا على الهاتف المحمول دون صوت. المحتوى الخالي من الترجمات في هذه الصيغ يتنافس في وضع أضعف بوضوح.
للتنسيق أهمية أيضًا في المحتوى القصير. كتل الترجمة القصيرة من 3 إلى 5 كلمات في كل سطر، والألوان عالية التباين، والموضع المتوسط، أداؤها أفضل من الأسطر الطويلة من النص الصغير. عند استيراد ملف SRT إلى محرر محتوى قصير، اضبط فواصل الأسطر لتناسب الصيغة قبل التصدير.
ابدأ توليد ترجماتك الآن
كل نموذج يغطيه هذا المقال متاح مباشرة على PicassoIA دون أي إعداد تقني. افتح نموذجًا، وارفع ملفك، وسيكون ملف SRT جاهزًا خلال دقائق.
إذا كنت تريد أسرع طريق إلى ترجمات دقيقة دون أي إعداد لواجهة API، فإن GPT-4o Transcribe هو نقطة البداية. للمعالجة بكميات كبيرة أو المحتوى متعدد اللغات، يقدم Gemini 3 Pro ونماذج Granite Speech مزايا محددة تستحق الاستكشاف.
وبينما أنت هناك، تقدم PicassoIA أيضًا إمكانيات معالجة فيديو كاملة، تشمل AI Video Enhancement لتحسين جودة المصدر قبل التفريغ، وتحويل النص إلى كلام لسير العمل المعاكس: تحويل نص ترجمتك مرة أخرى إلى تعليق صوتي طبيعي للنسخ المدبلجة أو المحتوى المروي.
الأدوات متاحة، والدقة جاهزة للإنتاج. ابدأ بفيديو كنت تؤجل إضافة ترجمات له، وشاهد مدى سرعة سير العمل فعليًا.


