किसी वीडियो के सबटाइटल पाने के लिए आम तौर पर दो ही रास्ते थे: घंटों तक हर बोला गया शब्द खुद टाइप करना, या ट्रांसक्रिप्शन सेवा को पैसे देकर नतीजे का दिनों इंतज़ार करना। जब इस हफ़्ते दस वीडियो प्रकाशित करने हों, तो दोनों में से कोई भी विकल्प अच्छा नहीं लगता। AI ने इस पूरे हिसाब को पूरी तरह बदल दिया है, और 2027 में इसकी गुणवत्ता इतनी अच्छी है कि मैन्युअल ट्रांसक्रिप्शन के लिए शायद ही कोई उपयोग बचा है।
अब सबटाइटल वैकल्पिक क्यों नहीं रहे
कैप्शन अब सिर्फ़ एक एक्सेसिबिलिटी फ़ीचर नहीं रहे। ये पहुँच को कई गुना बढ़ाते हैं। शोध लगातार बताते हैं कि सोशल मीडिया के 85% वीडियो बिना आवाज़ के देखे जाते हैं, यानी जो दर्शक कभी ऑडियो चालू नहीं करते, वे या तो सबटाइटल पढ़ते हैं या आगे स्क्रॉल कर देते हैं। यह एक बड़ी खामोश भीड़ है, जिसे या तो आप अपनी ओर खींच रहे हैं या खो रहे हैं।
सटीक कैप्शन से आपको क्या मिलता है
- एक्सेसिबिलिटी: बहरे और कम सुनने वाले दर्शक आपका कंटेंट पूरी तरह समझ सकते हैं।
- SEO वैल्यू: सर्च इंजन वीडियो नहीं देख सकते। वे ट्रांसक्रिप्ट पढ़ सकते हैं। अपने पेज पर सबटाइटल का टेक्स्ट एम्बेड करने से क्रॉलर्स को इंडेक्स करने के लिए कुछ मिलता है।
- एंगेजमेंट: कैप्शन चालू होने पर औसत वॉच टाइम बढ़ता है। शोरगुल वाले माहौल में भी दर्शक कैप्शन की वजह से अंत तक जुड़े रहते हैं।
- अनुवाद का आधार: एक ठोस सबटाइटल फ़ाइल बहुभाषी संस्करणों की शुरुआत है। आप ऑडियो से नहीं, टेक्स्ट से एक बार अनुवाद करते हैं।
खामोश दर्शकों की समस्या
सोचिए लोग कंटेंट कहाँ देखते हैं: बस में, इंतज़ार वाले कमरे में, सहकर्मी की बगल में बैठे डेस्क पर। आवाज़ अक्सर बंद होती है, या व्यावहारिक नहीं होती। बिना सबटाइटल के आपका वीडियो ऐसा है जैसे किसी बिलबोर्ड के कुछ अक्षर गायब हों। संदेश वहाँ है, कुछ हद तक, लेकिन खाली जगहें आपको दर्शक से दूर कर देती हैं।
AI स्पीच रिकग्निशन असल में कैसे काम करता है
आधुनिक AI ट्रांसक्रिप्शन डीप लर्निंग मॉडलों का इस्तेमाल करता है, जिन्हें हज़ारों घंटे की बोली गई ऑडियो पर प्रशिक्षित किया गया है। ये मॉडल ध्वनियों को एक-एक करके फ़ोनीम से सिर्फ़ मिलाते नहीं हैं। वे वाक्य के बड़े संदर्भ को देखकर अनुमान लगाते हैं कि कौन-से शब्द संभावित हैं। इसी वजह से वे पुराने नियम-आधारित सिस्टमों से बेहतर ढंग से लहजों, तेज़ बोलने और पृष्ठभूमि के शोर को संभाल पाते हैं।
एकॉस्टिक मॉडल बनाम लैंग्वेज मॉडल
दो घटक मिलकर काम करते हैं:
- एकॉस्टिक मॉडल: कच्ची ऑडियो वेवफ़ॉर्म को फ़ोनीम की संभावनाओं में बदलता है।
- लैंग्वेज मॉडल: उन संभावनाओं को लेता है और संदर्भ का इस्तेमाल करके अस्पष्टता सुलझाता है। यह जानता है कि "I need to read the book" और "I read the book yesterday" अलग-अलग हैं, भले ही "read" की आवाज़ एक जैसी लगे।
इन दोनों परतों के आपसी तालमेल से ही आधुनिक AI ट्रांसक्रिप्शन को उच्च सटीकता मिलती है। एकॉस्टिक मॉडल कच्चा संकेत देता है; लैंग्वेज मॉडल उसे समझने लायक बनाता है।
2025 में Word Error Rate
ट्रांसक्रिप्शन सटीकता का बेंचमार्क पैमाना Word Error Rate (WER) है। 5% WER का मतलब है कि हर 100 शब्दों में से 5 शब्दों में गलती है। संदर्भ के लिए:
| WER | गुणवत्ता स्तर | आम उपयोग |
|---|
| 5% से कम | उत्कृष्ट | ब्रॉडकास्ट, प्रकाशन |
| 5 से 10% | अच्छा | सोशल मीडिया, YouTube |
| 10 से 20% | औसत | आंतरिक नोट्स, रफ़ कट |
| 20% से ज़्यादा | कमज़ोर | भारी समीक्षा की ज़रूरत |
2025 के शीर्ष AI मॉडल साफ़ ऑडियो पर नियमित रूप से 5% से कम WER तक पहुँचते हैं। शोरगुल वाली रिकॉर्डिंग या भारी लहजे इसे 10 से 15% तक ले जा सकते हैं, लेकिन फिर भी यह टाइप करने से कहीं ज़्यादा तेज़ है।
वीडियो ट्रांसक्रिप्शन के लिए सर्वश्रेष्ठ AI मॉडल
सही मॉडल आपकी प्राथमिकताओं पर निर्भर करता है: कच्ची सटीकता, भाषा समर्थन, गति या लागत। इस समय उपलब्ध सबसे अच्छे विकल्पों का ब्योरा यहाँ है।
GPT-4o Transcribe
OpenAI का GPT-4o Transcribe अंग्रेज़ी ट्रांसक्रिप्शन सटीकता का मौजूदा सबसे उन्नत मानक है। यह भारी लहजों, एक-दूसरे के ऊपर बोलने वाले वक्ताओं और कम गुणवत्ता वाले ऑडियो को लगभग किसी भी प्रतिस्पर्धी मॉडल से बेहतर संभालता है। आउटपुट साफ़, विराम-चिह्नों वाला टेक्स्ट होता है, जिसमें वाक्य-संरचना अच्छी तरह बनी रहती है।
जो क्रिएटर मुख्य रूप से अंग्रेज़ी कंटेंट बनाते हैं और न्यूनतम पोस्ट-एडिटिंग के साथ अधिकतम संभव सटीकता चाहते हैं, उनके लिए यही मॉडल शुरू करने लायक है।
GPT-4o Mini Transcribe
GPT-4o Mini Transcribe अपने बड़े भाई के करीब सटीकता देता है, लेकिन लागत और प्रोसेसिंग समय के एक अंश पर। अगर आप बड़ी मात्रा में कंटेंट ट्रांसक्रिप्ट कर रहे हैं, साफ़ ऑडियो वाली नियमित रिकॉर्डिंग कर रहे हैं, या कई फ़ाइलों का जल्दी नतीजा चाहिए, तो Mini व्यावहारिक विकल्प है। स्टूडियो-क्वालिटी रिकॉर्डिंग पर गुणवत्ता का अंतर बहुत कम होता है।
Gemini 3 Pro
Google का Gemini 3 Pro दो खास खूबियाँ लाता है। पहली, यह बहुभाषी कंटेंट पर असाधारण रूप से अच्छा प्रदर्शन करता है, जिसमें मिश्रित-भाषा वाला ऑडियो भी शामिल है, जहाँ वक्ता बातचीत के बीच भाषाएँ बदलते हैं। दूसरी, तकनीकी शब्दावली, जार्गन और विशेष क्षेत्र की भाषा की इसकी समझ उल्लेखनीय रूप से मज़बूत है। पॉडकास्ट, तकनीकी इंटरव्यू या शैक्षिक कंटेंट के लिए Gemini 3 Pro विशेष शब्दावली को कम गलतियों के साथ संभालता है।
IBM Granite Speech मॉडल
IBM दो Granite Speech मॉडल देता है, जिनके बारे में जानना उपयोगी है:
- Granite Speech 4.1 2B: एक कॉम्पैक्ट मॉडल, जो 6 भाषाओं में ट्रांसक्रिप्शन सपोर्ट करता है। तेज़ और हल्का है, और रियल-टाइम या बैच प्रोसेसिंग के लिए ठीक है, जहाँ कंप्यूट की दक्षता मायने रखती है।
- Granite Speech 3.3 8B: बड़ा वर्ज़न, जिसकी भाषा समझ व्यापक है और जटिल ऑडियो को बेहतर संभालता है। विश्वसनीय थ्रूपुट चाहने वाले एंटरप्राइज़ वर्कफ़्लो के लिए मज़बूत विकल्प।
त्वरित तुलना
| मॉडल | सबसे अच्छा किसके लिए | भाषा समर्थन | गति |
|---|
| GPT-4o Transcribe | अधिकतम सटीकता | मुख्य रूप से अंग्रेज़ी | मध्यम |
| GPT-4o Mini Transcribe | बड़ी मात्रा का ट्रांसक्रिप्शन | मुख्य रूप से अंग्रेज़ी | तेज़ |
| Gemini 3 Pro | बहुभाषी, तकनीकी | व्यापक | मध्यम |
| Granite Speech 4.1 2B | दक्षता, गति | 6 भाषाएँ | बहुत तेज़ |
| Granite Speech 3.3 8B | एंटरप्राइज़ सटीकता | बहु-भाषा | तेज़ |
PicassoIA पर सबटाइटल कैसे पाएँ: चरण-दर-चरण
PicassoIA आपको ऊपर दिए सभी मॉडलों तक सीधी पहुँच देता है, बिना किसी सेटअप, API keys या लोकल इंस्टॉलेशन के। वर्कफ़्लो असल में ऐसे चलता है।
चरण 1: स्पीच-टू-टेक्स्ट सेक्शन खोलें
PicassoIA पर Speech to Text कैटेगरी में जाएँ और अपना मॉडल चुनें। अगर आप तय नहीं कर पा रहे कि कहाँ से शुरू करें, तो अधिकतर कंटेंट प्रकारों के लिए GPT-4o Transcribe एक सुरक्षित पहली पसंद है।
चरण 2: अपनी ऑडियो या वीडियो फ़ाइल अपलोड करें
आप MP4, MOV, MP3, WAV और M4A जैसे आम फ़ॉर्मैट अपलोड कर सकते हैं। अगर आपका स्रोत वीडियो फ़ाइल है, तो प्रोसेस करने से पहले मॉडल खुद ऑडियो ट्रैक निकाल लेता है। फ़ाइलों को पहले से कन्वर्ट करने की ज़रूरत नहीं।
💡 टिप: अगर आपके वीडियो में काफ़ी बैकग्राउंड म्यूज़िक या परिवेश का शोर है, तो पहले किसी ऑडियो एडिटर से सिर्फ़ डायलॉग ट्रैक निकालने से सटीकता में साफ़ सुधार होगा।
चरण 3: भाषा और आउटपुट सेटिंग चुनें
वीडियो में बोली जाने वाली भाषा चुनें। बहुभाषी कंटेंट के लिए Gemini 3 Pro या Granite Speech 4.1 2B एकल-भाषा मॉडलों से बेहतर मिश्रित-भाषा ऑडियो संभालते हैं। अपना आउटपुट फ़ॉर्मैट चुनें: सादा टेक्स्ट, SRT (मानक सबटाइटल फ़ॉर्मैट), या टाइमस्टैम्प वाला ट्रांसक्रिप्ट।
चरण 4: समीक्षा करें और एक्सपोर्ट करें
फ़ाइल की लंबाई के हिसाब से मॉडल कुछ सेकंड से लेकर कुछ मिनटों में आपका ट्रांसक्रिप्ट लौटा देता है। आपको मिलता है:
- सादा टेक्स्ट: बिना टाइमिंग मार्कर वाला पूरा ट्रांसक्रिप्ट। ब्लॉग पोस्ट, शो नोट्स या SEO कंटेंट के लिए उपयोगी।
- SRT फ़ाइल: हर कैप्शन ब्लॉक के सटीक टाइमस्टैम्प वाला मानक सबटाइटल फ़ॉर्मैट। YouTube, Vimeo पर अपलोड करने या अपने वीडियो एडिटर में एम्बेड करने के लिए तैयार।
- टाइमस्टैम्प वाला ट्रांसक्रिप्ट: नियमित अंतराल पर टाइम कोड वाला पूरा टेक्स्ट। एडिटिंग संदर्भ के लिए उपयोगी।
💡 टिप: ट्रांसक्रिप्ट को हमेशा एक बार जल्दी से पढ़ लें। AI मॉडल कभी-कभी व्यक्तिवाचक संज्ञाओं, ब्रांड नामों या दुर्लभ तकनीकी शब्दों को गलत सुन लेते हैं। 5 मिनट की समीक्षा आपको शर्मिंदगी भरे कैप्शन लाइव होने से बचा सकती है।
बेहतर नतीजे: सबसे पहले ऑडियो की गुणवत्ता
ट्रांसक्रिप्शन की सटीकता में सबसे बड़ा कारक यह नहीं कि आप कौन-सा मॉडल इस्तेमाल करते हैं। वह है आपके द्वारा दिए गए ऑडियो की गुणवत्ता। खराब ऑडियो पर बेहतरीन मॉडल हर बार साफ़ ऑडियो पर अच्छे मॉडल से हारेगा।
साफ़ ऑडियो कैसा दिखता है
- शांत कमरे में रिकॉर्डिंग: पृष्ठभूमि का शोर स्पीच रिकग्निशन का सबसे बड़ा दुश्मन है। एयर कंडीशनर की गुनगुनाहट, सड़क की आवाज़ें और कीबोर्ड की क्लिक, ये सब बोलने के सिग्नल से टकराते हैं।
- कमरे की गूँज नहीं: सख्त दीवारों वाले कमरे गूँज पैदा करते हैं, जो फ़ोनीम की सीमाओं को धुंधला करती है। आपके पीछे कंबल टाँगने से भी साफ़ फ़र्क पड़ता है।
- माइक्रोफ़ोन की दूरी एक जैसी रखें: वक्ता माइक के पास और दूर जाते हैं तो वॉल्यूम में उतार-चढ़ाव आता है, जो एकॉस्टिक मॉडलों को भ्रमित करता है।
- क्लिपिंग नहीं: ऑडियो जो चरम पर पहुँचकर विकृत होता है, उन पलों पर मूलतः खराब डेटा है।
सही माइक्रोफ़ोन क्यों मायने रखता है
आपको प्रोफ़ेशनल स्टूडियो सेटअप की ज़रूरत नहीं है। एक शांत-से कमरे में वक्ता के मुँह से 15 से 20 सेमी दूर रखा USB कंडेंसर माइक्रोफ़ोन ऐसा ऑडियो देगा जो किसी भी शीर्ष मॉडल पर 5% से कम WER तक पहुँचेगा। गूँज वाले कमरों में लैपटॉप के अंदरूनी माइक्रोफ़ोन खराब ट्रांसक्रिप्शन नतीजों का मुख्य कारण हैं।
आम ट्रांसक्रिप्शन समस्याएँ सुलझाना
बेहतरीन ऑडियो और शीर्ष मॉडल के साथ भी कभी-कभी दिक्कतें आती हैं। सबसे आम समस्याओं से निपटने का तरीका यहाँ है।
गलत सुने गए व्यक्तिवाचक संज्ञा और ब्रांड नाम
AI मॉडल व्यापक डेटासेट पर प्रशिक्षित होते हैं, इसलिए दुर्लभ नाम, ब्रांड नाम या विशेष तकनीकी शब्द कभी-कभी गलत निकल आते हैं। इसका हल सरल है: अपने सबसे ज़्यादा इस्तेमाल होने वाले व्यक्तिवाचक संज्ञाओं की एक सर्च-और-रिप्लेस सूची रखें और हर ट्रांसक्रिप्शन के बाद एक त्वरित फ़ाइंड-रिप्लेस चलाएँ। इसमें 2 मिनट लगते हैं और बार-बार होने वाली गलतियाँ हमेशा के लिए खत्म हो जाती हैं।
टाइमिंग सिंक की समस्याएँ
अगर आपकी सबटाइटल टाइमिंग बोले गए शब्दों से मेल नहीं खाती, तो सबसे आम कारण ऑडियो फ़ाइल की शुरुआत में प्री-रोल साइलेंस या गैप होता है। ज़्यादातर वीडियो एडिटर और समर्पित सबटाइटल टूल आपको सारी टाइमिंग एक निश्चित मात्रा से ऑफ़सेट करने देते हैं। पूरी सबटाइटल फ़ाइल को उस ऑफ़सेट अवधि से खिसकाएँ, और सिंक तुरंत ठीक हो जाएगा।
जिन वीडियो में म्यूज़िक इंट्रो या बोलना शुरू होने से पहले लंबी चुप्पी है, वहाँ ट्रांसक्रिप्शन से पहले ऑडियो फ़ाइल को पहले बोले गए शब्द से शुरू करने के लिए ट्रिम करने से आउटपुट SRT में साफ़ टाइमिंग मिलेगी।
वक्ताओं का ओवरलैप और क्रॉसटॉक
जब दो लोग एक साथ बोलते हैं, तो AI मॉडल प्रमुख आवाज़ का ट्रांसक्रिप्शन करने की कोशिश करते हैं और दूसरे वक्ता को आंशिक रूप से पकड़ सकते हैं या छोड़ सकते हैं। जिन इंटरव्यू में बार-बार क्रॉसटॉक होता है, वहाँ ट्रांसक्रिप्शन से पहले वक्ताओं को अलग-अलग ऑडियो ट्रैक में बाँटें और बाद में नतीजे वाली SRT फ़ाइलों को मिला दें।
अपने सबटाइटल का क्या करें
SRT फ़ाइल मिलना शुरुआत है, अंत नहीं। यहाँ बताया गया है कि वह फ़ाइल आगे कहाँ जाती है।
अपने वीडियो एडिटर में एम्बेड करें
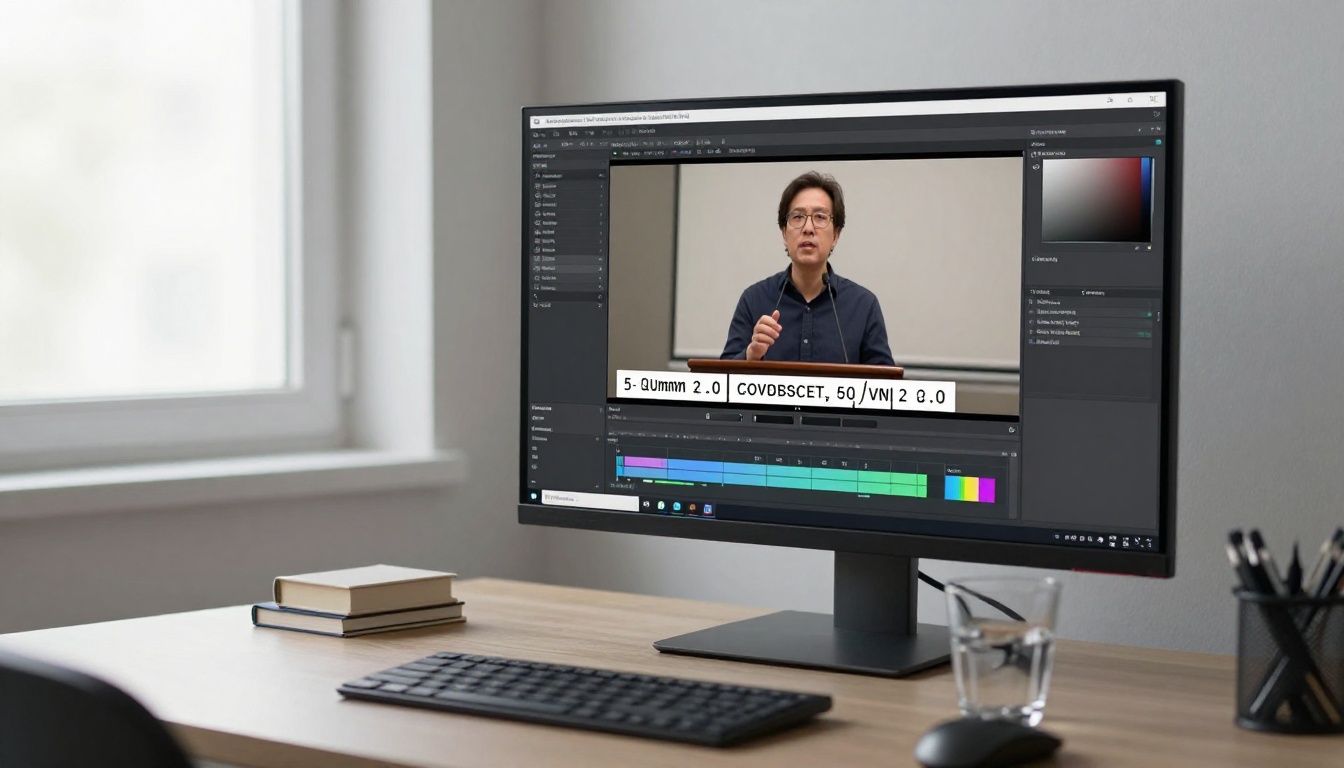
ज़्यादातर प्रोफ़ेशनल वीडियो एडिटर SRT फ़ाइलों को सीधे सबटाइटल ट्रैक के रूप में स्वीकार करते हैं। Premiere Pro में SRT फ़ाइल इंपोर्ट करें, और वह सीधे एक टेक्स्ट ट्रैक पर आ जाएगी जो आपकी वीडियो टाइमलाइन से सिंक होगी। DaVinci Resolve में फ़ाइल इंपोर्ट करने के लिए Subtitles पैनल का इस्तेमाल करें। वहाँ से आप कैप्शन की स्टाइल बदल सकते हैं, उन्हें स्थायी रूप से बर्न कर सकते हैं, या सॉफ़्ट सबटाइटल ट्रैक के रूप में रख सकते हैं।
सोशल मीडिया एक्सपोर्ट के लिए कैप्शन को बर्न करना (वीडियो में ही हार्डकोड करना) बेहतर परिणाम देता है, क्योंकि प्लेटफ़ॉर्म के ऑटो-कैप्शन सिस्टम उन AI मॉडलों से कम सटीक हैं जिनसे आपने SRT बनाई।
दूसरी भाषाओं में अनुवाद करें
साफ़ SRT फ़ाइल बहुभाषी कंटेंट का सबसे तेज़ रास्ता है। ट्रांसक्रिप्ट को अनुवाद के लिए किसी लार्ज लैंग्वेज मॉडल (LLM) को दें, स्वाभाविक वाक्य-रचना के लिए समीक्षा करें, और मिनटों में किसी भी भाषा में स्थानीकृत सबटाइटल फ़ाइल तैयार है। PicassoIA की Large Language Models कैटेगरी में उच्च-गुणवत्ता वाले टेक्स्ट जनरेशन और अनुवाद कार्यों के लिए बने मॉडल शामिल हैं।
ब्लॉग पोस्ट या शो नोट्स बनाएँ
लंबे वीडियो या पॉडकास्ट का ट्रांसक्रिप्ट बहुत कम एडिटिंग के साथ ब्लॉग पोस्ट बन सकता है। फ़िलर शब्द हटाएँ, विषय के अनुसार पैराग्राफ़ बनाएँ, और आपके पास ऐसा लिखित कंटेंट है जो उन्हीं कीवर्ड्स पर रैंक करता है जिन पर आपका वीडियो। एक रिकॉर्डिंग, दो इंडेक्स होने योग्य कंटेंट एसेट।
YouTube और Vimeo पर अपलोड करें
दोनों प्लेटफ़ॉर्म सीधे SRT अपलोड स्वीकार करते हैं। YouTube का ऑटो-कैप्शन फ़ीचर बेहतर हुआ है, लेकिन अपनी सटीक SRT फ़ाइल अपलोड करना प्लेटफ़ॉर्म के ऑटो-डिटेक्शन पर छोड़ने से हमेशा बेहतर है। किसी खास तौर पर बने स्पीच-टू-टेक्स्ट AI मॉडल और YouTube के ऑटोमैटिक कैप्शन के बीच सटीकता का अंतर काफ़ी बड़ा है, खासकर तकनीकी कंटेंट, लहजों या तेज़ बोलने वालों के लिए।
💡 टिप: YouTube अपलोड किए गए कैप्शन का इस्तेमाल सर्च इंडेक्सिंग के लिए भी करता है। सटीक कैप्शन उन बोले गए कीवर्ड्स के लिए आपके वीडियो की खोज-योग्यता सुधारते हैं, जिनका ज़िक्र आपके टाइटल या विवरण में स्पष्ट रूप से नहीं था।
शॉर्ट-फ़ॉर्म कंटेंट के लिए सबटाइटल
ऊपर बताया गया वर्कफ़्लो शॉर्ट-फ़ॉर्म कंटेंट पर भी उतना ही लागू होता है। 60 सेकंड के वीडियो के लिए GPT-4o Mini Transcribe 15 सेकंड से कम में पूरी SRT लौटा देता है। इस गति पर हर शॉर्ट-फ़ॉर्म कंटेंट में कैप्शन जोड़ना अतिरिक्त काम नहीं, बल्कि एक्सपोर्ट चेकलिस्ट का सामान्य हिस्सा बन जाता है।
Reels, TikToks और YouTube Shorts के लिए कैप्शन खास तौर पर असरदार हैं, क्योंकि इन फ़ॉर्मैट्स को लगभग हर जगह मोबाइल पर, बिना आवाज़ के देखा जाता है। इन फ़ॉर्मैट्स में बिना कैप्शन वाला कंटेंट साफ़ तौर पर नुकसान की स्थिति में मुकाबला कर रहा है।
शॉर्ट-फ़ॉर्म में फ़ॉर्मैटिंग भी मायने रखती है। हर पंक्ति में 3 से 5 शब्दों वाले छोटे कैप्शन ब्लॉक, हाई-कॉन्ट्रास्ट रंग और बीच में स्थिति छोटे टेक्स्ट की लंबी पंक्तियों से बेहतर प्रदर्शन करते हैं। जब आप अपनी SRT को किसी शॉर्ट-फ़ॉर्म एडिटर में इंपोर्ट करें, तो एक्सपोर्ट से पहले फ़ॉर्मैट के हिसाब से लाइन ब्रेक ठीक कर लें।
अभी अपने सबटाइटल बनाना शुरू करें
इस लेख में बताया गया हर मॉडल PicassoIA पर सीधे बिना किसी तकनीकी सेटअप के उपलब्ध है। एक मॉडल खोलें, अपनी फ़ाइल अपलोड करें, और आपकी SRT मिनटों में तैयार है।
अगर आपको बिना API कॉन्फ़िगरेशन के सबसे तेज़ रास्ते से सटीक सबटाइटल चाहिए, तो GPT-4o Transcribe से शुरुआत करें। बड़ी मात्रा की प्रोसेसिंग या बहुभाषी कंटेंट के लिए Gemini 3 Pro और Granite Speech मॉडल ऐसे खास फ़ायदे देते हैं जिन्हें आज़माना उपयोगी है।
वहाँ रहते हुए आपको PicassoIA पर पूरी वीडियो प्रोसेसिंग क्षमताएँ भी मिलेंगी, जिनमें ट्रांसक्रिप्शन से पहले स्रोत की गुणवत्ता सुधारने के लिए AI Video Enhancement शामिल है, और उल्टे वर्कफ़्लो के लिए Text to Speech भी, यानी डब किए गए संस्करणों या नैरेटेड कंटेंट के लिए आपके सबटाइटल टेक्स्ट को प्राकृतिक वॉइसओवर में बदलना।
टूल मौजूद हैं। सटीकता प्रोडक्शन-तैयार है। उस वीडियो से शुरू करें जिसके कैप्शन आप टालते आ रहे थे, और देखें कि वर्कफ़्लो असल में कितनी तेज़ी से चलता है।


