كانت دبلجة الفيديو تعني في السابق استئجار استوديو، وتوظيف ممثل صوت، وقضاء ثلاثة أيام في ما بعد الإنتاج لمحاولة مطابقة كل مقطع صوتي مع كل إطار. اليوم، تتولى أدوات مزامنة الشفاه بالذكاء الاصطناعي هذه المحاذاة تلقائيًا، في دقائق، بنتائج تصمد على وسائل التواصل الاجتماعي والدورات التعليمية الإلكترونية والمحتوى المؤسسي والنشر متعدد اللغات. لكن ليست كل أدوات مزامنة الشفاه متساوية، واختيار الأداة الخاطئة لحالتك سيكلّفك الوقت والمصداقية.
ماذا تفعل مزامنة الشفاه فعلًا بالفيديو
علم محاذاة حركة الفم مع الصوت
عندما يُدبلج فيديو، يُستبدل الصوت الأصلي بتسجيل جديد بلغة أو صوت مختلف. المشكلة البصرية: حركات فم المتحدث شُكّلت حول الكلمات الأصلية. فكلمتا "Hello" و"Hola" تستخدمان أوضاعًا مختلفة تمامًا للفم. ومن دون تصحيح، تبدو النتيجة كفيلم أجنبي سيئ الدبلجة من السبعينيات.
تحل مزامنة الشفاه بالذكاء الاصطناعي هذه المشكلة عبر رسم الفونيمات، وهي عملية يقسّم فيها النموذج الصوت الجديد إلى أصوات فردية للفم، ثم يعدّل إطارات الفيديو بحيث يعكس الوجه كل صوت بشكل صحيح. تحدد الخوارزمية منطقة الوجه، وتتتبع مجموعات العضلات في الفك والشفاه والخدين، وتحرّفها إطارًا تلو آخر لتطابق تسلسل الفونيمات الجديد.
تذهب نماذج حديثة مثل Lipsync Precision by HeyGen أبعد من ذلك، إذ تدمج تعويض حركة الرأس وأنماط رمش طبيعية لمنع مظهر "الدمية" الذي يعاني منه أدوات المزامنة القديمة.
لماذا تُفقد سوء المزامنة المشاهدين
الإنسان مُهيّأ لرصد عدم التطابق بين الصوت والصورة فورًا. وهي الآلية نفسها التي تجعل فيلمًا سيئ الدبلجة مزعجًا حتى لو كانت الترجمة دقيقة. تُظهر أبحاث علم النفس الإدراكي باستمرار أن حتى فرق 100 ميلي ثانية بين الصوت وحركة الشفاه يثير الانزعاج لدى المشاهدين.
بالنسبة إلى صنّاع المحتوى، يترجم هذا مباشرةً إلى معدلات مغادرة. الفيديو المُعرَّب بمزامنة شفاه رديئة يفقد مصداقيته في أول عشر ثوانٍ. وسيفترض جمهورك أن جودة الإنتاج رديئة حتى لو كان بقية الفيديو ممتازًا.
ملاحظة: جودة الصوت المُدخل تؤثر في دقة مزامنة الشفاه النهائية أكثر من أي متغير آخر تقريبًا. التسجيلات النظيفة الخالية من الضوضاء بتردد 44.1 كيلوهرتز أو أعلى تمنح الذكاء الاصطناعي أوضح بيانات الفونيمات للعمل عليها.
متى تحتاج إلى مزامنة الشفاه (حالات استخدام واقعية)
توطين المحتوى عبر اللغات
حالة الاستخدام الأوضح: لديك فيديو بالإنجليزية وتحتاج إلى نشره بالإسبانية أو الفرنسية أو البرتغالية أو الصينية الماندرين. كانت الدبلجة التقليدية تتطلب ما بعد إنتاج منفصلًا لكل لغة. مع أدوات مثل Video Translate by HeyGen، التي تدعم أكثر من 150 لغة، يمكنك ترجمة الصوت، وتوليد صوت متطابق، ومزامنة الشفاه في سير عمل واحد.
يُستخدم هذا بكثافة في:
- منصات التعلم الإلكتروني التي تنشر دورات للأسواق الدولية
- فيديوهات التدريب المؤسسي التي تُعرض على المكاتب العالمية
- قنوات YouTube التي تستهدف جمهورًا غير ناطق بالإنجليزية
- الحملات التسويقية المكيّفة للأسواق الإقليمية
صانعو YouTube ومنشئو الدورات
يُعد صنّاع المحتوى الراغبون في الدخول إلى أسواق لغوية جديدة دون إعادة تسجيل مكتبة فيديوهاتهم كاملة من أسرع مجموعات المستخدمين نموًا لأدوات مزامنة الشفاه. فبدلًا من تعلّم الإسبانية، يستطيع صانع المحتوى دبلجة مكتبته الحالية والحصول على نتائج متزامنة وطبيعية المظهر جاهزة للنشر.
سير العمل بسيط: ارفع الفيديو، وقدّم الصوت المدبلج، ودع الذكاء الاصطناعي يتولى حركة الفم. تعالج الأدوات المحسّنة لمحتوى المتحدث الواحد، مثل Lipsync Speed by HeyGen، المقاطع في ثوانٍ لا في دقائق.
فيديوهات العلامات التجارية والتدريب المؤسسي
غالبًا ما تحتاج شركات B2B التي تعمل دوليًا إلى فيديو التدريب نفسه بأربع أو خمس لغات. استئجار استوديو لكل نسخة مكلف وبطيء. تقلل مزامنة الشفاه بالذكاء الاصطناعي هذه التكلفة بشكل كبير مع الحفاظ على عرض بصري ثابت: المقدّم نفسه على الشاشة، والطابع نفسه للعلامة التجارية، فقط بلغة مختلفة.
اختيار نموذج مزامنة الشفاه المناسب
السرعة مقابل الدقة
ينقسم مشهد أدوات مزامنة الشفاه في 2027 إلى فئتين عريضتين: نماذج محسّنة للسرعة للإنجاز السريع، ونماذج دقيقة لجودة مناسبة للبث. معرفة ما تحتاجه قبل البدء توفّر عليك إعادة العمل على المقاطع.
الاختيار حسب الدقة
تحتاج الفيديوهات عالية الدقة (1080p، 4K) إلى نماذج قوية في الحفاظ على التفاصيل. يتعامل كل من Lipsync 2 Pro by Sync وLipsync Precision by HeyGen مع مواد المصدر عالية الدقة دون تمويه أو تشوّه حول منطقة الفم، وهو عطل شائع في الأدوات الأرخص.
بالنسبة إلى المقاطع القصيرة لوسائل التواصل التي تقل عن 30 ثانية، يعيد Lipsync Speed by HeyGen أو Pixverse Lipsync النتائج أسرع بجودة تصمد عند دقّة العرض التي تعتمدها منصات التواصل.
كيفية استخدام أدوات مزامنة الشفاه على PicassoIA
يستضيف PicassoIA أكثر من اثني عشر نموذجًا لمزامنة الشفاه في مكان واحد. لا تحتاج إلى اشتراكات أو حسابات منفصلة. إليك الطريقة الدقيقة لاستخدام الأدوات الرئيسية في سير عمل الدبلجة.
الخطوة 1: جهّز الفيديو والصوت
قبل رفع أي شيء، تأكد من هذين الأمرين:
- الفيديو: بصيغة MP4، ووجه واضح أمامي أو قريب من الأمامي، وإضاءة ثابتة. تجنب الضبابية الحركية الشديدة أو الوجوه بزوايا حادة.
- الصوت المدبلج: بصيغة WAV أو MP3، تسجيل نظيف بأقل قدر من ضوضاء الخلفية. طابق مدة الفيديو الأصلي في حدود ثانية أو ثانيتين.
نصيحة احترافية: إذا كان الصوت المدبلج أطول بكثير من المقطع الأصلي، سيواجه الذكاء الاصطناعي صعوبة في ملاءمة رسم الفونيمات دون تمطيط مرئي. حافظ على مدة الصوت ضمن 10% من طول المقطع الأصلي لأفضل النتائج.
الخطوة 2: شغّل Lipsync Precision
يُعد Lipsync Precision by HeyGen أفضل نقطة بداية للدبلجة الاحترافية. إليك سير العمل:
- افتح صفحة النموذج على PicassoIA.
- ارفع الفيديو الأصلي (الفيديو الذي يحتوي على الوجه الذي تريد إعادة مزامنته).
- ارفع ملف الصوت المدبلج باللغة المستهدفة.
- اختر دقة الإخراج.
- انقر على Generate وانتظر المعالجة (عادةً من دقيقة إلى 3 دقائق لمقطع مدته 60 ثانية).
- عاين الإخراج، مع الانتباه الشديد إلى الصوامت (B، P، M، F، V) وهي الأصعب في المزامنة الدقيقة.
- حمّل المقطع ودمجه في خط زمن المونتاج.
الخطوة 3: شغّل Lipsync Speed
عندما تحتاج إلى تكرار سريع أو تعمل على محتوى لوسائل التواصل، يقلل Lipsync Speed by HeyGen زمن المعالجة بشكل كبير. الإعدادات نفسها المستخدمة في Precision، لكن النموذج يعطي الأولوية لسرعة المعالجة على التفاصيل الدقيقة في منطقة الفم.
الاستخدام الأمثل: TikTok و Instagram Reels و YouTube Shorts بعدة لغات.
الخطوة 4: الدبلجة باستخدام Video Translate
لسير عمل ترجمة الفيديو الكامل، يتولى Video Translate by HeyGen المسار كاملًا: تحويل الكلام إلى نص، وترجمته إلى اللغة المستهدفة، وتوليد الصوت، ومزامنة الشفاه في مرور واحد.
- يدعم أكثر من 150 لغة
- يحافظ على الخصائص الصوتية للمتحدث الأصلي
- يتعامل مع الفيديوهات متعددة المتحدثين بفصل المتحدثين
صُممت هذه الأداة تحديدًا لصنّاع المحتوى الذين يريدون نشر الفيديو نفسه بعدة لغات دون إدارة ملفات صوتية منفصلة لكل لغة.
الخطوة 5: استخدم Kling للمقاطع المُنمّطة
يؤدي Kling Lip Sync by Kwaivgi أداءً جيدًا على المحتوى غير الوثائقي بحتًا، بما في ذلك الشخصيات المتحركة والأفاتار المرسومة والمحتوى المُنمَّط. إذا كان محتواك ذا طابع فني بدلًا من اللقطات الواقعية، يتعامل Kling مع مناطق الوجه غير الواقعية بشكل أفضل من النماذج المدرَّبة على اللقطات الحية فقط.
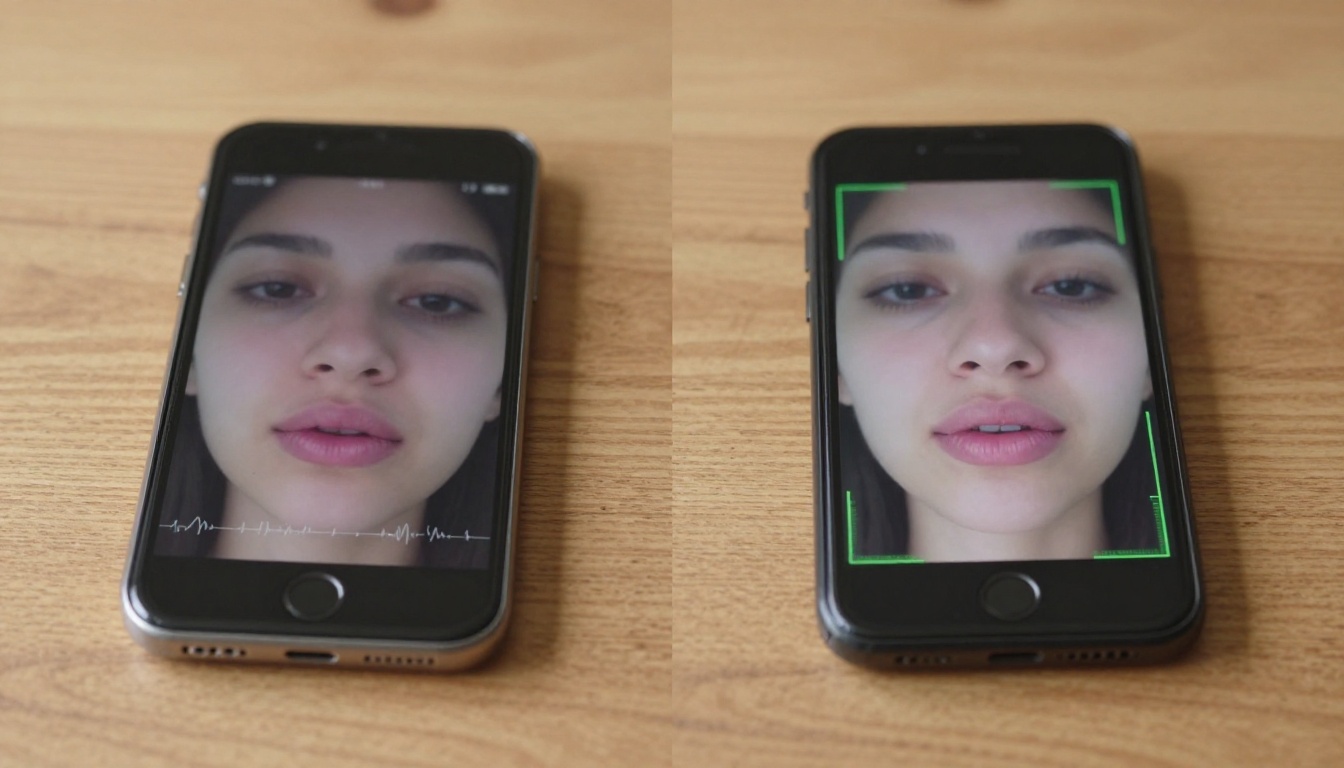
أخطاء شائعة تُفسد المزامنة
مشكلات جودة الصوت
أكثر أسباب الفشل شيوعًا في مزامنة الشفاه بالذكاء الاصطناعي هو إدخال صوت منخفض الجودة. إذا كان الصوت المدبلج يحتوي على:
- هسيس أو ضوضاء الغرفة في الخلفية
- تشويه أو قطع في الصوت
- تشوهات ضغط ثقيلة (MP3 مضغوط بشكل مفرط)
- صدى أو صدى مرتد
...يتضرر كشف النموذج للفونيمات. شغّل الصوت عبر مرور لتقليل الضوضاء قبل الرفع. تقوم أدوات مجانية مثل Adobe Podcast Enhance أو Auphonic بتنظيف الصوت في ثوانٍ.
زاوية الوجه الخاطئة
تُدرَّب نماذج مزامنة الشفاه في الغالب على لقطات الوجه الأمامية والقريبة من الأمامية. الوجه المُنحرف بأكثر من 30 إلى 40 درجة عن المركز ستتراجع جودة مزامنته لأن النموذج لا يرى ما يكفي من بنية الفم لرسم الفونيمات بدقة.
بالنسبة إلى اللقطات ذات الوجوه المائلة، طُوّرت نماذج مثل React 1 by Sync لتتعامل مع تنوع أكبر في وضعية الرأس، لكن حتى هذه لها حدود.
عدم تطابق طول المقطع
إذا كان الصوت المدبلج أطول من الفيديو الأصلي بثلاث ثوانٍ، يحدث أحد أمرين: إما أن يضغط النموذج الصوت بشكل غير طبيعي ليناسب، أو يترك الثواني الأخيرة خارج المزامنة. قُص الصوت أو أضف إليه حشوًا ليطابق طول الفيديو دائمًا قبل المعالجة.
قاعدة عامة: يجب أن تكون مدة الصوت ضمن 5% من مدة الفيديو لنتائج نظيفة. بعد فرق 10%، خطط لتعديل طول الفيديو نفسه قبل تشغيل مزامنة الشفاه.
نصائح احترافية لنتائج أنظف
سجّل الصوت للدبلجة، لا للترجمة فقط
هناك فرق بين صوت الترجمة وصوت الدبلجة. يُسجَّل صوت الترجمة بشكل طبيعي، كما يقرأ متحدث أصلي نصًا. أما صوت الدبلجة فيُسجَّل مع الاهتمام بـمطابقة الإيقاع: يعدّل ممثل الصوت سرعته لتتماشى مع فترات توقف المتحدث الأصلي وأطوال جمله وأنماط تنفسه.
عندما يحترم صوتك المدبلج التوقيت الأصلي، تصبح مهمة نموذج المزامنة أسهل بكثير. فالذكاء الاصطناعي يصحح فروقًا صغيرة في المواضع، لا يحاول حشر ضعف عدد المقاطع الصوتية في نصف الزمن.
بلا كاميرا؟ استخدم نماذج الأفاتار المتحدث
إذا كنت تبدأ من الصفر دون لقطات فيديو موجودة، يمكن لنماذج مثل Omni Human 1.5 by ByteDance وP Video Avatar by PrunaAI توليد فيديو لرأس متحدث مباشرة من صورة ثابتة وملف صوتي. هذا مفيد في:
- إنشاء محتوى متحدث رسمي دون كاميرا
- توليد فيديوهات شرح بأفاتار
- إنتاج محتوى رأس متحدث من صور تاريخية
يتعامل Fabric 1.0 model by Veed أيضًا مع التحويل من صورة ثابتة إلى فيديو متحدث بتفاصيل قوية للشفاه، خاصة للصور بأسلوب البورتريه التي تظهر فيها الوجه الأمامي بوضوح.
المعالجة الدفعية للمحتوى الطويل
بالنسبة إلى الأفلام الوثائقية والدورات أو المقابلات الطويلة، قسّم المحتوى إلى مقاطع من 60 إلى 90 ثانية قبل المعالجة. تتعامل معظم النماذج مع المقاطع القصيرة بدقة أكبر من الطويلة، والتقسيم يمنحك تحكمًا دقيقًا في الأقسام التي تحتاج إلى إعادة معالجة إذا لم يخرج مقطع منها نظيفًا.
مزامنة الشفاه في خط أنابيب دبلجة كامل
يبدو خط أنابيب الدبلجة الاحترافي لفيديو مدته خمس دقائق في 2025 كما يلي:
| المرحلة | الأداة | الوقت |
|---|
| النسخ | نموذج تحويل الكلام إلى نص | 2-3 دقائق |
| الترجمة | نموذج لغوي كبير (يراعي الإيقاع) | 5-10 دقائق |
| توليد الصوت | نموذج تحويل النص إلى كلام | 3-5 دقائق |
| مزامنة الشفاه | Lipsync Precision أو Lipsync 2 Pro | 3-8 دقائق |
| مراجعة الجودة | يدوية | 10-15 دقيقة |
| التصدير | التصيير النهائي | 2-3 دقائق |
المجموع: أقل من 45 دقيقة لفيديو مدبلج باحترافية مدته خمس دقائق. العملية نفسها في استوديو تقليدي تستغرق يومًا إلى ثلاثة أيام.
يدمج نموذج Video Translate من HeyGen المراحل من 1 إلى 4 في خطوة آلية واحدة عندما تريد أقصى سرعة بدلًا من التحكم الدقيق.
ماذا تقول الأرقام عن جودة مزامنة الشفاه
ليست كل مزامنة شفاه متساوية. إليك ما يفصل الإخراج الجيد عن الممتاز، بالأرقام:
- دقة الإطارات: تحقق أفضل النماذج مزامنة دون الإطار عند 30 إطارًا في الثانية (ضمن 16 ميلي ثانية لكل إطار)
- تغطية الفونيمات: تتعامل النماذج المدرّبة على بيانات مستوى الفونيمات مع أكثر من 42 فونيمًا إنجليزيًا؛ أما النماذج الأضعف فتعمّم ضمن مجموعات عريضة
- دقة الوجه: تحافظ نماذج مثل Lipsync 2 Pro على جودة الإخراج حتى 4K؛ بينما تتدهور النماذج الاقتصادية عند 1080p
- دعم اللغات: يغطي Video Translate أكثر من 150 لغة؛ أما النماذج أحادية اللغة فمحسّنة لمجموعة أو مجموعتين من الفونيمات
ملاحظة: عند مقارنة نماذج مزامنة الشفاه، اختبر دائمًا بمحتوى يتضمن الصوامت الصلبة (P، B، F، V) والصوائت الواسعة (A، O). هنا تظهر فروق النماذج بأوضح صورة.
بالنسبة إلى صنّاع المحتوى الذين يحتاجون إلى محتوى رأس متحدث دون فيديو مصدر، يُعد Omni Human by ByteDance النموذج الأساسي للمقارنة قبل الترقية إلى Omni Human 1.5 للعمل الإنتاجي.
ابدأ بدبلجة فيديوهاتك الخاصة
إذا كان لديك فيديو يحتاج إلى دبلجة، سواء كان مقطعًا واحدًا لوسائل التواصل أو مكتبة دورات كاملة لسوق دولي، فالأدوات موجودة الآن لإنجاز ذلك دون استوديو، ودون ممثل صوت في الموقع، ودون قضاء أسبوع في ما بعد الإنتاج.
يجمع PicassoIA كتالوج نماذج مزامنة الشفاه كاملًا في مكان واحد: Lipsync Precision للعمل بجودة البث، وLipsync Speed للتكرار السريع، وKling Lip Sync للمحتوى المُنمّط، وVideo Translate للنشر متعدد اللغات من البداية إلى النهاية. يمكنك تجربة أي منها دون التنقل بين منصات أو إدارة حسابات متعددة.
اختر فيديوك، وجهّز صوتًا نظيفًا، وشغّل أول مزامنة لك. ستُظهر لك النتائج بالضبط ما يمكن أن تقدمه الدبلجة بالذكاء الاصطناعي في 2027.