Doblar un video solía significar alquilar un estudio, contratar a un actor de voz y pasar tres días en postproducción intentando ajustar cada sílaba a cada fotograma. Hoy, las herramientas de lipsync con IA hacen esa alineación de forma automática, en minutos, con resultados que funcionan en redes sociales, cursos en línea, contenido corporativo y publicaciones multilingües. Pero no todas las herramientas de lipsync son iguales, y elegir la equivocada para tu caso te costará tiempo y credibilidad.
Qué hace realmente el lipsync en un video
La ciencia de la alineación entre boca y audio
Cuando un video se dobla, el audio original se reemplaza por una nueva grabación en otro idioma o voz. El problema visual: los movimientos de la boca del hablante se formaron en torno a las palabras originales. "Hello" y "Hola" usan posiciones de boca completamente distintas. Sin corrección, el resultado parece una película extranjera mal doblada de los años 1970.
El lipsync con IA resuelve esto mediante mapeo de fonemas, un proceso en el que el modelo descompone el nuevo audio en sonidos individuales de la boca y ajusta los fotogramas del video para que el rostro refleje correctamente cada sonido. El algoritmo identifica la región del rostro, sigue los grupos musculares de la mandíbula, los labios y las mejillas, y los deforma fotograma a fotograma para coincidir con la nueva secuencia de fonemas.
Los modelos modernos como Lipsync Precision de HeyGen van más allá e incorporan la compensación del movimiento de la cabeza y patrones naturales de parpadeo para evitar el aspecto de "maniquí" que afecta a las herramientas de sincronización más antiguas.
Por qué una mala sincronización hace perder espectadores
Los seres humanos estamos preparados para detectar al instante los desajustes entre audio e imagen. Es el mismo mecanismo que hace que una película mal doblada resulte chocante aunque la traducción sea precisa. La investigación en psicología perceptiva muestra de forma constante que incluso una desincronización de 100 ms entre el audio y el movimiento de los labios produce incomodidad en el espectador.
Para los creadores de contenido, esto se traduce directamente en tasas de abandono. Un video localizado con un lipsync descuidado pierde credibilidad en los primeros diez segundos. Tu audiencia asumirá una producción de baja calidad aunque el resto del video sea excelente.
Nota: La calidad del audio de entrada influye en la precisión final del lipsync más que casi cualquier otra variable. Las grabaciones limpias y sin ruido a 44,1 kHz o más dan a la IA los datos fonéticos más claros con los que trabajar.
Cuándo necesitas lipsync (casos de uso reales)
Localización de contenido en varios idiomas
El caso de uso más evidente: tienes un video en inglés y necesitas publicarlo en español, francés, portugués o mandarín. El doblaje tradicional requería una postproducción separada para cada idioma. Con herramientas como Video Translate de HeyGen, que admite más de 150 idiomas, puedes traducir el audio, sintetizar una voz equivalente y sincronizar los labios en un único flujo de trabajo.
Esto se usa mucho en:
- Plataformas de e-learning que publican cursos para mercados internacionales
- Videos de formación corporativa distribuidos a oficinas de todo el mundo
- Canales de YouTube dirigidos a audiencias que no hablan inglés
- Campañas de marketing adaptadas a mercados regionales
YouTubers y creadores de cursos
Los creadores que quieren entrar en nuevos mercados de idiomas sin volver a grabar toda su biblioteca de videos son uno de los grupos de usuarios de herramientas de lipsync que más crecen. En lugar de aprender a hablar español, un creador puede doblar su catálogo existente y tener resultados sincronizados y de aspecto natural listos para publicar.
El flujo de trabajo es sencillo: sube el video, aporta el audio doblado y deja que la IA se encargue del movimiento de la boca. Las herramientas optimizadas para contenido con un solo hablante, como Lipsync Speed de HeyGen, procesan los clips en segundos, no en minutos.
Videos de marca y formación corporativa
Las empresas B2B con operaciones internacionales a menudo necesitan el mismo video de formación en cuatro o cinco idiomas. Contratar un estudio para cada versión es caro y lento. El lipsync con IA reduce ese costo de forma notable y mantiene una presentación visual coherente: el mismo presentador en pantalla, la misma imagen de marca, solo que en otro idioma.
Cómo elegir el modelo de lipsync adecuado
Velocidad frente a precisión
El panorama de herramientas de lipsync en 2027 se divide en dos grandes grupos: modelos optimizados para la velocidad, para entregas rápidas, y modelos de precisión, para resultados de calidad de emisión. Saber cuál necesitas antes de empezar te evita tener que rehacer clips.
Elegir según la resolución
Los videos de alta resolución (1080p, 4K) necesitan modelos con buena conservación del detalle. Lipsync 2 Pro de Sync y Lipsync Precision de HeyGen trabajan bien con material de origen en alta resolución sin difuminar ni dejar fantasmas alrededor de la boca, un fallo habitual en las herramientas más baratas.
Para clips cortos de redes sociales de menos de 30 segundos, Lipsync Speed de HeyGen o Pixverse Lipsync devuelven resultados más rápido, con una calidad que se sostiene en las resoluciones que usan las plataformas sociales.
Cómo usar las herramientas de lipsync en PicassoIA
PicassoIA reúne más de una docena de modelos de lipsync en un solo lugar. No necesitas suscripciones ni cuentas separadas. Así se usan, paso a paso, las herramientas principales para flujos de doblaje.
Paso 1: prepara el video y el audio
Antes de subir nada, asegúrate de hacer bien estas dos cosas:
- Video: formato MP4, rostro claro de frente o casi de frente, iluminación constante. Evita el desenfoque por movimiento intenso o los rostros en ángulos extremos.
- Audio doblado: WAV o MP3, grabación limpia con un mínimo de ruido de fondo. Ajusta la duración a la del video original con una diferencia de uno o dos segundos.
Consejo profesional: Si tu audio doblado es considerablemente más largo que el clip original, la IA tendrá dificultades para ajustar el mapeo de fonemas sin que se noten estiramientos. Mantén la duración del audio dentro del 10 % de la del clip original para obtener mejores resultados.
Paso 2: ejecuta Lipsync Precision
Lipsync Precision de HeyGen es el mejor punto de partida para el doblaje profesional. Este es el flujo de trabajo:
- Abre la página del modelo en PicassoIA.
- Sube tu video original (el que tiene el rostro que quieres volver a sincronizar).
- Sube el archivo de audio doblado en el idioma de destino.
- Selecciona la resolución de salida.
- Haz clic en Generate y espera a que se procese (normalmente entre 1 y 3 minutos para un clip de 60 segundos).
- Revisa la salida, prestando mucha atención a los sonidos consonánticos (B, P, M, F, V), que son los más difíciles de sincronizar correctamente.
- Descarga el resultado e intégralo en tu línea de tiempo de edición.
Paso 3: ejecuta Lipsync Speed
Cuando necesitas iterar rápido o trabajas con contenido para redes sociales, Lipsync Speed de HeyGen reduce mucho el tiempo de procesamiento. Los parámetros son idénticos a los de Precision, pero el modelo prioriza la velocidad de procesamiento sobre el microdetalle en la región de la boca.
Ideal para: TikTok, Reels de Instagram, YouTube Shorts en varios idiomas.
Paso 4: dobla con Video Translate
Para flujos completos de traducción de video, Video Translate de HeyGen gestiona todo el proceso: transcripción de voz a texto, traducción al idioma de destino, síntesis de voz y lipsync en una sola pasada.
- Admite más de 150 idiomas
- Conserva las características tonales de la voz del hablante original
- Gestiona videos con varios hablantes gracias a la separación de voces
Esta herramienta está pensada específicamente para creadores que quieren publicar el mismo video en varios idiomas sin gestionar un archivo de audio distinto para cada uno.
Paso 5: usa Kling para clips estilizados
Kling Lip Sync de Kwaivgi funciona bien con contenido que no es puramente documental, incluidos personajes animados, avatares ilustrados y video estilizado. Si tu contenido tiene un estilo visual artístico en lugar de imágenes fotorrealistas, Kling maneja mejor las regiones del rostro no fotorrealistas que los modelos entrenados solo con imágenes de personas reales.
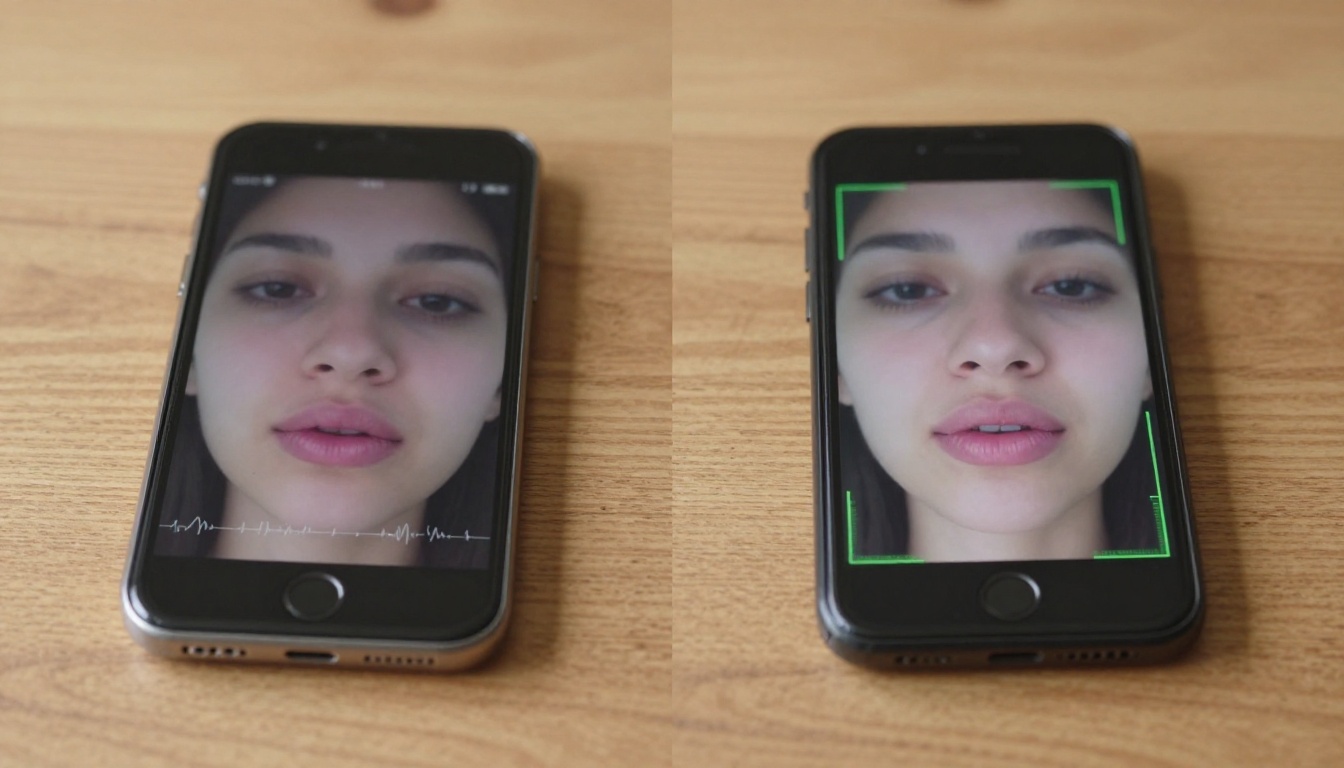
Errores comunes que rompen la sincronización
Problemas de calidad de audio
El fallo más común en el lipsync con IA es un audio de entrada de baja calidad. Si el audio doblado tiene:
- Siseo de fondo o ruido de la habitación
- Saturación o distorsión
- Artefactos de compresión intensa (MP3 sobrecomprimido)
- Eco o reverberación
...la detección de fonemas del modelo se resiente. Pasa tu audio por una reducción de ruido antes de subirlo. Herramientas gratuitas como Adobe Podcast Enhance o Auphonic limpian el audio en segundos.
Ángulo incorrecto del rostro
Los modelos de lipsync se entrenan sobre todo con material de rostros de frente o casi de frente. Un rostro girado más de 30-40 grados desde el centro verá degradada la calidad de la sincronización, porque el modelo no puede ver suficiente estructura de la boca para mapear los fonemas con precisión.
Para material con rostros en ángulo, modelos como React 1 de Sync se han optimizado para una mayor variación en la pose de la cabeza, pero incluso estos tienen límites.
Diferencias en la duración de los clips
Si tu audio doblado dura tres segundos más que el video original, ocurre una de dos cosas: el modelo comprime el audio de forma antinatural para encajar, o deja los últimos segundos desincronizados. Recorta o rellena siempre el audio para que coincida con la duración del video antes de procesarlo.
Regla general: La duración del audio debe estar dentro del 5 % de la del video para obtener resultados limpios. Si la diferencia supera el 10 %, planifica editar la duración del propio video antes de ejecutar el lipsync.
Consejos avanzados para resultados más limpios
Graba el audio pensando en el doblaje, no solo en la traducción
Hay una diferencia entre el audio de una traducción y el de un doblaje. El audio de traducción se graba con naturalidad, como lo leería un hablante nativo. El audio de doblaje se graba prestando atención a la coincidencia de ritmo: el actor de voz ajusta su velocidad para alinearse con las pausas, la longitud de las frases y los patrones de respiración del hablante original.
Cuando tu audio doblado respeta el tiempo original, el modelo de lipsync tiene un trabajo mucho más sencillo. La IA corrige pequeñas diferencias de posición, en lugar de intentar meter el doble de sílabas en la mitad del tiempo.
¿Sin cámara? Usa modelos de avatares parlantes
Si empiezas desde cero, sin material de video existente, modelos como Omni Human 1.5 de ByteDance y P Video Avatar de PrunaAI pueden generar un video de cabeza parlante directamente a partir de una foto fija y un archivo de audio. Esto resulta útil para:
- Crear contenido con portavoces sin necesidad de cámara
- Generar videos explicativos con avatares
- Producir contenido de cabezas parlantes a partir de fotos históricas
El modelo Fabric 1.0 de Veed también convierte fotos en videos parlantes, con un buen nivel de detalle en los labios, sobre todo en fotos de estilo retrato con el rostro frontal bien visible.
Procesamiento por lotes para contenido de larga duración
Para documentales, cursos o entrevistas largas, divide el contenido en segmentos de 60 a 90 segundos antes de procesarlo. La mayoría de los modelos manejan los clips cortos con más precisión que los largos, y segmentar te da un control detallado sobre qué secciones hay que volver a procesar si un segmento no sale limpio.
El lipsync dentro de un pipeline de doblaje completo
Un pipeline de doblaje profesional para un video de cinco minutos en 2025 se ve así:
| Etapa | Herramienta | Tiempo |
|---|
| Transcripción | Modelo de voz a texto | 2-3 min |
| Traducción | LLM (con atención al ritmo) | 5-10 min |
| Síntesis de voz | Modelo de texto a voz | 3-5 min |
| Lipsync | Lipsync Precision o Lipsync 2 Pro | 3-8 min |
| Revisión de calidad | Manual | 10-15 min |
| Exportación | Render final | 2-3 min |
Total: menos de 45 minutos para un video de cinco minutos doblado profesionalmente. El mismo proceso en un estudio tradicional tardaría de uno a tres días.
El modelo Video Translate de HeyGen reúne las etapas 1 a 4 en un único paso automatizado cuando lo que más importa es la velocidad y no el control detallado.
Lo que dicen los números sobre la calidad del lipsync
No todo el lipsync es igual. Lo que separa un buen resultado de uno excelente, en cifras:
- Precisión por fotograma: los mejores modelos logran una sincronización inferior a un fotograma a 30 fps (dentro de 16 ms por fotograma)
- Cobertura de fonemas: los modelos entrenados con datos a nivel de fonema manejan más de 42 fonemas del inglés; los modelos más débiles generalizan en grupos amplios
- Resolución del rostro: modelos como Lipsync 2 Pro mantienen la calidad de salida hasta 4K; los modelos económicos se degradan en 1080p
- Soporte de idiomas: Video Translate cubre más de 150 idiomas; los modelos de un solo idioma están optimizados para uno o dos conjuntos de fonemas
Nota: Al comparar modelos de lipsync, prueba siempre con contenido que incluya consonantes duras (P, B, F, V) y vocales abiertas (A, O). Ahí es donde más se notan las diferencias entre modelos.
Para los creadores que necesitan contenido de cabeza parlante sin video de origen, Omni Human de ByteDance es el modelo base con el que conviene comparar antes de pasar a Omni Human 1.5 para trabajos de producción.
Empieza a doblar tus propios videos
Si tienes un video que necesita doblaje, ya sea un clip para redes sociales o toda una biblioteca de cursos para un mercado internacional, hoy existen las herramientas para hacerlo sin estudio, sin actor de voz en el set y sin pasar una semana en postproducción.
PicassoIA reúne el catálogo completo de modelos de lipsync en un solo lugar: Lipsync Precision para trabajos de calidad de emisión, Lipsync Speed para iterar rápido, Kling Lip Sync para contenido estilizado y Video Translate para publicar en varios idiomas de principio a fin. Puedes probar cualquiera de ellos sin cambiar de plataforma ni gestionar varias cuentas.
Elige tu video, prepara un audio limpio y ejecuta tu primera sincronización. El resultado te mostrará exactamente lo que el doblaje con IA puede ofrecer en 2027.