إذا كنت ترفع فيديوهات على YouTube، فمن المرجح أنك واجهت جدار حقوق النشر في مرحلة ما. مقطع موسيقي بدا مثاليًا يُعلَّم بعد ثلاث ساعات من نشره. تطالب شركة تسجيلات لم تسمع بها من قبل بالعائدات. يُكتم الصوت، فتزيله، وتعيد الرفع، وتنتظر. إنها حلقة مرهقة، ويمكن تجنبها تمامًا اليوم بعد أن أصبحت أدوات توليد الموسيقى بالذكاء الاصطناعي مثل Stable Audio 2.5 قادرة على إنتاج موسيقى تصويرية أصلية من أمر نصي واحد.

ما هو Stable Audio 2.5 فعليًا
Stable Audio 2.5 نموذج لتوليد الموسيقى بالذكاء الاصطناعي أنشأته Stability AI. يأخذ أمرًا نصيًا وينتج مقطعًا صوتيًا كاملًا بتوقيت وبنية وطبقات من الآلات تبدو موسيقية حقًا. وهو ليس أداة لتكديس الحلقات أو مزج الإعدادات المسبقة. إنه يكتب تراكيب أصلية من الصفر بناءً على ما تصفه.
يدعم النموذج مدداً تصل إلى 3 دقائق لكل توليد، وهذا يغطي معظم موسيقى مقدمات YouTube، والموسيقى الخلفية، ومقاطع الانتقال القصيرة. تصف الإيقاع والمزاج والنوع والآلات الموسيقية بلغة إنجليزية بسيطة، ويتولى النموذج الباقي.
البيانات التي دُرِّب عليها النموذج
درّبت Stability AI النموذج على بيانات صوتية مرخّصة، ما يعني أن المخرجات ليست مشتقة من مقطوعات محمية بحقوق النشر كما قد يفعل أحد أدوات أخذ العينات. ما يخرج منه هو صوت جديد فعلًا. وهذا مهم لمبدعي YouTube، لأن Content ID لا يستطيع مطابقة شيء لم يوجد من قبل.
مقارنته بالمقاطع الجاهزة من المكتبات
| الميزة | Stable Audio 2.5 | المقاطع القياسية من المكتبات |
|---|
| خالية من حقوق الملكية | نعم، دائمًا | غالبًا (حسب شروط الترخيص) |
| قابلة للتخصيص حسب المزاج | تحكم كامل عبر الأمر النصي | محصورة في البحث داخل الكتالوج |
| تطابق المدة بدقة | نعم، تُحدَّد قبل التوليد | تتطلب تحريرًا يدويًا |
| خطر Content ID | لا يوجد | محتمل |
| التكلفة لكل مقطع | مجاني أو منخفضة التكلفة | اشتراك أو رسوم لكل مقطع |

مشكلة حقوق النشر التي يتجاهلها معظم المبدعين
يتعامل كل مبدع على YouTube مع الموسيقى بالطريقة نفسها في البداية. يجد مقطعًا يحبه، ويضعه في الفيديو وينشره. ثم يحدث أحد ثلاثة أشياء: يُعلَّم الفيديو وتذهب الأرباح إلى صاحب الحقوق، أو يُحظر الصوت في دول معينة، أو يشترك المبدع في خدمة موسيقى خالية من حقوق الملكية ويقضي ساعات في البحث عن شيء يناسب الفيديو دون أن يبدو كموسيقى جاهزة.
كيف تعمل مطالبات حقوق النشر فعليًا
يفحص نظام Content ID في YouTube كل ثانية من الصوت المرفوع مقابل قاعدة بيانات من المقاطع المسجلة. ولا يهم إن كنت قد اشتريت ترخيصًا. يظل صاحب الحقوق الأصلي هو من يقرر ما يحدث لفيديوك: حظره، أو تحقيق الربح منه بنفسه، أو السماح به بشروط.
الترخيص من موقع خارجي للموسيقى الخالية من حقوق الملكية لا يلغي قرار صاحب الحقوق الفعلي. أكثر الأصوات أمانًا على YouTube هي الأصوات غير الموجودة أصلًا في قاعدة بيانات Content ID. وهذا بالضبط ما توفره الموسيقى المولّدة بالذكاء الاصطناعي.

التكلفة الحقيقية لمكتبات الموسيقى الخالية من حقوق الملكية
خدمات الاشتراك مثل Epidemic Sound و Artlist و Musicbed تكلّف بين 10 و50 دولارًا شهريًا. توفر موسيقى جيدة، لكنك في الحقيقة تستأجر الوصول إليها. إذا توقفت عن الدفع، فقد تفقد الحق في استخدام المقاطع في الفيديوهات الموجودة، حسب شروط الترخيص. وبالنسبة للمبدعين الجدد أو القنوات التي لا تزال تبحث عن جمهورها، فإن هذه التكلفة المتكررة تتراكم بسرعة دون عائد واضح.
💡 يستغرق إنتاج مقطع واحد بالذكاء الاصطناعي من 10 إلى 30 ثانية، وتكلفته جزء بسيط من اشتراك شهري. وتملكه إلى الأبد.
استخدام Stable Audio 2.5 على PicassoIA
تستضيف PicassoIA Stable Audio 2.5 مباشرةً على منصتها. لا تحتاج إلى حساب في Stability AI، ولا إلى مفتاح API، ولا إلى أي إعداد تقني. افتح صفحة النموذج، واكتب أمرًا نصيًا، ثم ولّد.
خطوة بخطوة: مقطعك الأول
الخطوة 1. انتقل إلى Stable Audio 2.5 على PicassoIA وافتح واجهة التوليد.
الخطوة 2. في حقل الأمر النصي، صِف الموسيقى التي تريدها. كن محددًا في ثلاثة أمور: النوع، والمزاج، ومستوى الطاقة.
الخطوة 3. حدّد المدة. بالنسبة لمقدمات YouTube، تكون مدة 30 إلى 60 ثانية شائعة. أما للموسيقى الخلفية تحت درس تعليمي أو مدونة فيديو، فاستهدف من 90 إلى 180 ثانية.
الخطوة 4. ولّد. يعيد النموذج النتيجة في 15 إلى 40 ثانية.
الخطوة 5. استمع. إذا لم يكن الناتج مناسبًا تمامًا، فعدّل الأمر النصي وأعد التوليد. لا يوجد حد للتجريب.
الخطوة 6. نزّل ملف الصوت واستورده إلى محرر الفيديو.
كتابة أوامر نصية تعمل فعلًا
يكتب معظم المبدعين أوامر نصية ضعيفة في محاولتهم الأولى. فعبارة "موسيقى خلفية حماسية" تنتج شيئًا عامًا. ويستجيب النموذج بشكل أفضل بكثير للتفاصيل.
| أمر نصي ضعيف | أمر نصي قوي |
|---|
| "موسيقى هادئة لقناة YouTube" | "بيانو Lo-fi مع طقطقة فينيل ناعمة، 75 BPM، حزين لكنه دافئ، بدون غناء، 90 ثانية" |
| "موسيقى ألعاب ملحمية" | "لحن أكشن أوركسترالي بنفخ نحاسي ثقيل ورولات السنير (snare)، 140 BPM، تصاعد سينمائي للتوتر يبلغ ذروته عند 45 ثانية" |
| "موسيقى فيديوهات السفر المبهجة" | "عزف غيتار أكوستيك بالأصابع مع إيقاع خفيف، أجواء صباح مشمس، 95 BPM، بدون غناء، خفوت تدريجي لطيف في النهاية" |
💡 ضمّن BPM والآلات والصفات المعبّرة عن المزاج والمدة في كل أمر نصي. كلما زادت التفاصيل التي تقدمها، اقترب الناتج من المطلوب من المحاولة الأولى.
المعاملات المهمة فعلًا
يمنحك Stable Audio 2.5 تحكمًا يتجاوز نص الأمر النصي. أهم المعاملات التي ينبغي معرفتها:
- المدة: من 10 ثوانٍ إلى 3 دقائق. حدّدها قبل التوليد.
- الخطوات: أعداد الخطوات الأعلى تنتج مخرجات أكثر صقلًا لكنها تستغرق وقتًا أطول. ابدأ بالقيمة الافتراضية، ولا تزدها إلا إذا لم ترضك الجودة.
- البذرة: ثبّت قيمة البذرة لتوليد تنويعات على مقطع يعجبك تقريبًا، مع الحفاظ على الأساس البنيوي نفسه وتعديل عناصر صغيرة.
أفضل الأنماط الموسيقية حسب نوع الفيديو
ليست كل فئة على YouTube تحتاج الصوت نفسه. يتيح توليد الموسيقى بالذكاء الاصطناعي مطابقة الصوت لما يتطلبه الفيديو بالضبط، بدلًا من التنازل عن شيء قريب بما يكفي من كتالوج.
لمدونات السفر ونمط الحياة
يناسب محتوى السفر الموسيقى التي تبدو منفتحة ونوستالجية قليلًا. فكّر في الآلات الأكوستيكية، والإنتاج البسيط، وإيقاعات تتراوح بين 85 و100 BPM. ينبغي ألا تنافس الموسيقى الأصوات المحيطة بالمكان.
قالب الأمر النصي: Fingerpicked acoustic guitar with subtle cajon percussion, open countryside feeling, 88 BPM, warm afternoon mood, 2 minutes, no vocals, gentle fade

لمحتوى الألعاب والتقنية
غالبًا ما يحتاج محتوى الألعاب إلى نوعين من الموسيقى: مقاطع عالية الطاقة للمونتاج واللحظات المميزة، ومقاطع جوية متوترة لمشاهد التشويق. ويتعامل الذكاء الاصطناعي مع الاثنين لأنك تحدد النبرة العاطفية الدقيقة التي تحتاجها.
أمر نصي عالي الطاقة: Fast-paced electronic drum and bass with heavy synth bass, 155 BPM, aggressive and energetic, 60-second loop with consistent intensity
أمر نصي للأجواء الموسيقية: Dark atmospheric synth pads, slow evolving textures, minimal rhythm, eerie and focused, 120 seconds

للمحتوى التعليمي والدروس
تحتاج فيديوهات الدروس إلى موسيقى لا تشتّت الانتباه إطلاقًا. اللحظة التي يبدأ فيها المشاهد بمعالجة الموسيقى بدلًا من المحتوى، تكون المقطوعة قد فشلت في مهمتها.
قالب الأمر النصي: Soft lo-fi piano with light static, minimal arrangement, 70 BPM, studious concentration mood, 3 minutes, no build or drop
للوثائقيات والأفلام القصيرة
يحتاج المحتوى الوثائقي إلى موسيقى ذات قوس سردي. يجب أن تتطور المقطوعة مع الوقت. ويتعامل توليد الموسيقى بالذكاء الاصطناعي مع ذلك بأوامر نصية تصف التطور بصراحة.
قالب الأمر النصي: Sparse solo piano building slowly over 2 minutes into a full string quartet arrangement, emotionally weighted, cinematic pacing, no drums, crescendo at 1:45
كيف يبدو الناتج فعليًا
أكثر سؤال شيوعًا حول توليد الموسيقى بالذكاء الاصطناعي هو ما إذا كانت تبدو حقيقية. الإجابة الصادقة: يعتمد ذلك بشدة على النوع الموسيقي. يتفوق Stable Audio 2.5 في الأنواع الإلكترونية، وفي lo-fi، والأوركسترالي السينمائي، والأجواء الموسيقية (ambient). ويؤدي أداءً مقبولًا في الفولك الأكوستيك والجاز، لكنه قد يُدخل تشوهات طفيفة (artifacts) في توزيعات الأكوردات المعقدة.
الأنواع التي يتفوق فيها
- الإلكترونية: هاوس، تكنو أمبينت، سينثويف، درام آند باس
- السينمائية: التأليف الأوركسترالي، موسيقى التوتر، ثيمات الأكشن
- لو-فاي: إيقاعات الدراسة، هيب هوب هادئ، جماليات الأسطوانات القديمة
- الأكوستيكية: عزف جيتار بسيط بالأصابع، أغانٍ هادئة بالبيانو المنفرد
- التجريبية: تصميم الصوت، أجواء صوتية ذات ملمس، موسيقى الدرون
التكرار دون أن يبدو واضحًا
بالنسبة للفيديوهات التي تتجاوز 3 دقائق، ستحتاج إلى تكرار مقطع أو توليد عدة أجزاء. يعمل التكرار بأفضل شكل عندما تطلب مقطوعة "ذات بنية متكررة ثابتة" وتتأكد من أن نهاية المقطوعة تنتهي بسلاسة قبل العودة إلى البداية.
💡 ولّد نسختين من الأمر النصي نفسه ببذرتين مختلفتين، ثم انتقل تدريجيًا بينهما في المحرر. هذا يعطي انطباعًا بموسيقى أصلية متصلة دون أن يصبح التكرار ملحوظًا.
نماذج موسيقى أخرى بالذكاء الاصطناعي على PicassoIA
تستضيف PicassoIA عدة نماذج لتوليد الموسيقى إلى جانب Stable Audio 2.5. ولكل منها نقاط قوة تستحق التجربة، حسب ما تحتاجه قناتك أكثر.
يولّد Minimax Music 2.6 أغانٍ كاملة تشمل الغناء وكلمات منظمة. إذا كانت قناتك على YouTube تحتاج إلى أغانٍ أصلية لا مقطوعات دون كلمات، فهذا هو النموذج المناسب. يدعم كلمات مخصصة وينتج مقاطع كاملة ببنية المقطع والمقطع الرئيسي.
صُمّم Google Lyria 3 Pro لإنتاج موسيقي عالي الجودة. يقدم نتائج أنظف بشكل ملحوظ في المستوى الأعلى من الجودة، خاصة في الأنواع الأوركسترالية والأكوستيك. وهو الخيار الأقوى عندما تكون جودة الصوت هي الهمّ الأول.
يقدم Google Lyria 3 جودة قريبة من Lyria 3 Pro بسرعة توليد أعلى قليلًا. خيار افتراضي جيد للمبدعين الذين يريدون جودة ثابتة دون انتظار أطول.
يتعامل Minimax Music 2.5 مع إنشاء الأغاني الغنائية مع التزام قوي بالكلمات. مثالي للقنوات التي تريد مقدمات موسيقية قصيرة مميزة بعلامتها التجارية، أو موسيقى تحمل هوية صوتية ثابتة عبر الفيديوهات.
يتكامل ElevenLabs Music بسلاسة مع أدوات تركيب الصوت من ElevenLabs. إذا كنت تستخدم ElevenLabs للتعليق الصوتي بالفعل، يتيح لك هذا النموذج إنتاج الموسيقى ضمن سير العمل نفسه.
الموسيقى المولّدة بالذكاء الاصطناعي مع التعليق الصوتي المولّد به
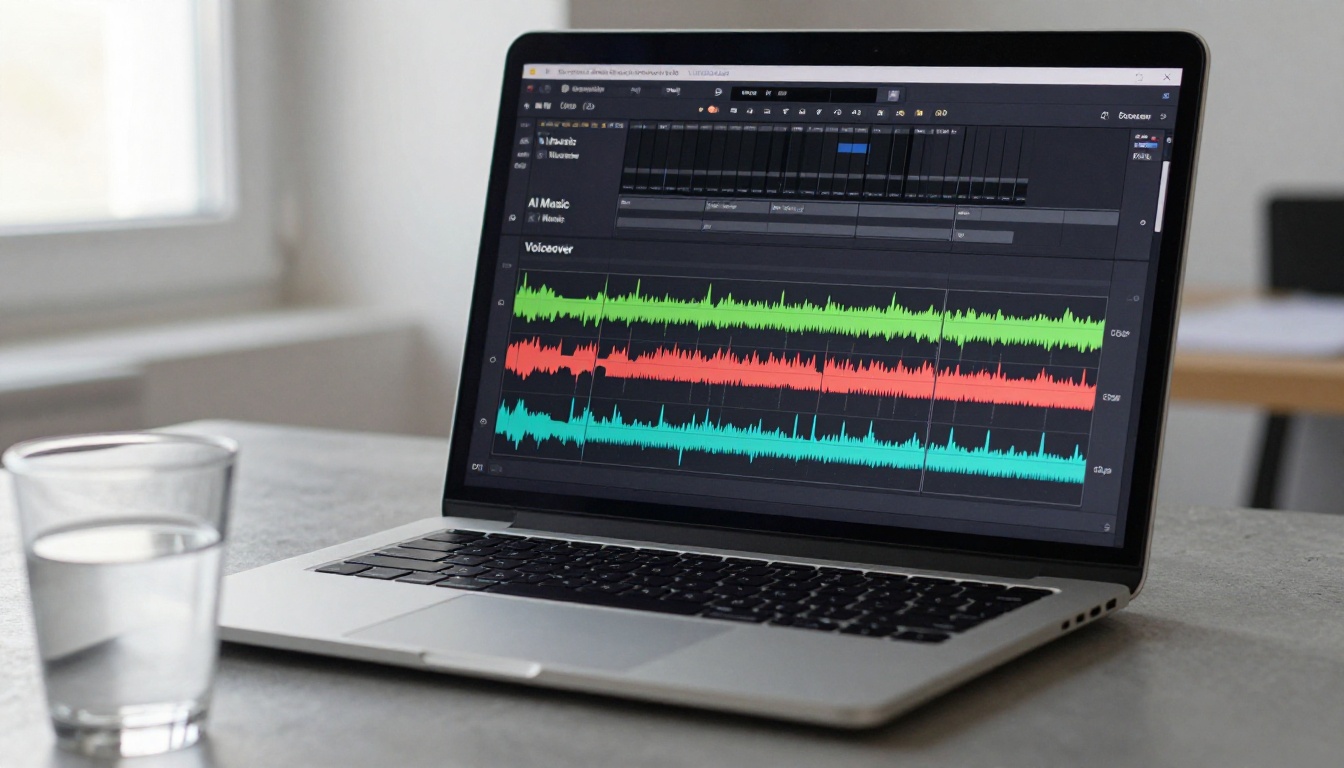
أكثر سير عمل فعّال لإنتاج فيديوهات YouTube حاليًا يجمع بين توليد الموسيقى بالذكاء الاصطناعي وتحويل النص إلى كلام للتعليق. اكتب السيناريو، وولّد تعليقًا صوتيًا، وولّد موسيقى خلفية، وضعها في طبقات داخل المحرر، ثم صدّر. لا استوديو تسجيل، ولا ترخيص موسيقى، ولا بحث في الكتالوجات.
نماذج تحويل النص إلى كلام التي تعمل بكفاءة
ينتج Minimax Speech 2.8 HD تعليقات صوتية بجودة الاستوديو مع إيقاع وتنغيم طبيعيين. يتعامل مع السرد الطويل دون الرتابة الآلية التي تعاني منها كثير من أنظمة تحويل النص إلى كلام، ما يجعله خيارًا موثوقًا لمحتوى الدروس والمحتوى على طراز الوثائقيات.
يُعد ElevenLabs V3 الخيار الأقوى للأداء الصوتي المعبّر. إذا تضمّن السيناريو مدى عاطفيًا، أو وقفات مدروسة، أو صياغة حوارية، فإن V3 يتعامل مع الفروق الدقيقة بشكل أفضل من معظم البدائل المتاحة اليوم.
ضبط توازن مستوى الصوت بشكل صحيح
أكثر خطأ شائع عند الجمع بين الموسيقى المولّدة بالذكاء الاصطناعي والتعليقات الصوتية هو توازن مستوى الصوت. الموسيقى المرتفعة أكثر من اللازم تنافس الصوت البشري وتسبب إرهاقًا للمستمع. نقطة بداية عملية لأي مشروع:
- التعليق الصوتي: 0 dB (مستوى المرجع)
- الموسيقى الخلفية تحت الصوت: من -18 dB إلى -24 dB
- الموسيقى أثناء المقدمة أو الخاتمة دون صوت: من -6 dB إلى -10 dB
استخدم أتمتة مستوى الصوت أو ضاغط Sidechain في المحرر لخفض مستوى الموسيقى تلقائيًا كلما كان التعليق الصوتي نشطًا. تتضمن DaVinci Resolve وPremiere Pro وCapCut هذه الميزة مدمجة.
💡 صدّر مسار الصوت والموسيقى بمعدل البت نفسه. التعليق الصوتي بمعدل 320kbps فوق ملف موسيقى بمعدل 128kbps يخلق اختلالًا مسموعًا. اجعل كليهما بمعدل 320kbps، أو استخدم WAV لكليهما.
سير عمل صوتي كامل بالذكاء الاصطناعي
إليك شكل بناء الصوت الكامل لفيديو YouTube باستخدام PicassoIA من البداية إلى النهاية:
- اكتب السيناريو في أي محرر نصوص.
- ولّد التعليق الصوتي باستخدام Minimax Speech 2.8 HD أو ElevenLabs V3. نزّله بصيغة MP3 أو WAV.
- ولّد موسيقى المقدمة باستخدام Stable Audio 2.5 مع أمر نصي قصير وحيوي (من 15 إلى 30 ثانية).
- ولّد الموسيقى الخلفية بأمر نصي هادئ ومتسق يطابق الموضوع (من 90 إلى 180 ثانية).
- ولّد موسيقى الخاتمة التي تحسم المزاج (30 ثانية، تنتهي بتلاشٍ).
- استورد كل شيء إلى محررك. ضع المسارات في طبقات، ووازن مستويات الصوت، وأضف الخفض التلقائي.
- صدّر وانشر.
إجمالي وقت مرحلة إنتاج الصوت: من 15 إلى 20 دقيقة. إجمالي التكلفة: أقل بكثير من اشتراك شهري في أي مكتبة موسيقى كبرى خالية من حقوق الملكية، دون أي مدفوعات مستمرة.
ابدأ بإنشاء موسيقاك التصويرية الخاصة
إذا كنت تتحايل على نظام حقوق النشر في YouTube باستخدام مقاطع مكتبات مجانية أو اشتراكات مكلفة، فإن Stable Audio 2.5 يزيل هذا القيد تمامًا. كل مقطع تولّده أصلي، ولا وجود له في أي قاعدة بيانات Content ID، وهو ملكك إلى الأبد لاستخدامه في أي فيديو تنشره.
المنصة متاحة الآن. انتقل إلى صفحة نموذج Stable Audio 2.5 على PicassoIA، واكتب أمرًا نصيًا يصف الصوت الذي يحتاجه فيديوك التالي، وشاهد النتيجة في أقل من دقيقة.
بالنسبة للقنوات التي تحتاج إلى أغانٍ كاملة بالغناء، فإن Minimax Music 2.6 وGoogle Lyria 3 Pro متاحان على المنصة نفسها دون أي إعداد إضافي. وللتعليقات الصوتية التي تُرافق الموسيقى، فإن Minimax Speech 2.8 HD وElevenLabs V3 جاهزان كلما احتجتهما.
موسيقاك التصويرية في انتظارك. كل ما عليك فعله هو وصفها.


