Se você publica vídeos no YouTube, provavelmente já esbarrou no muro dos direitos autorais em algum momento. Uma faixa que soava perfeita é sinalizada três horas depois da publicação. A receita é reivindicada por uma gravadora que você nunca ouviu falar. O áudio é silenciado, você tira o som, sobe o vídeo de novo e espera. É um ciclo desgastante, e hoje ele é totalmente evitável, já que ferramentas de geração de música por IA como o Stable Audio 2.5 conseguem criar trilhas originais a partir de um único prompt de texto.

O que é o Stable Audio 2.5, na prática
O Stable Audio 2.5 é um modelo de geração de música por IA criado pela Stability AI. Ele recebe um prompt de texto e produz uma faixa completa, com tempo, estrutura e camadas de instrumentos que soam genuinamente musicais. Não é um sequenciador de loops nem um mixador de predefinições. Ele compõe obras originais do zero, com base no que você descreve.
O modelo aceita durações de até 3 minutos por geração, o que cobre a maior parte das músicas de abertura do YouTube, trilhas de fundo e transições curtas. Você descreve andamento, clima, gênero e instrumentação em linguagem simples, e o modelo cuida do resto.
Com o que o modelo foi treinado
A Stability AI treinou o modelo com dados de áudio licenciados, o que significa que os resultados não são derivados de faixas protegidas por direitos autorais, como aconteceria com um sampler. O que sai é um áudio realmente novo. Isso importa para criadores do YouTube, porque o Content ID não consegue identificar algo que nunca existiu antes.
Como ele se compara às faixas de bibliotecas
| Recurso | Stable Audio 2.5 | Faixas de bibliotecas padrão |
|---|
| Livre de royalties | Sim, sempre | Geralmente (conforme os termos da licença) |
| Personalizável por clima | Controle total pelo prompt | Limitado à busca no catálogo |
| Duração exata | Sim, definida antes de gerar | Exige edição manual |
| Risco no Content ID | Nenhum | Possível |
| Custo por faixa | Gratuito ou de baixo custo | Assinatura ou taxa por faixa |

O problema dos direitos autorais que a maioria dos criadores ignora
Todo criador do YouTube lida com música da mesma maneira no começo. Encontra uma faixa de que gosta, coloca no vídeo e publica. Aí acontece uma de três coisas: o vídeo é sinalizado e a monetização vai para o detentor dos direitos, o áudio é bloqueado em certos países, ou o criador paga uma assinatura livre de royalties e passa horas procurando algo que combine com o vídeo sem soar como música de estoque.
Como as reivindicações de direitos funcionam na prática
O sistema Content ID do YouTube analisa cada segundo do áudio enviado em busca de correspondências em um banco de dados de faixas registradas. Ele não se importa se você comprou uma licença. O detentor original dos direitos ainda decide o que acontece com seu vídeo: bloqueá-lo, monetizá-lo ele mesmo ou deixá-lo passar sob certas condições.
Uma licença de um site de terceiros que oferece músicas livres de royalties não anula o que o detentor real dos direitos decide. O áudio mais seguro no YouTube é aquele que não existe no banco de dados do Content ID. É exatamente isso que a música gerada por IA oferece.

O custo real das bibliotecas livres de royalties
Serviços por assinatura como Epidemic Sound, Artlist e Musicbed custam entre US$ 10 e US$ 50 por mês. Eles oferecem boa música, mas você está alugando o acesso. Se parar de pagar, pode perder o direito de usar faixas em vídeos já publicados, dependendo dos termos da licença. Para criadores novos ou canais que ainda estão encontrando seu público, esse custo recorrente se acumula rápido, sem um retorno claro.
💡 Uma única faixa gerada por IA leva de 10 a 30 segundos para ser produzida e custa uma fração de uma assinatura mensal. Ela é sua para sempre.
Como usar o Stable Audio 2.5 no PicassoIA
O PicassoIA oferece o Stable Audio 2.5 diretamente em sua plataforma. Você não precisa de uma conta na Stability AI, de uma chave de API ou de qualquer configuração técnica. Abra a página do modelo, escreva um prompt e gere.
Passo a passo: sua primeira faixa
Passo 1. Acesse o Stable Audio 2.5 no PicassoIA e abra a interface de geração.
Passo 2. No campo do prompt, descreva a música que você quer. Seja específico em três pontos: o gênero, o clima e o nível de energia.
Passo 3. Defina a duração. Para aberturas do YouTube, de 30 a 60 segundos é o usual. Para música de fundo sob um tutorial ou vlog, mire entre 90 e 180 segundos.
Passo 4. Gere. O modelo devolve um resultado em 15 a 40 segundos.
Passo 5. Ouça. Se não estiver muito certo, ajuste o prompt e gere de novo. Não há limite para experimentar.
Passo 6. Baixe o arquivo de áudio e importe-o para seu editor de vídeo.
Escrevendo prompts que realmente funcionam
A maioria dos criadores escreve prompts fracos na primeira tentativa. "Música de fundo animada" gera algo genérico. O modelo responde muito melhor à especificidade.
| Prompt fraco | Prompt forte |
|---|
| "Música relaxante para o YouTube" | "Piano lo-fi com chiado suave de vinil, 75 BPM, melancólico, mas caloroso, sem vocais, 90 segundos" |
| "Música épica de games" | "Tema de ação orquestral com metais pesados e rufos de caixa, 140 BPM, tensão cinematográfica crescente, chegando a um ápice dramático aos 45 segundos" |
| "Música alegre para vlog de viagem" | "Violão acústico em dedilhado com percussão leve, clima de manhã ensolarada, 95 BPM, sem vocais, fade-out suave no final" |
💡 Inclua BPM, instrumentos, adjetivos de clima e duração em todo prompt. Quanto mais detalhes você der, mais o resultado se aproxima do ideal na primeira tentativa.
Parâmetros que realmente importam
O Stable Audio 2.5 oferece controle sobre mais do que o texto do prompt. Os parâmetros principais que você precisa conhecer:
- Duração: de 10 segundos a 3 minutos. Defina antes de gerar.
- Steps: contagens de steps mais altas produzem um resultado mais refinado, mas demoram mais. Comece com o padrão e aumente só se a qualidade não estiver satisfatória.
- Seed: fixe uma seed para gerar variações de uma faixa de que você quase gosta, mantendo a mesma base estrutural e ajustando pequenos elementos.
Os melhores estilos de música por tipo de vídeo
Nem todo nicho do YouTube precisa do mesmo som. A geração de música por IA permite combinar o áudio exatamente com o que o vídeo exige, em vez de se contentar com algo parecido no catálogo.
Para vlogs de viagem e estilo de vida
Conteúdo de viagem funciona melhor com músicas que pareçam abertas e levemente nostálgicas. Pense em instrumentos acústicos, produção minimalista e andamentos entre 85 e 100 BPM. A música não deve competir com o som ambiente do lugar.
Modelo de prompt: Fingerpicked acoustic guitar with subtle cajon percussion, open countryside feeling, 88 BPM, warm afternoon mood, 2 minutes, no vocals, gentle fade

Para vídeos de games e tecnologia
Conteúdo de games costuma precisar de dois tipos de música: faixas de alta energia para montagens e destaques, e música atmosférica e tensa para cenas de suspense. A IA atende aos dois, porque você especifica o registro emocional exato de que precisa.
Prompt de alta energia: Fast-paced electronic drum and bass with heavy synth bass, 155 BPM, aggressive and energetic, 60-second loop with consistent intensity
Prompt ambiente: Dark atmospheric synth pads, slow evolving textures, minimal rhythm, eerie and focused, 120 seconds

Para conteúdo educativo e tutoriais
Vídeos de tutorial precisam de música que fique completamente fora do caminho. No momento em que o espectador começa a processar a música em vez do conteúdo, a faixa falhou em seu papel.
Modelo de prompt: Soft lo-fi piano with light static, minimal arrangement, 70 BPM, studious concentration mood, 3 minutes, no build or drop
Para documentários e curtas-metragens
Conteúdo documental exige música com arco narrativo. A faixa precisa evoluir ao longo do tempo. A geração de música por IA resolve isso com prompts que descrevem a progressão explicitamente.
Modelo de prompt: Sparse solo piano building slowly over 2 minutes into a full string quartet arrangement, emotionally weighted, cinematic pacing, no drums, crescendo at 1:45
Como o resultado realmente soa
A pergunta mais comum sobre geração de música por IA é se ela soa real. A resposta honesta: depende muito do gênero. O Stable Audio 2.5 tem o melhor desempenho em gêneros eletrônicos, lo-fi, orquestral cinematográfico e ambient. Ele se sai razoavelmente bem em folk acústico e jazz, mas pode introduzir artefatos sutis em voicings de acordes complexos.
Gêneros em que ele se destaca
- Eletrônico: house, ambient techno, synthwave, drum and bass
- Cinematográfico: trilhas orquestrais, música de tensão, temas de ação
- Lo-fi: beats para estudar, chill hip-hop, estética de vinil
- Acústico: violão dedilhado simples, baladas para piano solo
- Experimental: design de som, ambientes texturais, música de drone
Fazer loop sem que pareça óbvio
Para vídeos com mais de 3 minutos, você vai precisar fazer loop de uma faixa ou gerar vários segmentos. O loop funciona melhor quando você pede uma faixa "com uma estrutura repetitiva consistente" e garante que o final da faixa se resolva bem antes de voltar ao início.
💡 Gere duas versões do mesmo prompt com seeds diferentes e, depois, faça um crossfade entre elas no seu editor. Isso cria a impressão de uma música original contínua, sem que o loop fique perceptível.
Outros modelos de música por IA no PicassoIA
O PicassoIA oferece vários modelos de geração de música além do Stable Audio 2.5. Cada um tem pontos fortes diferentes que vale testar, dependendo do que seu canal mais precisa.
Minimax Music 2.6 gera canções completas, incluindo vocais e letras estruturadas. Se o seu canal do YouTube precisa de canções originais em vez de instrumentais, este é o modelo certo. Ele aceita letras personalizadas e produz faixas completas com estrutura de versos e refrão.
Google Lyria 3 Pro foi feito para produção musical de alta fidelidade. Ele entrega resultados visivelmente mais limpos nos níveis mais altos, especialmente para gêneros orquestrais e acústicos. É a opção mais forte quando a qualidade do áudio é a principal preocupação.
Google Lyria 3 oferece qualidade semelhante à do Lyria 3 Pro com uma geração um pouco mais rápida. Uma boa opção padrão para criadores que querem qualidade consistente sem uma espera maior.
Minimax Music 2.5 faz a criação de canções com vocais e tem forte aderência às letras. Ideal para canais que querem vinhetas de abertura com a marca ou música que carregue uma identidade vocal consistente entre os vídeos.
ElevenLabs Music se integra naturalmente às ferramentas de síntese de voz da ElevenLabs. Se você já usa a ElevenLabs para narrações, este modelo permite produzir música dentro do mesmo fluxo de trabalho.
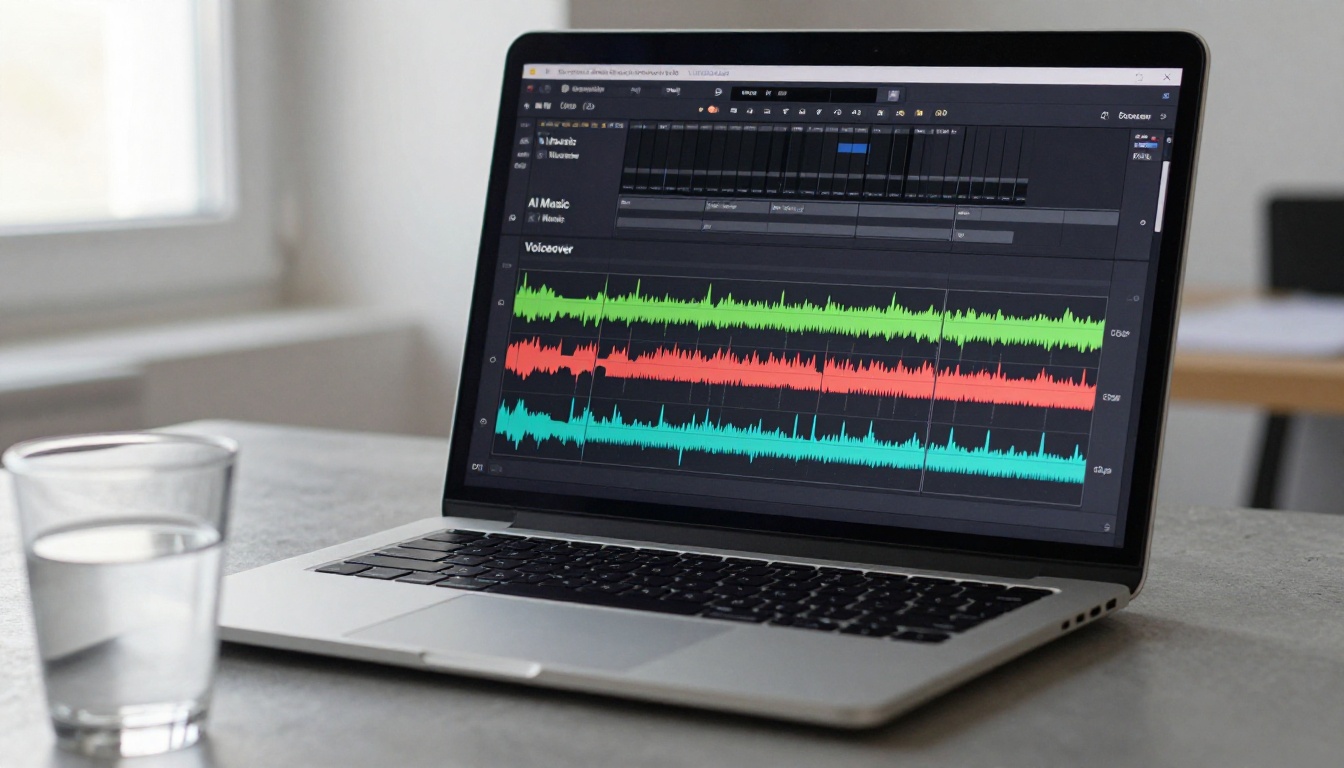
O fluxo de produção mais eficiente para o YouTube hoje combina geração de música por IA com texto para fala para a narração. Escreva um roteiro, gere a narração, gere a música de fundo, sobreponha tudo no editor e exporte. Sem cabine de gravação, sem licenciamento de música, sem busca em catálogo.
Modelos de texto para fala que funcionam bem
O Minimax Speech 2.8 HD produz narrações com qualidade de estúdio, com ritmo e entonação naturais. Ele lida com narrações longas sem a cadência robótica que atrapalha muitos sistemas de texto para fala, o que o torna uma escolha confiável para conteúdos no estilo tutorial e documentário.
O ElevenLabs V3 é a opção mais forte para uma entrega de voz expressiva. Se o roteiro tem variação emocional, pausas estratégicas ou frases conversacionais, o V3 lida com essas nuances melhor do que a maioria das alternativas disponíveis hoje.
Acertando o equilíbrio de volume
O erro mais comum ao combinar música por IA com narrações é o equilíbrio de volume. Música alta demais compete com a voz e causa cansaço no ouvinte. Um ponto de partida prático para qualquer projeto:
- Narração: 0 dB (nível de referência)
- Música de fundo sob a voz: -18 dB a -24 dB
- Música durante a abertura ou o encerramento, sem voz: -6 dB a -10 dB
Use automação de volume ou um compressor sidechain no seu editor para abaixar a música automaticamente sempre que a narração estiver ativa. DaVinci Resolve, Premiere Pro e CapCut têm isso embutido.
💡 Exporte as faixas de voz e de música com a mesma taxa de bits. Uma voz em 320 kbps sobre um arquivo de música em 128 kbps cria um desequilíbrio audível. Use 320 kbps para as duas ou WAV para ambas.
Veja como fica a produção completa do áudio de um vídeo do YouTube usando o PicassoIA do início ao fim:
- Escreva o roteiro em qualquer editor de texto.
- Gere a narração usando o Minimax Speech 2.8 HD ou o ElevenLabs V3. Baixe em MP3 ou WAV.
- Gere a música de abertura com o Stable Audio 2.5 usando um prompt curto e enérgico (de 15 a 30 segundos).
- Gere a música de fundo com um prompt calmo e consistente que combine com o tema (de 90 a 180 segundos).
- Gere a música de encerramento que resolva o clima (30 segundos, terminando com um fade).
- Importe tudo para o seu editor. Sobreponha as faixas, equilibre os volumes e adicione o ducking.
- Exporte e publique.
Tempo total da fase de produção de áudio: de 15 a 20 minutos. Custo total: bem menor do que uma assinatura mensal de qualquer grande biblioteca livre de royalties, sem pagamentos recorrentes.
Comece a criar suas próprias trilhas
Se você tem contornado o sistema de direitos autorais do YouTube com faixas de bibliotecas gratuitas ou assinaturas caras, o Stable Audio 2.5 elimina essa limitação por completo. Cada faixa que você gera é original, não existe em nenhum banco de dados do Content ID e é sua para usar para sempre em qualquer vídeo que publicar.
A plataforma já está no ar. Acesse a página do modelo Stable Audio 2.5 no PicassoIA, escreva um prompt descrevendo o som de que seu próximo vídeo precisa e veja o resultado em menos de um minuto.
Para canais que precisam de canções completas com vocais, o Minimax Music 2.6 e o Google Lyria 3 Pro estão disponíveis na mesma plataforma, sem configuração adicional. Para narrações que combinem com a música, o Minimax Speech 2.8 HD e o ElevenLabs V3 estão prontos sempre que você precisar.
Sua trilha está esperando. Você só precisa descrevê-la.


