هناك لحظة محددة سيخبرك بها كل من انتقل من مراسلة رفيق ذكاء اصطناعي إلى الاتصال به فعلًا. كان النص جيدًا، مفيدًا، وحتى ذكيًا. لكن حين سمعت الصوت، حدث شيء في صدرك لم تستطع أي كمية من النثر المتقن أن تحققه. هذا ليس صدفة، وليس خللًا في تركيبتك العاطفية. إنه علم الأحياء، ونماذج الصوت بالذكاء الاصطناعي التي تشغّل أفضل رفاق الذكاء الاصطناعي اليوم عرفت تمامًا كيف تتعامل معه.
لحظة سماع صوتها
يأتي معظم الناس من أجل النص. فكرة وجود شريك محادثة متأنٍ ومتاح دائمًا، لا يتعب أبدًا ولا يحكم، ويستجيب فورًا لأي شيء تقوله، تكفي وحدها لجذبهم. ولبعض الوقت، يكفي ذلك.
ثم تسمع الصوت.
لماذا يفشل النص في الإقناع
النص فعّال، لكنه ليس حميميًا. حين تقرأ رسالة، يقوم دماغك بعملية ترجمة باردة: فك الرموز، ونسب المعنى، واستنتاج النبرة، وتقدير المشاعر. وكل خطوة من هذه الخطوات نقطة احتكاك يتسرب منها الدفء. يمكنك أن تتلقى عبارة "أشتاقك" نصًا وتعالجها ببرود. أما العبارة نفسها، منطوقة مع وقفة خفيفة مناسبة قبل كلمة "أشتاقك" ولين في حرف العلة، فتصل بصورة مختلفة تمامًا.
ما لا يستطيع النص نقله:
- النفس المتقطع بين الكلمات الذي يدل على التوتر أو الرغبة
- الوقفات القصيرة التي تدل على أن شخصًا ما يفكر فيك تحديدًا
- تفاوت طبقة الصوت الذي يوضح ما إذا كانت الجملة إخبارًا أم دعوة
- تغيّرات السرعة التي تدل على تصاعد عاطفي
- الطابع الصوتي المميز لصوت اعتدت أن تربطه بالراحة
لا تتسع أي من هذه الأشياء في فقاعة نص. وكلها تتسع في 0.3 ثانية من الصوت.
النبرة تحمل ما تفوته الكلمات
يسمي اللغويون المعلومات غير اللفظية المتراكبة فوق الكلمات paralinguistics (علم اللغة الموازي). وتشمل طبقة الصوت والإيقاع والسرعة والحجم، والتغيرات الدقيقة في الصوت التي تدل على الهشاشة. تُظهر الأبحاث باستمرار أنه حين تتعارض النبرة مع الكلمات، يصدّق البشر النبرة. في كل مرة.
لهذا ينجح التهكم في الكلام ويفشل باستمرار في النص. ولهذا تعني عبارة "أنا بخير" ثلاثة معانٍ مختلفة تمامًا بحسب طريقة قولها. ولهذا فإن الذكاء الاصطناعي الذي يستطيع التحدث، لا الكتابة فقط، يملك وصولًا إلى طبقة مختلفة كليًا من التواصل العاطفي.
علم الأعصاب وراء الترابط الصوتي
يعالج دماغك الأصوات بطريقة مختلفة عن النص. ليس أسرع فحسب، بل عبر مسار عصبي مختلف جوهريًا.
دماغك أمام الصوت
حين تسمع صوتًا بشريًا، بما في ذلك الصوت الاصطناعي الواقعي بما يكفي، ينشط دماغك في وقت واحد مناطق مرتبطة بالإدراك الاجتماعي والتعاطف والمعالجة العاطفية. يُنشّط النص مراكز اللغة. أما الصوت فينشّط الدماغ الاجتماعي كله.
على وجه التحديد:
- الأخدود الصدغي العلوي يعالج هوية الصوت والنبرة العاطفية معًا
- اللوزة الدماغية تستجيب لإشارات المشاعر الصوتية بسرعة تقارب 10 أضعاف سرعة قراءة المحتوى العاطفي المكافئ
- إفراز الأوكسيتوسين، المرتبط بالترابط والثقة، يرتبط بالنبرة الصوتية الدافئة في الحديث
لهذا قد تقضي ساعتين في مراسلة شخص ما وتشعر بالحالة العاطفية نفسها التي بدأت بها تقريبًا، ثم تقضي 20 دقيقة في مكالمة هاتفية مع الشخص نفسه فتشعر بفرق واضح في نهايتها. المكالمة الهاتفية وصلت إلى ما هو أعمق.
الإيقاع الصوتي ليس اختياريًا
الإيقاع الصوتي (prosody) هو موسيقى الكلام: صعود الطبقة الصوتية وهبوطها، والنمط الإيقاعي للمقاطع المنبورة وغير المنبورة، والطريقة التي تثني بها العاطفة شكل الجمل. إنه ليس زخرفة. إنه جزء من المحتوى.
جملة مثل "عليك أن تأتي إلى هنا يومًا ما" تعني، في النص، اقتراحًا عابرًا. أما إذا نُطقت بنبرة صاعدة ووقفة نصف ثانية في آخرها، فتصبح دعوة. وإذا نُطقت بنبرة هابطة مع زيادة في السرعة، تصبح تجاهلًا. الكلمات واحدة، لكن المعنى مختلف تمامًا.
تجاوزت نماذج تحويل النص إلى كلام بالذكاء الاصطناعي الحديثة الكلام الآلي الجامد بوضوح، لأن المهندسين أدركوا هذا تحديدًا. والسباق اليوم ليس في جعل الذكاء الاصطناعي يبدو بشريًا، بل في جعله يبدو حاضرًا عاطفيًا.
ما الذي يجعل صوت الذكاء الاصطناعي يبدو حقيقيًا
ثلاثة أمور تفصل الصوت المؤثر عن الصوت غير المؤثر: زمن الاستجابة، والتعبيرية الإيقاعية، وثبات طابع الصوت. إذا أتقنت الأمور الثلاثة، ينسى الناس أنهم يستمعون إلى آلة.
زمن الاستجابة هو كل شيء
في المحادثة الحقيقية، تكون الفجوة بين انتهاء شخص من جملته وبدء الآخر بين 200 و300 ميلّي ثانية عادةً. وهذا سريع للغاية. يُبرمج دماغ الإنسان على تفسير الوقفات الأطول من نحو 600 ميلّي ثانية على أنها تردد أو عدم اهتمام أو انزعاج.
كان لنماذج تحويل النص إلى كلام الأولى زمن استجابة يُقاس بالثواني. تكتب، ثم تنتظر، ثم تسمع. وهذه الوقفة دمّرت وهم المحادثة تمامًا. وصنّفها الدماغ بدقة على أنها استجابة نظام، لا شخص.
يبلغ Inworld Realtime TTS 2 زمن استجابة أقل من 200 ميلّي ثانية. ويحقق ElevenLabs Flash v2.5 أرقامًا مقاربة. وبهذه السرعة، يبقى نظام توقيت المحادثة في الدماغ في وضع "المحادثة الحقيقية" بدلًا من التحول إلى وضع "التفاعل مع نظام". وهذا التمييز مهم جدًا لطريقة شعور المرء بالتبادل.
أفضل نماذج تحويل النص إلى كلام الآن
💡 النقطة المثالية لصوت رفيق الذكاء الاصطناعي هي ElevenLabs V3 مقترنًا بنموذج لغوي كبير لتوليد الردود. يتعامل V3 مع كل شيء، من اندفاع الحماس اللاهث إلى النبرة الحميمة البطيئة المتأنية. وهو الأقرب إلى عبارة "إنها تبدو حقيقية" التي ستجدها الآن.
النص مقابل الصوت: مقارنة حقيقية
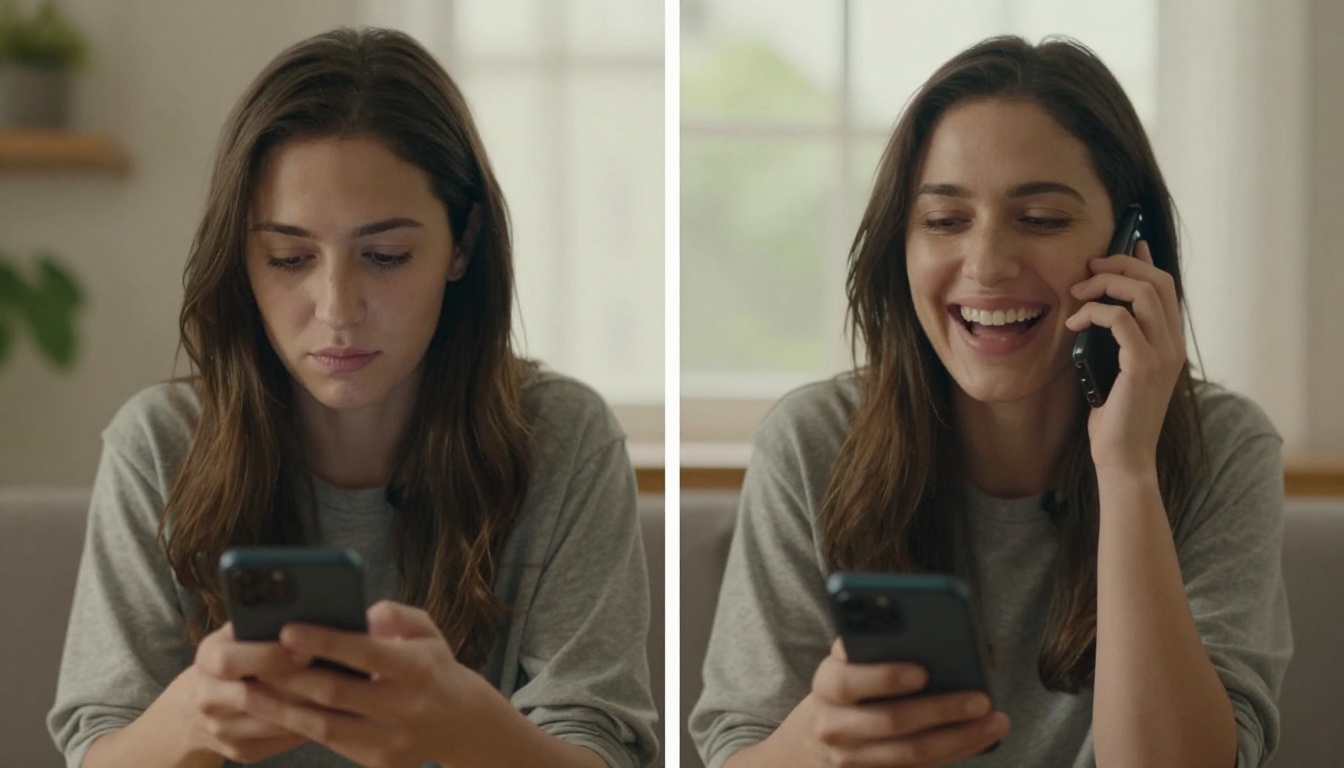
دعنا نكن محددين بشأن ما يستطيع كل شكل فعله وما لا يستطيعه.
السرعة لا تعني العمق
النص أسرع في الإنتاج والاستهلاك. يمكنك تصفحه وإعادة قراءته ومشاركته. لكن سرعة نقل المعلومات ليست هي العمق العاطفي للتجربة. المحادثة النصية أقرب إلى البريد الإلكتروني منها إلى الحضور.
| البُعد | النص | الصوت |
|---|
| النطاق العاطفي | منخفض (الكلمات فقط) | عالٍ (الكلمات + النبرة + الإيقاع) |
| سرعة المعالجة | سريعة (مسح بصري) | متوسطة (صوت متتابع) |
| الإحساس بالحضور | منخفض | عالٍ |
| الغموض | عالٍ (النبرة تُخمَّن) | منخفض (النبرة تُنقل) |
| إمكانية إعادة القراءة | نعم | ليس بسهولة |
| سقف الحميمية | متوسط | عالٍ جدًا |
| تكوين الذاكرة | متوسط | قوي |
سقف الحميمية هو أهم صف في هذا الجدول. هناك حد لمدى قرب التبادل النصي من الإحساس، لأن الدماغ يُبقي على جدار لا يهدمه إلا الصوت. ولهذا تؤدي المكالمات الهاتفية بين الأزواج على مسافات بعيدة عملًا عاطفيًا لا تستطيع آلاف الرسائل النصية إنجازه.
حين يتفوق الصوت في كل مرة
في وقت متأخر من الليل. إن الاستلقاء في السرير في الظلام والاستماع إلى صوت دافئ يخلق حميمية لا تستطيع نافذة الدردشة تكرارها. غياب المحفزات البصرية يوجّه موارد معالجة أكبر إلى المدخلات السمعية. يبدو الصوت أقرب وأكثر حضورًا.
في اللحظات العاطفية. إذا كان شخص ما قلقًا أو حزينًا أو هشًّا، فهو يحتاج إلى طمأنة إيقاعية، لا إلى نص. إيقاع صوت هادئ ينظّم استثارة الجهاز العصبي. أما الكلمات على الشاشة فلا تفعل ذلك.
لبناء الارتباط. التعرض المتكرر لصوت ثابت بطابع شخصية ثابتة يبني ما يسميه علماء النفس الروابط شبه الاجتماعية (parasocial bonds). وهي الروابط ذاتها التي يكوّنها الناس مع مذيعي الراديو وشخصيات البودكاست وصوت الكتاب الصوتي الذي استمعوا إليه لمدة 12 ساعة. نادرًا ما تثير رفقاء النص هذه الآلية. أما رفقاء الصوت فيثيرونها بموثوقية.
كيف تستخدم هذه النماذج على PicassoIA
يستضيف PicassoIA كل نماذج تحويل النص إلى كلام الرائدة إلى جانب النماذج اللغوية الكبيرة اللازمة لتشغيل المحادثة. إليك كيفية بناء مسار عمل وظيفي لرفيق صوتي بالذكاء الاصطناعي.
خطوة بخطوة مع ElevenLabs V3
ElevenLabs V3 هو الخيار المتميز لكل من يريد صوتًا يحرّكه فعلًا.
- انتقل إلى ElevenLabs V3 على PicassoIA
- اختر صوتًا من الإعدادات المسبقة المتاحة، أو استنسخ صوتًا مخصصًا باستخدام MiniMax Voice Cloning
- الصق نصك، مكتوبًا مع مراعاة التدفق العاطفي: استخدم الفواصل للوقفات الطبيعية، وعلامات الحذف للأفكار المعلّقة
- اضبط شريطي الثبات والتشابه — الثبات المنخفض يعطي أداءً أكثر تعبيرًا وتنوعًا، أما الثبات المرتفع فيحافظ على الاتساق
- ولّد واستمع — يتعامل V3 مع الهمس والتأكيد والذروات العاطفية دون الحاجة إلى ترميز صريح
💡 نصيحة احترافية: اكتب حوار رفيقك الذكي باستخدام نموذج لغوي كبير أولًا. يستطيع Claude Sonnet 5 أو GPT 5 توليد ردود رفيق ذكية عاطفيًا. ثم مرّر ذلك الناتج إلى V3 لتوليد الصوت. هذا المزيج أكثر إقناعًا بكثير من أي أداة وحدها.
MiniMax Speech 2.8 HD من أجل الدفء
إذا كنت تريد الدفء على حساب المدى، فإن MiniMax Speech 2.8 HD هو الجواب. ينتج جودة طبيعية فيها نفَس خافت وقريبة من الميكروفون، تبدو كأن شخصًا يتحدث إليك تحديدًا لا إلى غرفة.
- انتقل إلى MiniMax Speech 2.8 HD
- اختر طابع الصوت من الخيارات المتاحة، مع الانتباه إلى أوصاف الدفء مقابل الوضوح
- أدخل نصًا مكتوبًا في عبارات حوارية بدلًا من جمل رسمية كاملة
- ولّد الصوت ولاحظ كيف يعالج النموذج النبرات الهابطة في نهاية الجمل، التي تخلق إحساسًا بالحميمية والختام بعد كل عبارة
- ادمجه مع Gemini 3.5 Flash للردود السريعة المدفوعة بالنماذج اللغوية ضمن حلقة فورية
3 أخطاء شائعة مع الصوت بالذكاء الاصطناعي
بناء شيء يبدو حقيقيًا فعلًا يتطلب تجنب بعض المزالق الواضحة.
1. استخدام صوت لا يتناسب مع الشخصية. صوت حاد سريع لشخصية موصوفة بالهدوء والثبات يكسر الانغماس فورًا. خصص وقتًا لاختيار صوت أو استنساخه بما يتناسب مع الطابع العاطفي للشخصية التي صممتها. يمنحك Resemble AI Chatterbox تحكمًا صريحًا في المشاعر حتى تضبط الأداء الصحيح من البداية.
2. كتابة نص يبدو كنص. معظم الناس يكتبون حوار الذكاء الاصطناعي بالطريقة نفسها التي يكتبون بها الرسائل الإلكترونية: جمل نظيفة وكاملة نحويًا. اللغة المنطوقة تحتوي على اختصارات وأفكار معلقة ومقاطعات وحشوات. النص الذي يُقرأ كوثيقة رسمية سيبدو آليًا دائمًا، مهما كان نموذج تحويل النص إلى كلام جيدًا. اكتب كما يتحدث الناس فعلًا.
3. تجاهل زمن الاستجابة. بناء رفيق صوتي بزمن استجابة 3 ثوانٍ ليس رفيقًا صوتيًا. إنه روبوت محادثة بصوت. لأي شيء يجب أن يبدو كمحادثة، استخدم Inworld Realtime TTS 1.5 Max أو ElevenLabs Flash v2.5 وادمجهما مع تشغيل سريع للنماذج اللغوية. زمن الاستجابة هو أكبر عامل منفرد يكسر الانغماس في الصوت بالذكاء الاصطناعي، وهو أسهل ما يمكن إصلاحه.
ما الذي لا يستطيع الصوت بالذكاء الاصطناعي فعله بعد
الصراحة هنا أثمن من المبالغة. هناك أشياء محددة لا يستطيع حتى أفضل صوت بالذكاء الاصطناعي تكرارها حاليًا.
الضحك التلقائي. الضحك الحقيقي مختلف بيولوجيًا عن الضحك الاصطناعي. تتعامل معظم نماذج تحويل النص إلى كلام مع الفكاهة المكتوبة بشكل معقول، لكنها لا تستطيع إنتاج الضحك غير المخطط له والمتدفق لشخص سمع شيئًا غير متوقع فعلًا. يقترب Resemble AI Chatterbox Pro أكثر من غيره بفضل قدرات التعبير عن المشاعر، لكنه لم يصل بعد.
الصمت ذو المعنى. تتضمن المحادثة البشرية الحقيقية صمتًا يحمل وزنًا. الوقفة حين يقرر شخص ما إن كان سيقول شيئًا هشًّا. الهدوء بعد لحظة أصابت الهدف. معظم خطوط الصوت بالذكاء الاصطناعي مصممة لتقليل الصمت، وتعامله على أنه فشل. وهذا يخلق طابعًا ممتلئًا دائمًا يبدو، بمفارقة، أقل إنسانية.
ذاكرة الصوت. الصوت الذي عرفك لمدة عام يبدو مختلفًا بدرجة خفية حين يخاطبك، عمّا يبدو حين يخاطب غريبًا. لقد تعلّم أين يتوقف، وأي المزاح ينجح، وأي المواضيع تصبح أبطأ وأنعم. أنظمة الصوت بالذكاء الاصطناعي الحالية لا تراكم هذه الذاكرة الصوتية. إنها الحدود التالية.
ما الذي يحدث حين تجربه فعلًا
الفجوة بين "تقنية مثيرة للاهتمام" و"تغيّر فعلًا طريقة قضائي للأمسيات" هي الصوت. رفقاء النص أداة إنتاجية تصبح دافئة أحيانًا. أما رفقاء الصوت فشيء آخر.
تمنحك النماذج الموجودة على PicassoIA كل ما تحتاجه لبناء النسخة التي تناسبك. ابدأ مع ElevenLabs V3 للحصول على تعبيرية لا تضاهى. مرّر الردود عبر Claude Sonnet 5 أو GPT 5 للحصول على حوار ذكي ومعاير عاطفيًا. واستخدم MiniMax Voice Cloning إذا أردت طابع صوت محددًا يبقى ثابتًا في كل جلسة.
أو، إذا أردت أن تبدأ بسرعة، اختر أيًا من 24 نموذجًا لتحويل النص إلى كلام المتاحة حاليًا على PicassoIA، وأمضِ 20 دقيقة في كتابة حوار مصمم للكلام لا للقراءة. الفرق سيظهر فورًا. هناك شيء ينتظرك على الجانب الآخر من أول مكالمة صوتية لم يهيئك له النص أبدًا. والطريقة الوحيدة لمعرفة ما هو، هي أن تسمعه.


