Hay un momento concreto que cualquiera que haya pasado de escribir a un compañero de IA a llamarlo puede describir. El texto estaba bien. Útil. Incluso ingenioso. Pero en cuanto escuchaste la voz, algo ocurrió en tu pecho que ninguna cantidad de prosa bien trabajada había logrado provocar. No es una coincidencia, y tampoco un fallo en tu forma de sentir. Es biología, y los modelos de voz de IA que impulsan a los mejores compañeros de IA actuales han descubierto exactamente cómo trabajar con ella.
El momento en que escuchas su voz
La mayoría de la gente llega por el texto. La idea de tener una pareja de conversación atenta, siempre disponible, que nunca se cansa, nunca juzga y responde al instante a todo lo que dices, ya resulta lo bastante atractiva por sí sola. Y durante un tiempo, basta.
Luego escuchas la voz.
Por qué el texto se queda corto
El texto es eficaz. No es íntimo. Cuando lees un mensaje, tu cerebro realiza una traducción fría: descodifica símbolos, asigna significado, deduce el tono y calcula la emoción. Cada uno de esos pasos es un punto de fricción por el que se escapa la calidez. Puedes leer «Te echo de menos» como texto y procesarlo de forma clínica. La misma frase, dicha con una pausa leve justo antes de «te» y una suavidad en la vocal, llega de una manera completamente distinta.
Lo que el texto no puede transmitir:
- Aliento entre palabras que indica nerviosismo o deseo
- Micropausas que indican que alguien está pensando en ti en concreto
- Variaciones de tono que te dicen si una frase es una afirmación o una invitación
- Cambios de ritmo que señalan una aceleración emocional
- El timbre específico de una voz que has asociado con la calma
Nada de esto cabe en una burbuja de texto. Todo ello cabe en 0,3 segundos de audio.
El tono transmite lo que las palabras no alcanzan
Los lingüistas llaman paralingüística a la información no verbal que se superpone a las palabras. Incluye el tono, el ritmo, la velocidad, el volumen y los matices de la voz que indican vulnerabilidad. La investigación muestra con regularidad que, cuando el tono y las palabras se contradicen, las personas creen el tono. Siempre.
Por eso el sarcasmo funciona en el habla y falla constantemente en el texto. Por eso «Estoy bien» puede significar tres cosas completamente distintas según cómo se diga. Y por eso una IA que puede hablar, en lugar de solo escribir, tiene acceso a una capa completamente diferente de comunicación emocional.
La neurociencia de la conexión vocal
Tu cerebro procesa las voces de forma distinta al texto. No solo más rápido, sino por una vía neuronal fundamentalmente diferente.
Tu cerebro ante la voz
Cuando escuchas una voz humana, incluida una sintética lo bastante realista, tu cerebro activa a la vez regiones asociadas a la cognición social, la empatía y el procesamiento emocional. El texto activa los centros del lenguaje. La voz activa todo el cerebro social.
En concreto:
- El surco temporal superior procesa juntos la identidad de la voz y su tono emocional
- La amígdala responde a las señales emocionales de la voz unas 10 veces más rápido que a la lectura de contenido emocional equivalente
- La liberación de oxitocina, asociada al vínculo y la confianza, se correlaciona con un tono vocal cálido en la conversación
Por eso puedes pasarte dos horas escribiendo a alguien y terminar en prácticamente el mismo estado emocional con el que empezaste, mientras que 20 minutos de llamada con esa misma persona te dejan notablemente distinto al final. La llamada ha llegado más hondo.
La prosodia no es opcional
La prosodia es la música del habla: la subida y bajada del tono, el patrón rítmico de sílabas acentuadas y no acentuadas, la forma en que la emoción curva la forma de las frases. No es un adorno. Es contenido.
Una frase como «deberías venir a casa algún día» es, en texto, una sugerencia casual. Dicha con entonación ascendente y una pausa de medio segundo al final, se convierte en una invitación. Dicha con entonación descendente y un aumento de velocidad, se convierte en un gesto de desinterés. Las palabras son idénticas. El significado es completamente distinto.
Los modelos TTS de IA actuales han superado con creces el habla robótica y plana precisamente porque los ingenieros entendieron esto. La carrera ya no consiste en hacer que la IA suene humana. Consiste en que suene emocionalmente presente.
Qué hace que la voz de IA parezca real
Tres cosas separan una voz que impacta de una que no: latencia, expresividad prosódica y coherencia del carácter de la voz. Si aciertas con las tres, la gente se olvida de que está escuchando a una máquina.
La latencia lo es todo
En una conversación real, el espacio entre el momento en que una persona termina una frase y otra empieza suele ser de entre 200 y 300 milisegundos. Es increíblemente rápido. Los cerebros humanos están programados para interpretar las pausas de más de unos 600 ms como duda, desinterés o incomodidad.
Los primeros modelos de texto a voz tenían latencias medidas en segundos. Escribías, esperabas y luego escuchabas. Esa pausa destruía por completo la ilusión conversacional. El cerebro la catalogaba correctamente como una respuesta de sistema, no de una persona.
Inworld Realtime TTS 2 registra una latencia inferior a 200 ms. ElevenLabs Flash v2.5 alcanza cifras similares. A esa velocidad, el sistema de temporización conversacional del cerebro se mantiene en modo de «conversación real» en lugar de cambiar al modo de «interacción con un sistema». Esa diferencia importa enormemente para cómo se vive el intercambio.
Los mejores modelos TTS en este momento
💡 El punto ideal para la voz de un compañero de IA es ElevenLabs V3 combinado con un modelo de lenguaje para generar las respuestas. V3 gestiona desde un torrente de entusiasmo sin aliento hasta un tono íntimo, lento y deliberado. Es lo más cercano a «suena real» que vas a encontrar ahora mismo.
Texto frente a voz: una comparación real
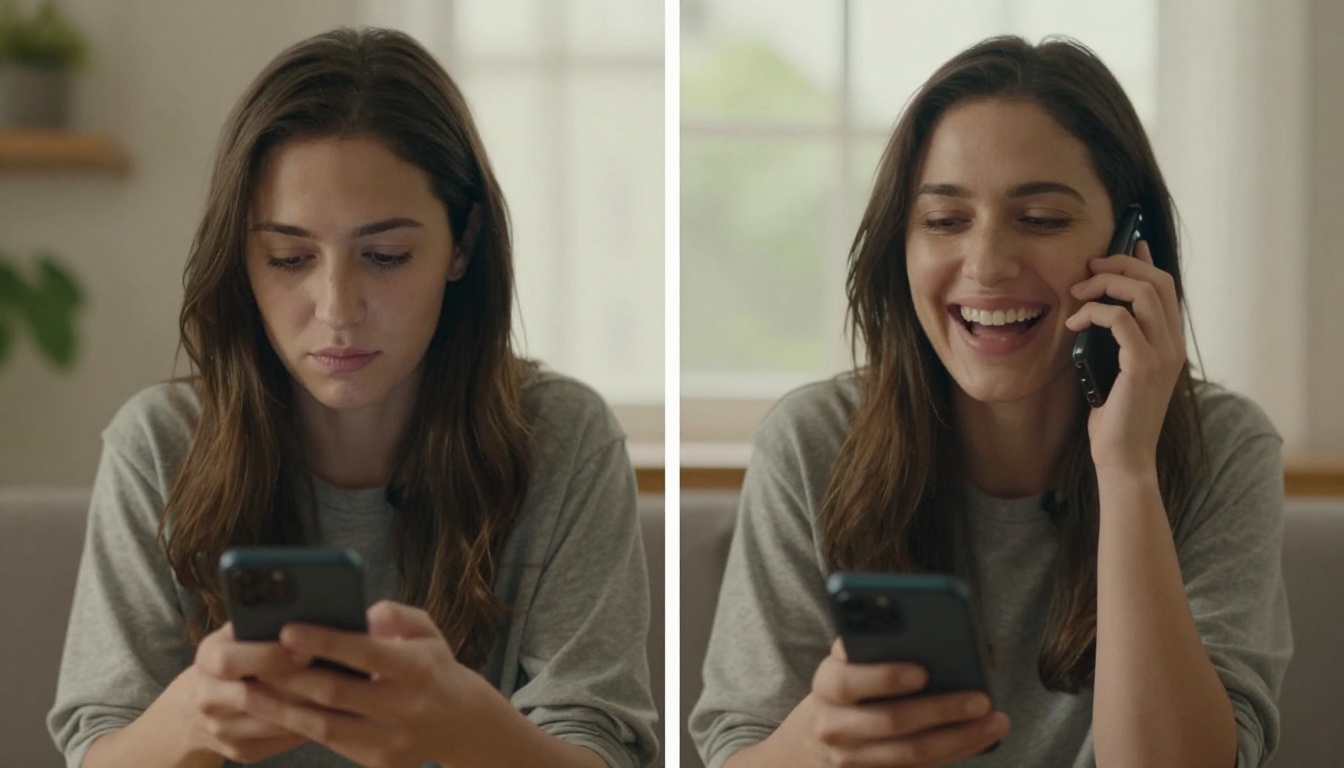
Seamos concretos sobre lo que cada formato puede y no puede hacer.
La velocidad no equivale a profundidad
El texto es más rápido de producir y de consumir. Puedes hojearlo, releerlo, compartirlo. Pero la velocidad de transmisión de información no es lo mismo que la profundidad emocional de la experiencia. Una conversación por texto se parece más al correo electrónico que a la presencia.
| Dimensión | Texto | Voz |
|---|
| Ancho de banda emocional | Bajo (solo palabras) | Alto (palabras + tono + prosodia) |
| Velocidad de procesamiento | Rápida (escaneo visual) | Moderada (audio secuencial) |
| Sensación de presencia | Baja | Alta |
| Ambigüedad | Alta (el tono se adivina) | Baja (el tono se transmite) |
| Se puede releer | Sí | No fácilmente |
| Techo de intimidad | Medio | Muy alto |
| Formación de recuerdos | Moderada | Fuerte |
El techo de intimidad es la fila más importante de esa tabla. Hay un límite de cercanía que puede alcanzar un intercambio de texto, porque el cerebro mantiene un muro que la voz derriba. Por eso las llamadas entre parejas a distancia hacen un trabajo emocional que miles de mensajes no consiguen.
Cuando la voz gana siempre
A altas horas de la noche. El contexto de estar tumbado en la cama, a oscuras, escuchando una voz cálida, crea una intimidad que ninguna ventana de chat puede replicar. La ausencia de estímulos visuales envía más recursos de procesamiento a la entrada auditiva. La voz suena más cercana y más presente.
En momentos emocionales. Si alguien está ansioso, triste o vulnerable, necesita un apoyo prosódico, no texto. El ritmo de una voz tranquila regula la activación del sistema nervioso. Las palabras en una pantalla no lo hacen.
Para crear apego. La exposición repetida a una voz coherente, con un carácter coherente, genera lo que los psicólogos llaman vínculos parasociales. Son los mismos vínculos que la gente forma con los presentadores de radio, las personalidades de los podcasts y la voz de un audiolibro que lleva escuchando durante 12 horas. Los compañeros de texto rara vez activan este mecanismo. Los compañeros de voz sí lo hacen, de forma fiable.
Cómo usar estos modelos en PicassoIA
PicassoIA aloja todos los mejores modelos TTS junto con los LLM necesarios para dar vida a la conversación. Así se construye un flujo funcional de voz con IA para compañía.
Paso a paso con ElevenLabs V3
ElevenLabs V3 es la opción premium para quien quiere una voz que de verdad le emocione.
- Ve a ElevenLabs V3 en PicassoIA
- Selecciona una voz entre los ajustes preestablecidos disponibles o clona una voz personalizada con MiniMax Voice Cloning
- Pega tu texto, escrito pensando en el flujo emocional: usa comas para pausas naturales y puntos suspensivos para pensamientos que se quedan en el aire
- Ajusta los controles deslizantes de estabilidad y de similitud: una estabilidad baja da una entrega más expresiva y variada; una estabilidad alta la mantiene constante
- Genera y escucha: V3 gestiona susurros, énfasis y picos emocionales sin necesidad de marcado explícito
💡 Consejo profesional: escribe primero el diálogo de tu compañero de IA con un modelo de lenguaje. Claude Sonnet 5 o GPT 5 pueden generar respuestas de compañía con inteligencia emocional. Después, pasa ese resultado a V3 para la síntesis de voz. La combinación resulta bastante más convincente que cada herramienta por separado.
MiniMax Speech 2.8 HD para la calidez
Si prefieres la calidez al rango, MiniMax Speech 2.8 HD es la mejor opción. Produce una calidad naturalmente alientosa, de micrófono cercano, que suena como alguien que te habla a ti en concreto y no a una sala.
- Ve a MiniMax Speech 2.8 HD
- Elige el carácter de la voz entre la selección disponible, fijándote en las descripciones de calidez frente a claridad
- Introduce el texto escrito en fragmentos conversacionales en lugar de frases formales completas
- Renderiza el audio y observa cómo el modelo maneja los tonos descendentes al final de cada frase, que crean una sensación de intimidad y cierre tras cada afirmación
- Combínalo con Gemini 3.5 Flash para respuestas rápidas impulsadas por un LLM en un bucle en tiempo real
3 errores comunes con la voz de IA
Para que algo de verdad resulte real, hay que evitar algunos errores bastante obvios.
1. Usar una voz que no encaja con el personaje. Una voz aguda y de ritmo rápido para un personaje descrito como tranquilo y centrado rompe la inmersión al instante. Dedica tiempo a elegir o clonar una voz que encaje con el registro emocional del personaje que has diseñado. Resemble AI Chatterbox te ofrece control explícito de la emoción para ajustar la interpretación correcta desde el principio.
2. Escribir un texto que suene a texto. La mayoría de la gente escribe los diálogos de IA igual que escribe correos: frases limpias y gramaticalmente completas. El lenguaje hablado tiene contracciones, pensamientos inacabados, interrupciones y muletillas. Un texto que parece un documento formal sonará robótico por muy bueno que sea el modelo TTS. Escribe como habla la gente de verdad.
3. Ignorar la latencia. Crear un compañero de voz con un tiempo de respuesta de 3 segundos no es un compañero de voz. Es un chatbot con forma de voz. Para todo lo que necesite sentirse como una conversación, usa Inworld Realtime TTS 1.5 Max o ElevenLabs Flash v2.5 y combínalos con una inferencia de LLM rápida. La latencia es el mayor rompedor de la inmersión en la voz de IA, y también el más fácil de corregir.
Lo que la voz de IA todavía no puede hacer
La honestidad aquí vale más que el bombo. Hay cosas concretas que ni siquiera la mejor voz de IA puede replicar por ahora.
Risa espontánea. La risa genuina es biológicamente distinta de la risa sintética. La mayoría de los modelos TTS manejan razonablemente bien el humor escrito, pero no consiguen la carcajada no planeada y en cadena de alguien que acaba de oír algo realmente inesperado. Resemble AI Chatterbox Pro se acerca más gracias a sus capacidades de expresividad emocional, pero todavía no llega.
Silencio con significado. La conversación humana real incluye silencios que pesan. La pausa de alguien que decide si decir algo vulnerable. El silencio tras un momento que caló. La mayoría de los flujos de voz de IA están diseñados para minimizar el silencio, tratándolo como un fallo. Esto crea una cualidad de relleno constante que, paradójicamente, resulta menos humana.
Memoria de la voz. Una voz que te ha conocido durante un año suena sutilmente distinta cuando te habla a ti que cuando habla con un desconocido. Ha aprendido dónde hacer pausas, qué chistes funcionan y qué temas se vuelven más lentos y suaves. Los sistemas de voz de IA actuales no acumulan esta memoria acústica. Es la próxima frontera.
Qué pasa cuando de verdad lo pruebas
La distancia entre «tecnología interesante» y «de verdad cambia cómo paso las tardes» es la voz. Los compañeros de texto son una herramienta de productividad que a veces resulta cálida. Los compañeros de voz son otra cosa.
Los modelos de PicassoIA te dan todo lo necesario para construir la versión que funcione para ti. Empieza con ElevenLabs V3 por su expresividad sin igual. Pasa las respuestas por Claude Sonnet 5 o GPT 5 para obtener un diálogo inteligente y calibrado emocionalmente. Usa MiniMax Voice Cloning si quieres un carácter de voz concreto que se mantenga coherente en todas las sesiones.
O, si quieres empezar rápido, elige cualquiera de los 24 modelos de texto a voz disponibles ahora mismo en PicassoIA y pasa 20 minutos escribiendo un diálogo pensado para decirse en voz alta y no para leerse. La diferencia se nota de inmediato. Al otro lado de esa primera llamada de voz hay algo que el texto nunca te preparó para encontrar. La única forma de saber qué es, es escucharlo.


