ما تراه وتسمعه وتقرؤه يصل إلى دماغك في اللحظة نفسها. نماذج الذكاء الاصطناعي متعددة الوسائط تعمل بالطريقة ذاتها. فبدلًا من معالجة نوع واحد من المدخلات في كل مرة، تستوعب النص والصور والصوت وأحيانًا الفيديو في آنٍ واحد، وتستدل على كل ذلك معًا. هذا التحول وحده يغيّر ما يستطيع الذكاء الاصطناعي فعله في العالم الحقيقي.
نموذج واحد وحواس متعددة
تعرّف معظم الناس على الذكاء الاصطناعي أولًا بوصفه أداة نصية: تطرح سؤالًا فتحصل على إجابة نصية. وهذا يعمل جيدًا في مهام الكتابة. لكن العالم المادي ليس مصنوعًا من النصوص، بل من الصور والأصوات والمستندات والرسوم البيانية والوجوه والمشاهد. النموذج الذي يقرأ الكلمات فقط يبقى أعمى جزئيًا دائمًا.
الذكاء الاصطناعي متعدد الوسائط يحل هذه المشكلة. فهو يجمع الإدراك عبر أنواع المدخلات، بحيث يتعامل نموذج واحد مع المجموعة الكاملة من الإشارات التي يستخدمها البشر بشكل طبيعي.
النص ليس إلا البداية
نماذج النص فقط (مثل GPT-2 المبكر أو BERT) تقرأ الجمل وتولّد الردود. وهي قوية في مطابقة الأنماط داخل اللغة. لكن قيدها صارم: إذا عرضت عليها صورة فوتوغرافية فلن تستطيع رؤيتها.
النماذج متعددة الوسائط تقبل مدخلات بصيغ مختلفة. يمكنها أن تقرأ سؤالك، وتنظر إلى الصورة التي أرفقتها، وتستمع إلى المقطع الصوتي الذي سجّلته، ثم ترد بإجابة متماسكة ومدركة للسياق تأخذ الثلاثة جميعًا في الحسبان.
التحول لا يقتصر على إضافة ميزات. إنه يغيّر طبيعة ما يدركه النموذج فعلًا.
ما الذي يعنيه "الوسيط" فعلًا
في أبحاث الذكاء الاصطناعي، "الوسيط" هو نوع من البيانات له بنيته الإحصائية الخاصة. ولكل وسيط تمثيل مميز:
| الوسيط | الصيغة | كيف يقرؤه الذكاء الاصطناعي |
|---|
| النص | توكنات / كلمات | تقسيم إلى توكنات + تضمين |
| الصور | شبكات من البكسلات | ترميز بصري قائم على المقاطع (patches) |
| الصوت | أشكال الموجات / المخططات الطيفية | استخلاص خصائص الترددات |
| الفيديو | تسلسلات إطارات | ترميز زمني ومكاني |
| المستندات | نص + تخطيط + صور | دمج التعرف الضوئي على الحروف (OCR) مع الاستدلال البصري |
عندما يكون النموذج "متعدد الوسائط"، فهذا يعني أنه تعلّم معالجة وسيطين أو أكثر من هذه الوسائط، والأهم أنه تعلّم ربط المعنى عبرها.
كيف يعالج مدخلات متعددة
الهندسة وراء الذكاء الاصطناعي متعدد الوسائط أكثر إثارة مما يبدو. فالأمر ليس مجرد "توصيل كاميرا بنموذج نصي". يجب بناء البنية بحيث تستطيع تمثيلات الوسائط المختلفة أن تتواصل فيما بينها.
المحوّل في القلب
تُبنى النماذج متعددة الوسائط الحديثة تقريبًا دائمًا على بنية المحوّل (transformer) التي قُدّمت لأول مرة في ورقة بحثية عام 2017 بعنوان "Attention Is All You Need". والمحوّلات بارعة في الانتباه إلى أجزاء مختلفة من التسلسل. ولا يشترط أن يعني "التسلسل" الكلمات فقط، فقد يعني مقاطع الصور أو إطارات الصوت أو مقاطع الفيديو.
في نموذج للرؤية واللغة مثل GPT-4o، يستقبل المحوّل تسلسلًا مدمجًا يضم توكنات النص ومقاطع الصور المرمّزة معًا. وتتيح آلية الانتباه لتوكنات النص أن "تنظر" إلى توكنات الصورة والعكس. هذا الانتباه المتقاطع هو المكان الذي يحدث فيه الاستدلال متعدد الوسائط فعلًا.
مرمّزات لكل حاسة
قبل أن يرى المحوّل البيانات أصلًا، تمر كل وسيط عبر مرمّز خاص بالوسيط:
- الصور تمر عبر مرمّز بصري (غالبًا مبني على ViT، أي Vision Transformer) يقسّم الصورة إلى مقاطع بحجم 16×16 بكسلًا ويحوّل كل مقطع إلى متجه تضمين.
- الصوت يمر عبر مرمّز للمخطط الطيفي يحوّل موجات الصوت إلى تمثيلات للتردد والزمن.
- النص يستخدم التقسيم القياسي إلى توكنات: الكلمات تُقسَّم إلى توكنات جزئية وتُربط بمتجهات تضمين.
كل هذه التضمينات تنتهي في فضاء البُعد نفسه. ومن تلك النقطة يعامل المحوّل الجميع بالتساوي. النموذج لا يعرف إن كان "ينظر" أم "يقرأ". إنه يركّز فقط على الأنماط داخل تسلسل موحّد.
النص والصور والصوت معًا
عندما يستقبل نموذج متعدد الوسائط مدخلات مختلطة، فإنه لا يعالج كل وسيط بالتتابع ثم يجمع النتائج لاحقًا. بل يعالج كل شيء ضمن السياق، ما يسمح لكل وسيط بأن يؤثر في طريقة تفسير الوسائط الأخرى.
الرؤية واللغة معًا
هذا هو الفرع الأكثر تطورًا في الذكاء الاصطناعي متعدد الوسائط. تُدرَّب نماذج الرؤية واللغة (VLMs) على مجموعات بيانات ضخمة من أزواج الصورة والنص. ويعلّم التدريب النموذج ربط المحتوى البصري بالأوصاف اللغوية.
من النتائج العملية لهذا التدريب:
- وصف الصور: يصف النموذج ما يراه بلغة طبيعية.
- الإجابة عن الأسئلة البصرية (VQA): اطرح سؤالًا عن صورة واحصل على إجابة محددة.
- تفسير المستندات: اقرأ ملف PDF يحتوي على رسوم بيانية وجداول واشرح البيانات.
- الاستدلال القائم على المشهد: "ما المخاطر المتعلقة بالسلامة التي تراها في صورة المصنع هذه؟"
Gemini 3 Pro و Claude Opus 4.7 نموذجان قادران على الرؤية واللغة متاحان على PicassoIA. يقبلان الصورة كجزء من المحادثة ويستدلان على محتواها بعمق.
💡 نصيحة: عند استخدام نموذج للرؤية واللغة، كن محددًا في سؤالك. "ما الموجود في هذه الصورة؟" يحصل على وصف عام. أما "ما المواد المستخدمة في الأثاث الظاهر في هذه الصورة؟" فيحصل على إجابة دقيقة وقابلة للتطبيق.
الصوت كمدخل من الدرجة الأولى
دعم الوسيط الصوتي أقل عمومية من الرؤية، لكنه ينمو بسرعة. النماذج التي تحتوي على تحويل الكلام إلى نص مدمج يمكنها نسخ الأسئلة المنطوقة في الوقت الفعلي. أما البنى الأحدث فتعالج موجة الصوت الخام مباشرة، فتلتقط النبرة والعاطفة وهوية المتحدث إلى جانب الكلمات.
الفرق مهم. فالنظام النصي الذي يحوّل الصوت إلى نص أولًا يفقد كل شيء يتجاوز الكلمات: التردد والتشديد والسياق المحيط. أما نموذج الصوت متعدد الوسائط الحقيقي فيحتفظ بهذا الثراء.
أين يظهر الذكاء الاصطناعي متعدد الوسائط
الانتقال من الذكاء الاصطناعي أحادي الوسيط إلى متعدد الوسائط ليس أمرًا نظريًا. إنه يغيّر بالفعل الأدوات التي يستخدمها الناس يوميًا.
الرعاية الصحية والأشعة
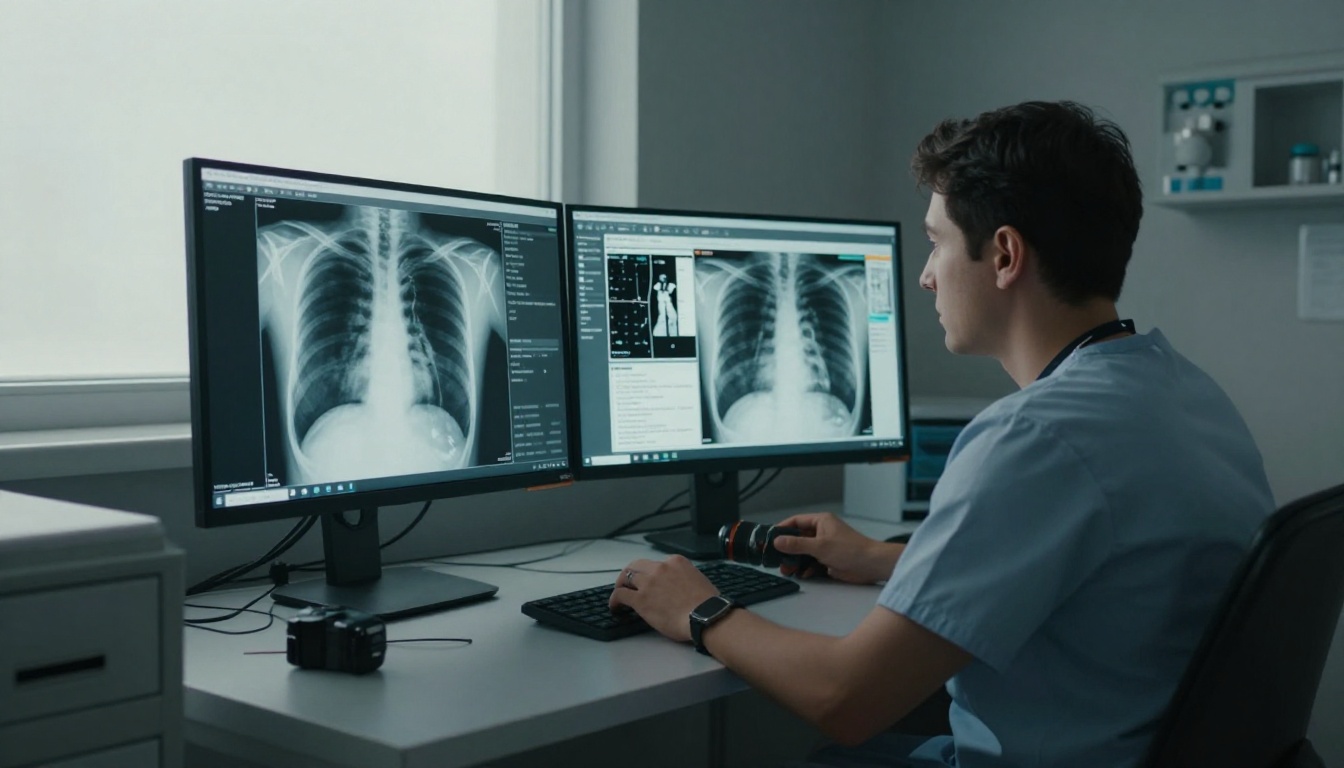
يراجع أخصائيو الأشعة آلاف الصور الطبية كل أسبوع. يستطيع الذكاء الاصطناعي متعدد الوسائط قراءة الملاحظات السريرية المكتوبة للمريض إلى جانب صورة الأشعة السينية أو الرنين المغناطيسي، والإشارة إلى التناقضات أو التشخيصات المحتملة. يستدل النموذج على الصورة والنص معًا في الوقت نفسه، وهذا بالضبط ما يفعله الطبيب الماهر.
Granite Vision 3.3 2B نموذج مدمج للرؤية واللغة يقرأ الرسوم البيانية والجداول، ما يجعله نقطة انطلاق عملية للصناعات التي تعتمد بكثافة على المستندات، مثل التأمين والقانون والبحوث السريرية.
الأدوات الإبداعية والتصميم
توليد الصور من النص هو الشكل الأكثر وضوحًا للذكاء الاصطناعي متعدد الوسائط بالنسبة إلى المحترفين المبدعين. نماذج مثل PicassoIA Image و GPT Image 2 و Seedream 4.5 تأخذ أمرًا نصيًا كمدخل وتنتج صورة واقعية كالصور الفوتوغرافية كمخرج. وهذا متعدد الوسائط بحكم التعريف: اللغة هي التي تقود التوليد البصري.
وأبعد من ذلك، تقبل أدوات مثل Qwen Image Edit Plus صورة وتعليمات نصية معًا، ثم تعدّل الصورة وفقًا لها. هذا مدخل متعدد الوسائط يقود مخرجًا متعدد الوسائط، وهي الحلقة الكاملة.
تطبيقات يومية على هاتفك
وجّه كاميرا هاتفك نحو قائمة طعام في مطعم بلغة أجنبية. يقرأ الذكاء الاصطناعي متعدد الوسائط الصورة، ويتعرف على النص، ويترجمه، ويشرح الأطباق. هذا مسار عابر للوسائط في الوقت الفعلي: مدخل بصري ومخرج لغوي.
تعالج التقنية نفسها أيضًا:
- أدوات إمكانية الوصول التي تصف المشاهد البصرية للمستخدمين ضعاف البصر.
- تطبيقات التسوق التي تتعرف على المنتجات من صورة.
- البحث الذي يقبل صورة مرفوعة كاستعلام بدلًا من الكلمات المفتاحية المكتوبة.
يوصف Kimi K2.5 بأنه "Chat AI That Reads Text and Images"، ما يجعله مساعدًا عمليًا متعدد الوسائط للمهام اليومية. ويقدّم Gemini 3 Flash محادثة ذكاء اصطناعي سريعة مع قدرة الرؤية للتفاعلات بسرعة الهاتف.
أحادي الوسيط مقابل متعدد الوسائط: الفرق الحقيقي
يتضح ما يستطيع الذكاء الاصطناعي متعدد الوسائط فعله بشكل أوضح عندما تقارنه مباشرة ببدائله أحادية الوسيط.
| القدرة | ذكاء اصطناعي للنص فقط | ذكاء اصطناعي متعدد الوسائط |
|---|
| الإجابة عن الأسئلة النصية | نعم | نعم |
| وصف صورة | لا | نعم |
| نسخ الصوت | لا (دون أداة إضافية) | نعم |
| الاستدلال على رسم بياني | لا | نعم |
| تعديل صورة من نص | لا | نعم |
| تفسير محتوى الفيديو | لا | بعض النماذج |
| قراءة مستند ممسوح ضوئيًا | لا | نعم |
| الاستدلال عبر الوسائط | لا | نعم |
العمود الأيمن لا يمثل "ميزات أكثر" فحسب. إنه يمثل علاقة مختلفة نوعيًا بين الذكاء الاصطناعي والعالم.
أبرز النماذج متعددة الوسائط الآن
يتحرك مجال الذكاء الاصطناعي متعدد الوسائط بسرعة. هذه هي البنى التي تحدد حاليًا أحدث ما توصّل إليه المجال.
GPT-4o ونهج OpenAI
GPT-4o ("o" تعني omni) كان أول نموذج متعدد الوسائط بشكل أصيل من OpenAI: دُرّب من البداية إلى النهاية عبر النص والرؤية والصوت، بدلًا من تجميعه من مكونات منفصلة. وهذا التدريب الشامل يعني أن النموذج لا يعاني "عنق زجاجة للترجمة" عند التبديل بين الوسائط. وخليفته، GPT-5، فيوسّع هذه البنية بقدرة استدلال أقوى عبر جميع الوسائط.
في توليد الصور، يجلب GPT Image 2 القدرة اللغوية العميقة نفسها إلى المخرجات البصرية، فينتج صورًا تعكس بدقة الأوصاف النصية المعقدة.
💡 نصيحة: استخدم GPT Image 2 عندما يصف أمرك النصي للصورة علاقات معقدة بين عدة أشخاص أو عناصر. فالأساس اللغوي للنموذج يتعامل مع التعليمات التركيبية أفضل من معظم نماذج الانتشار الخالصة.
بنية Gemini
صُممت عائلة Gemini من Google لتكون متعددة الوسائط منذ البداية. يتعامل Gemini 3 Pro مع النص والصور والصوت والشيفرة ضمن نافذة سياق واحدة. وهذا يعني أنه يمكنك مشاركة صورة فوتوغرافية وجدول بيانات وفقرة نصية في رسالة واحدة، وطلب تفسير مجمّع لها.
يضحّي Gemini 3 Flash ببعض القدرة مقابل السرعة، ما يجعله عمليًا في التطبيقات الفورية التي يهم فيها زمن الاستجابة.
الاستدلال البصري في Claude
يوصف Claude Opus 4.7 بأنه "AI That Codes, Sees, and Reasons". تتميز نماذج Anthropic بقراءة دقيقة ومتأنية للمستندات البصرية مثل العقود والمخططات التقنية والأوراق البحثية، ما يجعلها خيارًا جيدًا عندما تكون الدقة في المواد المعقدة أهم من السرعة الخام.
يقدّم Claude 4 Sonnet قدرات الرؤية نفسها في شكل أسرع وأخف.
كيف تستخدم النماذج متعددة الوسائط على PicassoIA
يمنحك PicassoIA وصولًا مباشرًا إلى مجموعة كاملة من نماذج الذكاء الاصطناعي متعددة الوسائط، سواء للاستدلال على النص مع الرؤية أو لتوليد الصور من النص. إليك كيفية الاستفادة منها:
استخدام نموذج للرؤية واللغة:
- افتح مجموعة النماذج اللغوية الكبيرة (Large Language Models) على PicassoIA.
- اختر نموذجًا يدعم الرؤية: GPT-4o أو Gemini 3 Pro أو Claude Opus 4.7.
- أرفق ملف صورة مع رسالتك النصية في منطقة الأوامر.
- اطرح سؤالًا محددًا عن الصورة أو مستند أو رسم بياني. يستدل النموذج على المدخلين معًا.
استخدام توليد الصور من النص:
- افتح قسم تحويل النص إلى صورة (Text to Image) على PicassoIA.
- اختر نموذجًا: PicassoIA Image للاستخدام العام، أو GPT Image 2 للأوامر التركيبية، أو Seedream 4.5 للمخرجات بدقة 4K.
- اكتب أمرًا نصيًا مفصّلًا يصف مشهدك وإضاءته وعناصره وأسلوبه.
- يحوّل النموذج نصك إلى صورة واقعية كالصور الفوتوغرافية، وهذه عملية متعددة الوسائط بامتياز.
نصائح محددة للمعاملات:
- في مهام الرؤية واللغة، أبقِ الصور دون 5 ميغابايت لتحقيق أسرع معالجة.
- في تحويل النص إلى صورة، أضف أوصافًا محددة للكاميرا والإضاءة ("عدسة 85 ملم، فتحة f/1.8، ضوء الساعة الذهبية") لتحسين الواقعية.
- Wan 2.7 Image Pro هو الخيار الأعلى دقة على المنصة، ومناسب لمخرجات الطباعة.
جرّبه بنفسك الآن
قراءة المقالات عن الذكاء الاصطناعي متعدد الوسائط شيء، لكن المفاهيم تتضح أسرع بعد أن توجّه نموذجًا نحو صورة وتسأله سؤالًا غير بديهي. اطلب من Gemini 3 Pro قراءة ملصق القيم الغذائية في صورة. واطلب من GPT-4o تفسير رسم بياني من ملف PDF. واطلب من PicassoIA Image تحويل جملة واحدة إلى مشهد واقعي مفصّل.
كل واحد من هذه التفاعلات يكشف لك وجهًا مختلفًا لمعنى "متعدد الوسائط" في الممارسة: ليس شعارًا تسويقيًا، بل تغيّرًا جوهريًا في طريقة إدراك الذكاء الاصطناعي للعالم والاستجابة له. الأدوات موجودة، والوصول إليها مجاني، ومنحنى التعلم يبدأ منذ اللحظة التي ترفع فيها صورتك الأولى.